Command Palette
Search for a command to run...
논문 주간 리포트丨에이전트 하네스 최신 동향을 다룬 8편의 논문, 코딩 에이전트/물리적 제어/이미지 및 영상 생성 분야 망라
AI Agent가 단순한 질의응답에서 복잡한 작업 수행으로 진화함에 따라, Agent Harness(에이전트 하네스)는 에이전트 연구의 중요한 방향으로 급부상하고 있습니다. Agent Harness는 대규모 언어 모델, 도구, 실행 환경을 연결하는 실행 프레임워크로, 작업 흐름 조직화, 컨텍스트 및 메모리 관리, 도구 호출 조율, 실행 과정의 오류 처리 및 결과 검증을 담당합니다. 쉽게 말해, 모델은 Agent가 무엇을 생각할 수 있는지를 결정하는 반면, Harness는 이러한 능력이 안정적이고 신뢰할 수 있는 실제 행동으로 전환될 수 있는지에 큰 영향을 미칩니다.
Harness가 왜 점점 더 주목받고 있을까요? 모델의 추론 및 생성 능력이 지속적으로 향상되면서, 에이전트가 직면한 과제는 더 이상 정답을 생성하는 것만이 아닙니다. 이는 다단계 작업을 연속적으로 완료하는 방법, 오류 조작을 줄이는 방법, 다양한 실행 환경에 적응하는 방법, 그리고 자율적인 행동 과정에서 위험을 통제하는 방법을 포함합니다. Harness는 모델 실행을 지원하는 기본 프레임워크에서 Agent의 실행 효과, 응용 범위 및 보안성을 좌우하는 핵심 인프라로 점차 진화하고 있습니다.
이러한 문제들을 중심으로 최근 다양한 관점에서 Harness의 설계, 평가 및 최적화를 탐구하는 연구가 증가하고 있습니다. 계획, 도구 및 컨텍스트 관리의 역할을 통제된 실험을 통해 분석하는 연구가 있는가 하면, 터미널 조작, 로봇 제어 및 시각 생성 분야에서 보다 신뢰할 수 있는 실행 메커니즘을 탐구하는 연구도 있습니다. 또한 보안 제약, 자동 구축 및 재귀적 자기 개선에 주목하여 Harness가 단순히 실행되는 것을 넘어 작업 피드백에 기반해 지속적으로 최적화될 수 있도록 시도하는 연구도 있습니다.
이번 호에서는 NVIDIA, Google Cloud AI Research, Northwestern University, University of Science and Technology of China 등 대학 및 연구 기관의 Agent Harness 관련 연구 8편을 엄선하여 소개합니다. 프레임워크 설계, 실행 제어, 임베디드 지능(embodied intelligence), 시각 생성, 보안 거버넌스, 엔지니어링 역량 평가, 재귀적 최적화 및 자기 진화 등 다양한 방향을 포괄합니다. 함께 살펴보시죠!
또한, HyperAI 공식 웹사이트의 '논문' 섹션은 인공지능 분야의 최전선 성과를 지속적으로 추적하여 관련 연구 동향을 신속하게 파악할 수 있도록 도와드릴 것입니다. ⬇️
최신 논문 보기:
이번 주 추천 논문
1. Coding Agents를 위한 Harness 설계
논문 제목:
An Empirical Study of Harness Design for Coding Agents
논문 및 상세 해설:
이 연구는 Coding Agents의 Harness 설계를 체계적인 실증 분석을 통해 진행하였으며, 하위 모델이 동일한 상태에서 다양한 실행 메커니즘이 작업 성능에 미치는 영향을 중점적으로 조사했습니다. 연구진은 계획 메커니즘, 행동 공간, 컨텍스트 관리라는 세 가지 핵심 구성 요소를 중심으로 통제된 실험을 수행하여, Harness의 각 부분이 작업 성공률, 실행 효율성 및 자원 비용에 미치는 구체적인 영향을 명확히 하려고 했습니다. 이를 통해 완전한 시스템의 최종 성능만으로 특정 설계의 유효성을 판단하는 오류를 피하고자 했습니다.
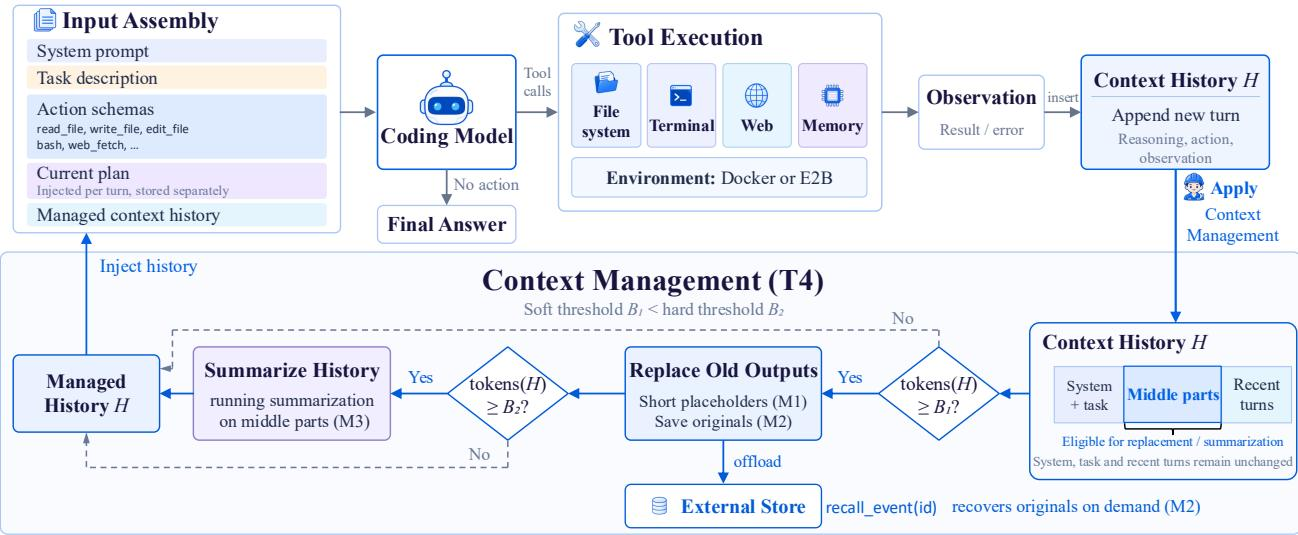
연구팀은 SWE-Bench Verified 및 Terminal-Bench 2.1 등 벤치마크를 기반으로 여러 매칭 실험을 진행했습니다. 그 결과, 컨텍스트 관리는 장거리 작업에 특히 중요하며, 과거 이력을 적절히 처리하면 컨텍스트 오버플로우로 인한 실패를 줄일 수 있음이 밝혀졌습니다. 계획 메커니즘은 모델의 능력에 따라 효용이 달라지며, 도구 인터페이스 선택 역시 모델의 특성에 맞춰 조정해야 합니다. 연구는 Harness가 구성 요소가 많을수록 좋은 것이 아니며, 작업 요구사항, 모델 능력 및 자원 예산에 따라 설계되어야 함을 시사하며, 이후 정량적인 Harness 최적화 연구를 위한 실증적 기반을 제공했습니다.
2. Mid-Harness
논문 제목:
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
논문 및 상세 해설:
NVIDIA, 한국과학기술원(KAIST) 등 기관의 연구진들은 Mid-Harness를 제안하며, 대규모 언어 모델과 실행 프레임워크 사이에 행동 샘플링 및 검증 메커니즘을 도입하여 Terminal Agents의 실행 신뢰성을 높이는 방법을 탐구했습니다. 기존의 Terminal Agent는 일반적으로 모델이 생성한 명령을 직접 실행하지만, 잘못된 조작은 실행 환경을 변경하여 이후 작업에 영향을 미칠 수 있습니다. 모델이 더 나은 명령을 생성할 능력이 있더라도 첫 번째 시도에서 최적의 선택을 보장하지 못할 수 있습니다. Mid-Harness는 실제 실행 전에 여러 후보 행동을 생성한 후 검증기를 통해 비교 및 필터링하여 부적절한 조작이 작업 진행에 미치는 영향을 줄입니다.
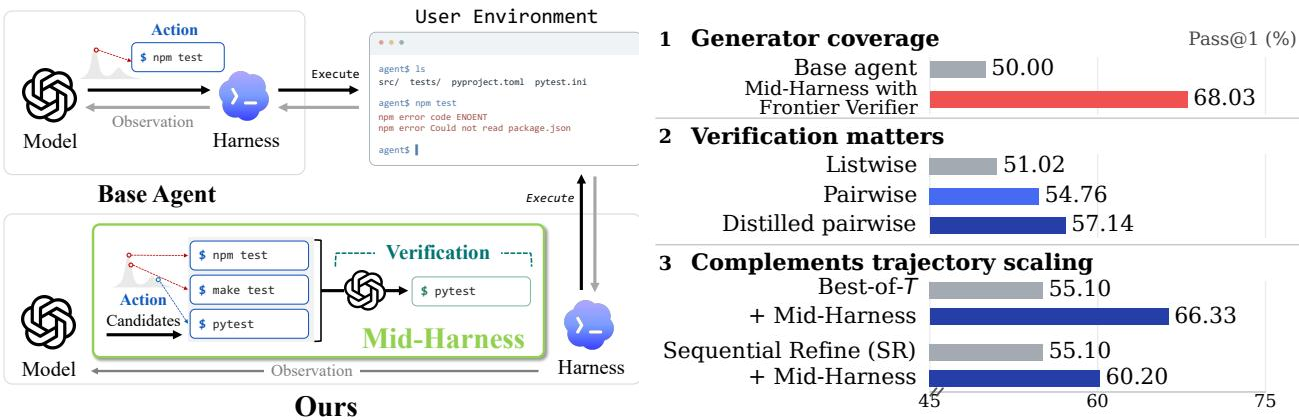
연구팀은 후보 행동의 샘플링 방식, 검증기 선택 및 다양한 실행 전략에 관한 실험을 수행하여 모델과 Harness 사이에 추가적인 계산 자원을 할당하는 실질적 가치를 분석했습니다. 연구 결과, 후보 행동을 늘리는 것이 반드시 효용을 가져오는 것은 아니며, 그 효과는 검증기가 더 나은 조작을 식별할 수 있는지에 달려 있음이 나타났습니다. 적절한 비교 및 필터링 메커니즘은 행동의 질을 향상시키고 전체 작업 궤적의 성공률을 개선할 수 있습니다. 이 연구는 최적화 초점을 단순히 모델의 생성 능력을 향상시키는 것에서 실행 전 행동 선택으로 확장하여, 보다 신뢰할 수 있는 Terminal Agent 구축을 위한 새로운 접근 방식을 제시했습니다.
3. Show-Harness
논문 제목:
Show-Harness: Just a VLM Agent Can Play Robots
논문 및 상세 해설:
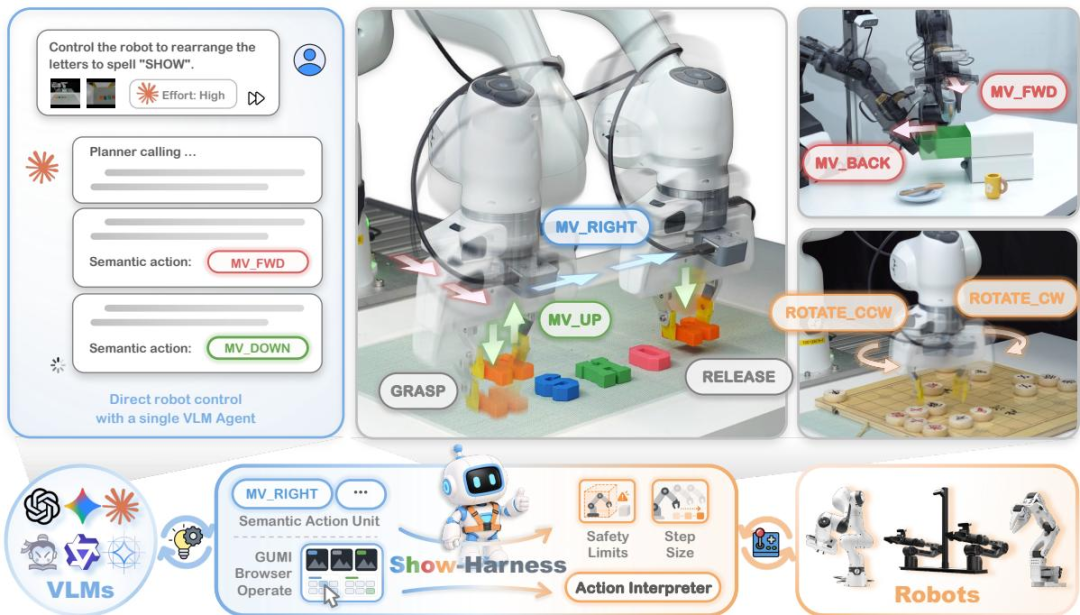
연구자들은 시각 언어 모델(VLM)의 시각적 이해와 언어 추론 능력을 실제 로봇 조작으로 어떻게 전환할 수 있는가라는 문제를 해결하기 위해 Show-Harness를 제안했습니다. 기존의 로봇 시스템은 일반적으로 시각-언어-동작 모델을 별도로 학습하거나, 상위 수준 모델이 생성한 명령을 실행하기 위해 독립적인 컨트롤러에 의존해야 했습니다. Show-Harness는 로봇 조작을 모델이 이해하고 추론할 수 있는 이산적인 동작 단위로 표현하는 시맨틱 동작 인터페이스를 설계했으며, 특정 로봇에 맞춰 설계된 인터프리터가 이러한 동작을 실제 제어 명령으로 변환합니다. 또한 연구팀은 전용 원격 조작 하드웨어에 대한 의존성을 줄이면서 그래픽 사용자 인터페이스(GUI)를 통해 로봇 조작 시연을 수집할 수 있는 GUMI(GUI Manipulation Interface)를 개발했습니다.
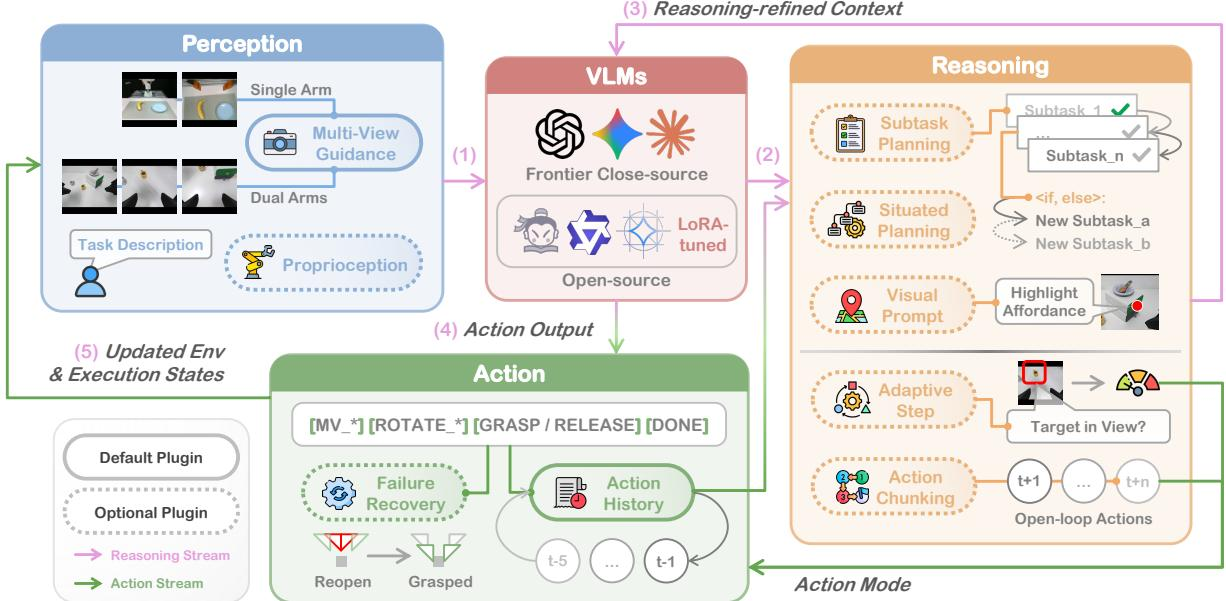
연구팀은 다양한 작업, 로봇 형태 및 환경에서의 평가를 통해 제로샷 제어 및 경량 미세 조정 시나리오에서 이 프레임워크의 성능을 탐구했습니다. 그 결과, Show-Harness는 최첨단 VLM이 별도의 미세 조정 없이도 다양한 로봇 조작 작업을 수행할 수 있도록 돕고, 비교적 가벼운 미세 조정을 통해 소형 오픈 소스 모델에도 적응할 수 있음을 보여주었습니다. 또한 상황 계획, 동작 이력 기록 및 실패 복구와 같은 메커니즘이 실행 안정성을 개선한다는 사실이 확인되었습니다. 이 연구는 모델과 환경 간의 상호작용 인터페이스를 합리적으로 설계하면 기초 VLM의 기존 임베디드 능력을 활성화하여, Harness가 소프트웨어 실행 프레임워크에서 물리적 세계의 행동 제어 계층으로 나아가는 데 기여할 수 있음을 시사합니다.
4. MaLiang-Harness
논문 제목:
MaLiang-Harness: A Programmable Path to Image and Video Generation
논문 및 상세 해설:
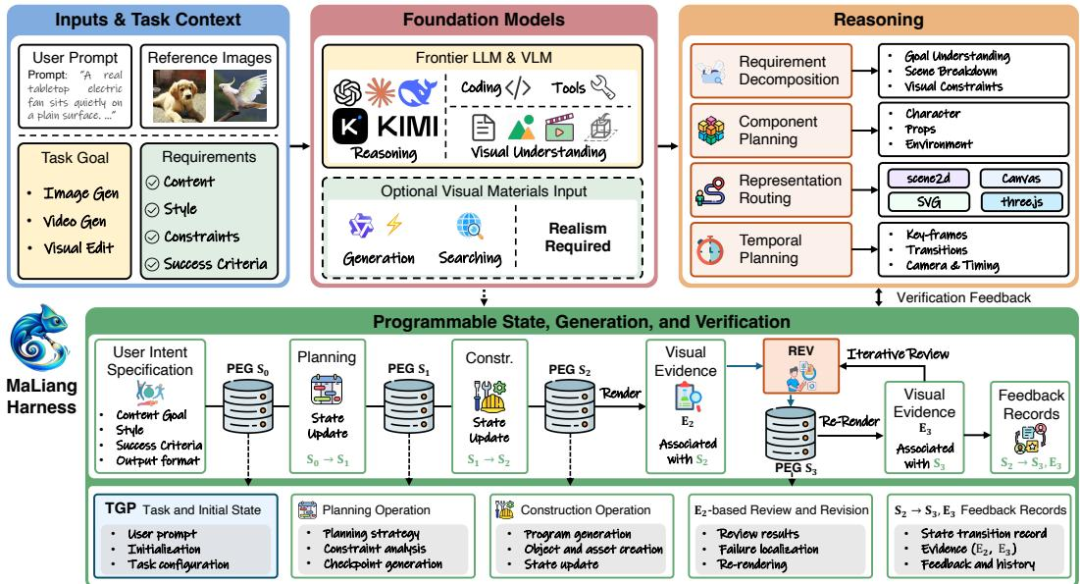
연구자들은 Harness의 설계 철학을 이미지 및 비디오 생성 영역으로 확장하는 방법을 탐구하기 위해 MaLiang-Harness를 제안했습니다. 기존의 프로그래밍 방식 생성은 명확한 구도와 애니메이션 제어를 제공할 수 있지만, 프로그램이 성공적으로 실행된다고 해서 최종 시각 결과가 사용자의 기대에 부합하는 것은 아닙니다. 이 문제를 해결하기 위해 본 프레임워크는 멀티모달 대규모 언어 모델이 주도하는 시각 생성을 지속적인 구축, 검사 및 수정의 과정으로 조직화합니다. 실행 가능한 프로그램과 작업 컨텍스트의 저장, 편집 이력 및 렌더링 증거 추적, 그리고 현재 버전에 대한 검증을 통해 시각 생성 과정을 더욱 추적 가능하고, 복구 가능하며, 반복적으로 개선할 수 있도록 합니다.
연구팀은 이미지 및 비디오 생성 능력을 평가하기 위해 각각 MaLiang-IBench와 MaLiang-VBench를 구축하고 여러 최첨단 멀티모달 대규모 언어 모델을 테스트했습니다. 그 결과, GPT-6-Astra는 두 벤치마크 모두에서 100%의 생성 성공률을 달성했으나, 모든 시각 품질 임계값을 충족한 이미지 작업은 96.0%, 비디오 작업은 76.9%였습니다. 이 결과는 프로그램 실행 성공과 최종 시각 품질 달성이 여전히 다른 평가 차원임을 보여주며, 범용 모델의 능력 점수가 유사하더라도 시각 생성 작업에서의 성능이 동일하지는 않음을 의미합니다. 이 연구는 프로그래밍 가능한 시각 생성을 위한 체계적인 실행 프레임워크를 제공하며, 생성형 AI 시나리오에서 Harness의 적용 범위를 확장합니다.
5. EvoSafeHarness
논문 제목:
EvoSafeHarness: Evolving Model- and Domain-Specific Harnesses for Securing Agents
논문 및 상세 해설:
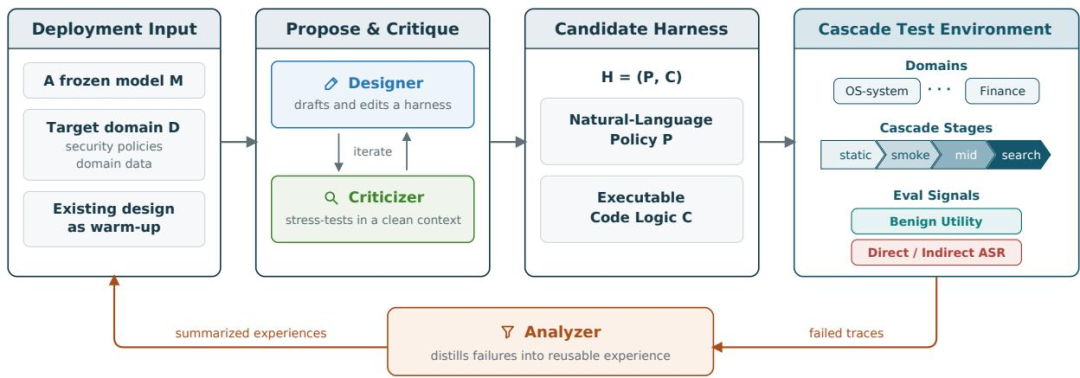
연구자들은 에이전트가 직접적인 유해 요청 및 간접적인 프롬프트 주입에 직면했을 때의 보안 방어 문제를 해결하기 위해 EvoSafeHarness를 제안했습니다. 기존의 보안 제약 조건은 일반적으로 전문가가 사전에 설계하여 다양한 모델과 작업 도메인에 적용하지만, 모델별 행동 특성과 도메인별 위험 요구 사항은 서로 다르므로 고정된 규칙은 정상 작업을 과도하게 제한하거나 특정 시나리오의 보안 위험을 놓칠 수 있습니다. EvoSafeHarness는 보안 제약 조건 설계를 최적화 가능한 프로세스로 전환하며, 자연어 보안 정책과 실행 가능한 코드 로직을 함께 조정합니다. 또한 목표 모델의 행동 피드백, 도메인 규정 및 적대적 검사를 결합하여 특정 배포 환경에 더 적합한 제약 조건 세트를 생성합니다.
연구팀은 다양한 에이전트 보안 벤치마크에서 평가를 수행했습니다. DecodingTrust-Agent의 관련 테스트 설정에서 해당 방법은 평균 공격 성공률을 45.6%에서 10.0%로 낮추고, 유틸리티 손실은 약 3.3 퍼센트 포인트에 그쳤습니다. AgentDojo의 특정 평가 설정에서는 공격 성공률이 0.0%로 떨어지고, 일반 작업 유틸리티는 82.8%에 도달했습니다. 이러한 결과는 모델 및 도메인에 맞춤형 보안 메커니즘을 적용하면 보안성과 작업 유틸리티 간의 균형을 개선할 수 있음을 시사합니다. 다만, 보안 성능은 공격 유형, 작업 환경 및 평가 범위에 따라 달라집니다. 이 연구는 Harness의 역할을 작업 실행에서 리스크 관리로 확장하여, 에이전트가 작업을 완료하는 동시에 적절한 보안 경계를 준수하도록 하는 방법을 탐구했습니다.
6. Doc 2 Harness
논문 제목:
Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
논문 및 상세 해설:
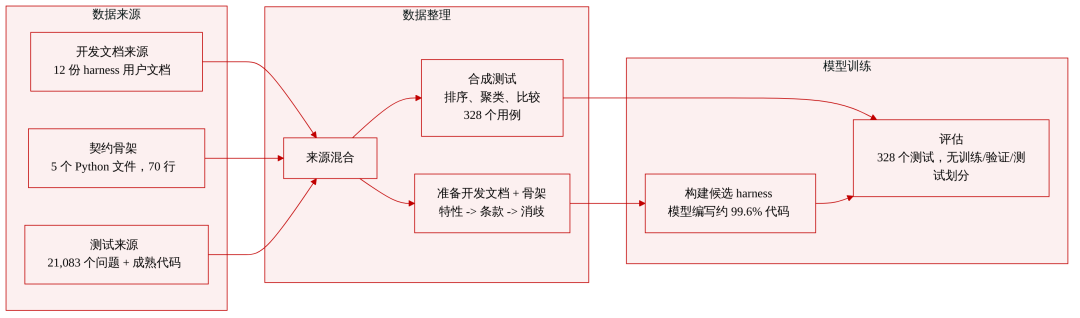
연구자들은 LLM의 완전한 Agent Harness를 구축하는 엔지니어링 능력을 직접 평가하기 위해 Doc2Harness를 제안했습니다. 기존 연구는 주로 사전에 설계된 실행 프레임워크 내에서 에이전트의 작업 성능을 테스트했으나, 모델이 개발 문서와 인터페이스 계약을 바탕으로 실제로 실행 가능한 프레임워크를 독립적으로 구축할 수 있는지를 검증하는 경우는 드물었습니다. Doc2Harness는 평가를 두 단계로 설계했습니다. 먼저, 구축 모델이 인터페이스 계약과 개발 문서를 바탕으로 후보 Harness를 생성합니다. 이후, 연구팀은 격리된 환경에서 해당 프레임워크를 실행하여 모델 요청, 디스크 파일, 프로세스 종료 코드, 명령 출력 등의 관측 가능한 정보를 통해 실제 동작이 요구 사항을 충족하는지 확인합니다.
연구팀은 이 벤치마크를 사용하여 19개의 최첨단 모델을 평가했으며, 각 모델은 328개의 테스트 케이스에 대해 3회 독립적으로 구축을 수행했습니다. 결과적으로, 가장 성능이 좋은 GPT-6 Astra의 통과율은 53.05%였고, 가장 약한 모델은 27.44%였습니다. 가장 성능이 좋은 모델조차도 절반에 가까운 테스트 케이스를 통과하지 못했습니다. 실패 문제는 주로 여러 모듈에 걸친 구현이 필요한 기능과 모듈 간 책임 분담에 집중되었습니다. 이 연구는 모델이 코드를 생성할 수 있다는 것이 복잡한 실행 인프라를 구축할 수 있는 완전한 엔지니어링 능력을 갖추고 있음을 의미하지는 않는다는 점을 보여줍니다. Doc2Harness는 장기간의 Harness 엔지니어링 능력을 측정하기 위한 결정론적 평가 벤치마크를 제공하며, 향후 에이전트 프레임워크의 자동 구축 능력을 개선하기 위한 참고 자료를 제공합니다.
7. Harness²
논문 제목:
Harness²:Recursive Agent Harnessing for an Open World
논문 및 상세 해설:
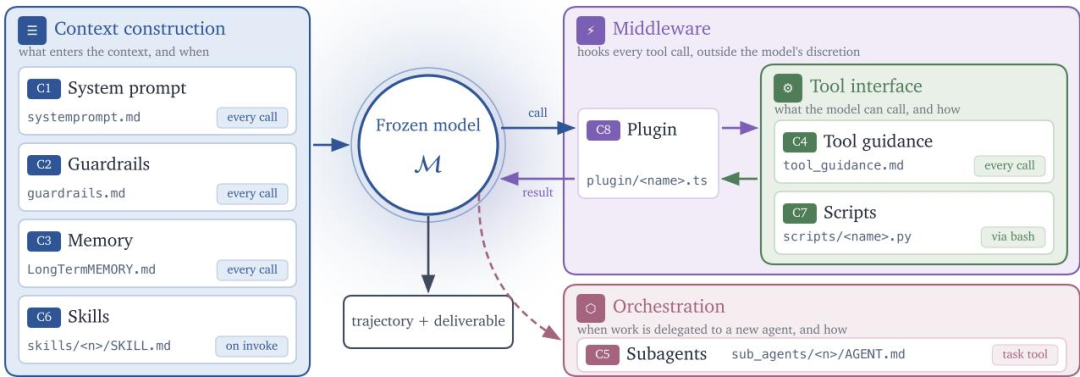
에이전트가 변화무쌍하고 사전에 정의하기 어려운 실제 작업에 직면했을 때, 전통적인 인간 설계 및 고정된 구성의 Harness는 적시에 적응하기 어려운 경우가 많습니다. 이러한 문제에 대응하기 위해, 연구는 Harness²를 제안하여 에이전트가 작업을 완료할 뿐만 아니라 실행 과정에서 자체 실행 프레임워크를 지속적으로 개선할 수 있도록 시도합니다. 이 방법은 두 개의 상호 연관된 재귀적 계층을 구축합니다. 작업 수준 재귀는 Propose–Probe–Compose 프로세스를 통해 현재 작업에 대한 후보 프레임워크 변경 사항을 제안하고 비교 테스트를 실행한 후, 실제 실행 궤적과 작업 결과물을 바탕으로 채택 여부를 결정합니다. 프레임워크 수준 재귀는 이러한 변경 사항에서 재사용 가능한 경험을 추출하여 향후 프레임워크 최적화 방식을 점진적으로 업데이트합니다. 작업의 정확성을 직접 판단할 수 있는 표준 정답이 없더라도, 시스템은 다른 구성 하의 실행 성능을 비교함으로써 프레임워크 조정을 위한 근거를 제공할 수 있습니다.
연구팀은 세 가지 전문 벤치마크와 네 가지 모델-프레임워크 구성에서 평가를 수행했습니다. 실험 결과, 단일 단계 프레임워크 개선은 GLM-5와 Gemini 3.5 Flash의 여러 벤치마크에서의 성능을 향상시킬 수 있음을 보여주었습니다. WorkBuddy-Bench에서 최대 11.5점, JobBench에서 4.5점, LAB에서 11.8 퍼센트 포인트가 향상되었으며, 작업 수준 재귀 예산이 증가함에 따라 성능 향상 폭은 더욱 커질 수 있습니다. Harness²의 의의는 '현재 작업 완료'와 '경험 축적 및 향후 작업 개선' 사이의 연결고리를 시도한다는 점에 있습니다. 이를 통해 Harness는 일회성 구성에서 새로운 작업에 지속적으로 적응할 수 있는 실행 시스템으로 점차 변모하며, 개방형 환경에서의 에이전트 자기 개선을 위한 새로운 접근법을 제공합니다.
8. Self-Evolving Agent Harness
논문 제목:
Self-Evolving Agent Harness
논문 및 상세 해설:
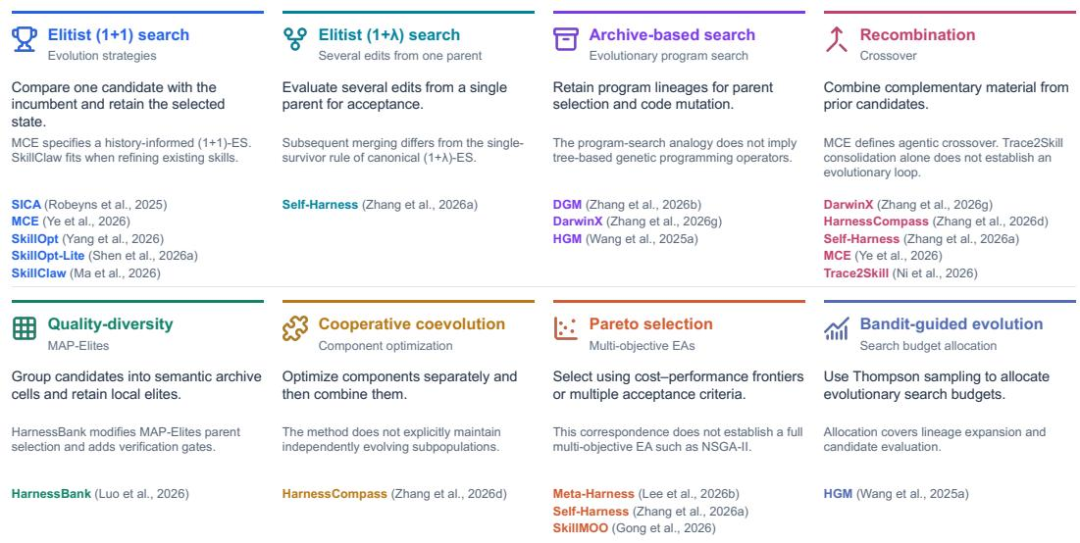
앞선 연구들이 Harness 설계, 행동 제어, 또는 작업 성능의 재귀적 최적화에 초점을 맞추었다면, 이 연구는 보다 포괄적인 질문을 제시한다: 에이전트가 장기적으로 실행될 때, Harness가 지속적이고 자가 갱신되는 메커니즘을 형성할 수 있는가? 연구는 '자가 진화'를 피드백에 기반한 지속적 수정 과정으로 정의한다: 기반 모델의 가중치를 변경하지 않으면서도, 시스템은 실행 경험을 바탕으로 프롬프트, 메모리, 워크플로우 및 실행 가능한 컴포넌트를 조정하고, 승인된 변경 사항을 이후 실행을 위해 보존한다. 조정 대상에는 단일 모듈뿐만 아니라 도구와 코드, 리포지토리 수준의 제어 로직, 그리고 다양한 플러그인과 컴포넌트 간의 조합 관계도 포함된다. 동시에 이 연구는 수정 사항의 제안, 수정의 유효성 판단, 그리고 공식 채택 여부 결정이 각각 별도로 처리되어야 하는 세 가지 단계임을 강조하며, 단순히 특정 작업 성능이 개선되었다고 해서 해당 변경 사항이 장기적인 가치를 지닌다고 단정할 수 없다고 지적한다.
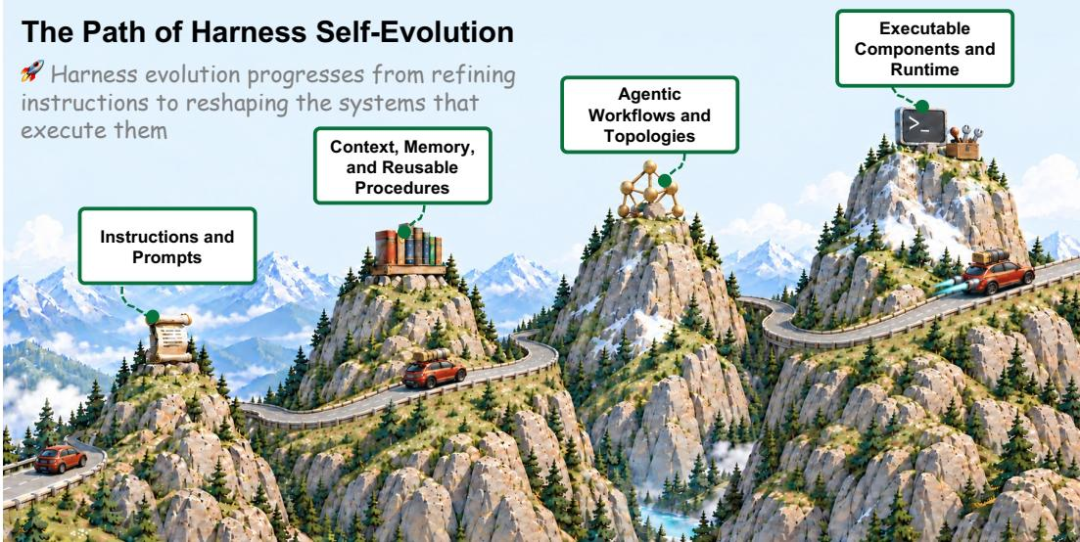
이론적 측면에서 논문은 진화적 최적화와 지속적 PAC 학습을 결합하여 Harness가 지속 업데이트될 때 발생할 수 있는 일반화 및 성능 후퇴 문제를 분석한다. 또한 명시적인 가정 하에 기대 일반화 경계, 과거 회귀 예산과 관련된 보존 경계, 그리고 완전히 새로운 독립적 검증 데이터를 기반으로 한 후보 변경 사항의 수용 규칙을 논의한다. 단순히 특정 벤치마크 점수를 비교하는 것보다, 이 연구는 Harness가 반복적인 반복 과정에서 유효한 경험을 보존하면서 과적합, 망각 및 과거 작업 성능 저하를 최소화하는 방법에 더 중점을 둔다. 논문은 작업 분포 변화, 평가기 편향, 그리고 과학적 신뢰성, 물리적 안전 및 조직적 책임과 같은 배포 문제들도 다루며, 지속적 검증과 독립적인 안전장치가 여전히 필수적임을 지적한다. 이 연구가 제시하는 방향은 Harness가 더 이상 모델 주위에 구축된 정적인 소프트웨어 구조가 아니라, 피드백을 축적하고 신중하게 자체를 수정하며 지속적 검증을 수용하는 시스템이 될 수 있다는 것이다.