Command Palette
Search for a command to run...
TimesFM 3.0 제로샷 예측 시계열, 다양한 시나리오 분석 요구 충족; VLX-Seek 목표 위치 파악과 세밀한 이해 융합, 구현 비전 인식 능력 확장
VLX-Seek는 OmAI Lab이 2026년 7월에 출시한 세밀한 인식 기반 비전-언어 모델로, 로봇, 드론 등 엣지 디바이스의 임베디드 비전 애플리케이션을 대상으로 합니다. 실제 작업에서 지시가 정확히 어떤 객체를 가리키는지 판단하기 어려운 문제를 해결하기 위해, 이 모델은 언어 이해와 영역 수준의 시각 인식을 결합하여 대상 특징과 지시 관계에 기반한 탐색을 지원하며, 선택된 영역을 중심으로 문자 인식, 내용 설명, 개수 세기 기능을 수행합니다. 또한, 모델은 대상이 없을 때의 거부 인식 메커니즘을 도입하여 후속 탐색 및 작업 조정의 근거를 제공합니다. VLX-Seek는 비전 모델의 적용 범위를 더욱 확장하여 구체적인 객체의 식별과 상호작용에 중점을 두며, 임베디드 지능 시스템이 환경 인식과 행동 결정을 연결하는 데 기초적인 능력을 제공합니다.
현재 HyperAI 공식 웹사이트에 'VLX-Seek: 세밀한 인식 기반 비전-언어 모델'이上线되었습니다. 지금 바로 사용해 보세요~
온라인 사용: https://go.hyper.ai/oeM9
9월 18일 - 9월 24일, hyper.ai 공식 웹사이트 업데이트 요약:
-
우수 공공 데이터셋: 5개
-
우수 튜토리얼 선정: 8개
-
인기 백과사전 항목: 5개
-
10월 마감 최우수 학회: 5개
공식 웹사이트 방문: hyper.ai
공공 데이터셋 선정
1. GooseReason-0.7M 강화 학습 검증 추론 데이터셋
GooseReason-0.7M은 NVIDIA가 2026년에 공개한 대규모 강화 학습 검증 추론(RLVR) 데이터셋으로, 검증 가능한 훈련 데이터 부족이라는 병목 현상을 해결하기 위해 설계되었습니다. Golden Goose 파이프라인을 통해 풍부한 추론형 인터넷 텍스트에서 무제한의 RLVR 작업을 합성합니다. 이 데이터셋은 수학, 프로그래밍, 일반 과학 분야를 아우르는 70만 개 이상의 작업을 포함하며, 데이터 규모는 0.7M 수준에 달합니다. 주로 GooseReason-4B-Instruct 모델 훈련에 사용되며, 해당 모델은 수학, 프로그래밍, STEM 추론, 지시 준수 및 논리 퍼즐을 포함한 15개 벤치마크에서 4B급 모델의 새로운 최첨단 결과를 달성했습니다.
온라인 사용: https://go.hyper.ai/eQ6X7
2. GR1-100 로봇 조작 시연 데이터셋
GR1-100은 NVIDIA가 2025년에 공개한 로봇 조작 데이터셋으로, 92개의 비디오 클립을 포함하며 로봇 훈련을 위한 고품질 비디오 데이터를 제공하는 것을 목표로 합니다. 데이터는 MP4 형식이며 총 크기는 약 142.3MB로, 컴퓨터 비전 및 로봇 학습 분야의 연구에 적합합니다. 이 데이터셋은 주로 GR1-T2라는 Fourier 로봇이 실험실 환경에서 다양한 작업을 수행하는 3인칭 시점 비디오를 기록합니다.
온라인 사용: https://go.hyper.ai/BulTI
3. GraspGen: Scaling Sim2Real Grasping 그립 생성 데이터셋
GraspGen: Scaling Sim2Real Grasping은 NVIDIA가 2025년에 공개한 대규모 시뮬레이션 그립 데이터셋으로, 5,700만 회 이상의 그립 데이터를 포함하며 Objaverse XL (LVIS) 데이터셋의 8,515개 객체를 기반으로 생성되었습니다. Franka Panda, Robotiq-2f-140 산업용 그리퍼 및 단일 접점 흡착 그리퍼(30mm 반경)를 위해 설계되었습니다. 대규모 시뮬레이션 데이터를 통해 로봇 그립 기술의 시뮬레이션에서 실제 환경으로의 전이 능력을 향상시키는 것을 목표로 합니다. 데이터셋은 WebDataset 형식을 사용하며, 총 5,700만 회 이상의 시뮬레이션 그립 데이터를 포함하고, 세 가지 유형의 로봇 그리퍼를 다루며, 로봇 그립, 시뮬레이션-실제 전이(Sim2Real) 및 로봇 학습 분야의 연구에 적합합니다.
온라인 사용: https://go.hyper.ai/81LdN
4. LiveCodeBench-CPP 코드 생성 평가 데이터셋
LiveCodeBench-CPP는 NVIDIA가 2025년에 공개한 C++ 코드 생성 평가 데이터셋으로, 대규모 언어 모델에 최신 프로그래밍 문제를 기반으로 한 코드 생성 및 디버깅 능력 평가 벤치마크를 제공하는 것을 목표로 합니다. 이 데이터셋은 454개의 프로그래밍 문제를 포함하며, 주로 AtCoder(287문제)와 LeetCode(167문제)에서 수집되었고, 2024년 10월부터 2025년 5월까지의 대회와 문제를 다룹니다. 데이터에는 문제 설명, 플랫폼 출처, 난이도, 테스트 케이스 및 관련 메타데이터가 포함되어 있으며, 주로 실제 프로그래밍 작업에서 모델의 코드 생성 및 문제 해결 능력을 평가하는 데 사용됩니다.
온라인 사용: https://go.hyper.ai/YdSXz
5. HelpSteer 유용성 정렬 데이터셋
HelpSteer는 NVIDIA가 2023년에 공개한 대규모 언어 모델 정렬용 데이터셋으로, 모델 응답의 유용성, 정확성, 일관성을 향상시키고 응답의 복잡성과 상세 수준을 조정할 수 있도록 지원합니다. 이 데이터셋은 37,120개의 샘플을 포함하며, 재작성, 요약, 분류, 추출 및 질의응답 등 다양한 작업 유형을 다룹니다. 각 샘플에는 프롬프트, 모델 응답 및 인간이 주석을 단 유용성, 정확성, 일관성, 복잡성, 상세 수준의 5가지 속성 점수(0~4점 범위)가 포함됩니다. 데이터는 Scale AI 조직에서 주석을 달았으며, 주로 대규모 언어 모델 훈련, 평가 및 모델 정렬 연구에 사용됩니다.
온라인 사용: https://go.hyper.ai/B5OPS
공개 튜토리얼 엄선
1. TimesFM 3.0: 제로샷 시계열 예측
TimesFM 3.0은 Google Research가 2026년 8월에 출시한 시계열 기반 모델로, 사전 학습된 제로샷 예측 방식을 채택하여 특정 작업에 대한 미세 조정 없이도 새로운 시계열을 예측할 수 있습니다. 이 모델은 단변량, 다변량 및 공변량 입력을 기본 지원하며, 제로샷 일반화 능력을 강화하여 소매 판매, 금융 분석, 날씨 및 에너지 수요, 공급망 예측 등 시계열 분석 시나리오에 활용할 수 있습니다.
온라인 실행: https://go.hyper.ai/DRk3i
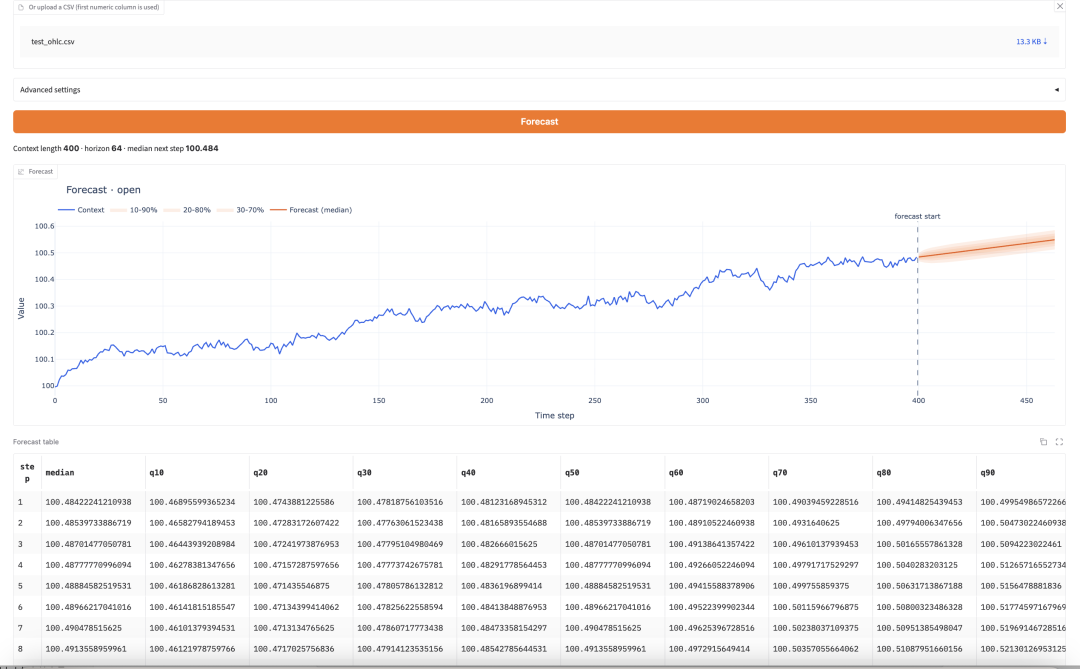
데모 페이지
2. VLX-Seek: 세밀한 인식 기반 비전 언어 모델
VLX-Seek는 OmAI Lab이 2026년 7월에 출시한 세밀한 비전 언어 모델(VLM)로, 엣지 측 임베디드 비전 시나리오를 대상으로 하며, 이미지 내용을 이해하면서 객체 위치 파악, 인스턴스 구분 및 세밀한 시각적 인식을 수행할 수 있습니다. 이 모델은 객체 감지, 지시 표현 이해, 영역 설명, 영역 OCR, 카운팅 및 추론 감지를 지원하며, 개방형 어휘 거부 메커니즘을 통해 객체가 존재하지 않을 때 None을 출력하여 로봇, 드론 등 임베디드 지능 시나리오에 활용할 수 있습니다.
온라인 실행: https://go.hyper.ai/oeM92
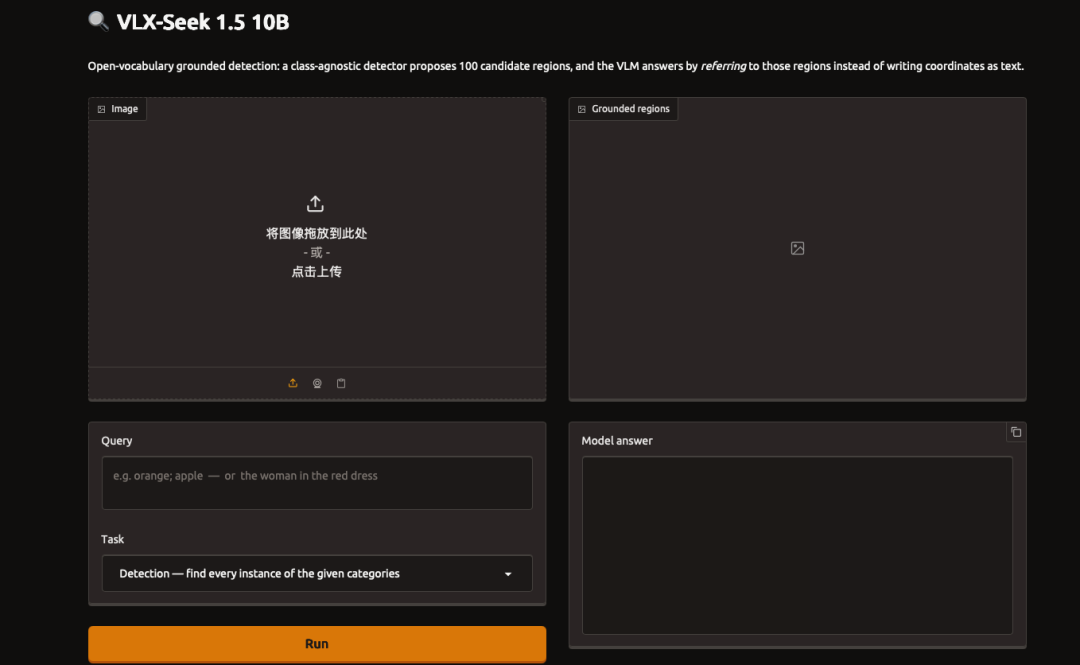
데모 페이지
3. Breeze TTS 2 — 오픈소스 실시간 텍스트 음성 변환 모델
Breeze TTS 2는 BreezeBlue 팀이 2026년 8월에 출시한 오픈 가중치 텍스트 음성 변환 모델로, 실시간 음성 상호작용 시나리오를 대상으로 하며, 자연어를 통한 음성 디자인, 음성 클로닝 및 감정 제어를 지원합니다. 이 모델은 중영 이중 언어를 지원하며, 텍스트 명령을 통해 어조, 속도 및 감정을 조정할 수 있고, 웃음, 한숨 등의 음성 이벤트와 초저지연 스트리밍 생성을 지원하여 실시간 음성 어시스턴트, 오디오 콘텐츠, 더빙 현지화 및 접근성 서비스 등 시나리오에 활용할 수 있습니다.
온라인 실행: https://go.hyper.ai/JStch
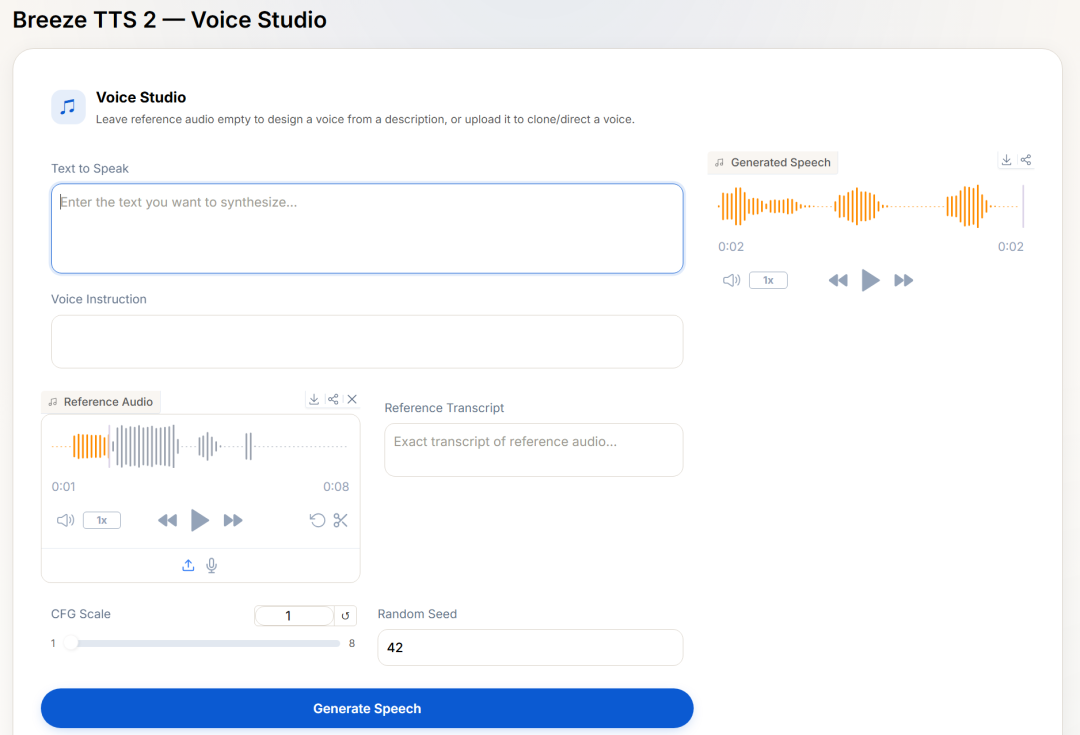
데모 페이지
4. 통계 학습 입문 튜토리얼
이 튜토리얼은 Kaggle 사용자 DATAI가 2018년에 게시한 것으로, Breast Cancer Wisconsin Diagnostic Dataset을 예시로 사용하여 통계 학습 기초 지식과 일반적인 분석 방법을 처음부터 설명합니다. 튜토리얼은 데이터 탐색 및 시각화, 평균과 분산 등의 기술 통계, 누적 분포 함수, 효과 크기와 상관관계, 가설 검정과 p값, 그리고 정규 분포와 Z-score 계산을 다루며, 통계 학습 입문자에게 적합합니다.
온라인 실행: https://go.hyper.ai/fVzMx
5. EfficientDet 훈련 튜토리얼: 밀 이삭 객체 감지
이 튜토리얼은 Alex Shonenkov가 Kaggle Global Wheat Detection 대회를 위해 구축한 훈련 파이프라인을 기반으로, 처음부터 EfficientDet 객체 감지 모델을 실습합니다. 튜토리얼은 환경 구성 및 GPU 확인, 대회 데이터셋 로드, Albumentations 데이터 증강, EfficientDet-D5 모델 구축 및 전체 훈련 과정을 다루며, 객체 감지 모델 훈련과 실전을 배우고자 하는 개발자에게 적합합니다.
온라인 실행: https://go.hyper.ai/AtDMM
6. YuE2-3B: 최첨단 오픈소스 음악 생성 모델
YuE2-3B는 Multimodal Art Projection(m-a-p) 팀이 2026년에 출시한 오픈소스 음악 생성 모델로, 가사와 스타일 프롬프트를 기반으로 보컬과 반주를 포함한 완전한 노래를 생성할 수 있습니다. 이 모델은 AR–NAR Mixture-of-Transformers 아키텍처를 채택하여 멜로디와 코드, 멜로디 전용, 직접 생성의 세 가지 모드를 지원하며, 48 kHz 스테레오 출력을 지원하여 텍스트 기반 음악 생성, 노래 커버 및 지능형 음악 편집 등 시나리오에 활용할 수 있습니다.
온라인 실행: https://go.hyper.ai/t4G7M
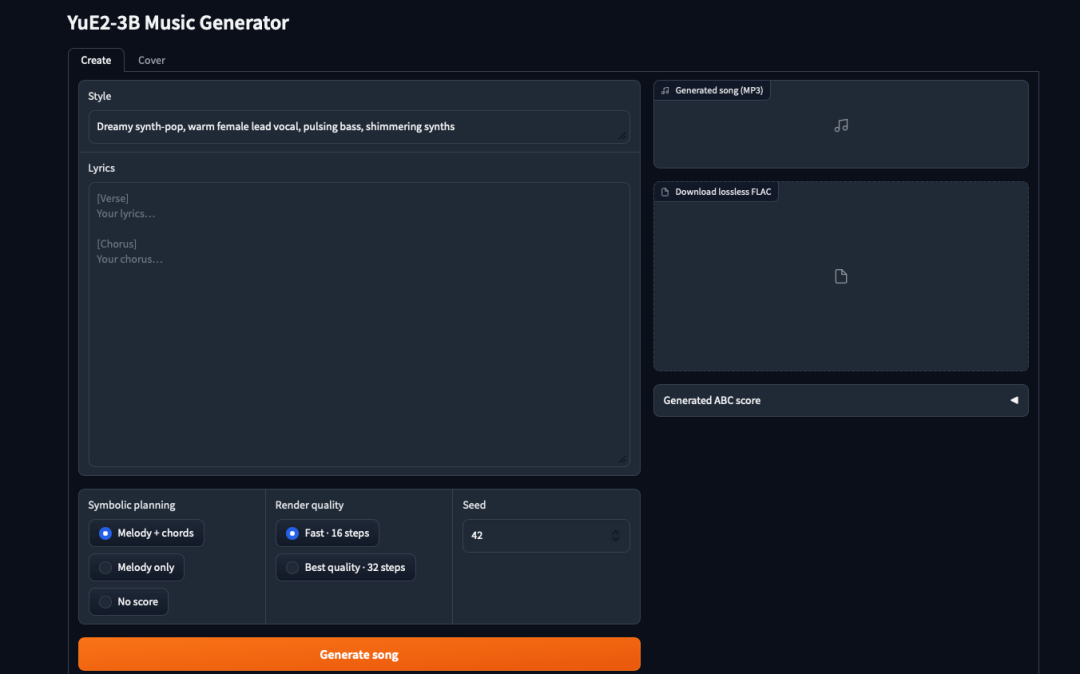
데모 페이지
7. FFmpeg 비디오 플레이어 개발 튜토리얼: 프레임 캡처부터 점프까지
이 시리즈 튜토리얼은 Stephen Dranger가 2015년에 게시한 클래식 튜토리얼 《An ffmpeg and SDL Tutorial》을 각색한 것으로, Python과 FFmpeg 명령줄 도구를 사용하여 핵심 내용을 다시 구현하고, 처음부터 디지털 오디오/비디오의 작동 원리를 설명합니다. 튜토리얼은 컨테이너, 스트림, 코덱, 데이터 패킷, 프레임 및 타임스탬프 등의 기본 개념을 다루며, 실행 가능한 실험을 통해 비디오 동기화, 오디오 동기화 및 미디어 주소 지정을 단계별로 실습하여 플레이어, 트랜스코딩, 스트리밍 미디어 및 컴퓨터 비전 관련 기술을 배우는 데 적합합니다.
온라인 실행: https://go.hyper.ai/rtrW4
8. MiniCPM5-2B: 엣지 2B급 SOTA 대규모 모델 추론
MiniCPM5-2B는 OpenBMB가 2026년 9월에 출시한 2B급 오픈소스 대규모 언어 모델로, MiniCPM5 시리즈의 두 번째 모델입니다. 표준 LlamaForCausalLM 아키텍처를 채택했으며, 엣지 배포, 로컬 추론 및 리소스 제한 환경을 대상으로 합니다. 이 모델은 최대 131K 컨텍스트를 지원하며, 코드 및 수학 추론, 도구 호출, Agent 기능을 갖추고 있어 로컬 AI 어시스턴트, 프로그래밍 보조, 지식 질의응답 및 지능형 에이전트 애플리케이션 등 다양한 시나리오에 활용할 수 있습니다.
온라인 실행: https://go.hyper.ai/D8jnq
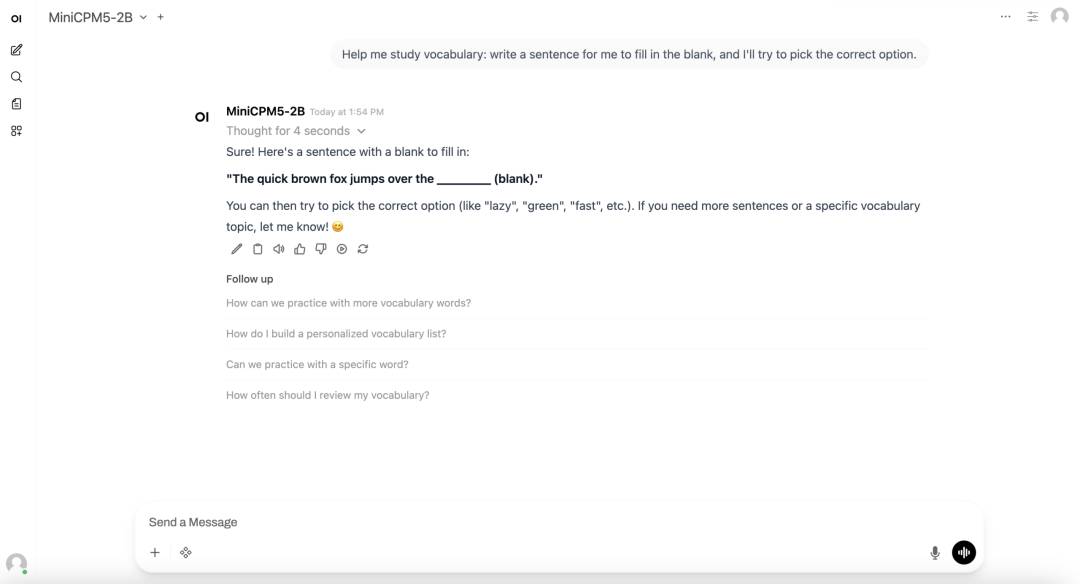
데모 페이지
인기 백과사전 용어精选
1. 광학 문자 인식 OCR
2. 세계 행동 모델 WAM
3. 원격 탐사 Remote Sensing
4. 결함 토큰 Glitch Token
5. 생성형 사전 학습 변환 모델 GPT
여기에 수백 개의 AI 관련 용어가 모여 있어, 여기서 '인공지능'을 이해할 수 있습니다:
10월 마감 최상위 학회
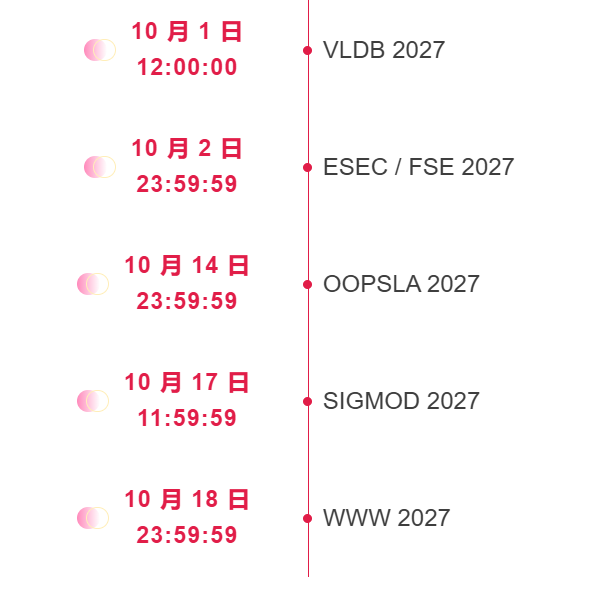
*마감 시간은 AoE 기준
인공지능 학술 최상위 학회를 한 번에 추적하세요: https://go.hyper.ai/event
이상으로 이번 주 편집진이 선정한 모든 내용입니다. hyper.ai 공식 웹사이트에收录하고 싶은 리소스가 있다면, 댓글이나投稿로 알려주세요!
다음 주에 다시 만나요!