HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
画像を用いた多モーダル推論の思考:基礎、手法、および将来のフロンティア
WebSailor: ウェブエージェントの超人的推論をナビゲートする
AIリサーチエージェントによる機械学習:MLE-benchにおける探索、探査、および一般化
局所性を考慮した並列デコーディングによる効率的な自己回帰画像生成
FreeMorph: ディフュージョンモデルを用いたチューニングフリーの汎用画像モーフィング
視覚言語行動モデルに関する調査:行動トークン化の観点から
任意の条件における任意の深さ
LongAnimation: 動的なグローバル-ローカルメモリを用いた長尺アニメーション生成
Kwai Keye-VL 技術レポート
自動運転向けのビジョン-言語-行動モデルに関する調査
モカ: モダリティ認識の継続的前学習が双方向多様性埋め込みを改善する
FreeLong++: マルチバンドスペクトルフュージョンを用いた学習不要の長尺ビデオ生成
トークンを超えて考える:脳からインスピレーションを得た知能から人工一般知能の認知的基礎及其の社会的影響まで
数学的推論が汎用LLMの能力を向上させるか? LLMの推論の転移可能性についての理解
SciArena: 科学文献タスクのためのオープン評価プラットフォーム
医学における包括的人工知能;性能向上と説明可能性の改善
進化するコンテキスト内のプロンプト:オープンエンドで自己複製的な視点
SPIRAL: ゼロサムゲームにおける自己対戦が、マルチエージェント・マルチターン強化学習を介した推論を奨励する
VLMにおける画像選好の聴取者報酬型思考
書道家:フリースタイルテキストイメージのカスタマイズ
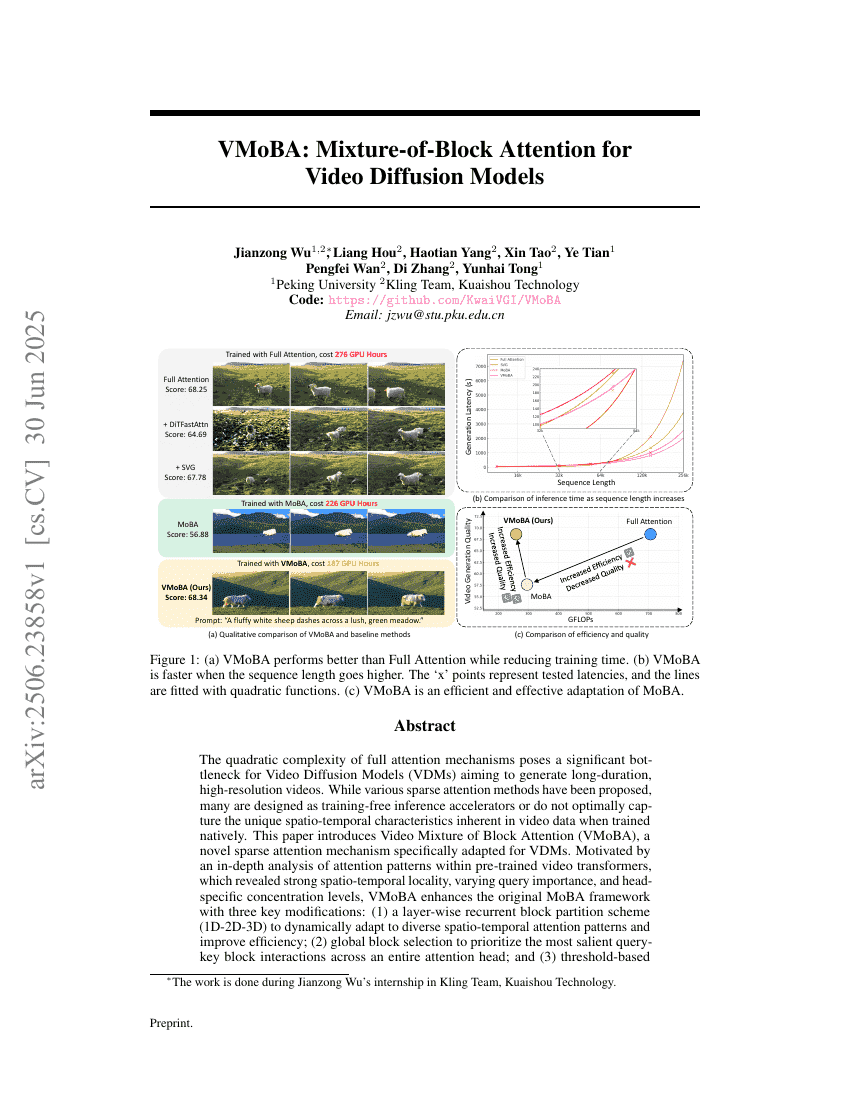
VMoBA: ブロック混合注意機構を用いたビデオ拡散モデル
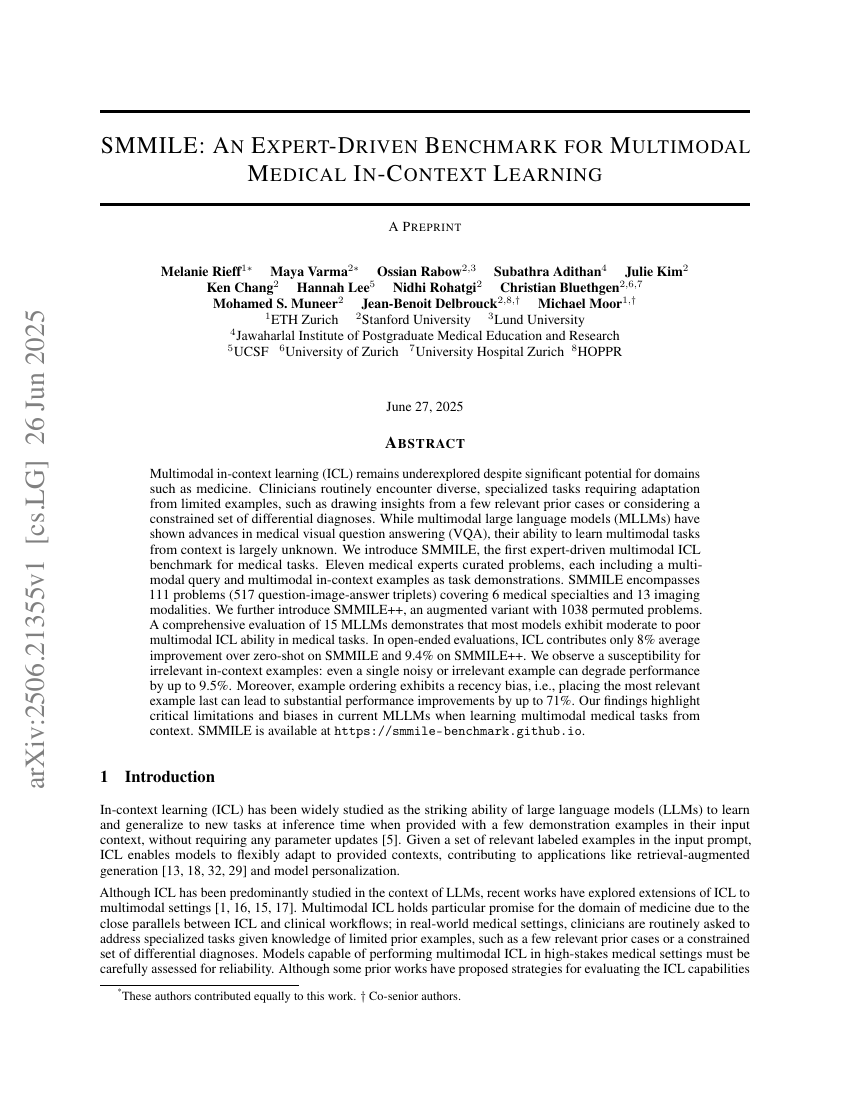
SMMILE: 多モーダル医療文脈学習の専門家主導ベンチマーク
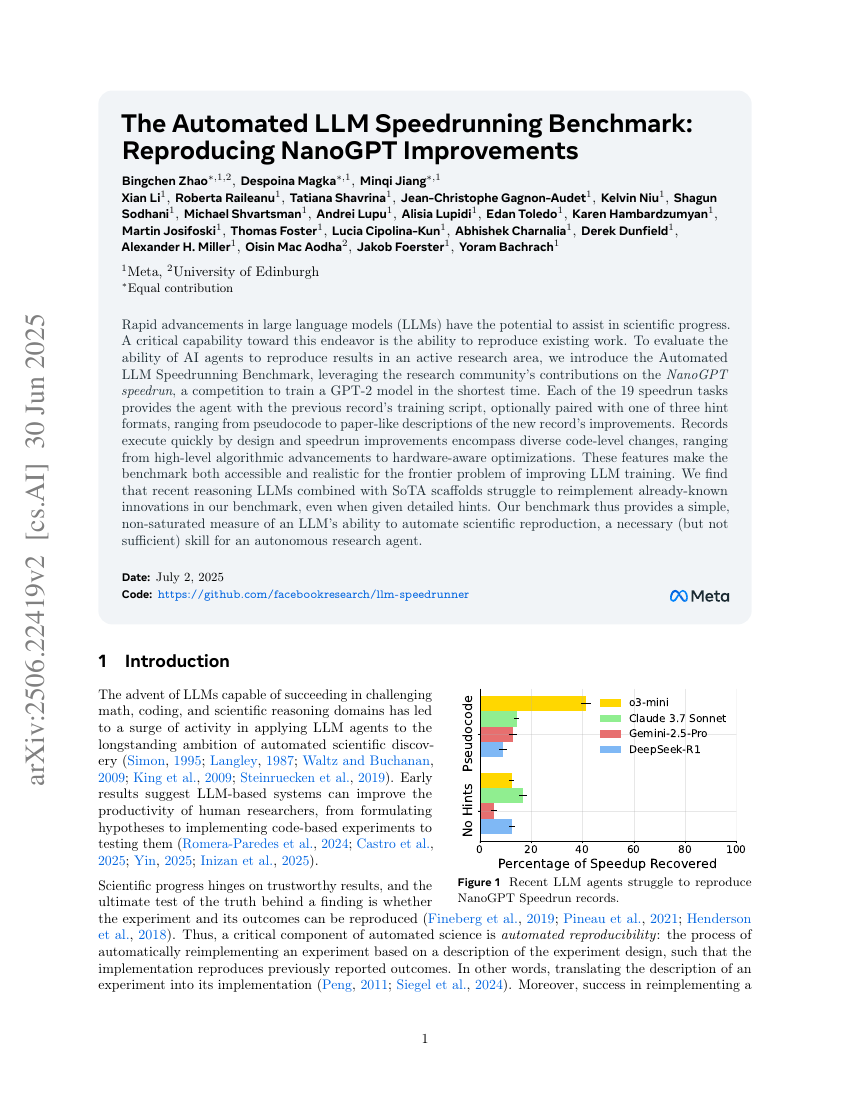
自動化LLMスピードランニングベンチマーク:NanoGPTの改善の再現
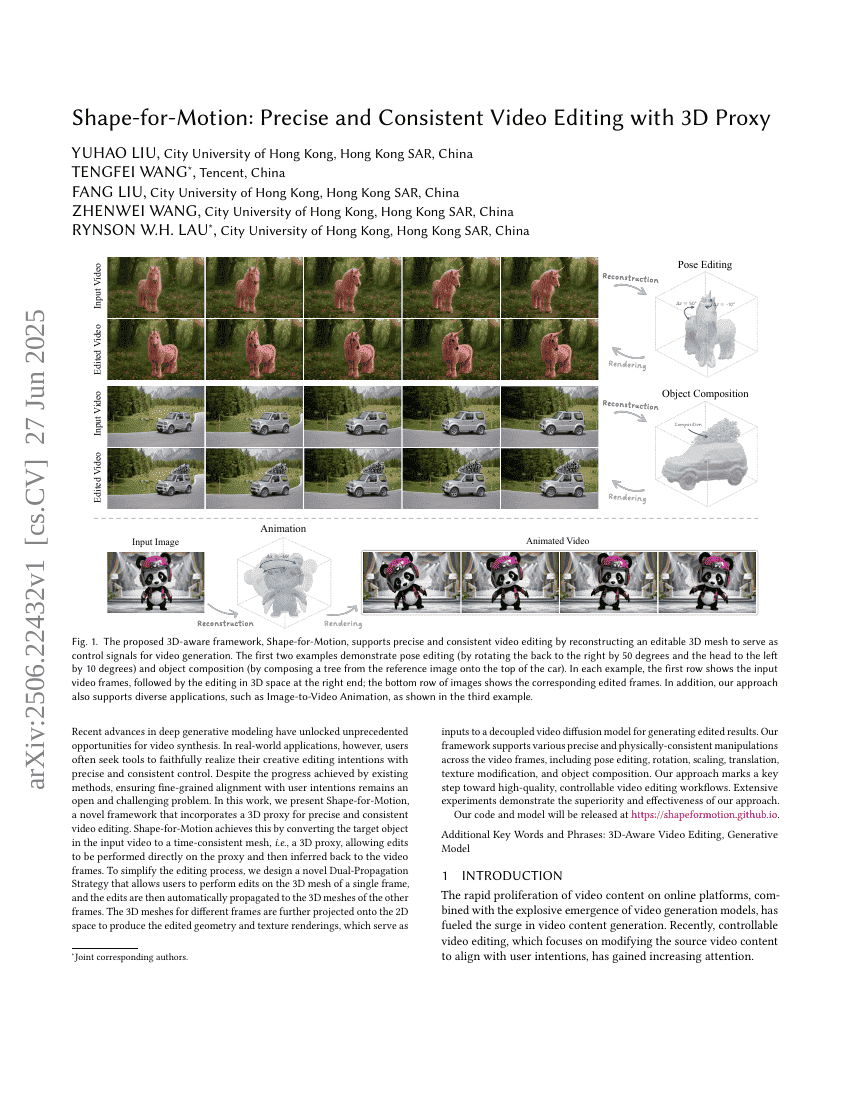
Shape-for-Motion: 3D プロキシを用いた精密で一貫性のあるビデオ編集
理想から現実へ:統一的でデータ効率の高い密集予測の実世界シナリオへの適用
ShotBench: 視覚言語モデルにおける映画的な理解の専門家レベル
XVerse: 複数主題のアイデンティティと意味属性をDiT調節を通じて一貫して制御する方法
24ウェルプレートにおけるゼロショット抗体設計
KinFormer: カタリスト有機反応動力学の一般化可能な動的記号回帰
MiCo: 複数画像の対照性を用いた強化学習視覚推論
微細な嗜好最適化がVLMにおける空間推論を改善する
ARK: ロボット学習のためのオープンソースPythonベースフレームワーク