Command Palette
Search for a command to run...
業界初!NVIDIA、ノーベル賞受賞者David Bakerチームと共同でRFD4-Proteinaを発表し、配列-構造-機能のデカップリング問題の解決に貢献
近年、人工知能(AI)技術の活用により、タンパク質工学の分野は劇的な変革を遂げ、バイオ医薬品、ワクチン開発、遺伝子治療、バイオ製造など、あらゆる分野がその恩恵を受け、将来性は極めて明るいものとなっています。しかし、計算タンパク質設計そのものに立ち返ると、「生成できるか」という課題から、「より良い生成」へと移行することが、次の段階における主要な課題となっています。 これまでの成果により、特定の結合能力や触媒活性を持つタンパク質の人工設計は難題ではなくなりましたが、グローバルな構造動態変化や複数の制約が結合した複雑な分子機械に対しては、依然として安定した実現が困難な状況です。
一般的に言って、タンパク質の機能の本質は、特定の化学基が特定の三次元形状の中で精密な空間配置をとり、他の分子と相互作用することにあります。したがって、タンパク質設計の段階では、分子特性(molecular identity)、構造コンホメーション(structural conformation)、および相互作用幾何学(interaction geometry)の間の強い結合関係を同時に考慮する必要があります。RFdiffusion3などの既存手法は、多様な分子環境下で全原子構造の生成を実現できますが、生成された構造に対して高品質な配列を設計することができません。Proteina-Complexaは、タンパク質の配列と構造を同時に生成し、報酬に基づく探索によって探索範囲を拡大できますが、その表現手法はタンパク質設計に特化しており、相互作用パートナー分子のコンホメーションは固定され、変化しません。
この課題に対し、ワシントン大学タンパク質設計研究所、NVIDIAなどの機関は、業界初となる多成分生体高分子複合体向け、潜在空間推論に基づく大一統の配列-構造共同生成モデル「RFD4-Proteina」を共同で提案しました。 このモデルは、タンパク質設計を「分布サンプリング+事後スクリーニング」という生成パラダイムから、内在的/外在的推論を伴う制約付き探索パラダイムへと推進し、従来のモデルにおける分子種類の狭さ、配列-構造の分離、パートナー剛性仮説というボトルネックを突破し、大規模なウェットラボ実験によってその有効性を証明しました。
関連する研究成果は、「Biomolecular design through latent reasoning with RFD4-Proteina」というタイトルで発表されました。
研究のハイライト:
- 統一潜在空間+二重推論パラダイムの先駆的創出により、配列-構造-機能の分離問題の根源的緩和を実現
- 単一モデルで分子設計ワークフローの全チェーンをカバーし、複数の専用ツールを代替可能
- ウェットラボ実験による検証で複数のマイルストーン的ブレークスルーを達成し、デノボ設計による酵素触媒活性を持つ医薬品有効成分の合成を初めて実現
論文リンク:
https://rfd4-proteina.org/assets/paper/RFD4-Proteina.pdf
マルチモーダル分子データによる訓練および評価ベンチマークの構築
訓練データセット
RFD4‑Proteinaの訓練データセットは、複数のソースからなる公共の生体構造ライブラリ、物理シミュレーションにより生成された合成データセット、および蒸留データセットの混合で構成されており、すべてのデータ処理およびアノテーション作業はAtomWorksツールにより完了しています。異なる訓練段階における各データセットのサンプリング比率は以下の図の通りです:
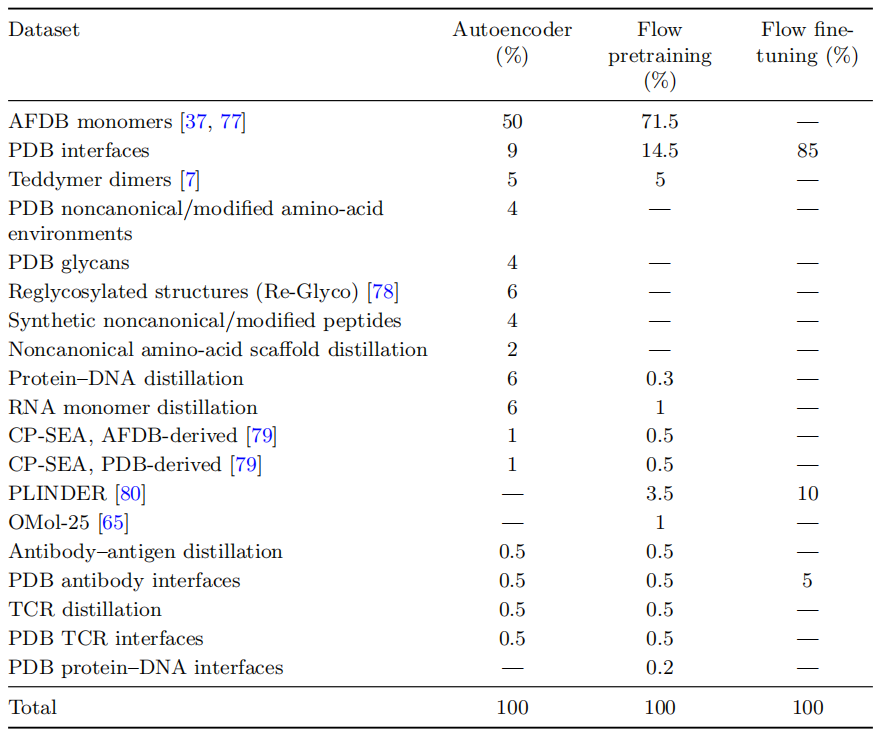
データセットには標準的なタンパク質だけでなく、低分子、核酸、糖類、翻訳後修飾(非標準アミノ酸 NCAA)のサンプルも拡充されており、実験構造中に希少な分子タイプのサンプルが不足している問題を補完しています。
訓練時には、現実世界のタンパク質設計タスクをシミュレートするため、あらゆる制約条件をオンラインでサンプリングし、モデルによる多様な機能制約の理解を向上させます。
テストデータセット
サイドチェーンパッキングのテストデータセットはPackBenchベンチマークデータセットであり、CASP14およびCASP15の天然タンパク質計114種の実在するバックボーン骨格を含みます; 固定バックボーン配列設計のテストデータセットは、天然タンパク質骨格とデノボ設計骨格を含み、前者は訓練時に未見でありテスト用に保持された天然構造、後者は独立モデルRFD3により生成された人工タンパク質骨格です; リガンドの立体化学テストデータセットはCCDデータベースであり、訓練データセットで未見のリガンド43種を含みます; 設計最適化タスクのテストデータセットは、以前のRFdiffusionにより生成されたがAF3構造スクリーニングを通過しなかった結合体で、計102種です; ペプチド-MHC複合体結合のテストデータセットは、3つの標的ペプチドを含みます:MART-1(腫瘍抗原)、SARS-CoV-1膜タンパク質ペプチド、およびPhox2Bペプチド; 本質的に無秩序な領域(IDRs)タスクのテストデータセットは8本のIDRペプチドを含み、2種類に分類されます:5本は結合後に二次構造を形成し、3本は結合しても安定した二次構造を形成しにくいものです; トロポミオシン受容体キナーゼ(TrkA、TrkB、TrkC)タスクのテストデータセットは94個の設計コード化遺伝子を含みます。
統一潜在空間+二重推論により初の全チェーン生成パラダイムを創出
RFD4-Proteinaモデルの中核となる設計思想は、統一された化学-コンホメーション潜在空間を構築し、Flow-Matching(フローマッチング)により生成を行うとともに、潜在空間内で内在的/外在的な二重潜在推論を実行し、微分可能な物理力場の監督制約下で妥当な原子再構築を実現することです。
統一化学-コンホメーション潜在空間
まず、研究チームはオートエンコーダ(Autoencoder)を訓練し、天然/修飾アミノ酸、糖類、ヌクレオチドを、アンカー原子座標(例えば、アミノ酸ではα-炭素)と32次元の潜在ベクトル(分子アイデンティティ)にエンコードします。以下にその概要を示します。当然ながら、すべてが潜在ベクトルに圧縮されるわけではなく、一部の分子成分は明示的な原子種および化学結合の接続情報を保持しており、化学構造の混乱を防いでいます。
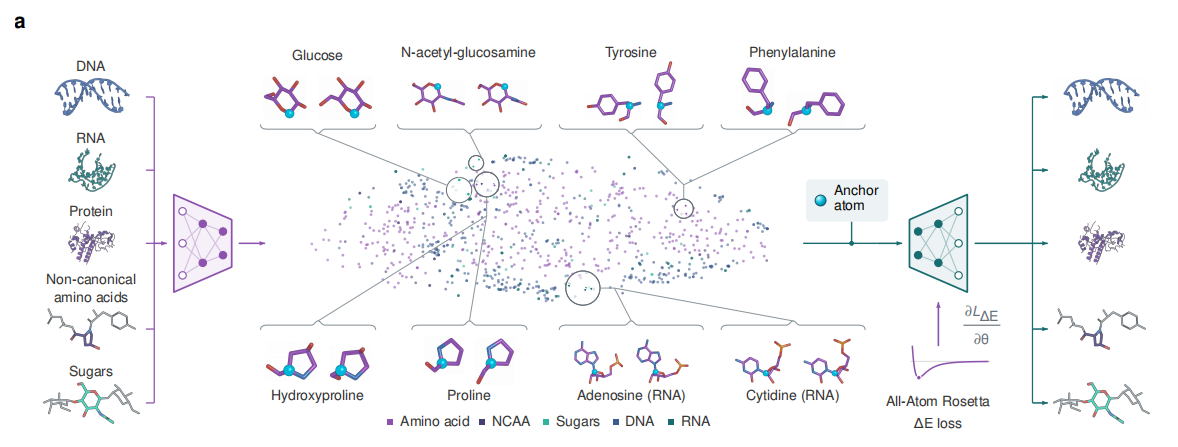
物理的に妥当な再構築構造を得るため、ファインチューニングプロセスでは、Rosettaエネルギー損失関数に基づく項を特別に導入し、TMolを用いてデコード座標の勾配を計算した。
Flow-Matching モデル
その後、研究チームはFlow-Matchingモデルを訓練し、分子座標と潜在ベクトルの同時生成を実現した。これは、La-Proteina / Proteina-Complexaが提案した部分潜在変数フレームワークの拡張である。
従来の配列-構造協調設計手法と比較して、本研究ではモデルを4つの重要な次元でアップグレードした。
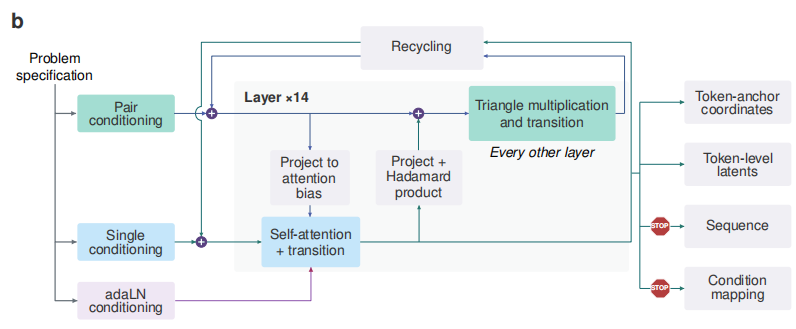
訓練データの拡張:多モーダル物理シミュレーションによる合成データや構造予測蒸留データを導入し、低分子、核酸、タンパク質界面をカバーした。訓練時の条件情報サンプリングでは、実際の設計ニーズに合わせて特徴を意図的に調整し、モデルが実際の有効な制約を理解する能力を向上させた。例えば、酵素活性部位に類似したポケットにおける先端原子位置制約のサンプリングや、大量のタンパク質のみデータを用いたリアルな原子モチーフスキャフォールドタスクの生成などである。ペア表現の強化:1つのTransformerブロックごとに三角乗算更新を行い(下図参照)、単一特徴からペア特徴への情報インタラクションを強化すると同時に、隠れ層の次元を広げた。また、内在/外在推論も導入した。
二重推論
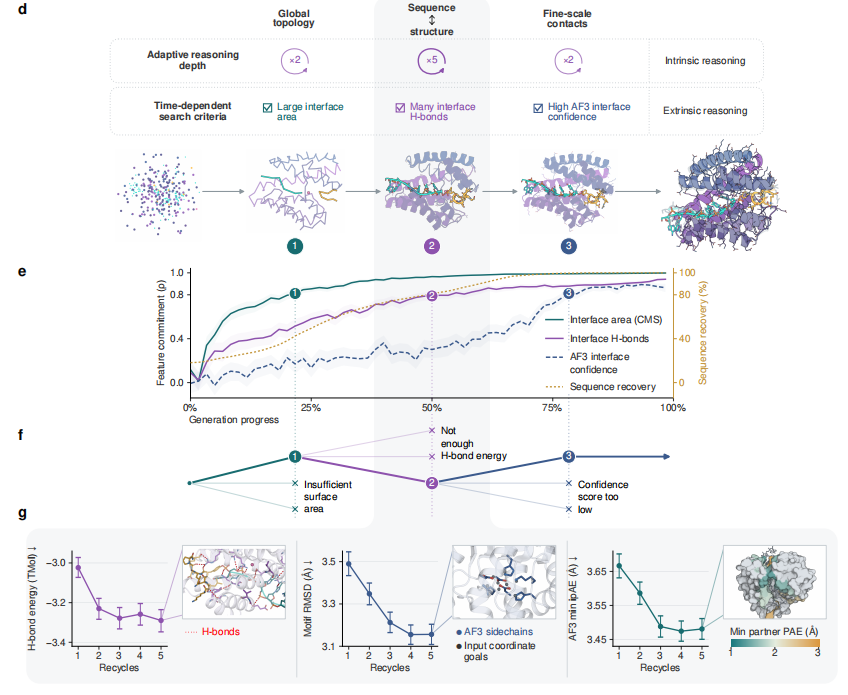
内在推論(intrinsic reasoning): 拡散時間ステップごとに循環的リファイメントを実行し、前処理段階のみで実行するのではなく、全過程に適用する。循環回数は時間ステップに応じて変化させることで、生成の重要な段階においてより詳細な最適化を可能にする。
外在推論(extrinsic reasoning): 複数の生成軌跡にわたるトラジェクトリ検索を行い、サンプリング結果をユーザー定義指標を満たす設計に偏らせる。同時に、外在推論は特徴や時間ステップに紐づく形で実行可能であり、対応する分子特徴がゆっくりと形成・安定化した後に、各指標に対してターゲットを絞った最適化を行う。すべての目標を全期間にわたって一括で最適化するのではなく、段階的に処理する。
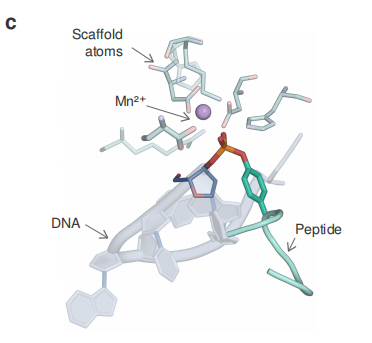
研究チームは、モデルの生成プロセスを解析するためのテストケースとして、柔軟な基質におけるペプチド鎖とDNA間の共有結合を切断する酵素の設計を行った。下図参照:
研究により、異なる設計目標が生成プロセスの異なる時点で段階的に達成されることが明らかになった。具体的には、500本の軌跡において、独立した推論結果と最終結果の相関が約0.8に達する時点は以下の通りであった:
- 界面面積:生成プロセスの約20%で予測可能;
- 水素結合:約50%で予測可能;
- AlphaFold3(AF3)界面信頼度:約80%で予測可能。
推論時の検索プロセスでは、界面面積、水素結合、AF3界面信頼度の順に軌跡をフィルタリングし、各検出ノードで現在の基準から逸脱した軌跡を打ち切る。この時系列検索により、潜在空間を効率的に走査し、すべての基準を満たす出力結果を見つけることができる(下図参照)。単純なサンプリングと比較して、上記のケースでは、GPU時間あたりで得られるユニークな合格設計の数が3倍になった。
多くの革新、特に内在/外在の二重推論の導入により、RFD4-Proteinaは従来のタンパク質生成モデルの2つのボトルネック——カバーできる分子化学空間の制限と、結合した化学-幾何学制約を満たすための効率的な検索能力の不足——を突破した。これにより、タンパク質設計は単純な拡散サンプリングから、推論、物理的制約、配列-構造の共同最適化を備えた、大統一の生体分子設計パラダイムへと進化した。
シミュレーションベンチマークと湿式実験によるモデル能力の二重検証
異なる分子シナリオでの検証
研究チームはまず、計算機シミュレーションテストにおいて、RFD4-Proteinaを他の生成型手法、ハルシネーション手法、構造リファイメント手法と比較した。テストタスクは4つのカテゴリーを含み、タンパク質バインダー設計(24ターゲット)、低分子バインダー設計(77ターゲット)、酵素スキャフォールド構築(37ターゲット)、DNAバインダー設計(3ターゲット)である。下図参照:
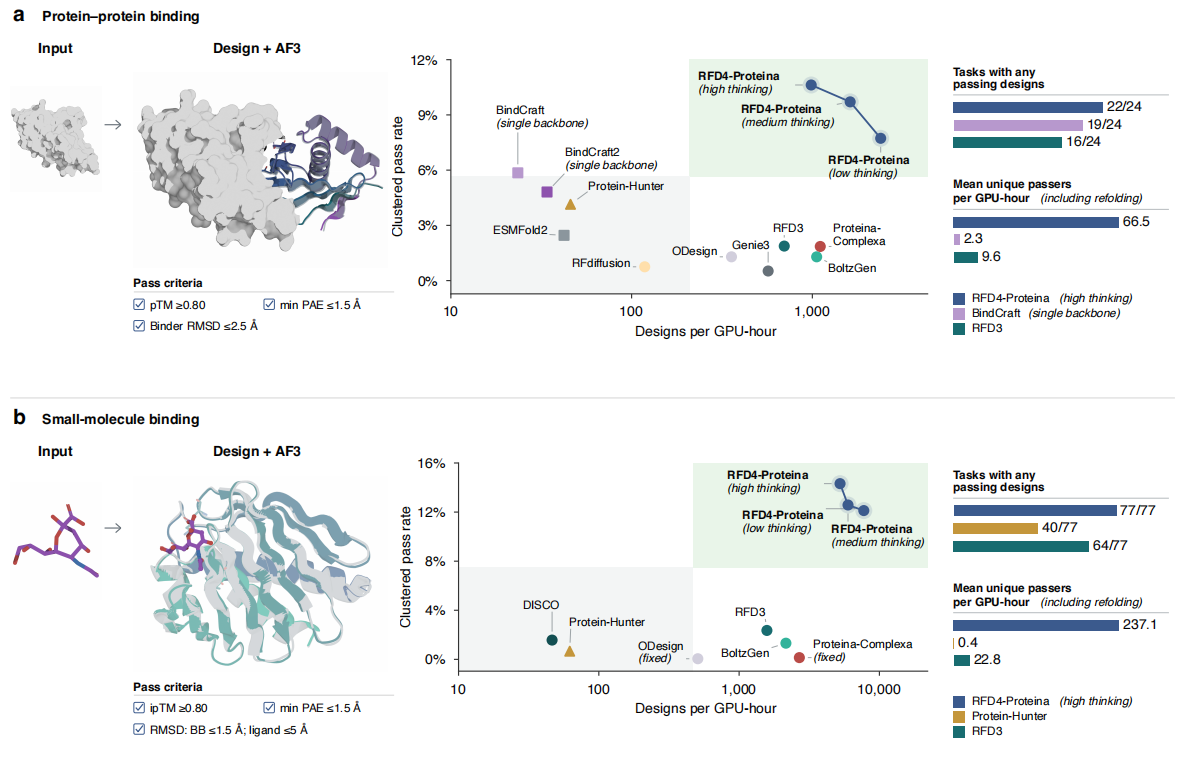
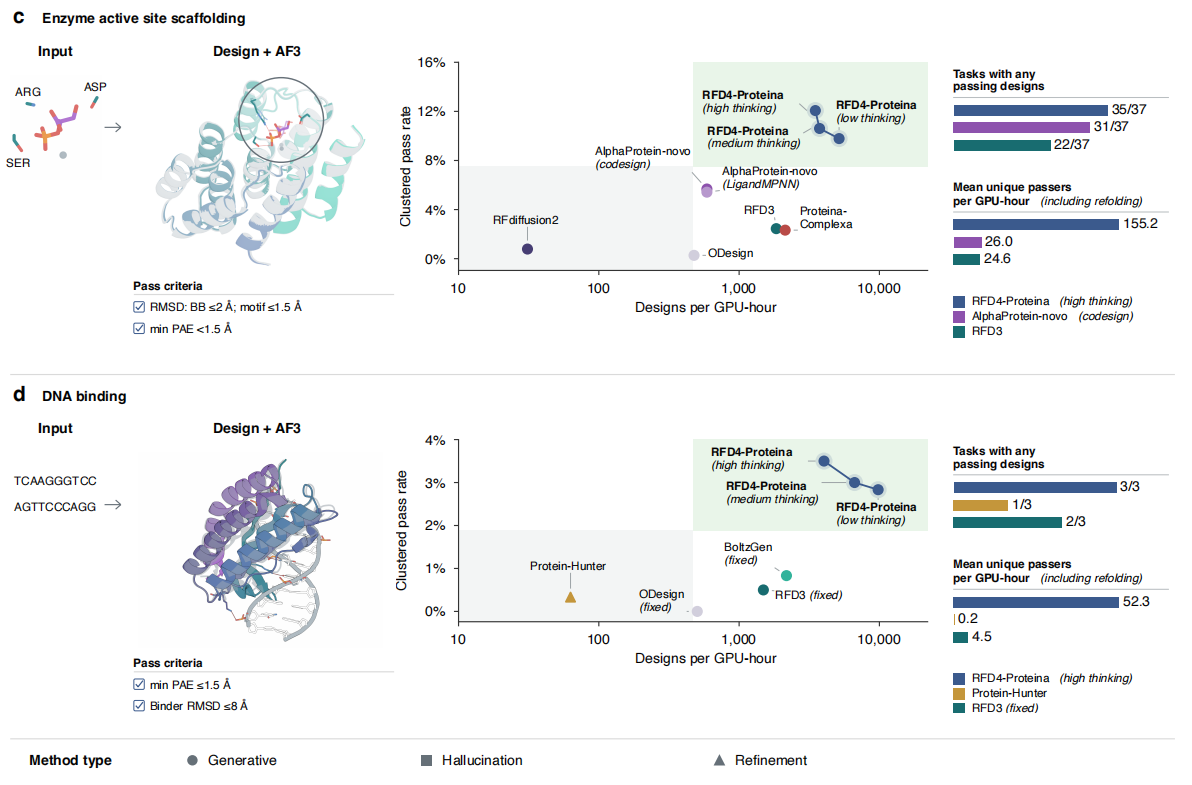
評価は、AF3によって設計配列から独立に予測された構造を用い、ターゲット構造との適合度、およびタスク固有の構造・信頼度基準への適合性を評価することで実施した。2つのコア指標は以下の通り:
- 生成スループット(generation throughput): GPU時間あたりで生成できる設計数;
- クラスタリング合格率(clustered pass rate): 初期試行ごとに基準を通過し、かつ構造が重複しない合格構造の割合。
high-thinking条件下、タンパク質結合タスクにおいて、RFD4-Proteinaのクラスタリング通過率は10.6%で、次点のBindCraftモデルはわずか5.9%であり、生成スループットは42倍向上した。酵素骨格構築タスクでは、RFD4-Proteinaのクラスタリング通過率は12.1%で、AlphaProtein-novo共同設計モデルは5.7%であり、生成スループットは5.9倍向上した。低分子結合タスクでは、RFD4-Proteinaのクラスタリング通過率は14.3%で、RFD3は2.4%であり、生成スループットは3.3倍向上した。さらに、77個のターゲットすべてが設計に合格した(RFD3は64個)。DNA結合タスクでは、RFD4-Proteinaのクラスタリング通過率は3.5%で、BoltzGenは0.8%であった。
以上より、4つのベンチマークテストにおいて、RFD4-Proteinaは生成プロセス中に構造予測器のフィードバックを必要とすることなく、比較対象のすべてのベースラインモデルよりも多くの設計課題を解決でき、かつクラスタリング通過率が高く、生成速度も速い。AF3評価時間を考慮した場合、high-thinking条件下でのRFD4-ProteinaによるGPU時間あたりの有効クラスタ生成数は、タンパク質結合、低分子結合、酵素骨格構築、DNA結合タスクにおいて、次点のベースラインモデルよりもそれぞれ5倍、10.4倍、6倍、5.5倍高い。
内在的な推論能力の向上が設計成功率を高めるかどうかをテストした際、タンパク質結合タスクではLow、Medium、high-thinking設定において、クラスタリング通過率が7.7%から10.6%へと段階的に向上した。低分子結合タスクでは12.1%から14.3%へ、酵素骨格構築タスクでは9.8%から12.1%へ、DNA結合タスクでは2.8%から3.5%へと向上した。しかし、計算量の増加に伴い生成スループットは逆に低下した。例えばタンパク質結合タスクでは、GPU時間あたりの設計数が2388(Low)から986(high-thinking)へ減少した。
生成プロセス中に分子環境のコンフォメーション変化を許容することが設計成功率を高めるかどうかをテストした際、RFD4-Proteinaはhigh-thinking条件下で、設計タンパク質とリガンドコンフォメーションの同時生成を許容すると、クラスタリング通過率が8.1%から14.3%へ向上した。ターゲット側鎖とDNAコンフォメーションの変化を許容すると、タンパク質結合のクラスタリング通過率は9.6%から10.6%へ、DNA結合のクラスタリング通過率は2.0%から3.5%へ向上した。
外部ツールからのデータ統合により外部推論が設計成功率を高められるかどうかを探究した結果、外部ツールを活用することで有望でない軌跡に計算リソースを浪費することを回避できることが判明した。酵素骨格構築や低分子結合などの高難度タスクにおいて、合格可能な独自設計を生成する効率はそれぞれ22.6%および24.6%向上した。
最後にアブレーション実験により、トライアングル更新、アダマール積演算、内在的推論メカニズム、探索的訓練がすべてモデル性能向上の重要なコンポーネントであることが個別に確認された。特にトライアングル乗算更新が性能向上に最も大きく寄与し、その他のコンポーネントもそれぞれ異なる程度のゲインをもたらしており、単一のテクニックだけで全体が向上したわけではない。
特定の分子ワークフローにおける検証
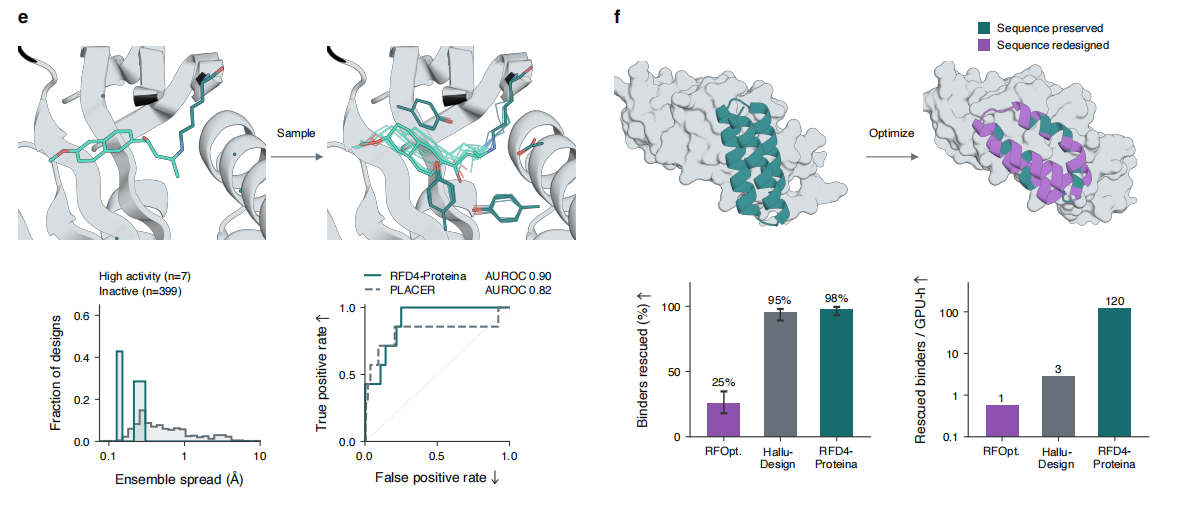
新規設計の生成を検証した後、研究者らは同一モデルが構築、評価、および設計最適化に必要な他の分子プロセスをサポートできるかどうかを評価した。実験では、シーケンス割り当て、コンフォメーション収集、既存構造の最適化など、6つのユースケースをテストし、以下に示す図の通りであった。
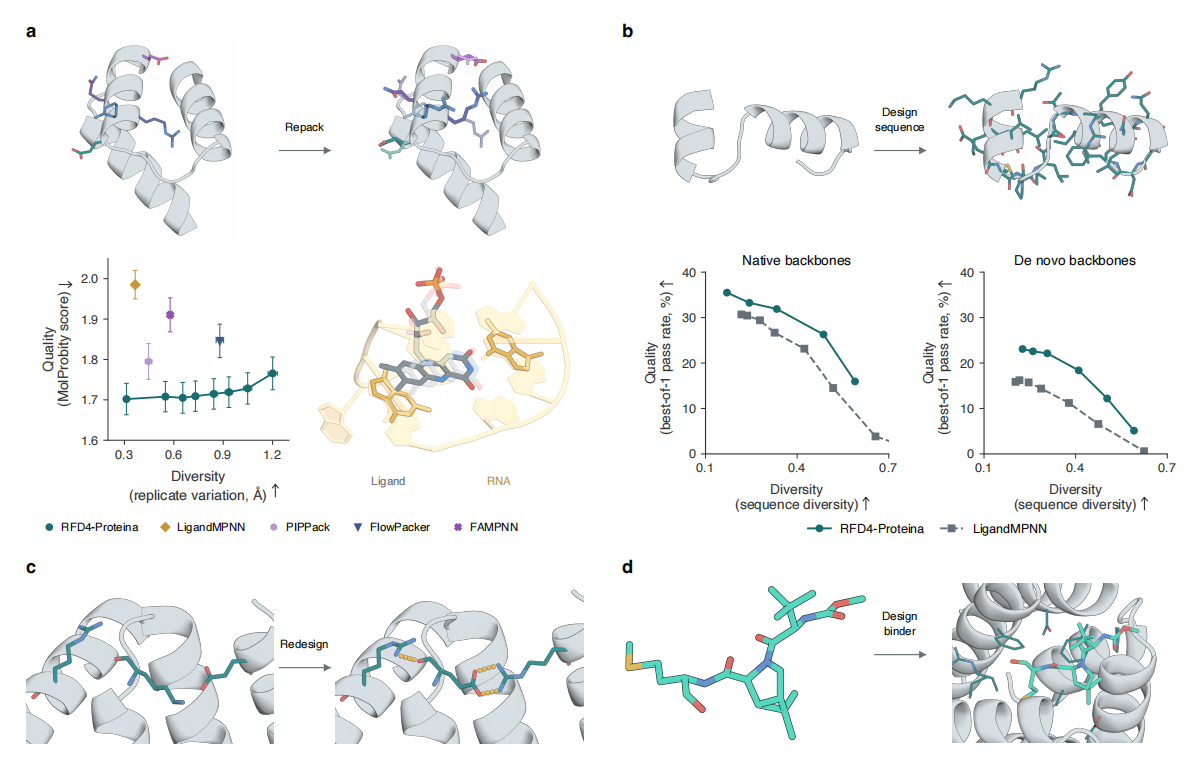
サイドチェーンパッキングタスクにおいて、タンパク質シーケンスと主鎖座標が与えられた場合、RFD4-Proteinaは類似のコンフォメーション多様性下で、LigandMPNNよりも低い平均MolProbityスコア(1.70対1.99)を達成した。
MolProbity:タンパク質構造の品質チェックツールであり、結合長、結合角、空間衝突、不合理なねじれなどを検証するために使用される。サイドチェーンパッキングタスクで最も一般的な指標である。MolProbityスコアが低いほど、構造の立体化学的品質が高いことを意味する。
サンプリングノイズを大きくすることで、側鎖間の平均差異を0.31 Åから1.20 Åへ拡大でき、これは構造品質を損なうことなく多様なコンフォメーションを生成できることを示している。なお、MolProbityスコアは1.70から1.77へとわずかに上昇するのみであった。
固定骨格シーケンス設計タスクでは、RFD4-Proteinaを逆折りたたみツールとして評価した。結果は、天然タンパク質骨格とRFD3により生成されたデノボ設計骨格という2つのテストセットで検証され、RFD4-Proteinaは一致する多様性下でも一貫してLigandMPNNよりも高い通過率を示した。
柔軟な骨格配列設計タスクにおいて、13組のHBDesigner標的/オフターゲットテストセット上で、柔軟な骨格を用いたRFD4-Proteinaの平均特異度差△ipTMは0.25であり、固定骨格のRFD4-Proteinaは0.18にとどまり、この値はすべての比較手法の中で最高値となった。
△ipTMは標的とオフターゲット間のipTMの差を表す。数値が高いほど、オフターゲットタンパク質に対する目標標的への相対的な特異性が高いことを示す。
リガンド立体化学タスクにおいて、RFD4-Proteinaのキラリティー正解率は98.8%、二重結合立体化学(double-bond stereochemistry)正解率は92.2%、PoseBustersスコア(全体的な化学的妥当性)は92.3%であり、いずれもAF3および2位の生成モデルを上回った。
設計最適化タスクにおいて、生成済みだが実験テストを通過していない設計が救済可能かどうかの検証では、各設計試行あたり6回の最適化を行った後、RFD4-Proteinaは102件の設計のうち100件を成功裡に修復できたが、HalluDesignは97件のみ、RFoptimizationは26件のみ修復できた。また、RFD4-Proteinaの所要時間が極めて短く、他のどのモデルよりも短いことを強調しておきたい。
ウエットラボによる検証
研究チームは、特異性を中核的制約とする多様な設計タスクにおいて、RFD4-Proteinaの性能をテストした。
まず、カルモジュリン(下図参照)を対象とした。カルモジュリンには2つの状態、すなわちカルシウム非結合状態(あるコンフォメーション)とCa²⁺結合状態(完全に異なるコンフォメーションへの変化)が存在し、研究チームの目標は後者の状態のカルモジュリンのみを認識することであった。テストされた18の設計配列のうち、12種がカルシウム依存的な結合を示し、測定された見かけの親和力の範囲は69 pMから37 nMであった。
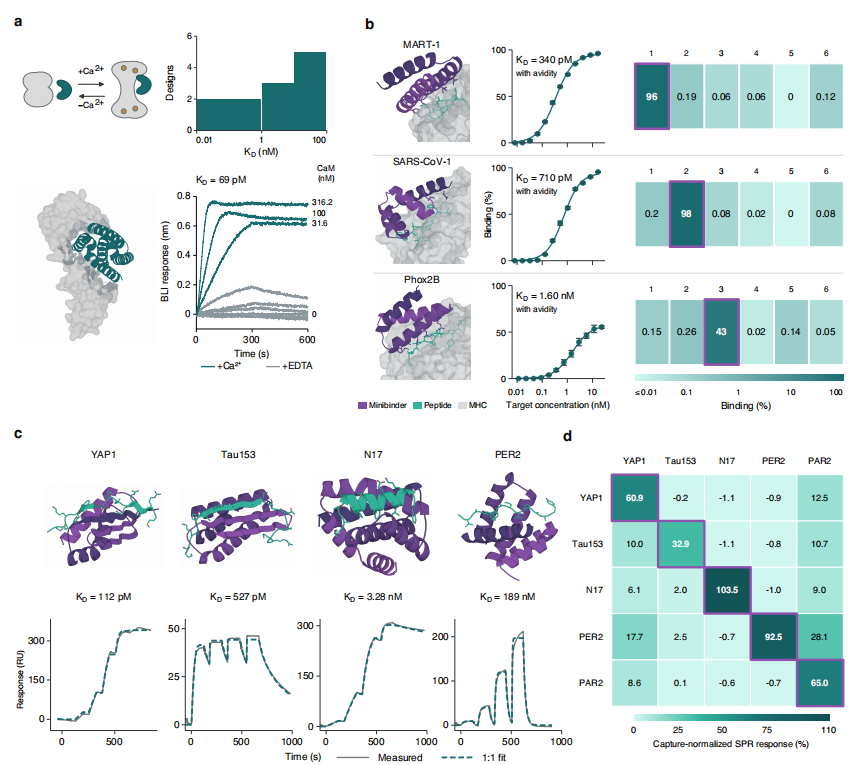
pMHCタスクにおいて、研究チームはRFD4-Proteinaが目標ペプチドと正確に結合する能力を評価し、MART-1、SARS-CoV-1膜タンパク質ペプチド、Phox2Bペプチドに対する結合タンパク質を設計した。イーストディスプレイによるチトラーション実験の結果、3種のペプチドに対する結合タンパク質の見かけの半最大結合濃度はそれぞれ340 pM、710 pM、1.60 nMであった。さらに、配列が非常に類似したオフターゲットペプチドを用いたスクリーニングを行った結果、すべてのケースにおいて100倍以上の特異性差が達成された。
注目すべきは、一部の目標ペプチドは非目標ペプチドと非常に似通っていることである。例えば、Phox2Bのオフターゲットペプチドは目標ペプチドとアミノ酸1個分しか異なっておらず、SARSのオフターゲットペプチドは2個のアミノ酸しか異なっていない。これは、RFD4-Proteinaが高特異性のpMHCミニバインダーを設計できることを示している。
IDRsタスクにおいて、研究チームはRFD4-Proteinaのコンフォメーション推論能力が、8種のIDRsペプチドに対するバインダー設計を可能にするかをテストした。結果は、2種類のIDRペプチドカテゴリーにおいてそれぞれ1件の失敗が生じたものの、残りの6件すべてにおいて高親和性のバインダーが得られた。そのうち、YAP1およびTauエピトープIDRを標的とする最初期の人工デノボ設計結合タンパク質は、それぞれ112 pMおよび527 pMの最強親和力を示した。
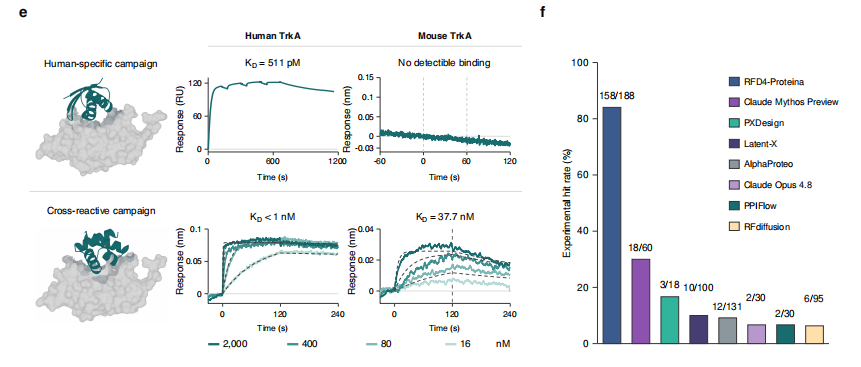
キナーゼタンパク質設計タスクにおいて、研究チームは2つの課題を設定した。一つ目は、ヒトTrkAのみと結合し、マウスTrkA、ヒトTrkB、TrkCとは結合しないこと。二つ目は、ヒトTrkAとマウスTrkAの両方と結合するが、TrkBおよびTrkCとは依然として結合しないことである。種間交差反応性実験において、94件の設計のうち18件が期待される結合パターンを満たした。ヒトTrkAに対する最高親和力は1 nM未満、マウスTrkAに対する親和力は37.7 nMであった。
特別な制約を課さず、ヒトTrkAとの結合のみを要求した場合、RFD4-Proteinaの188件の設計のうち158件が1 μM未満の親和力を達成し、成功率は84%に達した。これに対し、オープンソースのタンパク質設計ツールを利用できるClaude Mythos Previewでは18/60のみが成功し、成功率はわずか30%であった。
その後、研究者らはRFD4-Proteinaが翻訳後修飾を含む複合分子系、すなわち糖鎖修飾とリン酸化を処理できるかをテストした。
糖鎖修飾タスクにおいて、従来の限界は、Man5~Man8のような短い高マンノース型糖鎖のみを安定して捕捉でき、最も長いMan9やGlcMan9を安定して保持できないことであった。今回の目標は、RFD4-Proteinaを用いてより小さなタンパク質を設計し、主にMan9/GlcMan9を保持しつつ、末端のマンノースが依然として接触可能にすることであった。
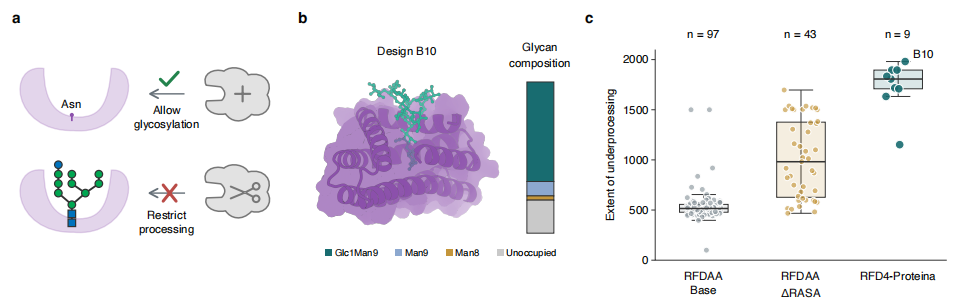
結果として、RFD4-Proteinaは従来のRFDAAと比較して計算設計の通過率を大幅に向上させた。LC-MS/MS質量分析検出において、9件の設計のうち8件で、修飾位点の90%以上が高マンノース型糖鎖(トリミングされていない状態)であり、未トリミングの成功率はこれまでのすべての手法を上回った。
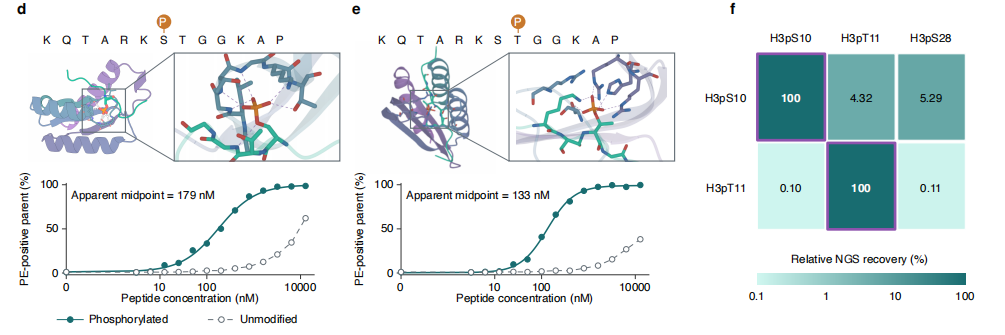
リン酸化課題において、研究チームはヒストンH3尾部の隣接する2つの部位、すなわちpS10とpT11に対し、それぞれリン酸化依存性の結合タンパク質を特定することを試みました。その結果、ヒットした配列は優先的に自身のリン酸化ターゲットと結合し、また隣接する非ターゲット部位のリン酸化に対して選択性を維持することが示されました。これは、RFD4-Proteinaが単なるリン酸基団の認識にとどまらず、局所的な化学的微小環境の微細な差異、すなわちリン酸基団がどのアミノ酸に結合しているか、どの配列コンテキストにあるかまでを認識し、部位レベルでの精密な識別を実現していることを強調しています。
酵素設計は、多様な化学反応に対して高効率、グリーン、かつ選択性の高い生体触媒を生み出すことが期待される、非常に有望な研究分野です。研究チームはRFD4-Proteinaの活性中心構築能力を検証するために、2つの高難易度の酵素課題、すなわち二金属酵素とシステインリガーゼを選定しました。
まず、RFD4-Proteinaがパラオキソンを加水分解するトリエステラーゼを設計できるかを検証しました。従来、チームはRFD3を用いて2つの金属補因子とパラオキソン基質の周りに6つの触媒残基を配置し、比較的低い触媒効率(最高でも4±3 M⁻¹s⁻¹)を得ていました。本実験では、触媒効率を向上させるために触媒残基を2つ追加するという仮説を立てました。
結果として、8残基を含むこのモック酵素において、RFD4-Proteinaの1000件の設計のうち15件(1.5%)が一般的なモチーフのRMSDおよび基質信頼度の基準を通過しました。一方、RFD3の設計1000件中、基準を通過したものは1件もありませんでした。
RMSDが小さいほど、設計された活性部位が理想的なtheozyme構造に近いことを意味する
後続のスクリーニング実験では、RFD4-Proteinaの288件の設計のうち89件が活性を示し、これは47の骨格ファミリーのうち25ファミリーにわたるものでした。対照的に、RFD3の設計192件はいずれも活性を示しませんでした。
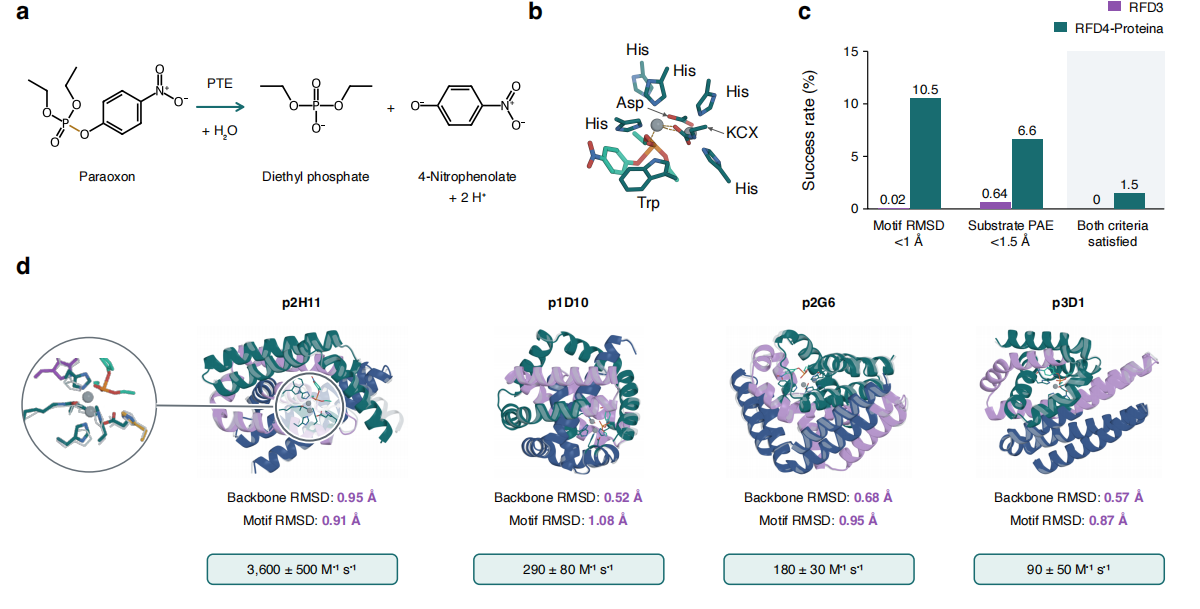
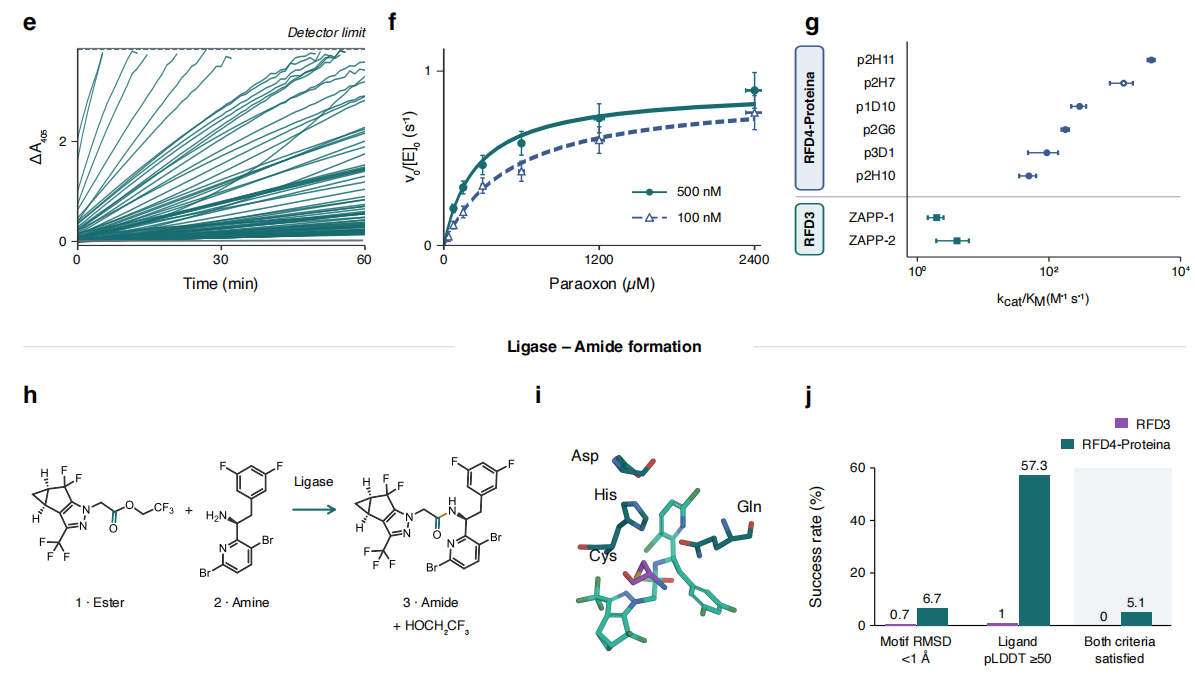
その後、チームは4つの骨格ファミリーから6つの設計について特性評価を行いました。そのうち最高の設計では、触媒効率がそれぞれkcat / KM = 3600 ± 500 M⁻¹s⁻¹、kcat = 0.9 s⁻¹に達し、非触媒加水分解反応速度と比較して1.5 × 10⁷倍の加速が見られました。同定された6つの設計はいずれも、従来の6残基モック酵素トリエステラーゼよりも触媒効率が10〜1000倍高くなりました。
研究チームはさらに、RFD4-Proteinaがバイオ医薬品向けに結合形成酵素を設計できるかを探究しました。テスト対象として選定された反応は、Lenacapavir合成経路の1ステップであり、活性化エステルと立体障害の大きいキラリティを持つアミンとのアミド結合形成反応を含んでいます。
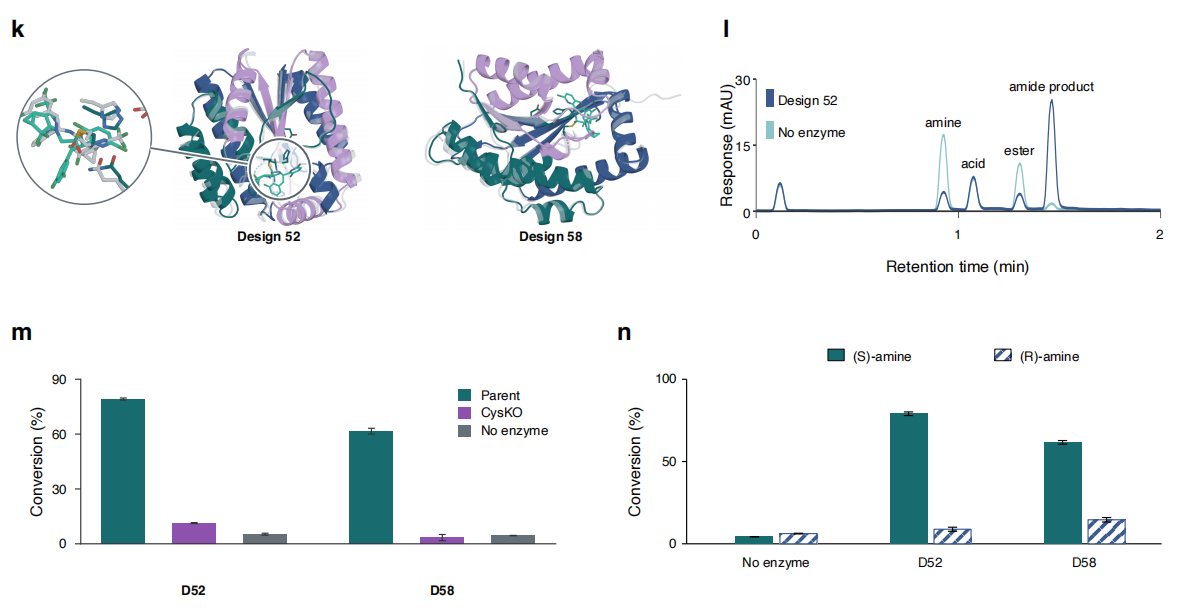
計算スクリーニングの結果、RFD4-Proteinaの計算通過率はRFD3より数桁高いことが示されました。実験テスト用に67の設計配列の遺伝子を選択したところ、そのうち4つの設計配列でアミド結合の形成が成功し、生成した目標S-アミン製品の含有量がバックグラウンド値を上回りました。対照的に、従来RFD3を用いて設計した72件はいずれも有効な結果を得ていません。
2つの最良設計は52番および58番であり、それぞれS配置アミンの79%および61%をアミドに変換しました。R配置アミンの変換率はわずか8.8%および14.6%でした。酵素なしの対照群の変換率はそれぞれ4.3%および6.2%でした。
おわりに
総じて、RFD4-Proteinaは物理モデリングと深層学習を深く融合させ、PDBデータベース内の天然タンパク質の統計分布の学習だけに依存するのではなく、物理シミュレーションによる合成データセットを新たに導入し、微分可能なRosetta力場を用いて生成過程を監督・誘導しています。これにより、過去に複数の専用ツールが分断的に機能していた状況を打破し、潜在空間推論パラダイムにより、タンパク質設計を盲目的なサンプリング生成から、評価と反復最適化を伴う制約付き探索モードへと転換させ、コンピュータベンチマークテストにおいて複雑な分子設計の成功率と計算効率を大幅に向上させました。
もちろん、モデルは完璧ではありません。推論スケジュールのパラメータは小規模な予備実験による微調整を必要とする場合が多く、複雑な課題は一定の計算コストを伴います。しかし、オープンソース化されたコードと重みは、この分野全体にとって新たな出発点を提供しており、AI生成と生物物理学的規則を緊密に結合させることでタンパク質設計の境界を拡張し、研究者がコンピュータ設計分子を、湿式実験で実際の機能を有する結合タンパク質や新規人工酵素へとより迅速に変換し、創薬や合成生物学により多くの可能性をもたらすことを示唆しています。