Command Palette
Search for a command to run...
Tutoriel En Ligne | Couvrant 40 Langues / Traitement D’une Heure D’enregistrement : NVIDIA Ouvre Le Code Source De Nemotron 3.5 Transcribe, Permettant La Reconnaissance Vocale, La Traduction Et Les Questions-réponses Audio Pilotées Par Instructions

Après la transcription d’un enregistrement de réunion, de nombreux problèmes peuvent subsister : comment distinguer les interventions de plusieurs personnes ? Les termes techniques ont-ils été mal reconnus ? Si l’on doit également créer des sous-titres ou une traduction, peut-on obtenir directement le résultat souhaité à partir de l’enregistrement ?
NVIDIA a lancé Nemotron 3.5 Transcribe, qui tente de répondre à ces différents besoins grâce aux instructions. Les utilisateurs peuvent demander au modèle de conserver les mots de remplissage oraux et les répétitions pour générer une transcription littérale ; ils peuvent aussi lui demander de reformuler l’expression pour produire un texte plus lisible. Le modèle prend également en charge l’annotation des locuteurs, la traduction vocale, la reconnaissance de la langue et le questionnement audio. Selon la fiche modèle officielle, il couvre 40 langues et peut traiter des enregistrements d’environ 1 heure au maximum ; le niveau de prise en charge varie selon les langues et les tâches.
Nemotron 3.5 Transcribe adopte une architecture MoE hybride Mamba-2 et Transformer, avec un total d’environ 34B paramètres, activant environ 4.3B paramètres par Token traité, et comprenant un encodeur audio. Les évaluations publiées par NVIDIA montrent que le modèle obtient des résultats compétitifs sur les benchmarks de reconnaissance vocale en anglais, sur les longs enregistrements et multilingues. Il est destiné au traitement audio hors ligne ; il ne faut pas le considérer comme un modèle de transcription en flux temps réel simplement parce qu’il adopte un mécanisme de découpage interne.
Actuellement, HyperAI a mis en ligne « NVIDIA-Nemotron-3.5-Transcribe-30B-A4B : reconnaissance vocale, traduction et questionnement audio pilotés par instructions », l’environnement est configuré, ce qui réduit considérablement le seuil de déploiement ⬇️
Exécution en ligne :
Plus de tutoriels en ligne :
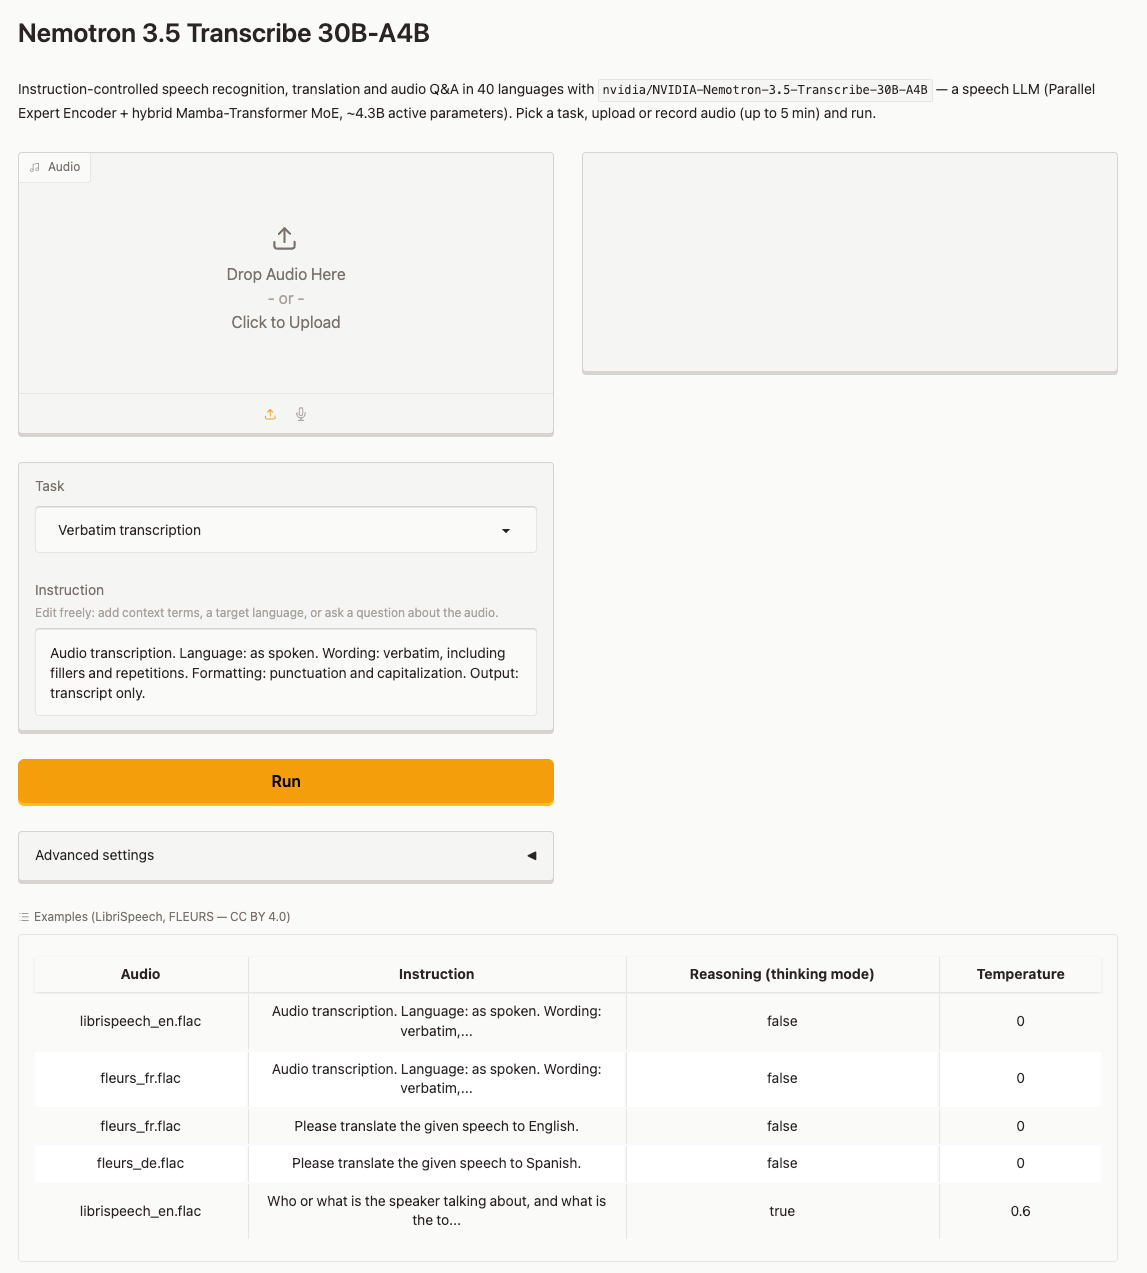
Exécution de la démo
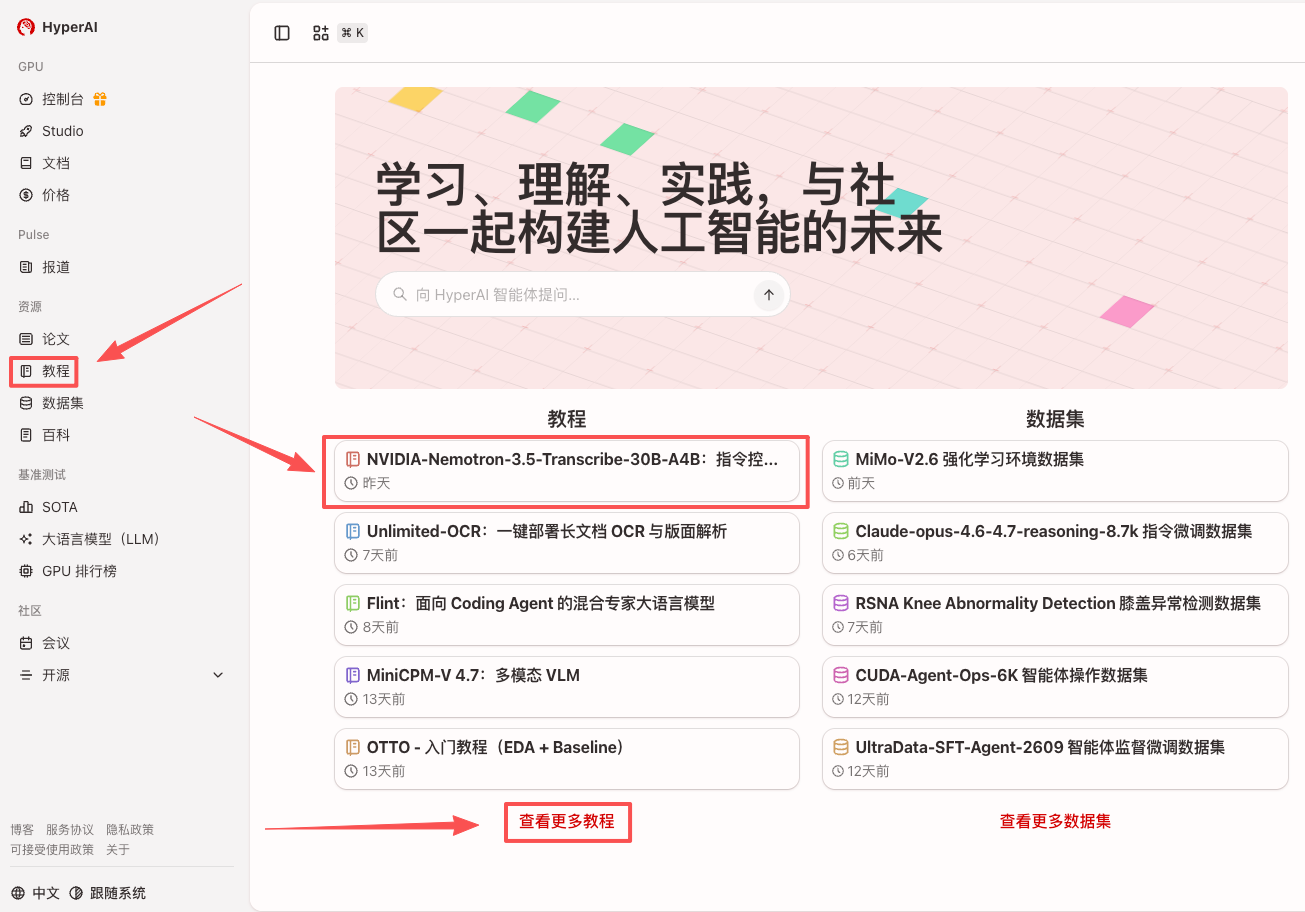
- Après être arrivé sur la page d’accueil de hyper.ai, sélectionnez la page « Tutoriels », ou cliquez sur « Voir plus de tutoriels », choisissez « NVIDIA-Nemotron-3.5-Transcribe-30B-A4B : reconnaissance vocale, traduction et questionnement audio pilotés par instructions », puis cliquez sur « Exécuter ce tutoriel ».
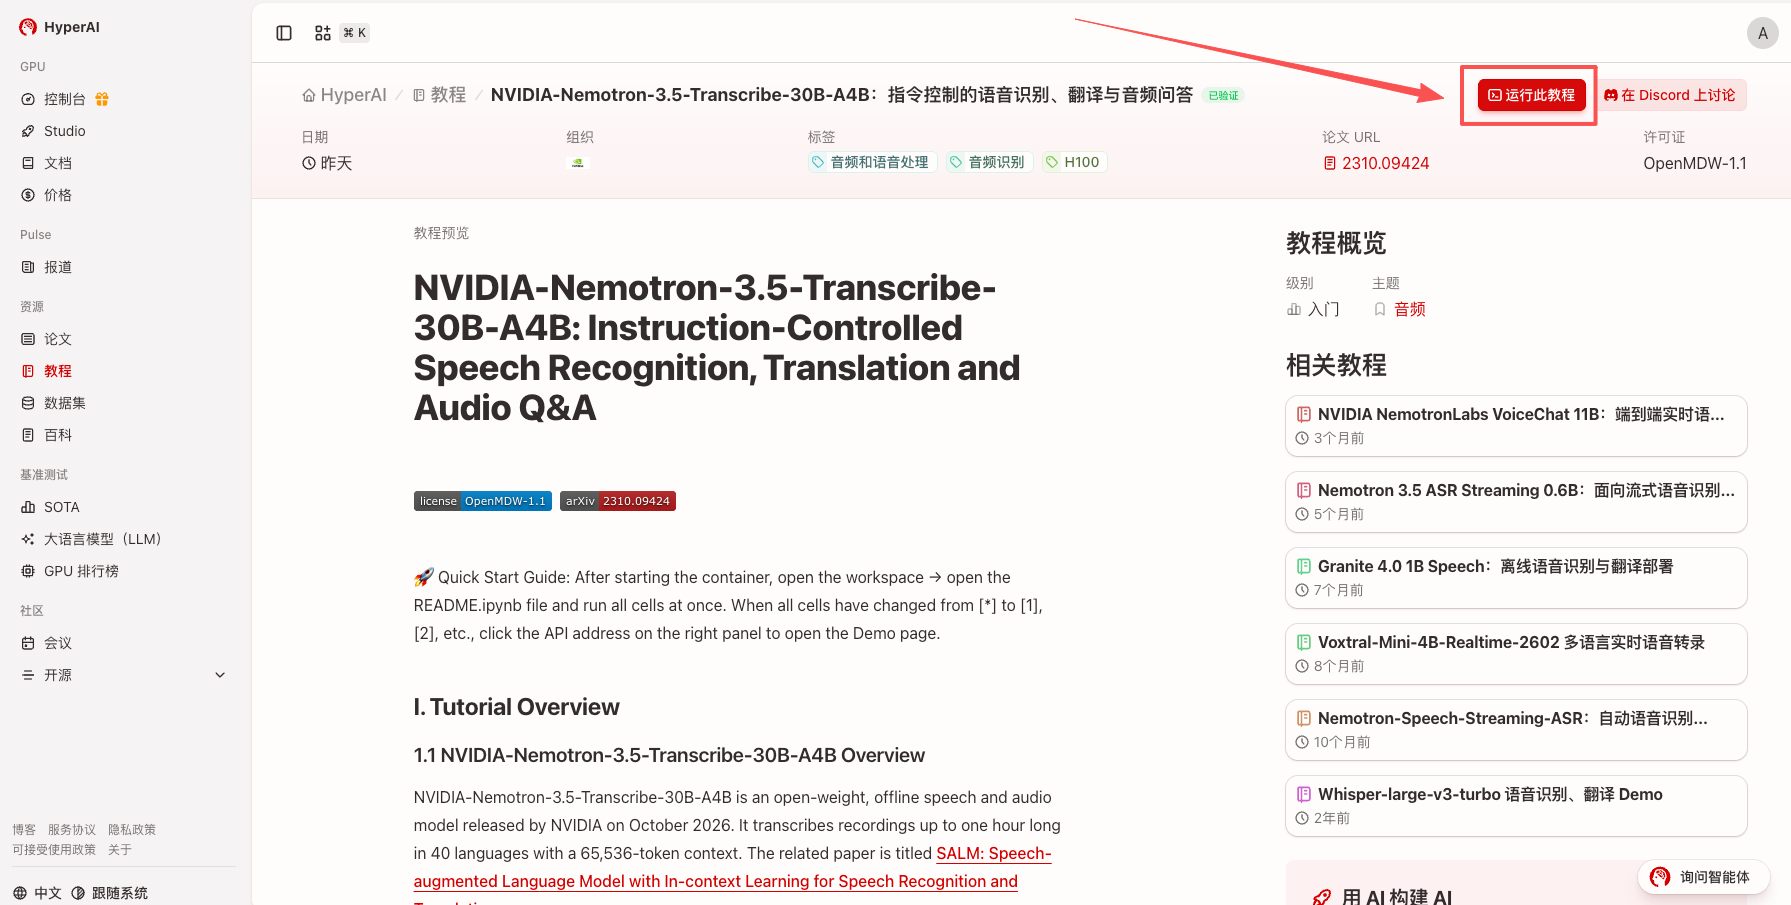
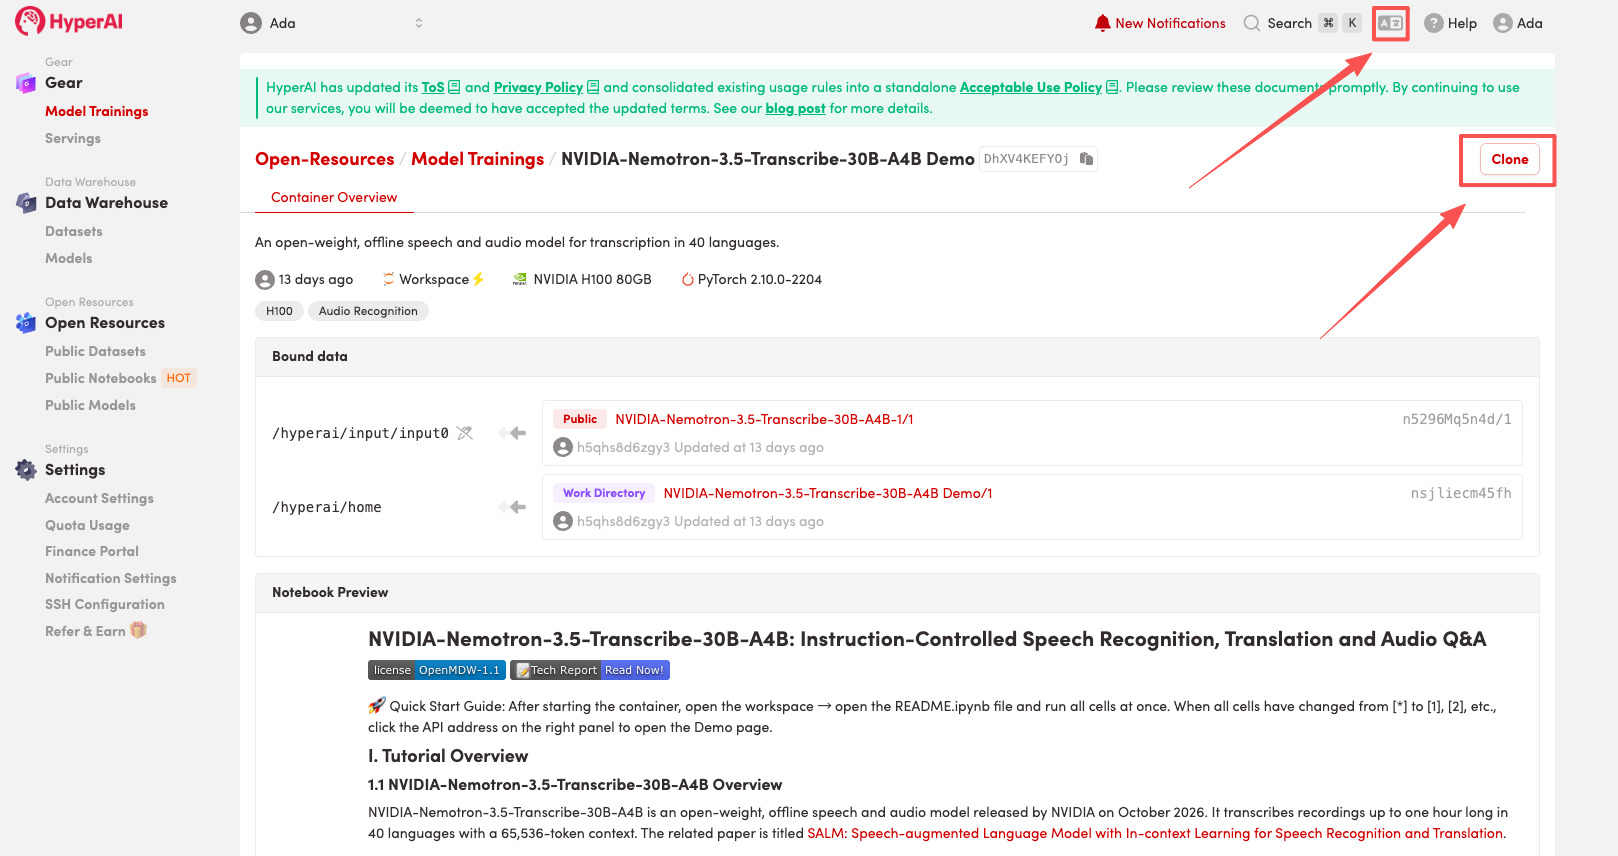
- Après la redirection, cliquez sur « Clone » en haut à droite pour cloner ce tutoriel dans votre propre conteneur.
Remarque : la langue peut être modifiée en haut à droite de la page ; le chinois et l’anglais sont actuellement proposés. Cet article de tutoriel présente les étapes en anglais.
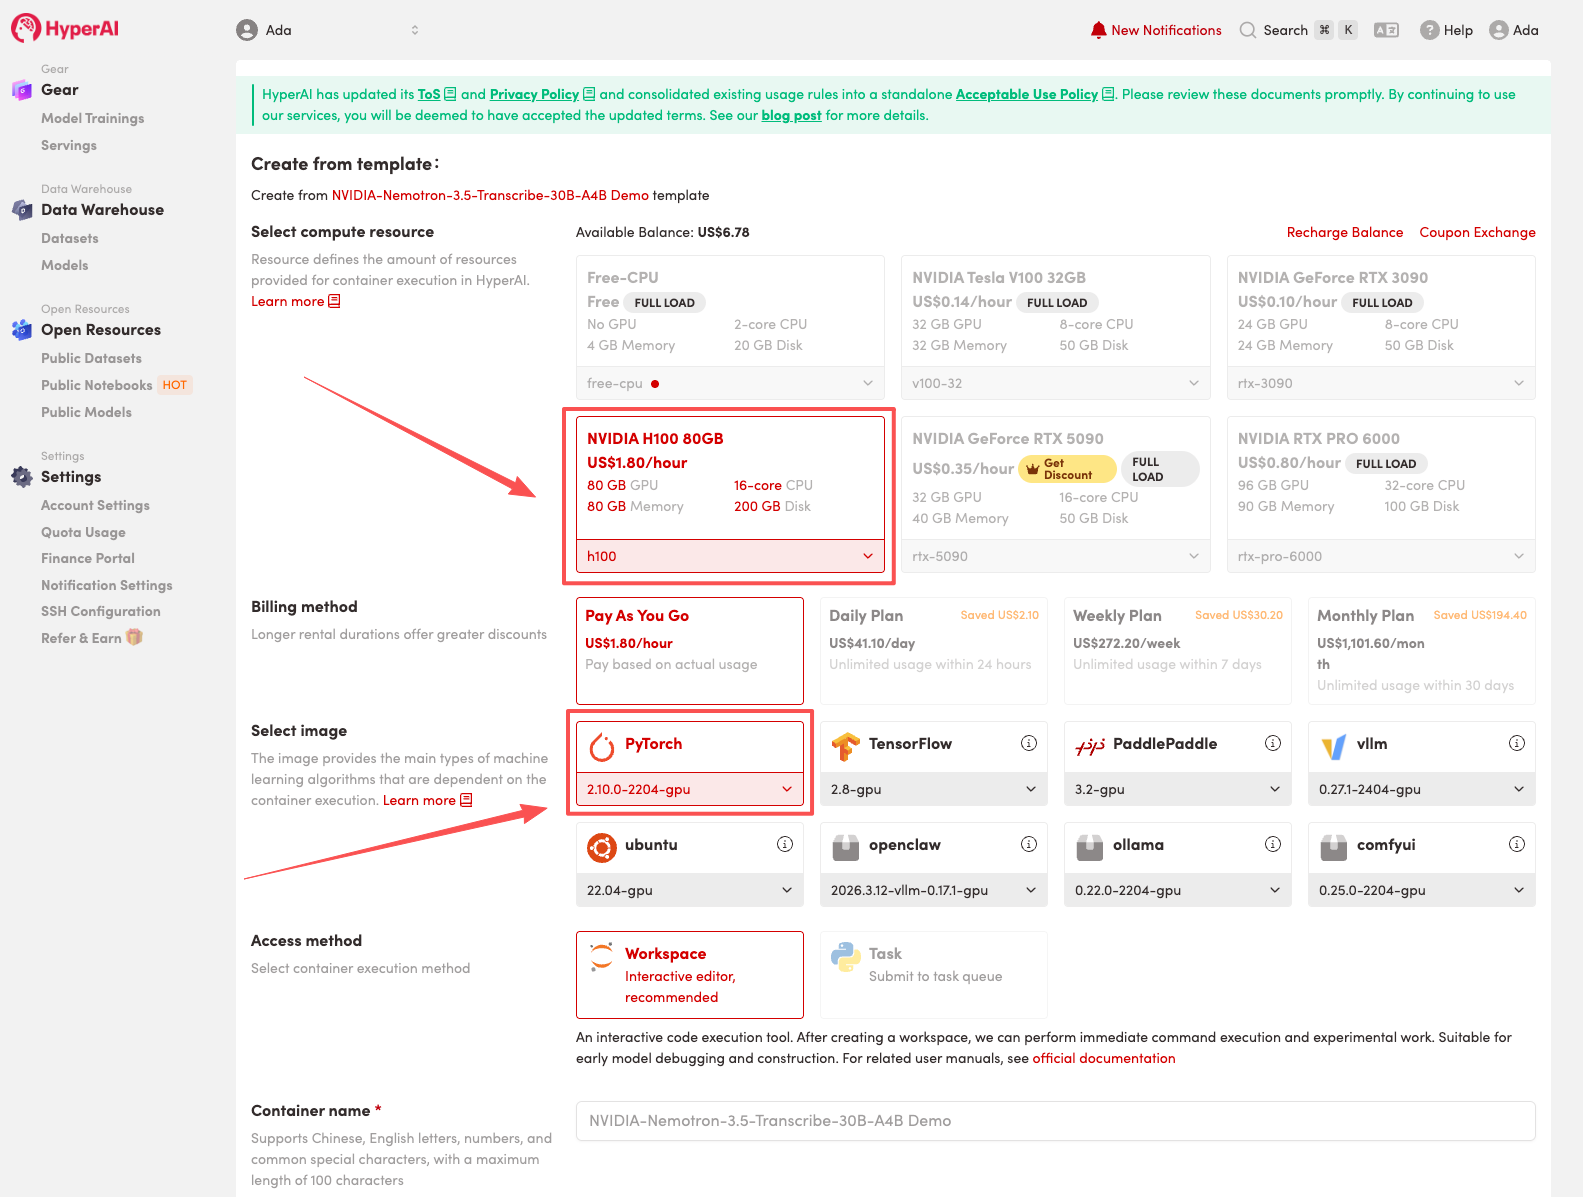
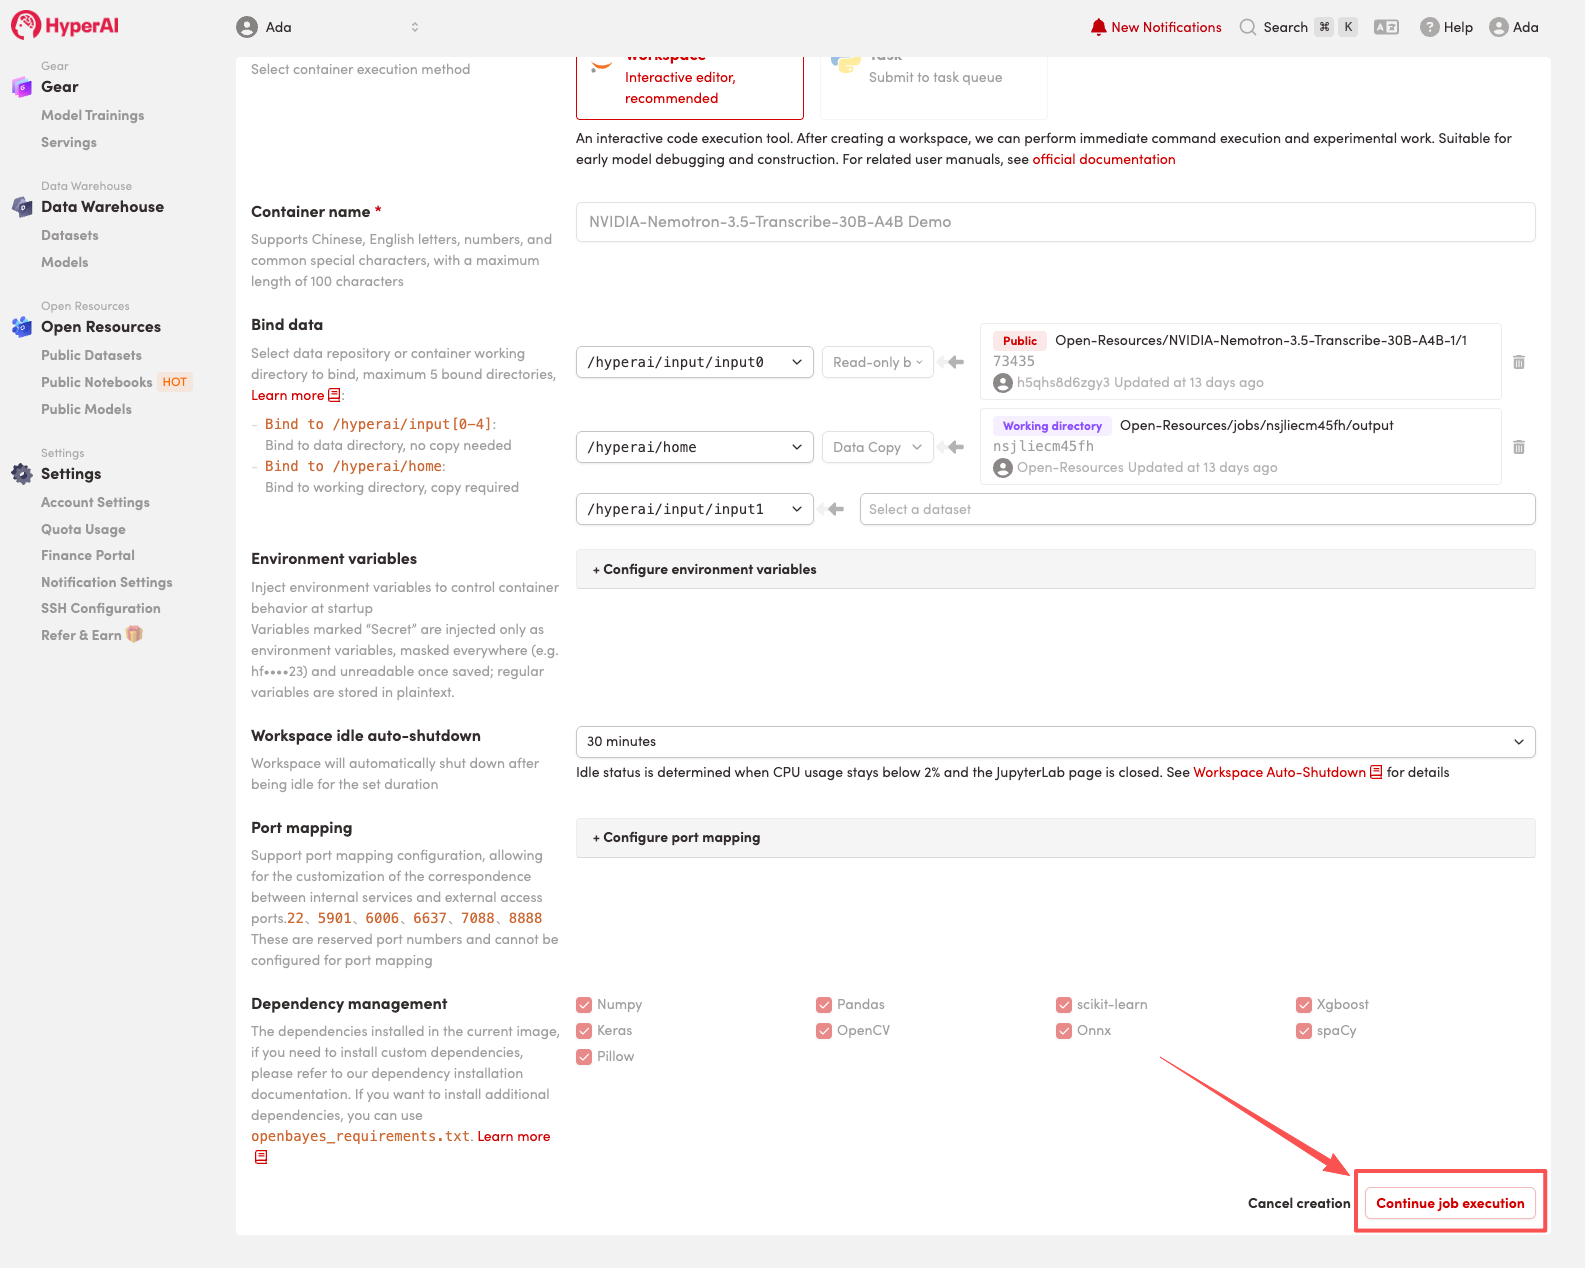
- Sélectionnez « NVIDIA H100 » ainsi que l’image correspondante, puis cliquez sur « Continue job execution (continuer l’exécution) ».
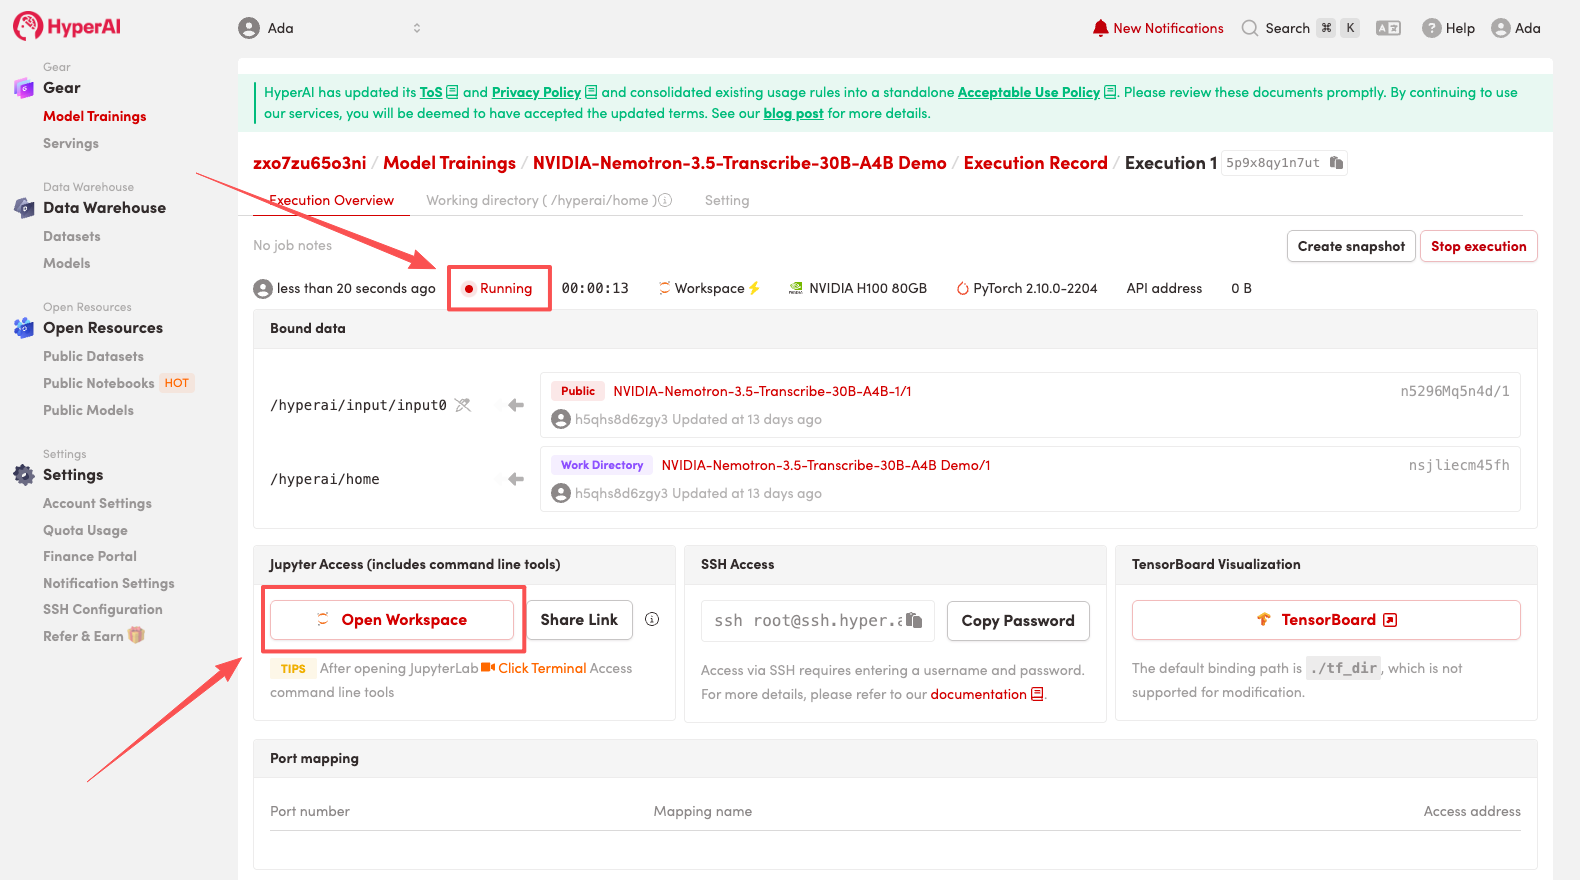
- Attendez l’allocation des ressources ; lorsque l’état passe à « Running (en cours d’exécution) », cliquez sur « Open Workspace » pour entrer dans Jupyter Workspace.
Présentation des résultats
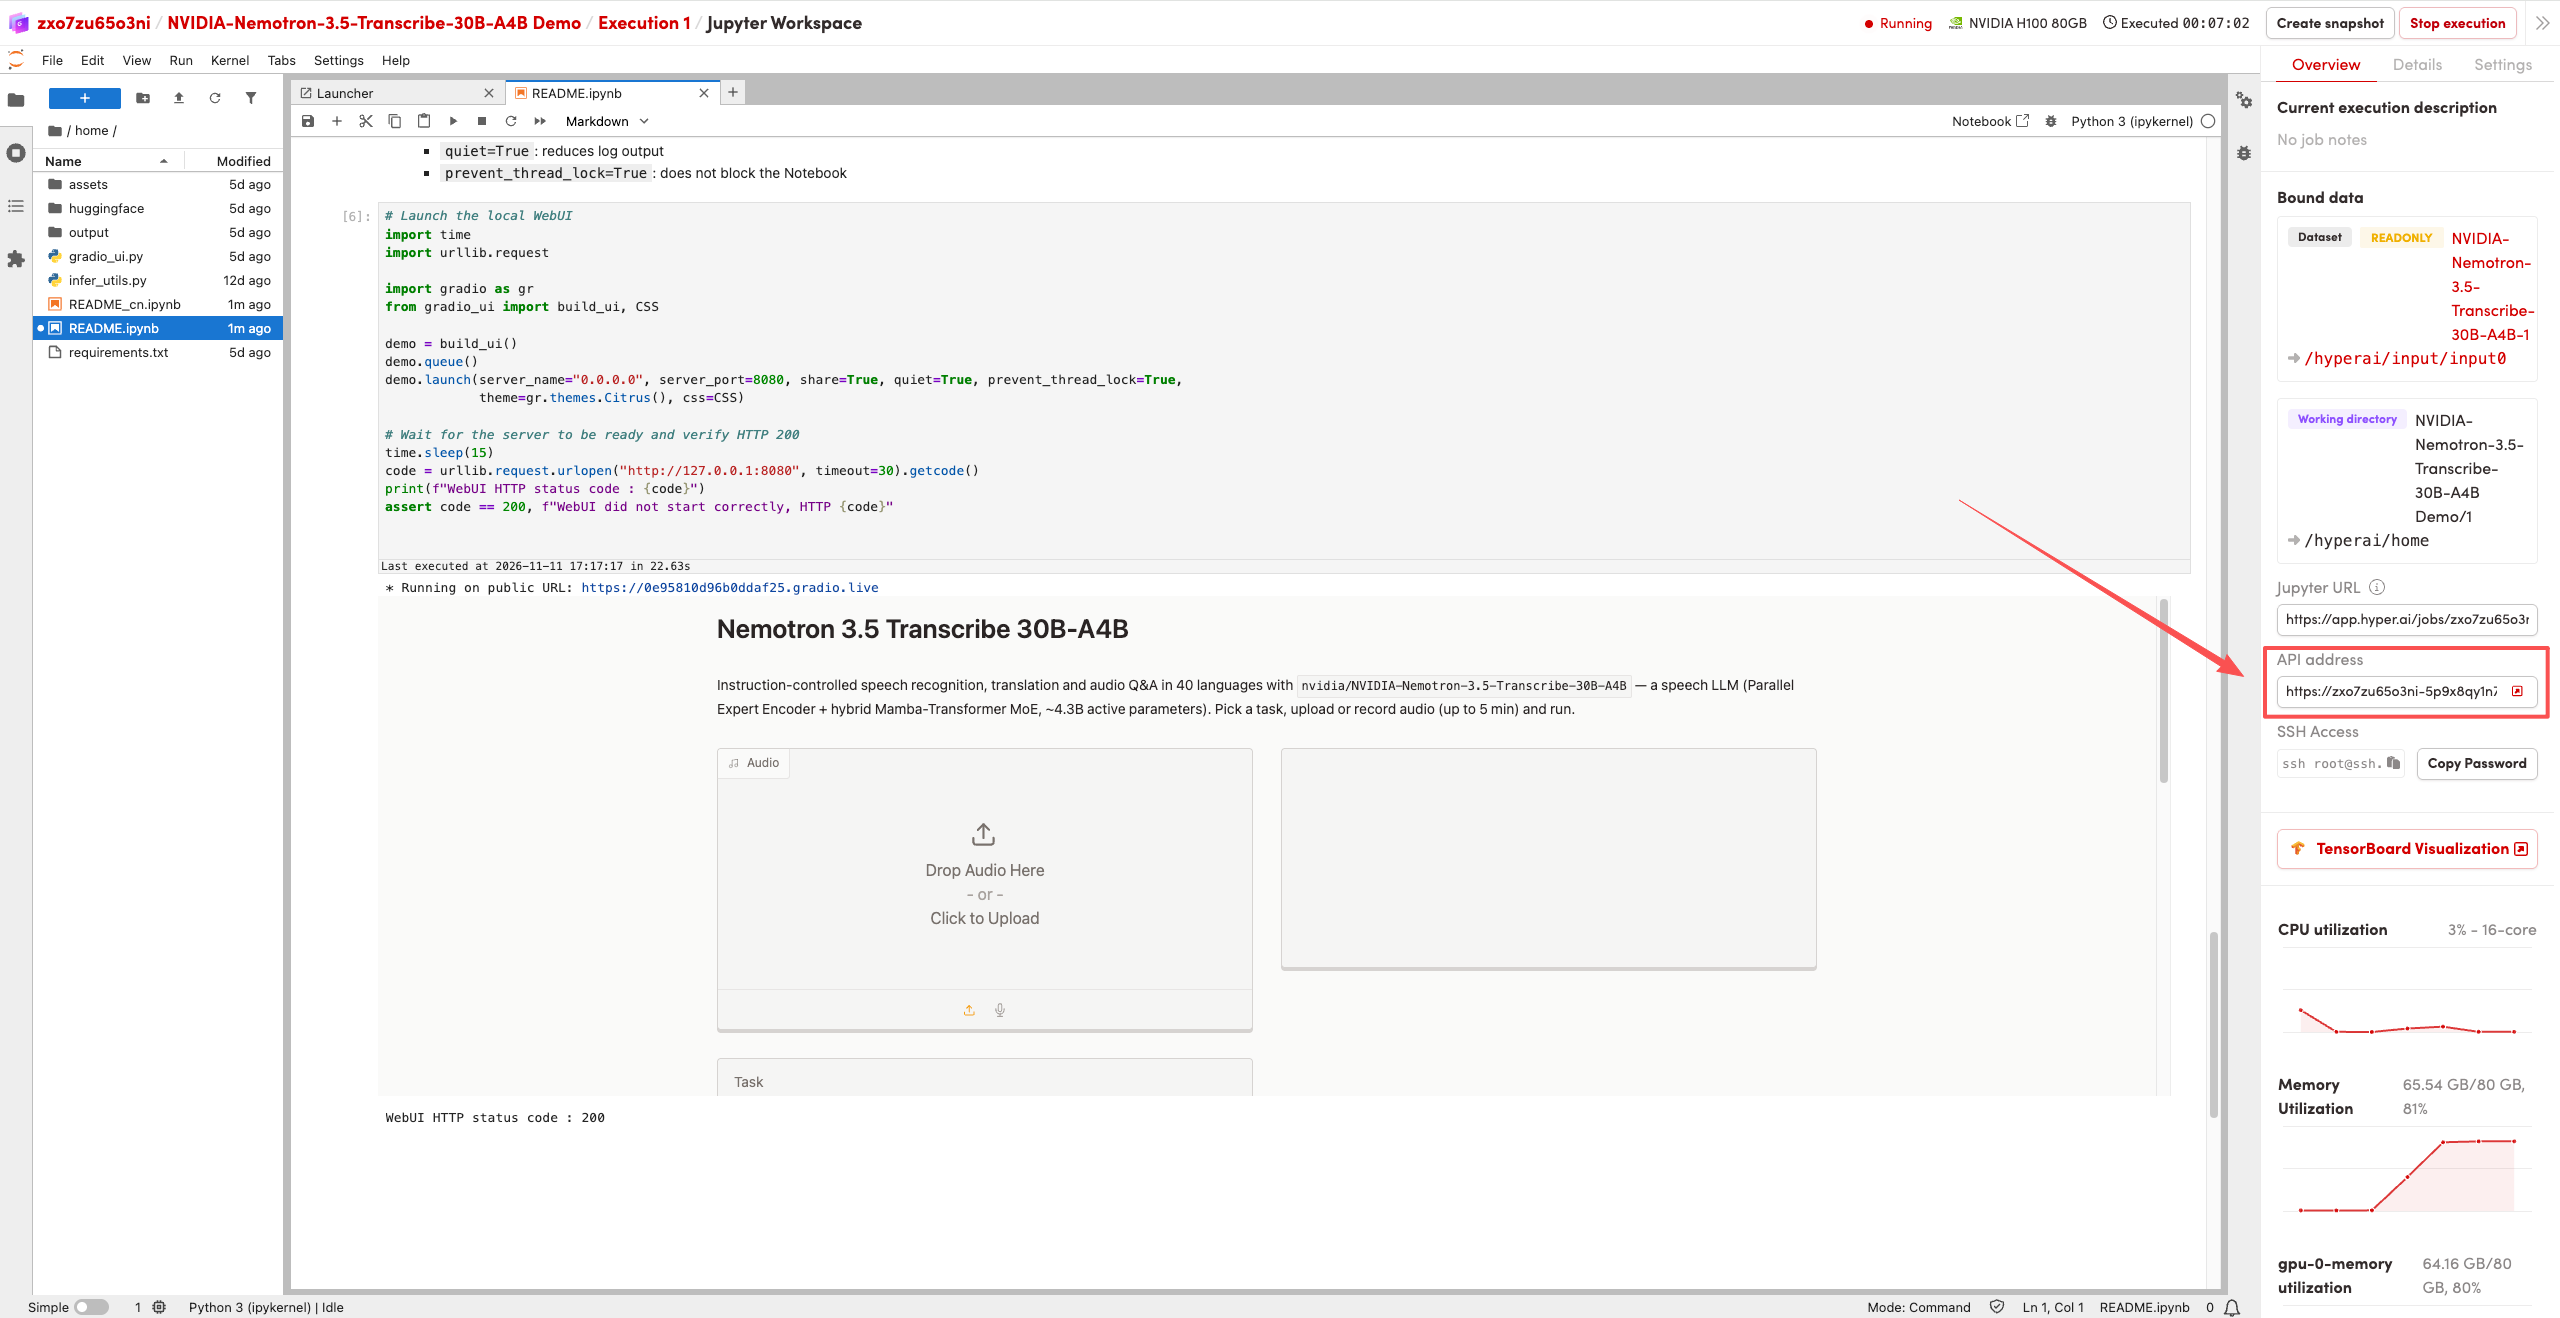
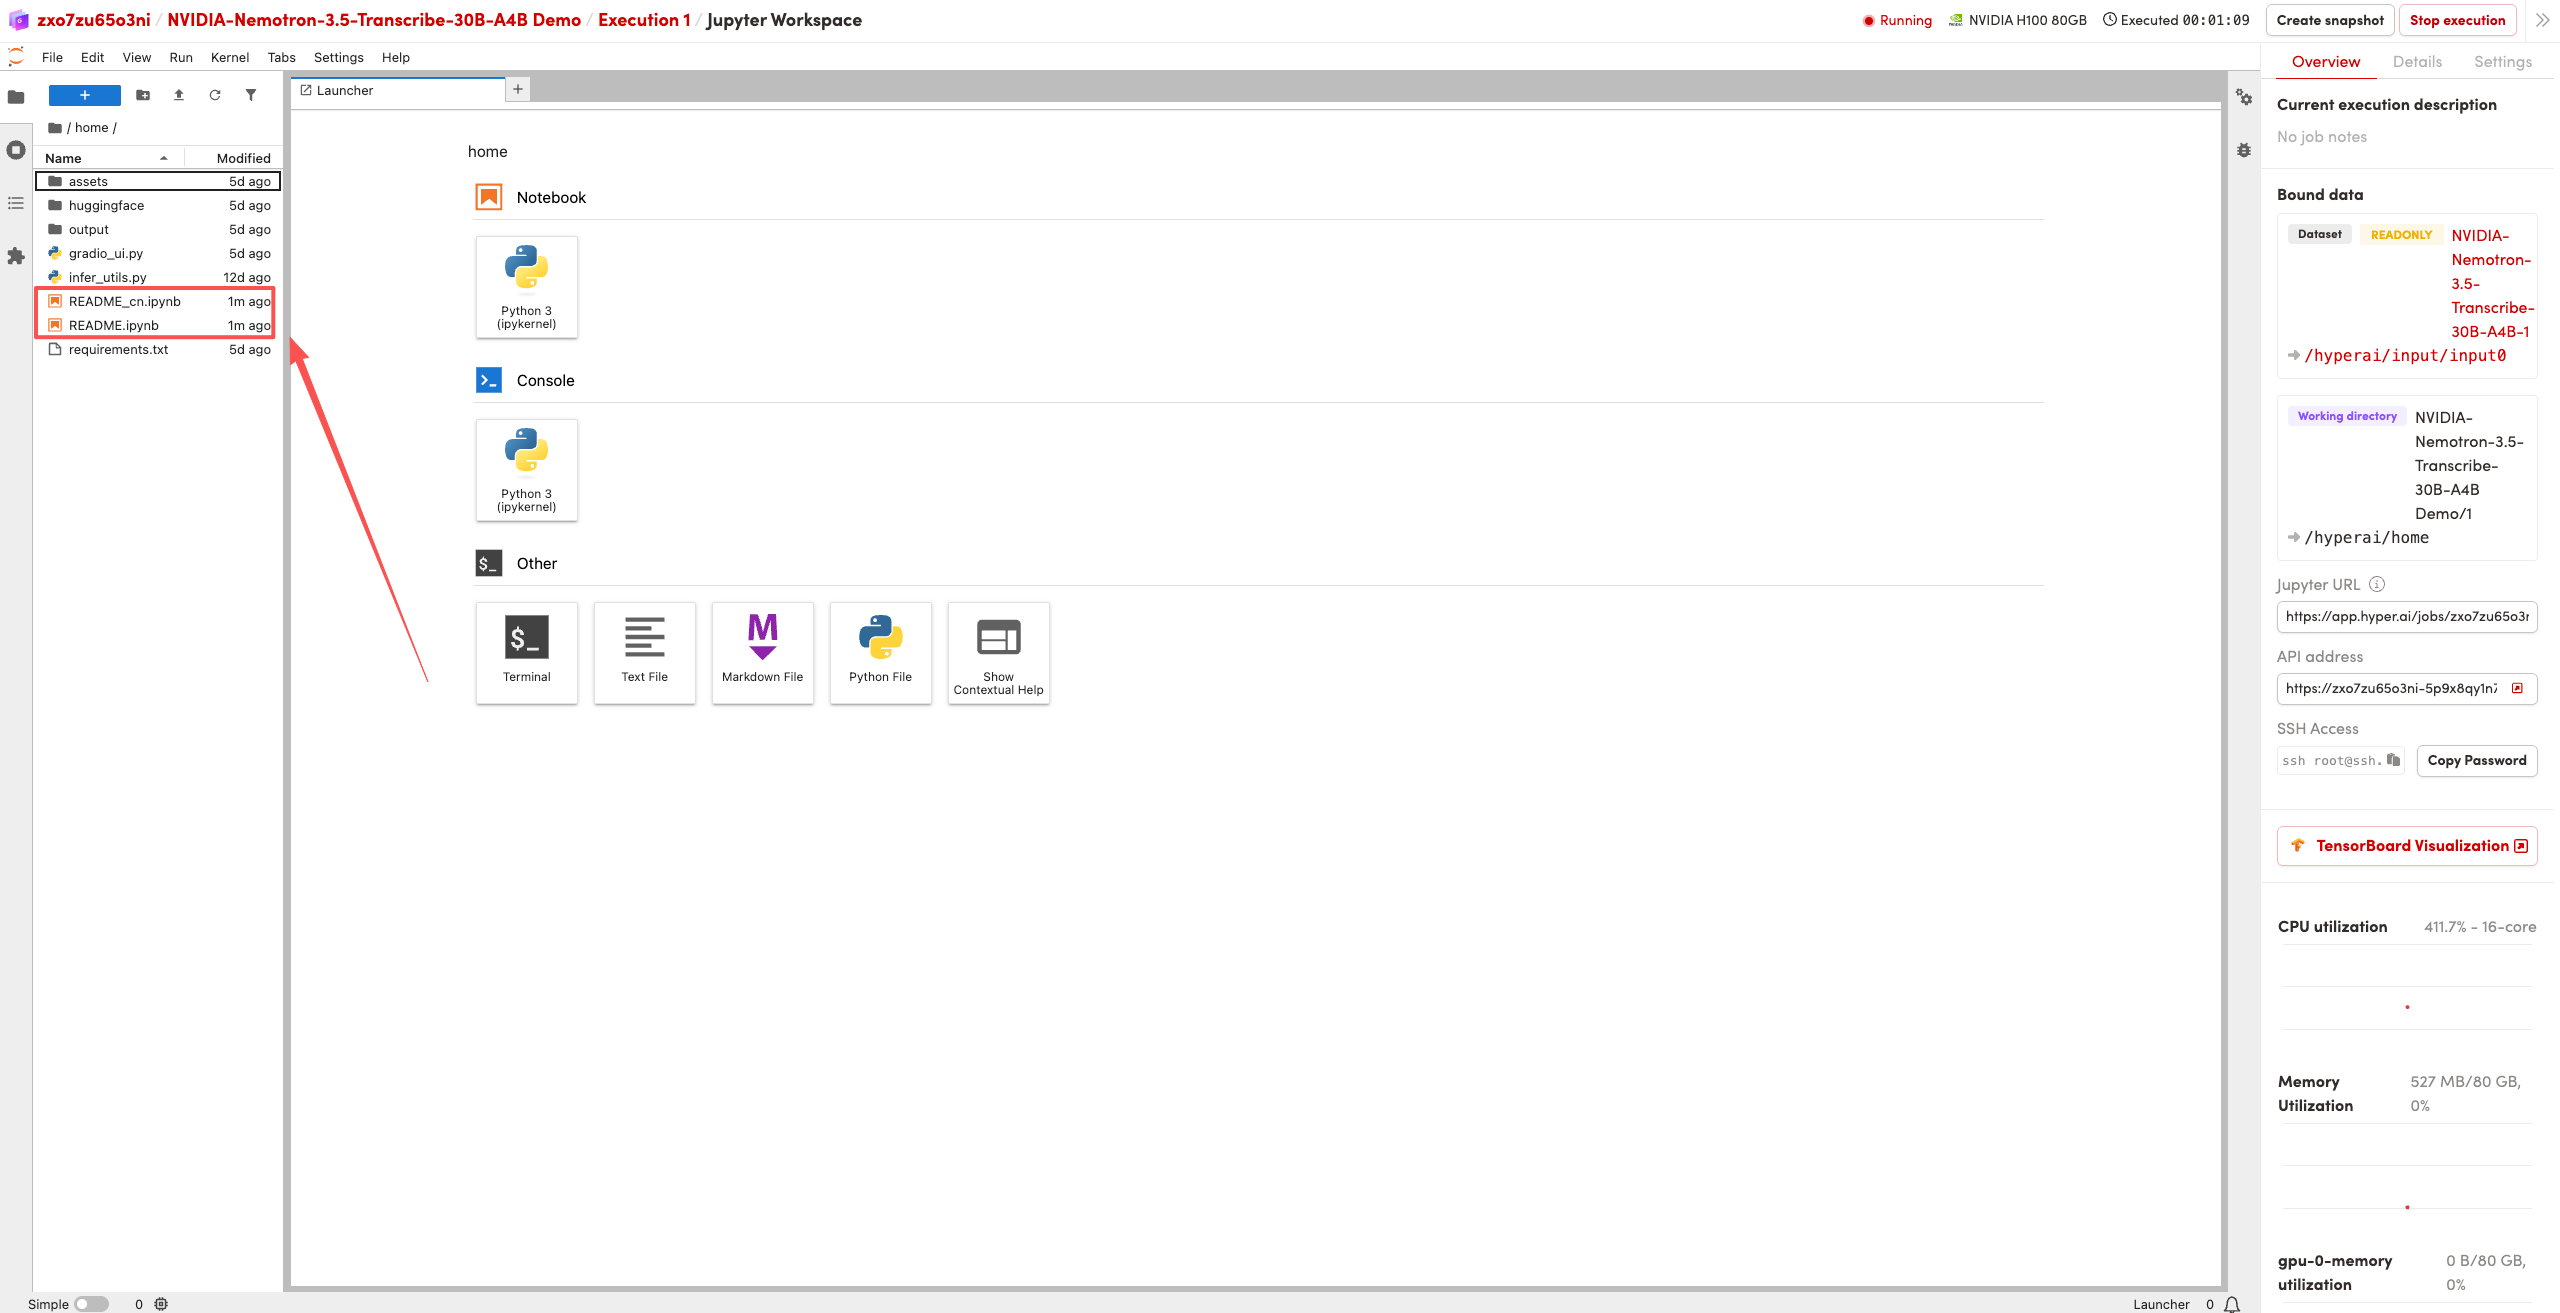
- Après la redirection, cliquez sur le fichier README à gauche ; une fois ouvert, cliquez sur « Run (Exécuter) » en haut.
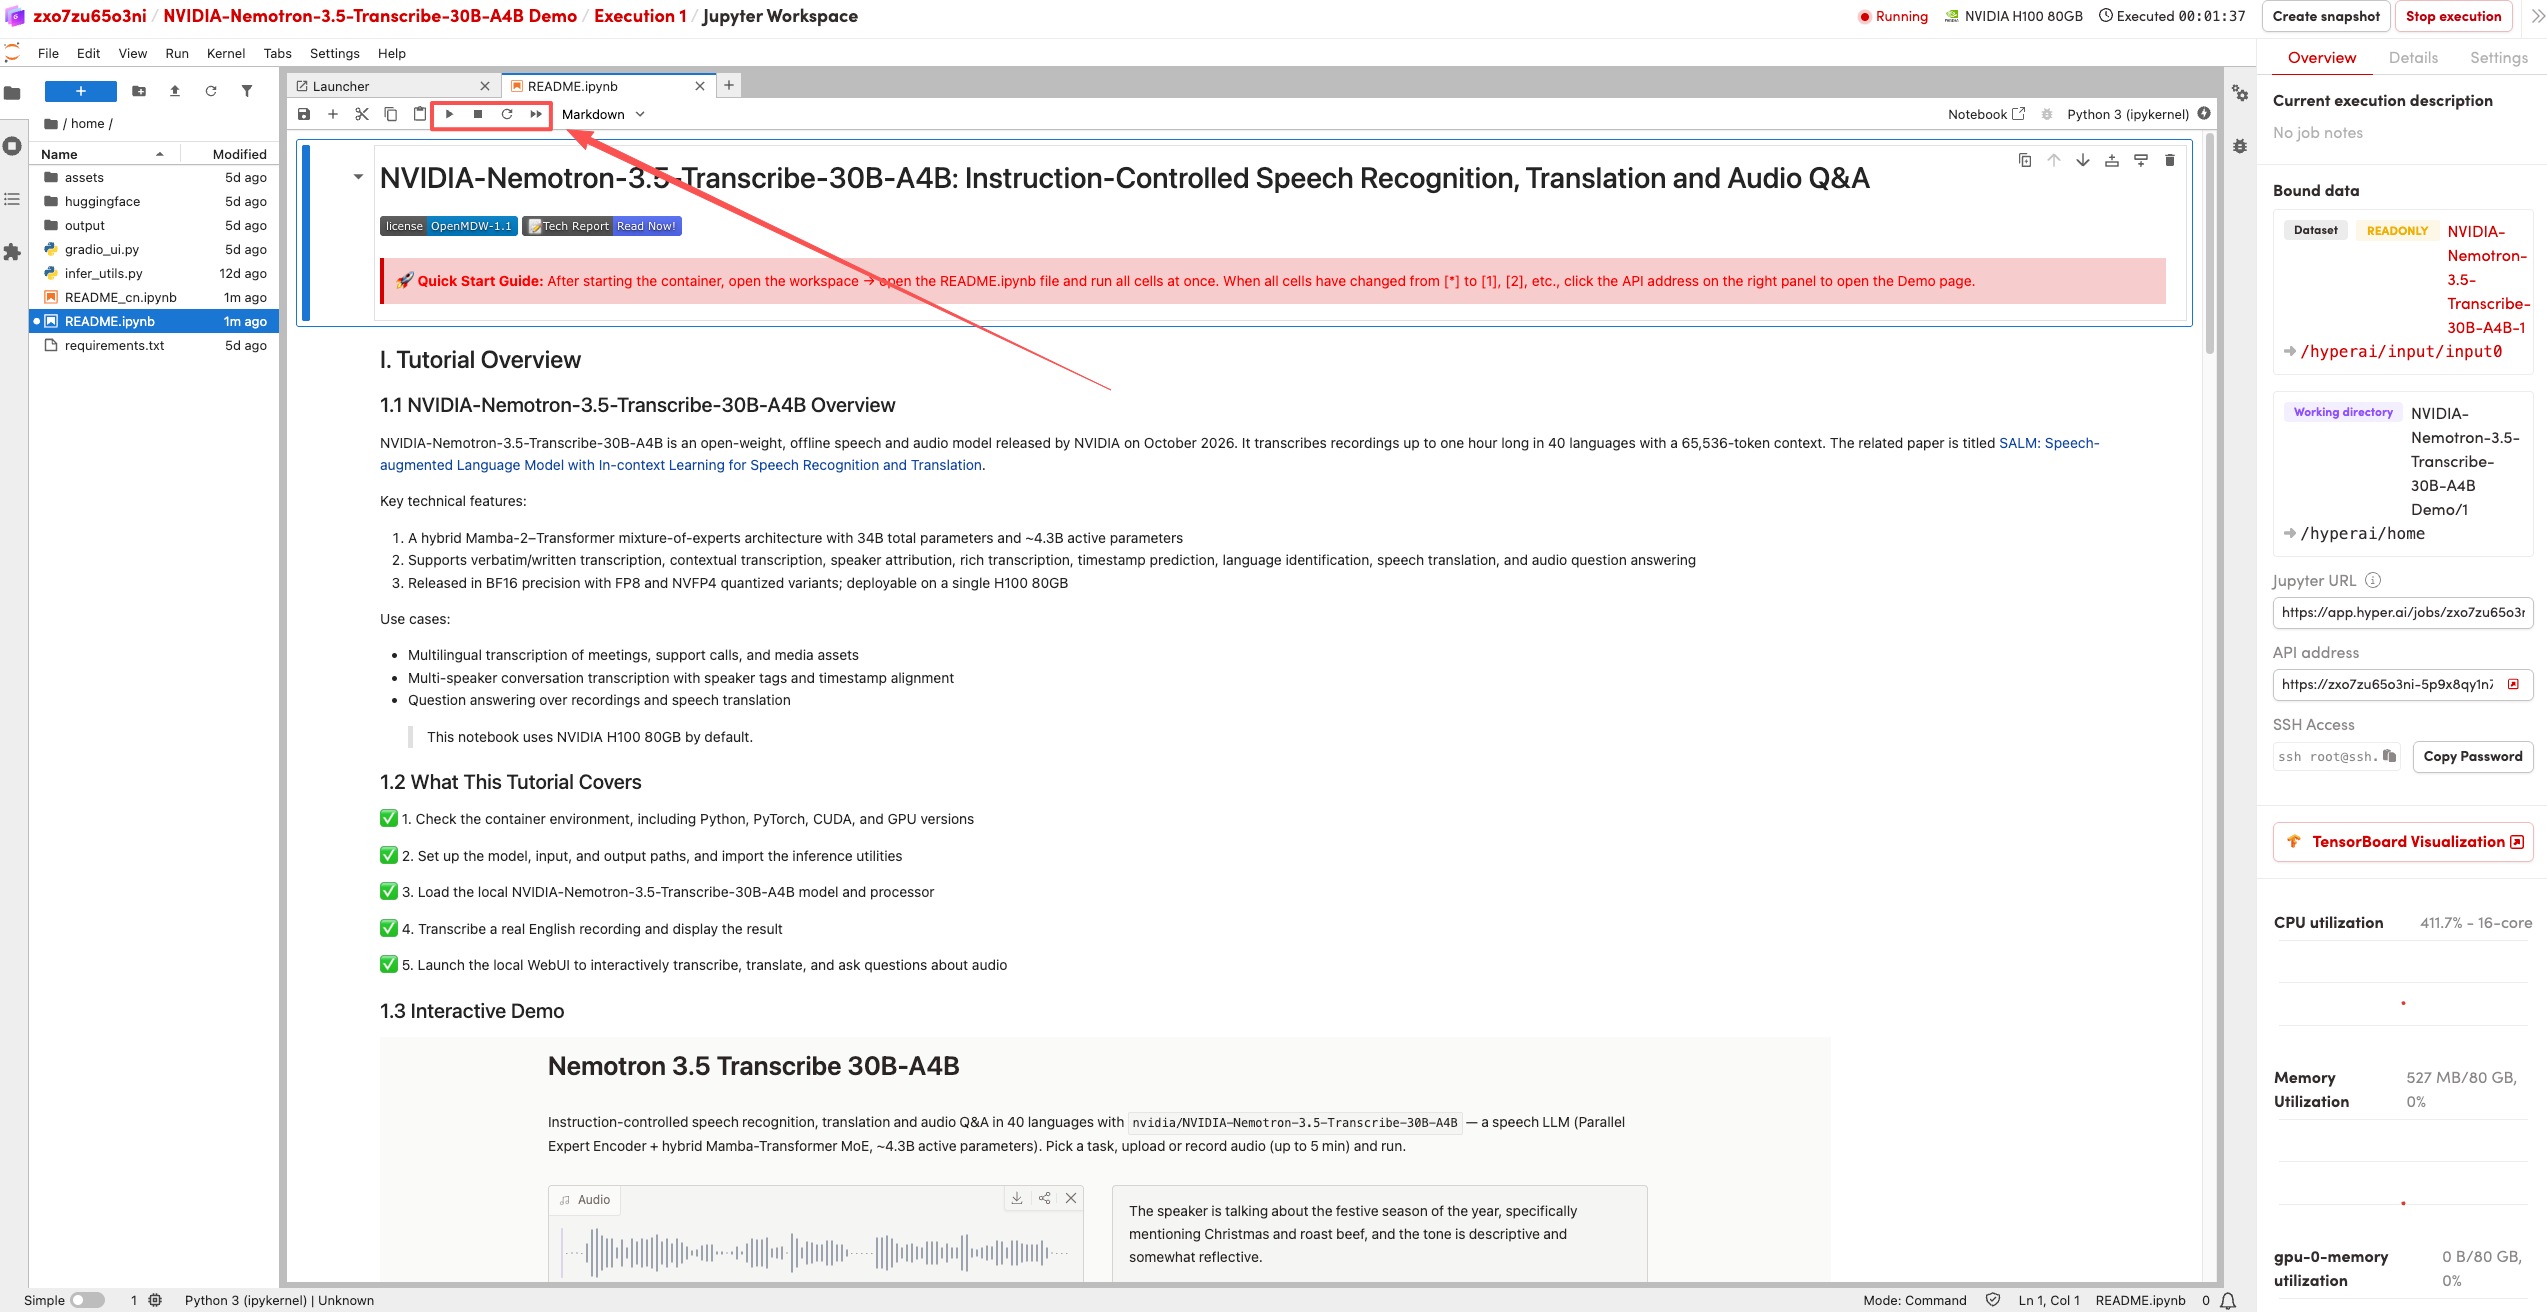
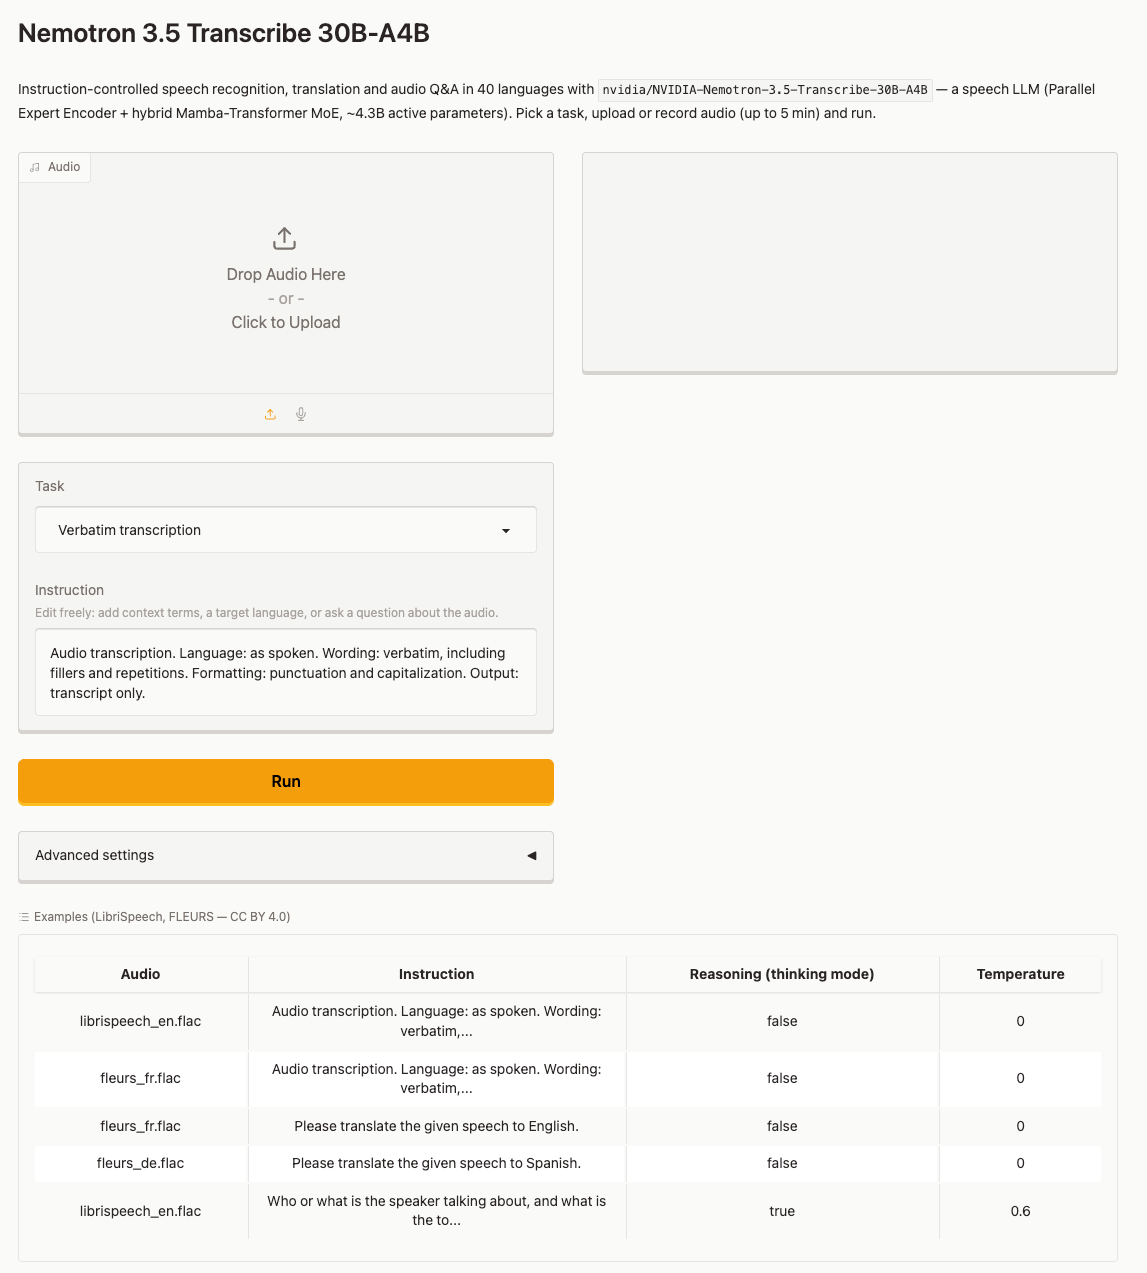
- Une fois l’exécution terminée, cliquez sur l’adresse de l’API à droite pour accéder à la page de démonstration.