Command Palette
Search for a command to run...
En Seulement 38,8 Ms ! Clef-Flash Accomplit La Prise De Décision Multimodale Et Abandonne La Génération Token Par Token ; Un Contexte D'un Million De Tokens, Le Benchmark DABstep Évalue La Capacité Des Agents À Raisonner En Plusieurs Étapes
Dans un contexte où les agents et les applications d'automatisation s'accélèrent, les entreprises ont de plus en plus besoin que les modèles fournissent directement des décisions exploitables, plutôt qu'un long texte nécessitant une seconde analyse. Cependant, le paradigme de génération libre token par token des grands modèles de langage traditionnels rencontre toujours, dans les scénarios de prise de décision structurée, les mêmes problèmes d'instabilité du format de sortie, de complexité d'analyse et de latence élevée.
Pour surmonter cette limitation, Cloudflare a open-sourcé en octobre 2026 Clef-Flash, un modèle de décision multimodal de 9 milliards de paramètres. Basé sur un entraînement postérieur à Qwen3.5-9B, il reconfigure le processus de décision, passant de la génération de texte à un scoring probabiliste en une seule passe avant, offrant ainsi une voie technique plus directe pour la prise de décision structurée à l'ère des grands modèles.
Le chemin génératif traditionnel nécessite le décodage progressif des tokens de sortie : plus la génération est longue, plus l'attente est importante. Or, une tâche de décision ne requiert qu'une option et sa probabilité. Clef-Flash contourne l'ensemble de la chaîne de génération autorégressive, avec une latence médiane de décision officiellement rapportée de seulement 38,8 millisecondes, soit plus rapide qu'un clignement d'œil. Parallèlement, il conserve pleinement la capacité de compréhension des 9 milliards de paramètres, en réorganisant simplement le calcul de la « rédaction de la réponse » vers la « prise de décision ». Il est également nativement compatible avec l'API Jev System One, permettant aux entreprises utilisant déjà ce type d'interface de s'intégrer presque sans couture. De la classification et du routage automatiques des tickets de support et des messages clients, à la modération d'images et de contenus, en passant par l'extraction structurée de l'état des factures, du niveau d'urgence ou de la tendance sentimentale, Clef-Flash fournit une réponse prête à l'emploi pour les besoins les plus courants des flux de travail d'entreprise : prendre des décisions rapidement, de manière stable et quantifiable.
Actuellement, le site officiel HyperAI a lancé « Clef-Flash : Modèle de décision probabiliste typé ». Venez l'essayer ~
Utilisation en ligne :
Aperçu des mises à jour du site officiel hyper.ai du 19 octobre au 23 octobre :
- Ensembles de données publics de qualité : 6
- Tutoriels de qualité sélectionnés : 4
- Articles encyclopédiques populaires : 5
- Conférences de premier plan avec échéance en novembre : 6
Visitez le site officiel : hyper.ai
Sélection d'ensembles de données publics
1. Ensemble de données de référence DABstep pour agents de raisonnement multi-étapes
DABstep (Data Agent Benchmark for Multi-step Reasoning) est un ensemble de données de référence pour agents de données et raisonnement multi-étapes, publié par Adyen en 2025, visant à évaluer la capacité des agents IA à exécuter des questions-réponses complexes sur les données et des raisonnements logiques multi-étapes. L'ensemble de données comprend trois sous-ensembles, le sous-ensemble tasks contenant 460 tâches commerciales réelles, pour un total de plus d'un million d'échantillons de contexte, au format JSON.
Exécution en ligne : https://go.hyper.ai/E4hf8
2. Ensemble de données de référence Last Translation Benchmark pour la traduction extrême
Last Translation Benchmark est un ensemble de données de référence publié en 2026 par les chercheurs Vilém Zouhar et al., destiné à l'évaluation des modèles de traduction automatique. Le成果 de la recherche associée est l'article « Last Translation Benchmark », visant à tester les capacités des modèles de traduction automatique actuels dans des tâches de traduction complexes et à identifier leurs échecs spécifiques dans des scénarios réels. L'ensemble de données contient 3 456 échantillons de traduction de haute difficulté, couvrant de nombreuses langues et combinaisons linguistiques, issus d'exemples de traduction rédigés manuellement et évalués par des pairs. Les échantillons incluent des entrées multimodales telles que texte, image, audio et vidéo, avec des règles de validation définies manuellement pour chaque échantillon.
Exécution en ligne : https://go.hyper.ai/yxBAk
3. Ensemble de données Knee-Raptor-Corpus : pile de prétraitement des IRM du genou
Knee-Raptor-Corpus est un ensemble de données dérivé et prétraité à partir des données IRM du genou brutes de fastMRI, visant à fournir des échantillons prétraités standardisés pour les tâches d'apprentissage profond sur les images IRM du genou. L'ensemble de données complet est divisé en deux parties, Part 1 et Part 2, contenant au total 4 407 études IRM du genou. Le présent ensemble de données correspond à la Part 1, incluant les 3 200 premières études, chaque étude étant traitée sous forme de piles de 44 images uint8 de 336 × 336, avec des coupes des séquences sagittales, coronales et axiales remplis dans un ordre fixe.
Exécution en ligne : https://go.hyper.ai/roWu1
4. Ensemble de données Knee-Raptor-Corpus-Ext : coupes IRM du genou
Le présent ensemble de données correspond à la Part 2 de Knee-Raptor-Corpus, contenant les 1 207 échantillons d'études restants. Les données rééchantillonnent les images médicales DICOM brutes en piles de coupes axiales de taille fixe, chaque échantillon étant uniformément composé de 44 images uint8 de 336 × 336, prêtes à être utilisées directement pour l'entraînement de modèles d'imagerie médicale.
Exécution en ligne : https://go.hyper.ai/rlTgA
5. Ensemble de données de propriétés MOF Property Diversity pour les réseaux métallo-organiques
MOF Property Diversity est un ensemble de données de propriétés des réseaux métallo-organiques (Metal-Organic Frameworks, MOF) publié en 2026, visant à fournir des données MOF représentatives pour la recherche en informatique des matériaux, supportant des tâches telles que l'analyse de propriétés des matériaux, le regroupement (clustering) et l'apprentissage automatique.
Exécution en ligne : https://go.hyper.ai/BIMLz
6. Ensemble de données de prompts prompts.chat
prompts.chat est une communauté open source de partage de prompts. Le présent ensemble de données est un instantané exporté de la bibliothèque de prompts de cette plateforme, les sources originales provenant du projet open source Awesome‑ChatGPT‑Prompts. L'ensemble de données rassemble des exemples de prompts adaptés à plusieurs grands modèles populaires tels que ChatGPT, Claude, Gemini, Llama et Mistral, pouvant être utilisés pour la recherche en ingénierie des prompts et les tests de performance des conversations avec les grands modèles.
Utilisation en ligne : https://go.hyper.ai/iDmot
Sélection de tutoriels publics
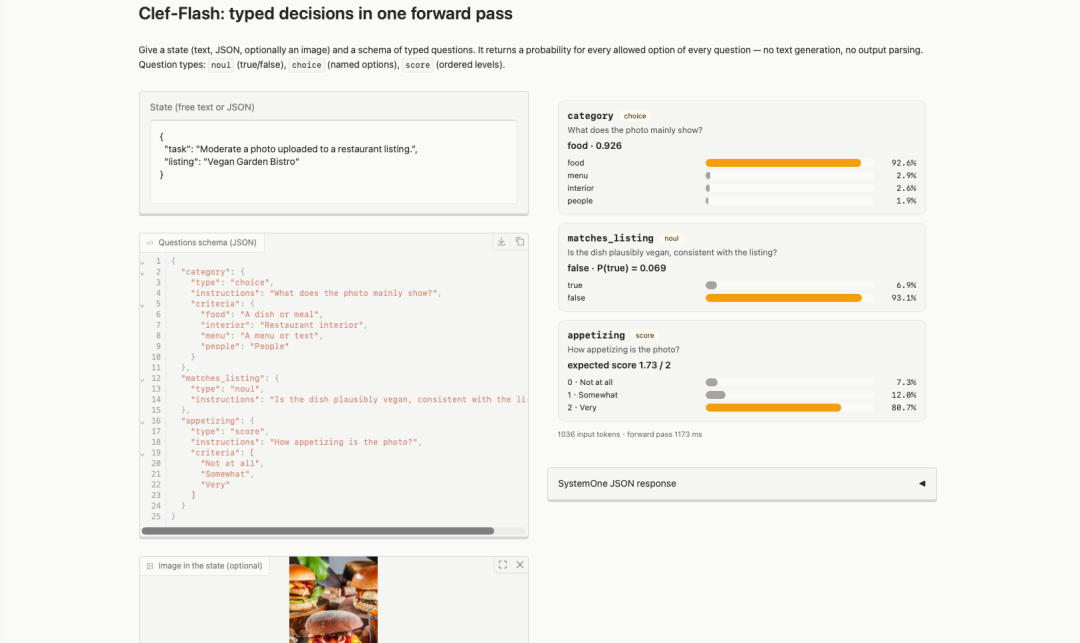
1. Clef-Flash : Modèle de décision probabiliste typé
Clef-Flash est un modèle de décision multimodal de 9 milliards de paramètres publié par Cloudflare en octobre 2026, avec une latence médiane de décision officiellement rapportée de seulement 38,8 millisecondes, et compatible avec l'API Jev System One. Il convient aux scénarios de décision structurée tels que la classification et le routage automatiques des tickets de support, la modération d'images et de contenus, et la détermination de l'état des factures et du niveau d'urgence.
Exécution en ligne : https://go.hyper.ai/U6YW0
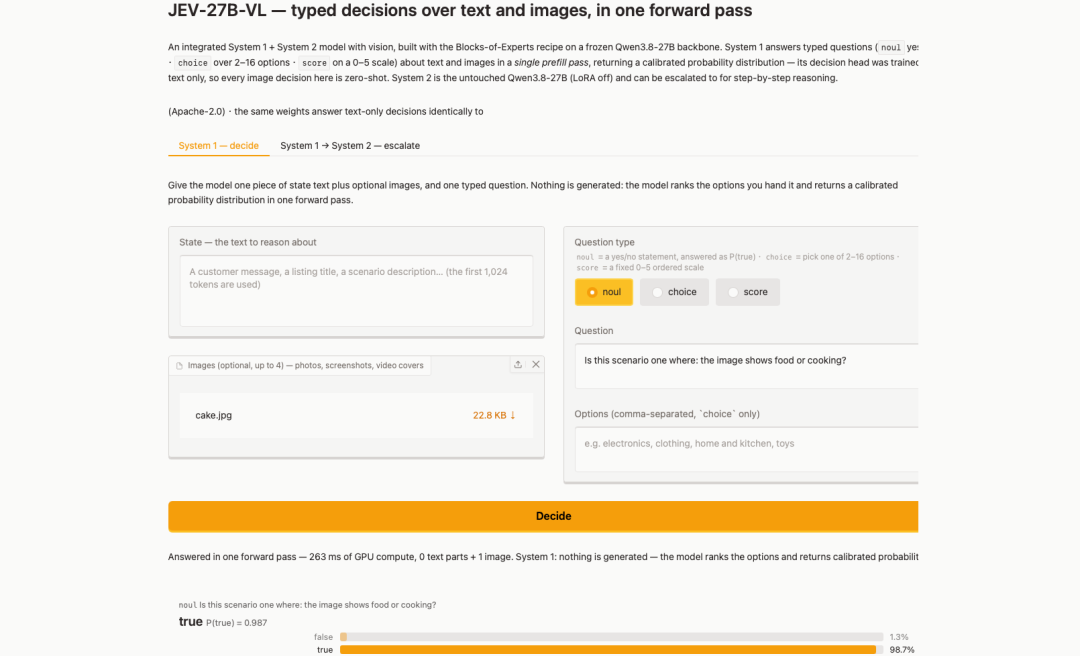
2. JEV-27B-VL : Modèle de décision structurée pour texte et images
JEV-27B-VL est un modèle de décision visuelle publié par AutoTrust AI en octobre 2026, intégrant des capacités à double canal via la solution Blocks-of-Experts sur un backbone Qwen3.8-27B gelé. Selon les chiffres du fournisseur, ce modèle se classe premier parmi les 20 modèles de décision visuelle du classement visuel Jev Decision Index 0.3.
Exécution en ligne : https://go.hyper.ai/3wow2
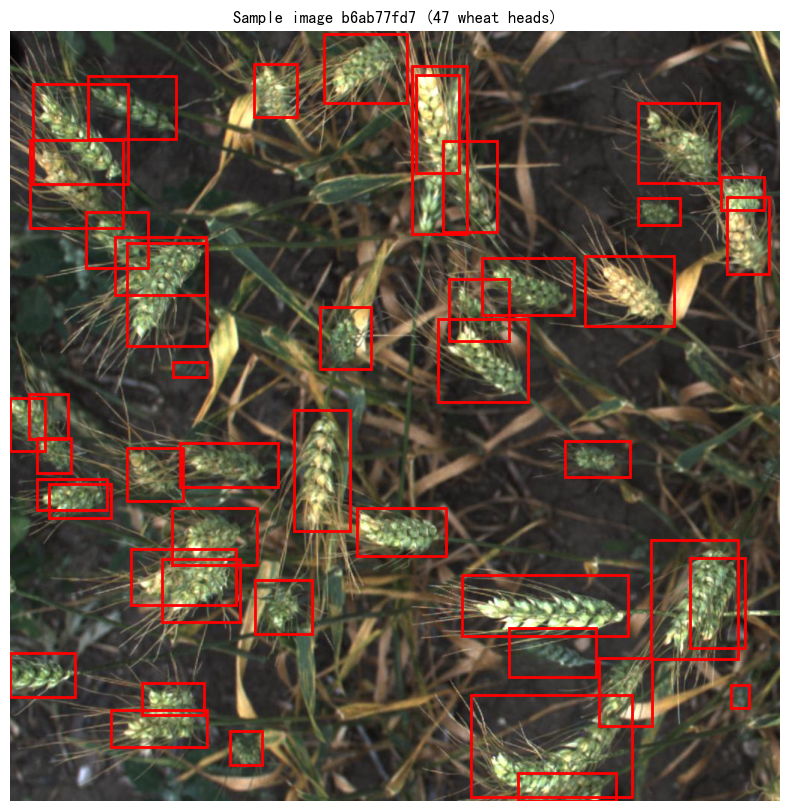
3. Tutoriel d'introduction à PyTorch - Entraînement du modèle FasterRCNN
Ce tutoriel, basé sur un Notebook public de l'utilisateur Kaggle pestipeti, démontre comment entraîner un modèle de détection d'objets Faster R-CNN avec PyTorch et torchvision pour détecter des épis de blé dans des images de champs. Le tutoriel couvre successivement le flux complet allant du chargement des données, à l'exploration des données, la construction du modèle, l'entraînement sur un tour unique et l'inférence sur des images de test. Il convient aux débutants en détection d'objets et en apprentissage par transfert, et peut être utilisé dans des scénarios tels que le comptage des épis, la télédétection agricole et l'analyse phénotypique des plantes.
Exécution en ligne : https://go.hyper.ai/Ozwaq
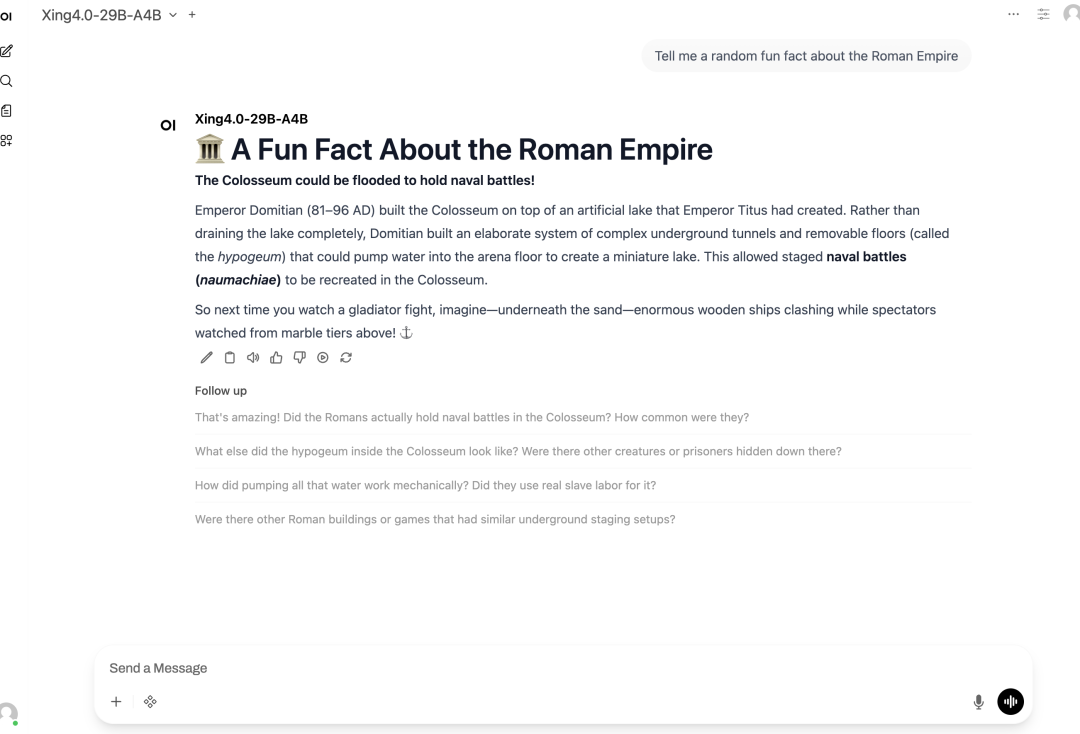
4. Inférence locale et déploiement Open WebUI pour Xing4.0-29B-A4B
Ce tutoriel démontre l'inférence locale et le déploiement Open WebUI du grand modèle Xing4.0-29B-A4B. Xing4.0-29B-A4B est le dernier grand modèle de langage de la série Xing (anciennement TeleChat), publié par China Telecom Artificial Intelligence Technology Co., Ltd. en septembre 2026, adapté aux scénarios de raisonnement complexe, de génération de code, d'appels d'outils et de questions-réponses sur longs contextes.
Exécution en ligne : https://go.hyper.ai/PDmlT
Sélection d'articles encyclopédiques populaires
1. Modèle d'action mondial WAM
2. Robustesse / Solidité Robustness
3. Modèle de transformation pré-entraîné génératif GPT
4. Génération de vidéo Video Generation
5. Modèles d'incrustation Embedding Models
Des centaines d'articles liés à l'IA sont compilés ici pour vous permettre de comprendre « l'intelligence artificielle » : https://go.hyper.ai/wiki
Conférences de premier plan avec échéance en novembre
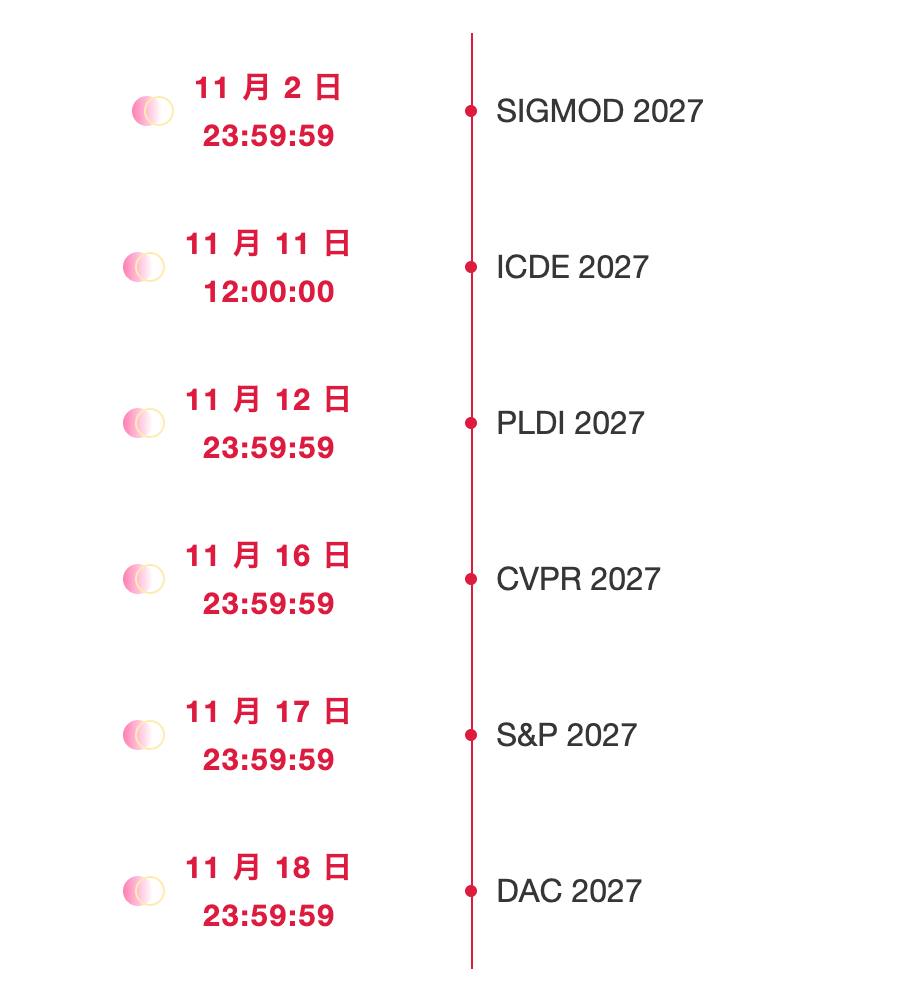
- Les dates de soumission sont en heure AoE (Anywhere on Earth)
Suivi complet des conférences académiques de premier plan en intelligence artificielle : https://go.hyper.ai/event
C'est tout pour la sélection éditoriale de cette semaine. Si vous souhaitez proposer des ressources pour le site officiel hyper.ai, n'hésitez pas à laisser un commentaire ou à nous soumettre un article !
À la semaine prochaine !