Command Palette
Search for a command to run...
Adieu Au Comptage Des Fluorescences À L’œil Nu : Une Équipe Britannique Développe Un Flux De Travail D’ia Pour L’évaluation Des Vaccins Contre La Rage, Atteignant Une AUC De 0,999

La rage est une zoonose grave qui continue de causer des dizaines de milliers de décès chaque année dans les régions endémiques. Bien que la vaccination permette une prévention efficace de la rage, le diagnostic de l'infection virale, l'évaluation de l'efficacité immunitaire post-vaccinale et la surveillance sérologique connexe reposent toujours sur des méthodes de laboratoire fiables. Lors des tests par culture cellulaire, les opérateurs doivent généralement recourir à l'imagerie en microscopie à fluorescence pour déterminer si les cellules présentent une infection par le virus de la rage (RABV). Ce processus implique une observation et une interprétation manuelles d'un grand nombre d'images, ce qui est non seulement chronophage, mais peut également être affecté par l'expérience de l'opérateur ainsi que par des facteurs tels que la faible intensité de fluorescence et les artefacts d'image.
Ces dernières années, les progrès des technologies d'apprentissage profond (DL) ont considérablement fait progresser l'analyse des images biomédicales, y compris l'évaluation des infections virales. Cependant, aucune étude antérieure n'avait appliqué les méthodes d'apprentissage profond à une analyse systématique par imagerie en fluorescence des antigènes du virus de la rage. Étant donné que le virus de la rage ne provoque généralement pas d'effets cytopathiques évidents ni de formation de syncytiums, les caractéristiques morphologiques cellulaires sur lesquelles reposent de nombreuses méthodes basées sur l'intelligence artificielle ont une applicabilité limitée dans ce type de détection.
Dans ce contexte, une équipe de recherche de l'Université de Surrey au Royaume-Uni a proposé le premier flux de travail basé sur l'intelligence artificielle pour détecter l'infection par le virus de la rage dans des cultures cellulaires BHK-21 et quantifier les titres d'anticorps. Les chercheurs ont sélectionné trois architectures d'apprentissage profond avancées — ResNet, Swin Transformer V2 et MambaOut — et les ont entraînées à l'aide d'un grand jeu de données. Lors d'évaluations à trois niveaux — zones d'image, images individuelles et puits —, le modèle MambaOut a constamment surpassé les autres modèles.
Au niveau des puits, le modèle a atteint une précision de 0,996, un score F1 de 0,993 et une aire sous la courbe ROC (AUC-ROC) de 0,999. Pour évaluer la capacité d'application pratique de cette méthode, les chercheurs ont également testé le modèle sur des images inédites provenant du test de neutralisation virale par anticorps fluorescents recommandé par l'Organisation mondiale de la Santé (OMS) / l'Organisation mondiale de la santé animale (OMSA). MambaOut a montré une concordance parfaite avec les résultats annotés réels en ce qui concerne la prédiction de la concentration en anticorps, confirmant la fiabilité de ce flux de travail dans l'évaluation des vaccins et les tests liés aux déplacements d'animaux de compagnie.
Les résultats de cette recherche, intitulés « Deep learning enables rabies virus detection and antibody quantification in cell culture », ont été publiés dans Scientific Reports.
Points forts de la recherche :
-
Construction du premier grand jeu de données d'imagerie du virus de la rage
-
Automatisation de l'analyse d'images à haut débit grâce à l'IA, offrant aux laboratoires de diagnostic une solution évolutive et gain de temps, particulièrement adaptée aux pays et régions où la rage est endémique
-
Les résultats de l'étude jettent les bases du diagnostic assisté par l'IA de la rage et ouvrent de nouvelles possibilités pour l'application des technologies d'apprentissage profond à d'autres méthodes de détection virale basées sur la culture cellulaire
Lien vers l'article :
https://www.nature.com/articles/s41598-026-57955-8
Construction du jeu de données LyssaScan : Identification des signaux d'infection à partir d'images en fluorescence
Les chercheurs ont d'abord construit le jeu de données d'images LyssaScan, destiné à l'identification de l'infection par le RABV. Ce jeu de données couvre divers niveaux d'infection, agents de coloration et conditions d'imagerie, reflétant simultanément les variations biologiques et les variations au niveau technique.
Plus précisément, les chercheurs ont établi un processus normalisé d'imagerie en microscopie à fluorescence en utilisant des cellules BHK-21 infectées par la souche standard d'attaque 11 (CVS-11) du virus de la rage (RABV). La culture cellulaire a été réalisée dans des plaques à 96 puits à fond plat, à fond transparent et à parois noires. Après 48 heures de culture, les cellules ont été fixées et colorées à l'aide d'un anticorps polyclonal anti-nucléocapside du virus de la rage conjugué à l'isothiocyanate de fluorescéine (FITC) (Fujirebio). Les contrôles négatifs comprenaient des puits contenant des cellules non infectées et des puits contenant uniquement du milieu. Certaines cultures cellulaires ont été colorées avec un autre anticorps conjugué au FITC (Sifin). Le processus d'imagerie complet est illustré ci-dessous :
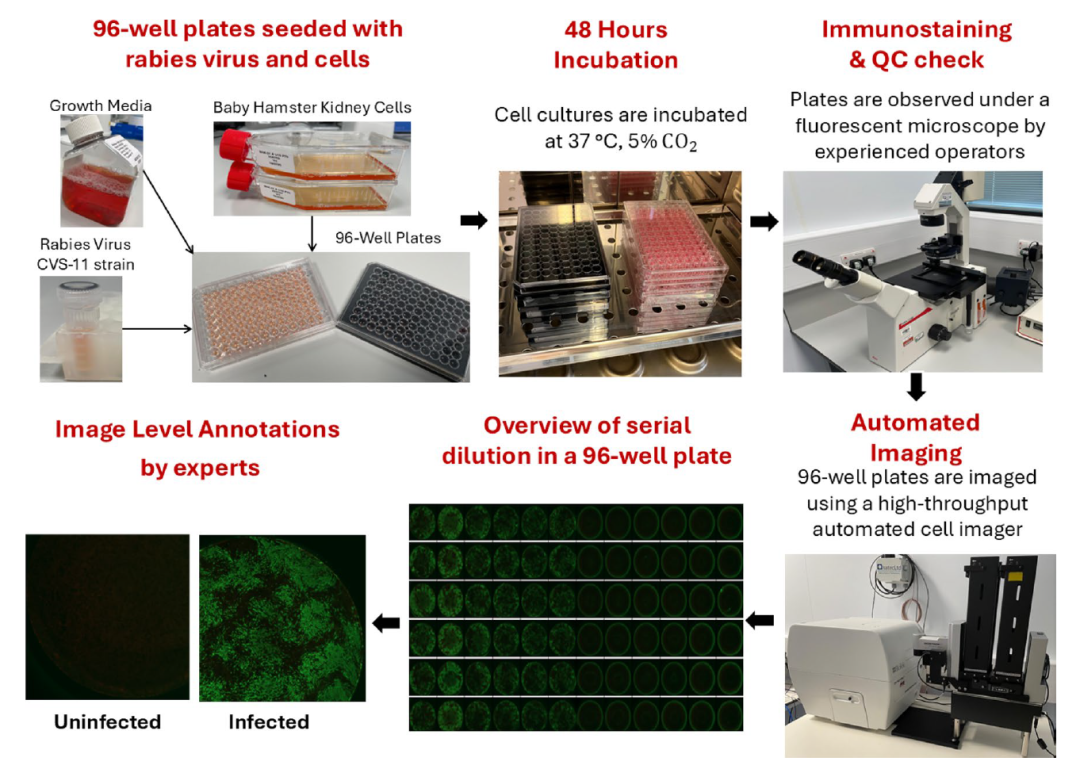
Flux de travail automatisé pour la génération du jeu de données
L'imagerie automatisée a été réalisée à l'aide de l'analyseur d'imagerie cellulaire Cytation 5 d'Agilent Technologies, équipé d'un objectif dont le numéro de modèle est anormal dans le texte original, et d'une caméra grand champ intégrée. Les chercheurs ont utilisé des blocs de filtres GFP et Texas Red pour collecter respectivement le signal de fluorescence généré par la coloration des nuclécapsides virales et les images permettant d'observer la monocouche cellulaire. Chaque puits a été imagé à quatre positions aux coins, générant ainsi quatre images PNG composites par puits. Au total, 2 344 images composites ont été collectées pour le traitement ultérieur.
Ensuite, les images ont été redimensionnées à une taille spécifique afin d'être divisées précisément en 16 zones d'image (patchs) non chevauchantes, qui ont été annotées manuellement par des experts pour générer des étiquettes de référence fiables. Les cas pour lesquels un consensus n'a pas pu être atteint ont été marqués comme « ambigus » et exclus du développement du modèle. Au final, le jeu de données LyssaScan comprend 36 822 zones d'image, dont 9 750 échantillons infectés et 27 072 échantillons non infectés.
Différences d'architecture entre les trois modèles : des réseaux convolutifs aux convolutions à porte
Pour comparer les performances de différentes architectures d'apprentissage profond dans la tâche de reconnaissance d'images en fluorescence, les chercheurs ont sélectionné trois modèles : ResNet-101, Swin Transformer V2 Small (SwinT-V2) et MambaOut Small, dont le nombre de paramètres s'élève respectivement à environ 44,5 millions, 47 millions et 48,5 millions.
ResNet-101 : réseau de neurones convolutif basé sur les connexions résiduelles
ResNet constitue le modèle de référence de cette étude. Sa caractéristique principale est l'introduction de connexions par saut (skip connections), qui améliorent la propagation des gradients à mesure que la profondeur du réseau augmente. En extrayant les caractéristiques des images couche par couche, ResNet permet d'identifier les structures fluorescentes locales. Cependant, sa capacité à exprimer des caractéristiques locales peut encore limiter sa capacité à discriminer les signaux d'infection faibles dans des contextes complexes.
SwinT-V2 : intégration d'informations contextuelles via l'auto-attention
SwinT-V2 est un Transformer visuel hiérarchique qui utilise un mécanisme d'auto-attention par fenêtres décalées. Il intègre des informations contextuelles plus vastes tout en extrayant des caractéristiques locales. Dans les images en fluorescence, les foyers d'infection peuvent être petits ou se confondre avec le bruit de fond, les différences de coloration ou d'autres structures. Prendre en compte simultanément les manifestations locales et l'environnement environnant contribue donc à améliorer la capacité de reconnaissance.
MambaOut : modulation dynamique des caractéristiques via un mécanisme de porte
Dans cette étude, MambaOut utilise des modules CNN à porte empilés, sans composants de modèles à espace d'état. Le mécanisme de porte module dynamiquement la transmission des caractéristiques, en renforçant sélectivement les signaux utiles et en supprimant le bruit de fond. Cette caractéristique peut mieux convenir à l'identification de foyers fluorescents faibles noyés dans un contexte complexe, ce qui constitue l'une des raisons pour lesquelles les chercheurs se sont concentrés sur ses performances.
Les trois architectures représentent des voies technologiques aux caractéristiques complémentaires — réseaux de neurones convolutifs (CNN), Transformers visuels (ViT) et réseaux de neurones convolutifs à porte — offrant une base pour une comparaison systématique des différentes architectures.
L'entraînement des modèles a utilisé des méthodes standard d'augmentation des données, notamment des retournements et rotations aléatoires, ainsi que des ajustements de luminosité et de contraste, afin d'améliorer la robustesse des modèles. Les modèles ont été initialisés avec des poids pré-entraînés sur ImageNet-1k, puis affinés (fine-tuning) sur le jeu de données LyssaScan. L'entraînement a été effectué sur des GPU NVIDIA GeForce RTX 2080 Ti, sur 20 époques, avec une taille de batch de 128.
L'optimisation a utilisé l'optimiseur Adam, avec un taux d'apprentissage initial dont la formule est affichée de manière anormale dans le texte original et ne peut être restituée avec précision, ainsi qu'une stratégie de planification du taux d'apprentissage par recuit cosinus. Pour résoudre le problème du déséquilibre des classes, l'étude a adopté une fonction de perte par entropie croisée pondérée, où les poids des classes sont inversement proportionnels à la fréquence des échantillons de chaque catégorie.
Au cours de l'entraînement (comme illustré ci-dessous), les caractéristiques extraites par chaque modèle sont d'abord agrégées en un vecteur descripteur de caractéristiques de dimension D via le pooling moyen global (GAP), puis soumises à une couche entièrement connectée (FC) pour générer des logits, enfin optimisées via la fonction de perte par entropie croisée pondérée.
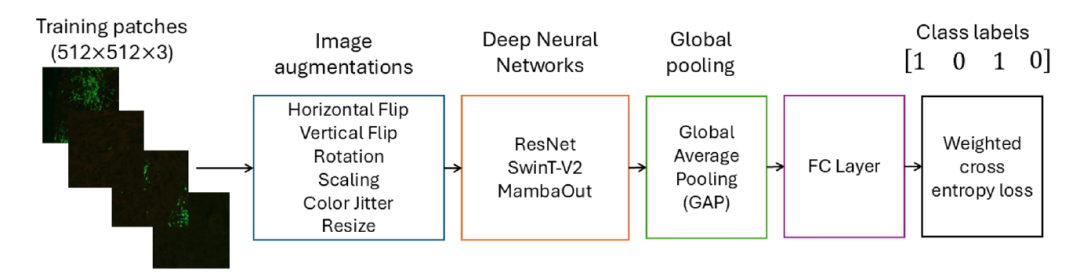
Processus d'entraînement du modèle
Lors de la phase d'inférence (comme illustré ci-dessous), les régions d'images d'entrée sont redimensionnées, puis traitées par le modèle entraîné ; les caractéristiques extraites sont agrégées via le pooling moyen global, puis traversent une couche entièrement connectée et une couche Softmax pour obtenir les probabilités de prédiction pour chaque catégorie. Ces probabilités sont ensuite utilisées pour calculer les différentes métriques d'évaluation du modèle.
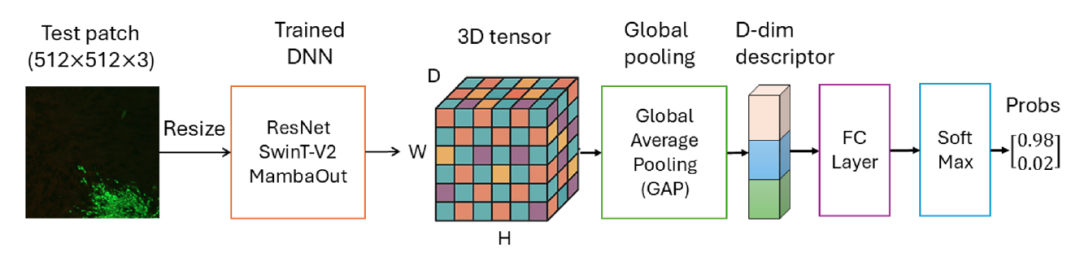
Processus d'inférence du modèle
Le modèle MambaOut combine précision de reconnaissance et capacité de quantification des anticorps
Les chercheurs ont procédé à une évaluation systématique des trois modèles ResNet, Swin Transformer V2 et MambaOut, comparant les performances des modèles d'apprentissage profond avancés actuels dans la tâche de détection du virus de la rage, fournissant ainsi des bases pour le choix et l'application de modèles connexes.
Évaluation des performances des modèles
Les performances des modèles sont évaluées à trois niveaux. Premièrement, une évaluation des performances de détection est réalisée au niveau des régions d'images, en classant chaque région d'image individuellement ; les résultats sont présentés dans le tableau ci-dessous :
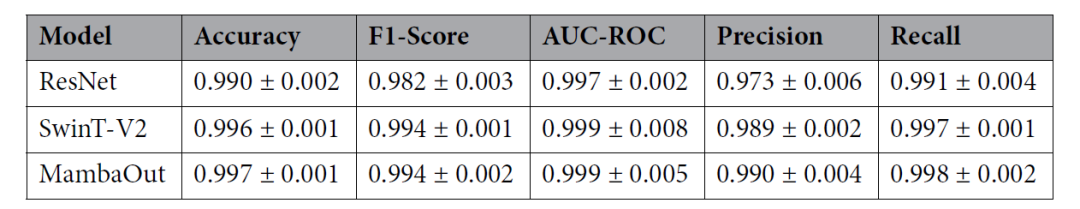
Performances des réseaux de neurones profonds au niveau des régions d'images (patches) du jeu de données LyssaScan, basées sur une validation croisée à 5 plis (moyenne ± écart type)
Deuxièmement, les prédictions de 16 régions d'images sont agrégées pour obtenir un résultat de classification pour l'image entière, qui est ensuite comparé aux annotations réelles au niveau de l'image ; les résultats sont présentés dans le tableau ci-dessous :
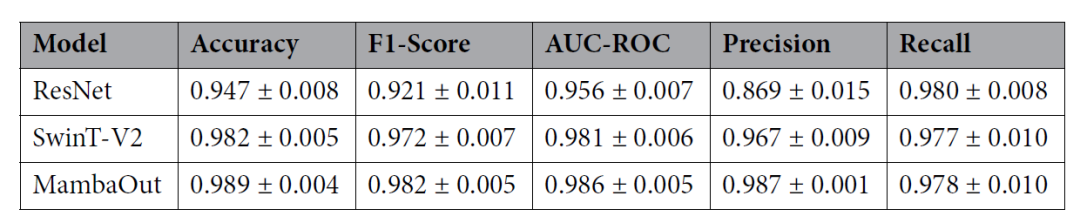
Performance evaluation of various deep neural networks on the LyssaScan dataset at the image level using five-fold cross-validation (mean ± standard deviation)
Enfin, comme chaque puits correspond à quatre images provenant de différentes positions angulaires, les chercheurs ont ensuite agrégé les prédictions des régions d'images au niveau des puits et les ont comparées aux annotations réelles correspondantes pour évaluer la performance de détection à l'échelle du puits. Les résultats sont présentés dans le tableau ci-dessous :
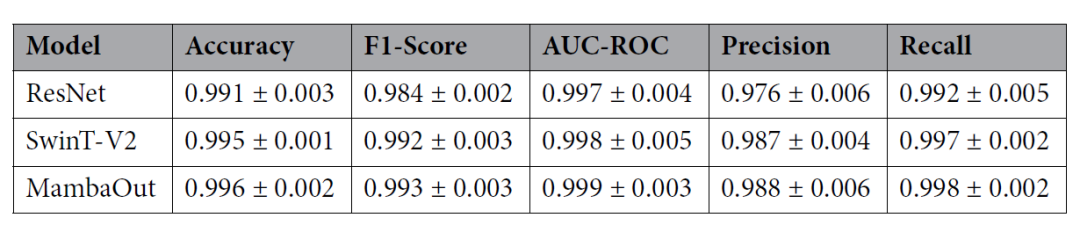
Performance evaluation of various deep neural networks on the LyssaScan dataset at the well level using five-fold cross-validation (mean ± standard deviation)
Aux trois niveaux d'évaluation — région d'image, image unique et puits — MambaOut obtient systématiquement les meilleures performances, suivi par le Swin Transformer V2 (SwinT-V2). Au niveau de la région d'image, MambaOut affiche les meilleures performances en termes de précision, de score F1 et de précision positive, ce qui indique sa capacité à identifier de manière fiable les signaux d'infection dans les régions locales de l'image. Cette tendance se retrouve également dans l'évaluation au niveau de l'image : MambaOut atteint une précision et un score F1 élevés, tandis que les performances de SwinT-V2 sont légèrement inférieures à celles de MambaOut.
ResNet présente les performances les plus faibles au niveau de l'image, avec une précision de 0,947, principalement en raison de la sensibilité de ce modèle aux erreurs de classification au niveau des régions d'images. Néanmoins, cette règle d'agrégation est conforme à la logique biologique réelle de prise de décision : même une seule région positive à la fluorescence signifie la détection d'antigènes viraux, et l'image entière doit donc être considérée comme positive pour l'infection. Dans un contexte diagnostique, la détection de toute preuve d'infection est cruciale, et les faux négatifs ont généralement des conséquences plus graves que les faux positifs occasionnels.
Applicabilité à la détermination des titres d'anticorps dans le test de neutralisation par fluorescence des anticorps (FAVN)
Pour évaluer l'applicabilité du flux de travail proposé dans les scénarios de sérologie, les chercheurs ont appliqué le modèle au test de neutralisation par fluorescence des anticorps (FAVN). Les résultats expérimentaux montrent que MambaOut atteint les meilleures performances, avec une précision de 0,992, un score F1 de 0,992 et une aire sous la courbe ROC (AUC-ROC) de 0,997, ce qui indique que le modèle est capable de capturer efficacement les caractéristiques locales et globales dans des conditions de test complexes et variées. SwinT-V2 démontre également une forte capacité de généralisation, avec une précision atteignant 0,988 ; en revanche, les performances de ResNet sont en baisse, avec une précision de 0,965.
Les chercheurs ont ensuite examiné plus en détail son applicabilité à la détermination des titres d'anticorps dans le test FAVN, en utilisant le même ensemble d'images pour comparer les titres d'anticorps prédits par le modèle avec les résultats obtenus par des opérateurs humains, ces derniers servant de référence. Les résultats sont présentés dans le tableau ci-dessous :
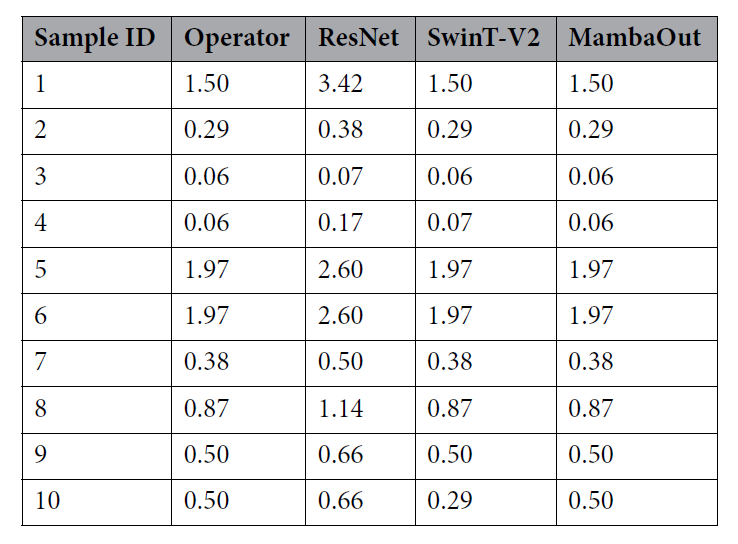
Comparaison des titres d'anticorps (unités internationales par millilitre, UI/mL) prédits par les modèles ResNet, SwinT-V2 et Mamba avec les résultats interprétés par des opérateurs humains sur le même ensemble d'échantillons
L'étude a utilisé l'analyse de Bland–Altman pour évaluer la concordance entre le modèle et les opérateurs humains, comme illustré ci-dessous :
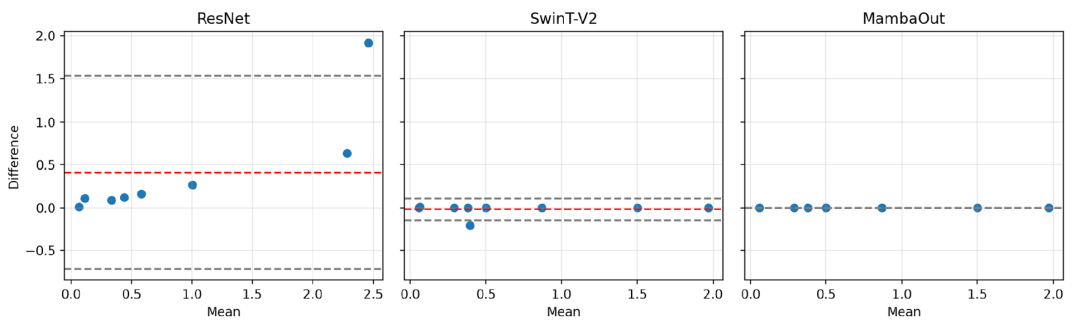
Graphiques d'analyse de concordance de Bland–Altman entre les résultats prédits par les modèles d'apprentissage profond et les mesures effectuées par des opérateurs humains
ResNet présente un biais positif marqué, avec une différence moyenne de +0,41 et des limites de concordance (LoA) larges, allant de −0,71 à +1,53. Cela indique que, par rapport aux résultats interprétés manuellement, ResNet a tendance à surestimer systématiquement les titres d'anticorps.
SwinT-V2 montre une bonne concordance, avec une différence moyenne proche de zéro (−0,02) et des limites de concordance étroites, allant de −0,15 à +0,11, ce qui suggère une bonne intercomparabilité entre ses prédictions et les interprétations humaines sur toute la plage de mesure.
Les prédictions de MambaOut sont parfaitement cohérentes avec les interprétations humaines, toutes les différences par paires étant nulles.
Aucune preuve de biais proportionnel n'a été constatée pour SwinT-V2 et MambaOut ; en revanche, les différences observées pour ResNet montrent une légère augmentation à mesure que le titre d'anticorps augmente.
Selon les directives pertinentes de l'Organisation mondiale de la santé (OMS) et de l'Organisation mondiale de la santé animale (OMSA), un titre d'anticorps atteignant 0,5 UI/mL peut être considéré comme une preuve raisonnable de séroconversion après vaccination et sert de référence pour respecter les réglementations internationales relatives aux déplacements d'animaux de compagnie. L'étude a utilisé ce seuil pour évaluer l'impact des écarts entre les titres prédits sur la détermination des résultats dans des groupes d'échantillons couvrant l'ensemble de la plage des titres d'anticorps.
Dans l’ensemble de l’échantillonnage, les estimations du titre anticorps par ResNet sont globalement supérieures aux valeurs de référence réelles, ce type d’erreur de jugement pouvant conduire à l’approbation erronée de voyages pour des animaux dont l’immunité est insuffisante.
Les prédictions globales de SwinT-V2 sont plus proches de l’interprétation humaine, mais l’échantillon 10 a néanmoins été classé à tort comme négatif, bien qu’il réponde effectivement aux critères de qualification. Cela pourrait entraîner des rappels de vaccination inutiles et des retards dans les déplacements.
Les prédictions de MambaOut sont parfaitement cohérentes avec l’interprétation humaine, identifiant correctement tous les échantillons non conformes et distinguant avec précision les sérums à faible titre de ceux à titre élevé, sans aucune erreur dans la détermination des seuils.
Dans l’ensemble, ces résultats de recherche indiquent que le système proposé peut non seulement être efficacement appliqué aux tests par culture cellulaire, mais aussi être étendu aux procédures de sérologie, soutenant ainsi son application plus poussée dans le diagnostic de la rage et la surveillance sérologique.
Conclusion
En somme, les progrès réalisés par cette étude dans la détection de l’infection par le RABV renforcent davantage les fondements scientifiques de l’application de la vision par ordinateur à la recherche cellulaire et aux essais diagnostiques, tout en ouvrant la possibilité de son extension à la détection par culture cellulaire d’autres agents pathogènes viraux. Cette étude met en évidence le potentiel de l’intelligence artificielle pour transformer le diagnostic de laboratoire, contribuant à combler l’écart entre les capacités d’interprétation experte et les technologies scalables et faciles à utiliser. Au-delà des contributions techniques, cette approche démontre également le potentiel des technologies de diagnostic pilotées par l’IA à réduire la charge mondiale de la rage. Bien que le protocole actuel dépende encore d’équipements spécialisés, la méthodologie sous-jacente pourrait être adaptée à des plateformes d’équipement plus accessibles, telles que la combinaison d’un microscope ordinaire et d’une caméra numérique, ouvrant ainsi la voie au développement de solutions diagnostiques scalables et durables pour les régions à ressources limitées.
Références :
https://phys.org/news/2026-10-ai-rabies-world.html
https://www.nature.com/articles/s41598-026-57955-8