Command Palette
Search for a command to run...
Un Échantillonnage À Seulement 25 % Permet D'augmenter Le Débit D'images Jusqu'à 4 Fois, Le Deep Learning Révolutionne L'imagerie Par Fluorescence Nanoscopique Des Cellules Vivantes
Comme il est bien connu, la cellule est l'unité fondamentale de structure et de fonction des organismes vivants. En son sein, diverses organelles sophistiquées, le cytosquelette et des complexes protéiques, ainsi que d'autres structures à l'échelle nanométrique, remplissent chacun leurs fonctions spécifiques, pilotant ainsi des activités biologiques complexes et variées. Cependant, à ce jour, la communauté scientifique en sait encore très peu sur les interactions dynamiques entre ces structures nanométriques délicates. La raison en est que la microscopie optique traditionnelle est limitée par la limite de diffraction d'Abbe. En conséquence, une grande partie des structures fines à l'échelle nanométrique et leurs dynamiques internes ressemblent à un brouillard « flou », entravant considérablement les progrès dans l'étude des sous-structures cellulaires.
L'apparition de la nanoscopie à fluorescence (Fluorescence nanoscopy) a permis de surmonter cet obstacle. En tant que technique de microscopie de fluorescence en champ lointain capable de dépasser la limite de diffraction optique, elle régule par des moyens physiques l'état d'émission des molécules fluorescentes, repoussant ainsi efficacement la résolution d'observation à l'échelle nanométrique. Les chercheurs peuvent désormais observer directement les conformations fines et l'évolution dynamique des structures microscopiques internes aux cellules, faisant de cette technologie un outil essentiel pour explorer les lois physiologiques cellulaires, élucider les mécanismes pathologiques des maladies et décoder les mystères des processus biologiques.
Parmi les nombreuses approches technologiques de la nanoscopie à fluorescence, la nanoscopie RESOLFT (Reversible Saturable Optical Linear Fluorescence Transitions) est une solution représentative. Elle s'appuie sur des protéines fluorescentes photoswitchables réversibles (rsFPs), utilisant un champ lumineux structuré spatialement pour contrôler le commutation réversible des protéines fluorescentes entre un état « ON » (luminescent) et un état « OFF » (obscur), créant ainsi une rareté moléculaire de l'émission. Grâce à cette ingénieuse stratégie de « sélection d'allumage » par balayage, elle permet de reconstituer finalement des images cellulaires haute définition dépassant la limite de diffraction.
Toutefois, la nanoscopie RESOLFT n'est pas encore parfaite. Deux principaux obstacles entravent actuellement son application généralisée : premièrement, les rsFPs souffrent d'un effet de fatigue de commutation optique ; les commutations d'état répétées peuvent entraîner une perte progressive de leur capacité de commutation réversible, limitant directement la durée totale de l'imagerie temporelle prolongée sur cellules vivantes ; deuxièmement, le temps d'imagerie RESOLFT est contraint par la commutation des molécules fluorescentes, la durée d'excitation et le nombre de points d'échantillonnage du balayage spatial. Plus il y a de points d'échantillonnage, plus le temps d'imagerie est long. Une résolution temporelle insuffisante peut également générer des artefacts de mouvement.
Pour relever ces défis, une équipe de recherche interinstitutionnelle composée de chercheurs de l'École royale polytechnique de Stockholm (Suède), de l'Université technique de Dresde (Allemagne) et de la Fondation Human Technopole de Milan (Italie) a combiné l'apprentissage profond avec l'imagerie RESOLFT, développant deux stratégies complémentaires d'imagerie computationnelle : le réseau de débruitage hiérarchique Hierarchical DivNoising (HDN) et le cadre de reconstruction d'échantillonnage épars Fast‑MoNaLISA. Ces outils sont destinés à restaurer les images à faible rapport signal-sur-bruit (SNR) ou sous-échantillonnées, élargissant considérablement les limites expérimentales de l'imagerie RESOLFT. Grâce au réseau HDN, la dose lumineuse par image peut être réduite de 10 fois, et la durée totale de l'imagerie temporelle peut être prolongée jusqu'à 5 fois ; grâce au cadre Fast-MoNaLISA, la cadence d'image peut être augmentée jusqu'à 4 fois dans des conditions d'échantillonnage à 25 %.
Les résultats associés ont été publiés dans Nature Communications sous le titre « Time-lapse RESOLFT nanoscopy empowered by deep learning ».
Points forts de la recherche :
-
Basé sur les réseaux de débruitage hiérarchiques HDN/HDNsup, la restauration d'images RESOLFT à faible SNR avec une réduction de 10 fois de la dose lumineuse permet de réaliser une imagerie nanoscopique temporelle sur cellules vivantes pouvant durer jusqu'à 5 fois plus longtemps.
-
Développement du modèle d'upsampling temporel Fast-MoNaLISA pour la reconstruction super-résolue d'images sous-échantillonnées, permettant une accélération de l'imagerie jusqu'à 4 fois et une réduction des artefacts de balayage.
-
Construction de jeux de données de types variés pour une validation complète des modèles, permettant l'observation nanoscopique sur cellules vivantes de processus dynamiques sous-cellulaires tels que les vésicules mitochondriales et le réseau d'actine.
Adresse de l'article :
https://www.nature.com/articles/s41467-026-78580-z
Conception de jeux de données multi-sources, adaptée à l'entraînement et à l'évaluation indépendante
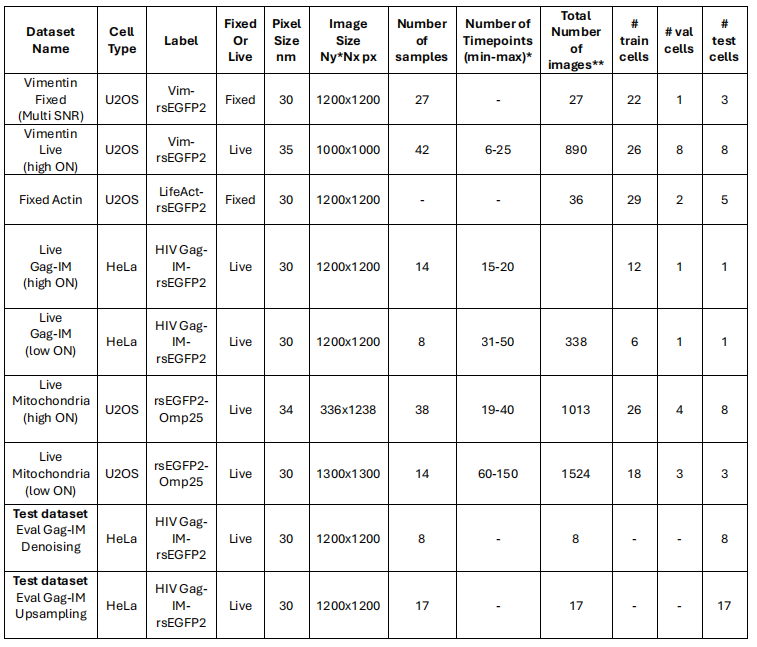
Cette étude a utilisé plusieurs jeux de données RESOLFT aux objectifs distincts, couvrant les jeux de données appariés (Paired datasets), les jeux de données non appariés (Unpaired datasets) et les jeux de données indépendants (Independent datasets). Plus précisément :
Jeux de données appariés
Pour obtenir des jeux de données d'images appariées propres-bruitées, les chercheurs ont fixé les cellules afin d'éviter tout déplacement structurel entre les paires d'images. La fixation limite le nombre de cycles des rsFP, ce qui signifie que le photoblanchiment est plus rapide que dans les cellules vivantes, mais permet néanmoins d'obtenir des images RESOLFT de haute qualité.
Pour le jeu de données de vimentine fixée (Fixed vimentin dataset) U2OS Vim-rsEGFP2, les chercheurs ont d'abord acquis des images bruitées avec une commutation ON d'environ 10 % à 20 % (environ 30 W/cm²) ; puis ils ont acquis 5 images avec une commutation ON d'environ 80 % à 90 % (environ 300 W/cm²). Ce pseudo-série temporelle de signal s'atténue rapidement. Les chercheurs ont utilisé ce processus d'atténuation du signal pour évaluer les résultats de prédiction de HDN, HDNsup et d'upsampling à différents niveaux de rapport signal-sur-bruit, en prenant la moyenne des 3 premières images de la pseudo-série temporelle pour obtenir la référence idéale optimale.
Pour le jeu de données de réseau d'actine fixé (Fixed actin meshwork dataset) U2OS LifeAct-rsEGFP2, le protocole est similaire. Cependant, la première image a été acquise avec une commutation ON d'environ 50 % ; puis 5 images ont été acquises avec une commutation ON d'environ 90 %, et une image de référence idéale de haute qualité a été générée par moyennage, utilisée pour entraîner le modèle HDNsup.
Jeux de données non appariés
Les jeux de données non appariés sont principalement utilisés pour l'entraînement au débruitage non supervisé et à l'upscaling.
Pour le débruitage HDN non supervisé appliqué aux mitochondries et aux particules HIV Gag-IM, les chercheurs ont utilisé des séries temporelles à faible temps de commutation ON, entraînant directement le réseau HDN sur ces séries temporelles à faible rapport signal/bruit. Comme chaque série temporelle contient un grand nombre d'images, un petit nombre de cellules suffit à fournir une quantité suffisante d'images bruitées.
Pour le jeu de données d'entraînement à l'upscaling, les chercheurs ont acquis des séries temporelles RESOLFT standard (comprenant 10 à 40 images), dont la durée était adaptée à chaque cellule et structure afin de garantir un rapport signal/bruit suffisant pour l'ensemble de la série.
Jeu de données de test indépendant
Concernant les particules HIV Gag-IM, les chercheurs ont acquis deux jeux de test supplémentaires : un jeu d'évaluation du débruitage (comprenant des images acquises dans trois conditions : faible commutation ON, forte commutation ON et microscopie confocale améliorée) et un jeu d'évaluation de l'upscaling (comprenant uniquement des images acquises dans deux conditions : forte commutation ON et microscopie confocale améliorée). Il est à noter que ces jeux de données ont tous été acquis sur des cellules vivantes, ce qui implique donc la présence d'effets liés au mouvement cellulaire.
Chaque jeu de données est divisé de manière aléatoire en ensembles d'entraînement, de validation et de test. La taille des images couvre 64 × 64, 96 × 96 et 128 × 128 pixels ; les blocs manquant d'information sont éliminés. Les détails des jeux de données sont présentés dans la figure ci-dessous :
Décomposition du problème central : se concentrer sur le débruitage d'images et la reconstruction d'échantillonnage clairsemé
Cette étude se concentre sur la technologie RESOLFT, dont la méthode de base utilise l'implémentation MoNaLISA — une technologie d'imagerie RESOLFT parallélisée de pointe. MoNaLISA intègre des modes multifocaux pour la commutation ON et la lecture, ainsi que des modes linéaires périodiques superposés pour la commutation OFF, permettant une imagerie en cellules vivantes avec une résolution spatiale de 45 à 60 nanomètres à une cadence d'environ 0,5 Hz dans un champ de vision (FOV) d'environ 40 × 40 µm².
Sur cette base, les chercheurs ont proposé d'utiliser l'apprentissage profond pour restaurer les images à faible rapport signal/bruit ou les images sous-échantillonnées, afin de dépasser les limites des méthodes RESOLFT traditionnelles. La logique est simple : utiliser la technologie de débruitage d'images pour réduire la dose de lumière nécessaire à l'imagerie, atténuant ainsi le photoblanchiment ; construire un cadre de calcul pour restaurer les données acquises par échantillonnage clairsemé, en améliorant la résolution temporelle via un upscaling computationnel.
Plus précisément, l'intensité de la lumière de commutation ON détermine le nombre de rsFP activés, contrôlant ainsi l'intensité du signal acquis. Les approches traditionnelles activent généralement 80 % à 90 % des rsFP pour maximiser le rapport signal/bruit ; cette étude propose au contraire une stratégie consistant à n'activer que 10 % à 20 % des rsFP, pour acquérir des images à faible rapport signal/bruit, puis reconstruire des images de haute qualité via un débruitage par apprentissage profond. Cela permet non seulement de minimiser le photoblanchiment, mais aussi d'atténuer la phototoxicité due à l'utilisation de longueurs d'onde courtes (généralement 405 nm) pour la commutation ON.
Sur cette base, les chercheurs ont proposé d'utiliser HDN, un algorithme de débruitage d'images non supervisé. Cette méthode repose sur une architecture de réseau auto-encodeur variationnel à niveaux (LVAE), intégrant également un modèle de bruit mesuré expérimentalement. L'étude fournit également une variante supervisée de HDN, appelée HDNsup, basée sur le même cadre mais entraînée de manière supervisée. L'objectif de proposer à la fois des versions non supervisées et supervisées est d'utiliser l'apprentissage supervisé lorsqu'une vérité terrain (GT) de haute qualité est disponible, tout en garantissant la stabilité et l'utilité du mode non supervisé en l'absence de vérité terrain. Par ailleurs, la stratégie idéale doit assurer une réduction efficace du bruit sans sacrifier la résolution spatiale.
Dans HDN, le réseau principal LVAE sert à apprendre les a priori structurels hiérarchiques des données d'images biologiques, capturant simultanément des caractéristiques multi-échelles, allant des contours grossiers aux textures fines. Plus important encore, ce modèle est un modèle d'a priori multi-solutions, ne produisant pas un résultat unique et déterministe ; le modèle de bruit expérimental est quant à lui au cœur de l'entraînement non supervisé de HDN, décrivant la probabilité conditionnelle du signal réel propre derrière une observation bruitée par le système d'imagerie. De plus, ce cadre s'adapte facilement à l'entraînement supervisé, permettant à HDN d'exploiter les informations de vérité terrain propre connues, tout en conservant les deux caractéristiques majeures de HDN : sa représentation multi-solutions et la diversité ajustable de ses sorties.
La seconde approche de l'étude consiste à construire un cadre pour restaurer les images échantillonnées de manière clairsemée, dans le but de visualiser la dynamique rapide des cellules vivantes. Plus précisément, le temps d'acquisition dépend du nombre de pas de balayage, et l'association d'un échantillonnage clairsemé à des techniques de restauration d'images promet d'améliorer considérablement la vitesse d'imagerie tout en maintenant la qualité de l'image. La taille optimale du pas d'échantillonnage est généralement déterminée par le théorème d'échantillonnage de Nyquist-Shannon, afin d'éviter les artefacts d'aliasing ou la redondance d'information ; la taille du pas est égale au double de la fréquence de coupure du système, soit environ la moitié de la résolution attendue. En imagerie RESOLFT, ce pas est d'environ 20 à 30 nm.
Sur cette base, les chercheurs ont proposé Fast MoNaLISA. Cette méthode raccourcit le temps d'acquisition par image en sautant certains pas de balayage, puis utilise un réseau d'upscaling pour restaurer les images sous-échantillonnées. L'avantage est significatif : la dose de lumière reste inchangée, tandis que la résolution temporelle est améliorée. Cette idée a déjà été utilisée en microscopie confocale à limite de diffraction, mais n'avait pas encore été validée en imagerie nanoscopique super-résolue au-dessous de 100 nm. Par ailleurs, un détail technique clé de cette étude est que, lors de la réduction de l'échantillonnage, la dose de lumière de commutation OFF est maintenue constante, ce qui permet de conserver la résolution d'imagerie originale sur l'échantillon.
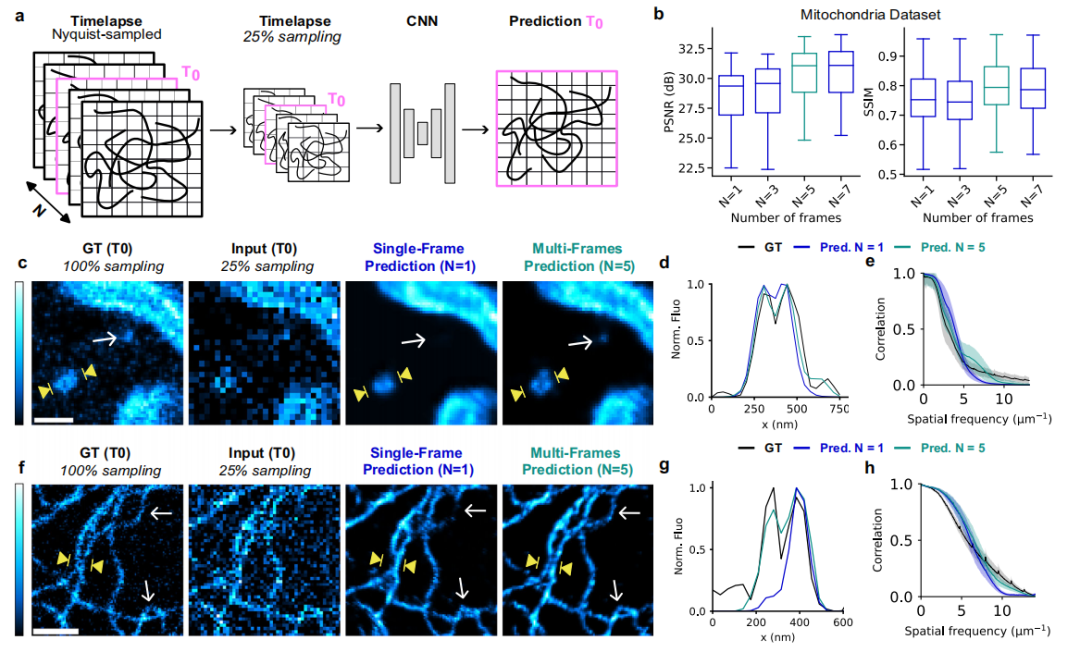
Fast MoNaLISA met en œuvre deux paradigmes d'entraînement : l'entraînement en image unique et l'entraînement multi-images. L'entraînement en image unique est destiné à la restauration par super-résolution de scènes statiques, fournissant au réseau des données correspondant à un seul instant. L'entraînement multi-images est une amélioration de la méthode d'entraînement en image unique, visant à imager les processus dynamiques rapides des molécules intracellulaires et des organites. Dans cette méthode, les chercheurs utilisent des images en série temporelle sous-échantillonnées comme entrée, plutôt qu'une seule image instantanée, générant des images sous-échantillonnées pour chaque instant en appliquant les mêmes étapes de sous-échantillonnage aléatoire que dans l'entraînement en image unique. Le réseau est ensuite entraîné pour prédire les instants intermédiaires de la série temporelle, tout en apprenant les informations supplémentaires fournies par le contexte temporel additionnel des images d'entrée, ce qui améliore la fidélité de la reconstruction.
Concernant l'architecture du réseau, la structure de base de la reconstruction par super-résolution de Fast MoNaLISA est UNet-RCAN, en conservant la dernière couche de super-résolution de l'architecture RCAN originale, sans la supprimer. La raison de ce choix est simple : RCAN a été conçue spécifiquement pour les tâches de super-résolution d'images, ce qui la rend naturellement adaptée à la restauration d'images sous-échantillonnées dans cette étude. De plus, dans les choix architecturaux, le modèle conserve le corps principal U-Net pour aider à une convergence plus rapide.
10 fois moins d'éclairage, 5 fois plus de durée d'acquisition, 4 fois plus de vitesse
L'étude a d'abord évalué la capacité de HDN à reconstruire des images à faible taux de commutation ON. Les méthodes non supervisées Noise2Void (N2V) et Self-Inspired Noise2Noise (SN2N), ainsi que les méthodes supervisées Content-Aware Image Restoration (CARE) et UNet-RCAN, ont été sélectionnées pour la comparaison avec HDN.
Les résultats montrent que la largeur totale à mi-hauteur (full width at half-maximum, FWHM) moyenne de la vérité terrain (GT) est de 58 nm, tandis que HDN et HDNsup maintiennent la résolution spatiale avec des FWHM moyennes de 56 nm et 54 nm respectivement. En comparaison, la FWHM moyenne de la méthode non supervisée SN2N est de 120 nm et celle de N2V de 93 nm ; les méthodes supervisées sont relativement meilleures, avec 73 nm pour CARE et 70 nm pour UNet-RCAN. Cependant, ces dernières tendent toujours à lisser les structures cellulaires, entraînant une perte de détails fins, ce qui fait que leur FWHM moyenne reste supérieure à celle de la vérité terrain, et leurs courbes de corrélation en anneau de Fourier (FRC) diminuent dans les basses fréquences, comme illustré ci-dessous :
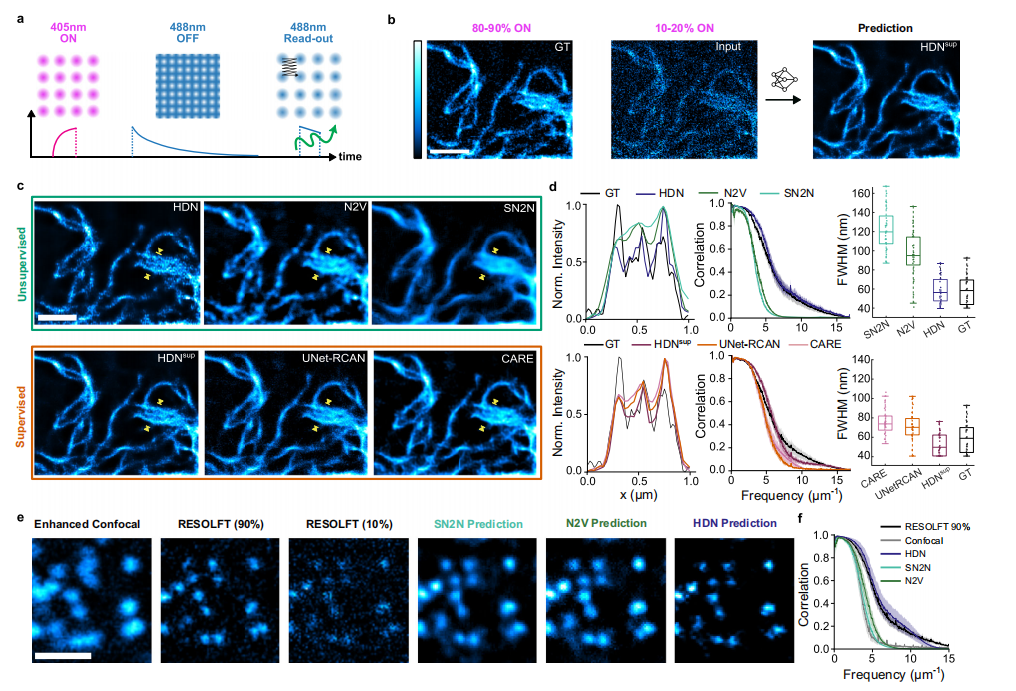
Il est toutefois important de noter que la performance limitée des méthodes de débruitage supervisées ne provient pas de l'architecture du réseau elle-même, mais de l'insuffisance de la qualité de la vérité terrain. Par conséquent, comme pour d'autres méthodes d'apprentissage supervisé, bien que HDNsup offre des performances excellentes, sa performance dépend toujours fortement de la qualité de la vérité terrain.
Les chercheurs ont ensuite validé l'efficacité de la méthode de débruitage HDN sur des structures ponctuelles plus éparses. Les résultats montrent que HDN peut restaurer avec précision ces structures ponctuelles et préserver les détails super-résolus qui ne peuvent être observés en imagerie confocale standard. C'est ce que les autres méthodes de débruitage non supervisées ne parviennent pas à faire, et la FRC confirme également cette conclusion. Bien sûr, lorsque le rapport signal/bruit est extrêmement faible, la précision de prédiction diminue ; il faut donc choisir et valider avec prudence le niveau de commutation ON pour garantir la fiabilité des prédictions. Pour HIV Gag-IM-rsEGFP2, un taux d'activation de l'état brillant de 5 % entraîne des artefacts de reconstruction importants, tandis que 10 % constitue un seuil de fonctionnement plus fiable.
Pour valider la capacité du schéma à réaliser une imagerie en série temporelle prolongée sur des cellules vivantes, l'énergie lumineuse utilisée en ultraviolet-visible étant réduite à environ 1/10 de la valeur initiale, la durée d'acquisition en série temporelle a pu être prolongée jusqu'à environ 5 fois par rapport à la méthode RESOLFT conventionnelle à taux de commutation ON élevé. Comme illustré ci-dessous. Il est à noter que ces expériences ont toutes été réalisées à des niveaux d'expression endogène de la molécule vimentine. Pour des échantillons plus brillants, tels que le modèle mitochondrial externe rsEGFP2, le HDN non supervisé a été utilisé à la place, permettant une acquisition en série temporelle de plus de 100 images.
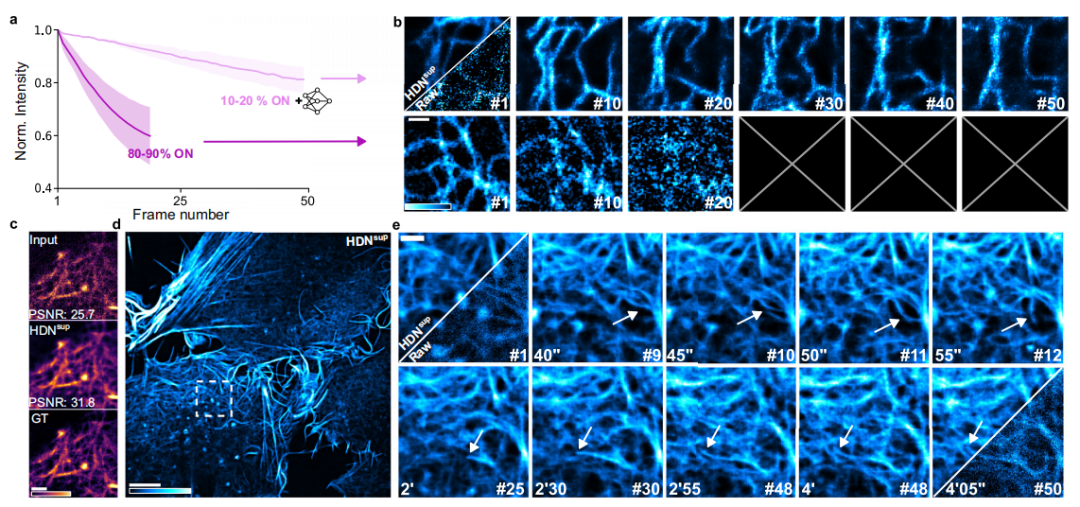
Les chercheurs ont continué à utiliser HDNsup pour imager des structures complexes et entrelacées, telles que les réseaux d'actine. En acquérant des données de haute qualité sur des cellules fixées exprimant LifeAct-rsEGFP2, ils ont d'abord vérifié la capacité de reconstruction précise du réseau d'actine, puis ont transféré cette méthode à l'imagerie de cellules vivantes. Les résultats montrent que HDNsup a réussi à acquérir en continu au moins 50 images, permettant une observation prolongée des processus dynamiques du réseau d'actine.
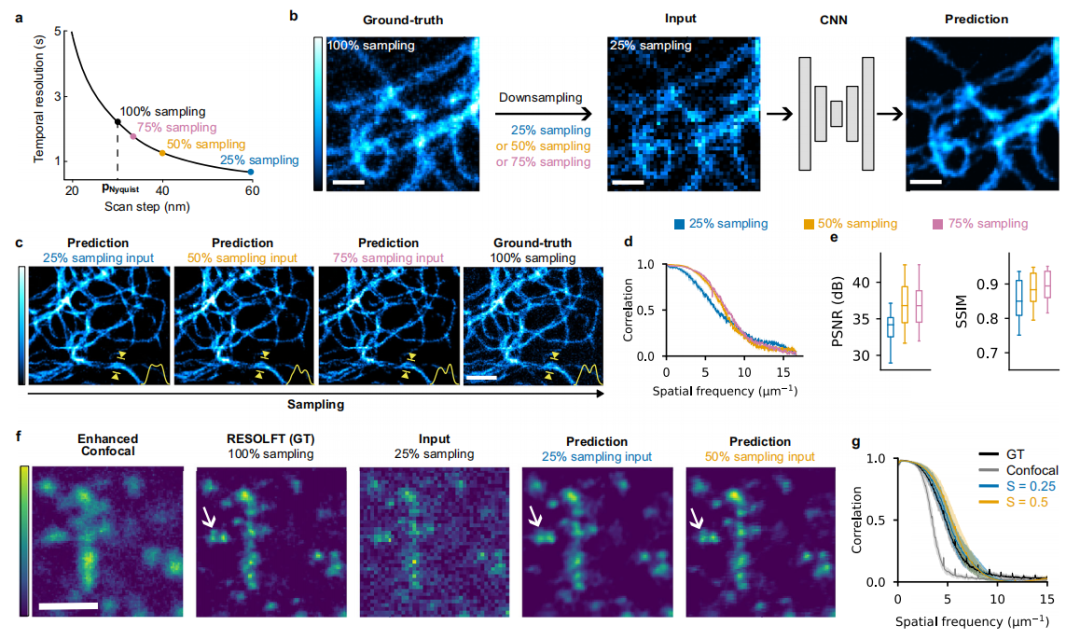
Dans l'évaluation de l'entraînement en image unique et de l'entraînement multi-images, l'étude a exploré trois taux d'échantillonnage : 75 %, 50 % et 25 %, correspondant respectivement à des augmentations de la fréquence d'images de 1,3, 2 et 4 fois.
Les résultats de l'entraînement en image unique indiquent que Fast MoNaLISA offre les meilleures performances sur les images à rapport signal/bruit élevé ; par conséquent, il convient d'utiliser les niveaux de commutation ON conventionnels, soit 80 %-100 %, ce qui est cohérent avec l'objectif global de réduction de la dose d'éclairage, car le sous-échantillonnage réduit lui-même cette dose. Ensuite, le choix du taux d'échantillonnage reflète un compromis entre la vitesse d'imagerie et la fiabilité de la prédiction ; dans la prédiction en image unique, un taux d'échantillonnage de 50 % est le compromis le plus robuste entre vitesse et fidélité. Comme illustré ci-dessous :
Les résultats de l'entraînement sur plusieurs images montrent que Fast MoNaLISA peut reconstruire avec précision les images dans des conditions d'imagerie rapide avec seulement 25 % des pixels acquis, dépassant ainsi les limites de l'entraînement sur une seule image. Comme le montre la figure ci-dessous :
En conclusion
Dans l'ensemble, cette étude a mis en place une approche hybride combinant l'imagerie expérimentale et la reconstruction computationnelle. En s'appuyant sur la technique RESOLFT parallèle, elle permet une observation dynamique à long terme de cellules vivantes entières, avec une résolution spatiale atteignant environ 60 nanomètres. Cette méthode permet de capturer des structures fines telles que le cytosquelette et les vésicules mitochondriales, ainsi que de suivre des signaux faibles et des molécules à mouvement rapide qui n'étaient auparavant observables que statiquement. Par rapport aux techniques de super-résolution en cellules vivantes couramment utilisées, telles que SIM, SOFI et STED, cette méthode atteint un équilibre rare entre une résolution sub-70 nanomètres, la vitesse d'imagerie, la taille du champ de vision et les dommages phototoxiques.
Plus remarquable encore, l'équipe a actuellement publié en open source le cadre logiciel LISAI, et les algorithmes associés peuvent être transposés à d'autres systèmes de microscopie à balayage, tels que STED et la microscopie à disque tournant confocal. Bien entendu, la reconstruction par apprentissage profond implique des compromis paramétriques, nécessitant un ajustement des paramètres en fonction du rapport signal-sur-bruit de l'échantillon. À l'avenir, le modèle pourrait être davantage optimisé pour construire un cadre intégré visant à réduire simultanément la dose lumineuse d'imagerie et le temps d'acquisition.