Command Palette
Search for a command to run...
Rapport Hebdomadaire Des Articles Scientifiques | 8 Articles Axés Sur Les Nouvelles Avancées Des Frameworks D'agents, Couvrant Les Agents De Programmation, Le Contrôle Incarné Et La Génération D'images Et De Vidéos
À mesure que les agents IA passent de simples systèmes de question-réponse à l’exécution de tâches complexes, l’Agent Harness devient progressivement une direction de recherche majeure dans le domaine des agents intelligents. Il s’agit d’un cadre d’exécution reliant les grands modèles de langage, les outils et les environnements d’exécution, chargé d’organiser les flux de tâches, de gérer le contexte et la mémoire, de coordonner les appels d’outils, et de traiter les erreurs ainsi que la validation des résultats pendant l’exécution. En résumé, si le modèle détermine ce que l’agent peut penser, le Harness influence largement la capacité à traduire ces compétences en actions concrètes, stables et fiables.
Pourquoi le Harness suscite-t-il un intérêt croissant ? Avec l’amélioration continue des capacités de raisonnement et de génération des modèles, les défis auxquels font face les agents intelligents ne se limitent plus seulement à produire des réponses correctes, mais incluent également la manière d’achever des tâches multi-étapes de façon continue, de réduire les opérations erronées, de s’adapter à différents environnements d’exécution, et de contrôler les risques au cours de l’action autonome. Le Harness évolue progressivement d’un cadre fondamental soutenant l’exécution des modèles vers une infrastructure critique influençant l’efficacité d’exécution des agents, leurs limites applicatives et leur sécurité.
Autour de ces questions, de nombreuses recherches récentes explorent sous divers angles la conception, l’évaluation et l’optimisation du Harness : certaines études analysent, via des expériences contrôlées, le rôle de la planification, des outils et de la gestion du contexte ; d’autres examinent des mécanismes d’exécution plus fiables dans le domaine des opérations en terminal, du contrôle robotique et de la génération visuelle ; d’autres encore se penchent sur les contraintes de sécurité, la construction automatique et l’amélioration récursive de soi, tentant de faire en sorte que le Harness non seulement fonctionne, mais s’optimise également en continu grâce aux retours des tâches.
Dans cette édition, nous avons sélectionné 8 recherches liées à l’Agent Harness, rassemblant des explorations provenant d’institutions telles que NVIDIA, Google Cloud AI Research, ainsi que de l’Université Northwestern et de l’Université des Sciences et Technologies de Chine (USTC), couvrant des domaines comme la conception de cadres, le contrôle d’exécution, l’intelligence incarnée, la génération visuelle, la gouvernance de sécurité, l’évaluation des compétences d’ingénierie, l’optimisation récursive et l’auto-évolution. Découvrons-les ensemble !
De plus, la section « Articles » du site officiel HyperAI suivra également les avancées de pointe dans le domaine de l’intelligence artificielle, afin de vous aider à rester informés des dernières tendances en matière de recherche ⬇️
Voir les derniers articles :
Recommandations d’articles de la semaine
1. Conception du Harness pour les agents de codage
Titre de l’article :
An Empirical Study of Harness Design for Coding Agents
Article et analyse détaillée :
Cette étude mène une analyse empirique systématique de la conception du Harness pour les agents de codage, en examinant principalement comment différents mécanismes d’exécution influencent la performance des tâches lorsque le modèle sous-jacent reste inchangé. Les chercheurs ont réalisé des expériences contrôlées autour de trois composants clés : les mécanismes de planification, l’espace d’action et la gestion du contexte, tentant de clarifier l’impact spécifique de chaque partie du Harness sur le taux de réussite des tâches, l’efficacité d’exécution et le coût des ressources, afin d’éviter de juger l’efficacité d’une conception uniquement sur la base des performances finales du système complet.
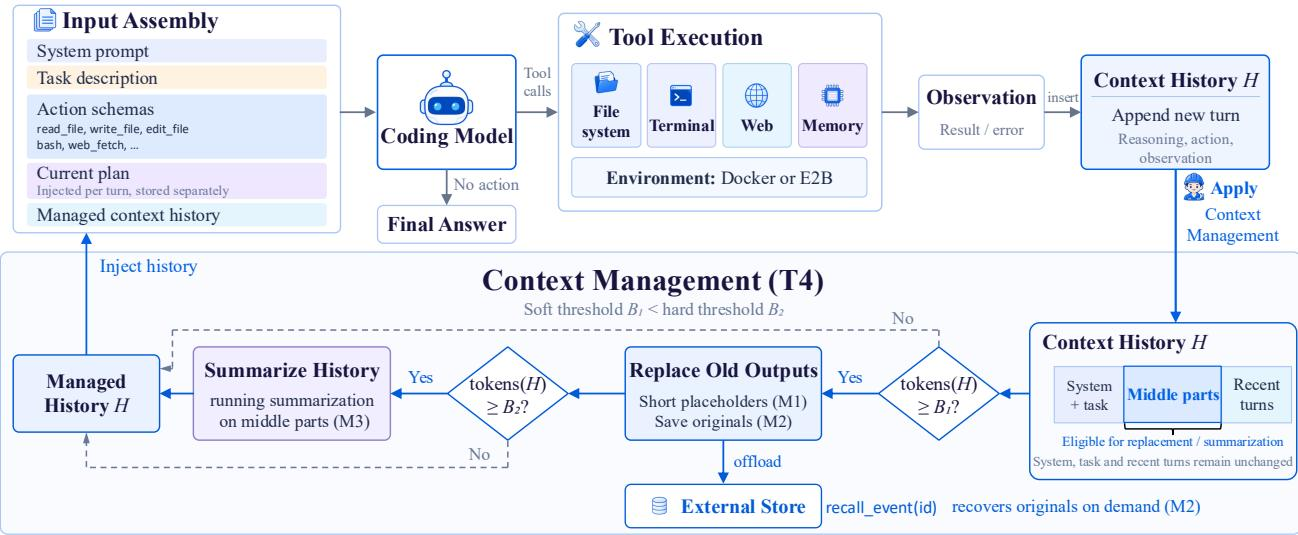
L’équipe de recherche a mené plusieurs expériences comparatives sur des benchmarks tels que SWE-Bench Verified et Terminal-Bench 2.1. Les résultats montrent que la gestion du contexte est particulièrement cruciale pour les tâches à long terme, car le traitement adéquat de l’historique permet de réduire les échecs dus au débordement de contexte ; les mécanismes de planification offrent des bénéfices variables selon les capacités des modèles, et le choix des interfaces d’outils doit également être adapté aux caractéristiques des modèles. L’étude indique que plus il y a de composants dans le Harness, ce n’est pas nécessairement mieux, et qu’il doit être conçu en fonction des besoins des tâches, des capacités des modèles et des budgets de ressources, fournissant une base empirique pour des recherches futures sur l’optimisation quantifiable du Harness.
2. Mid-Harness
Titre de l’article :
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
Article et analyse détaillée :
Des chercheurs de NVIDIA, de l’Institut supérieur des sciences et technologies de Corée (KAIST) et d’autres institutions ont proposé Mid-Harness, explorant comment ajouter des mécanismes d’échantillonnage et de validation d’actions entre le grand modèle de langage et le cadre d’exécution pour améliorer la fiabilité des agents de terminal. Les agents de terminal traditionnels exécutent généralement directement les commandes générées par le modèle, mais des opérations erronées peuvent modifier l’environnement d’exécution et affecter les tâches ultérieures ; même si le modèle possède la capacité de générer de meilleures commandes, il ne garantit pas toujours de fournir le meilleur choix dès la première tentative. Mid-Harness génère plusieurs actions candidates avant l’exécution réelle, puis les compare et les filtre via un validateur, afin de réduire l’impact des opérations inappropriées sur le déroulement des tâches.
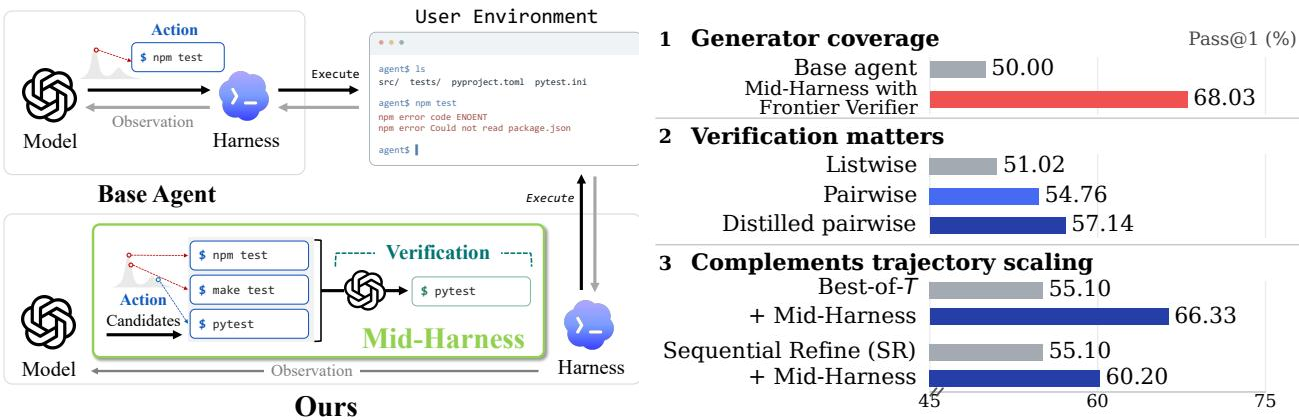
L’équipe de recherche a mené des expériences portant sur les méthodes d’échantillonnage des actions candidates, le choix des validateurs et différentes stratégies d’exécution, analysant la valeur réelle de l’allocation de ressources de calcul supplémentaires entre le modèle et le Harness. L’étude montre que l’augmentation du nombre d’actions candidates n’apporte pas nécessairement de bénéfices, son efficacité dépendant de la capacité du validateur à identifier les opérations supérieures ; des mécanismes appropriés de comparaison et de filtration permettent d’améliorer la qualité des actions et le taux de réussite de l’ensemble du trajet de la tâche. Ce travail déplace l’accent de l’optimisation de la simple amélioration de la capacité de génération du modèle vers la sélection d’actions avant l’exécution, offrant une nouvelle approche pour construire des agents de terminal plus fiables.
3. Show-Harness
Titre de l'article :
Show-Harness : Un agent VLM peut à lui seul piloter des robots
Article et interprétation détaillée :
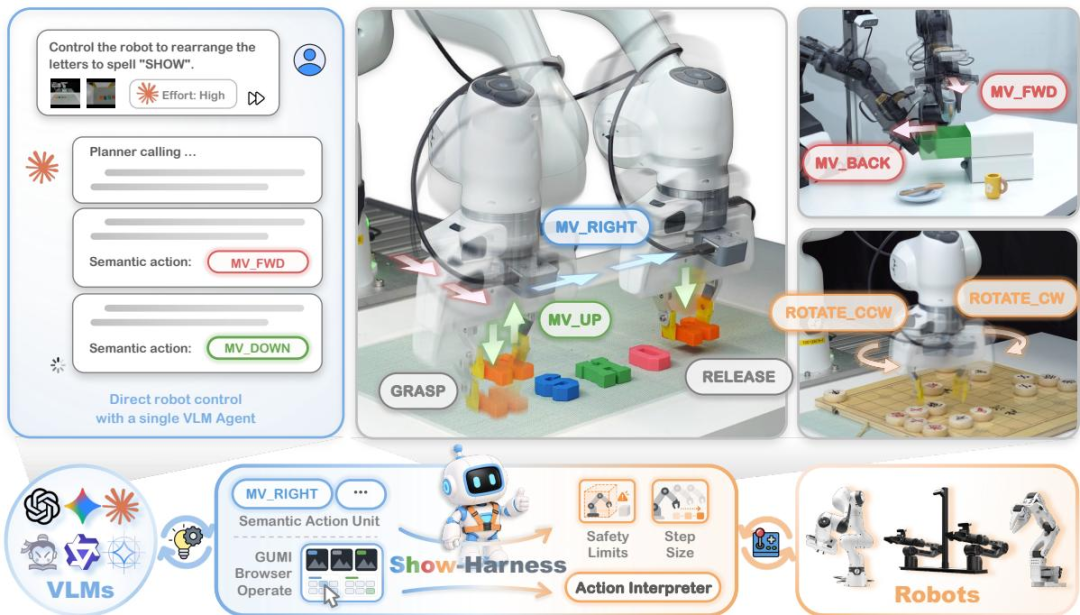
Les chercheurs ont proposé Show-Harness, conçu pour résoudre le problème de la conversion des capacités de compréhension visuelle et de raisonnement linguistique des modèles de vision et de langage (VLM) en opérations robotiques réelles. Les systèmes robotiques traditionnels nécessitent généralement l'entraînement spécifique de modèles Vision-Language-Action ou dépendent de contrôleurs indépendants pour exécuter les instructions générées par des modèles de haut niveau. Show-Harness conçoit une interface d'actions sémantiques qui représente les opérations robotiques sous forme d'unités d'action discrètes que le modèle peut comprendre et raisonner. Un interpréteur, conçu pour des robots spécifiques, convertit ensuite ces actions en commandes de contrôle réelles. De plus, l'équipe de recherche a développé GUMI (GUI Manipulation Interface), qui permet la collecte de démonstrations d'opérations robotiques via une interface graphique, réduisant ainsi la dépendance au matériel de téléopération dédié.
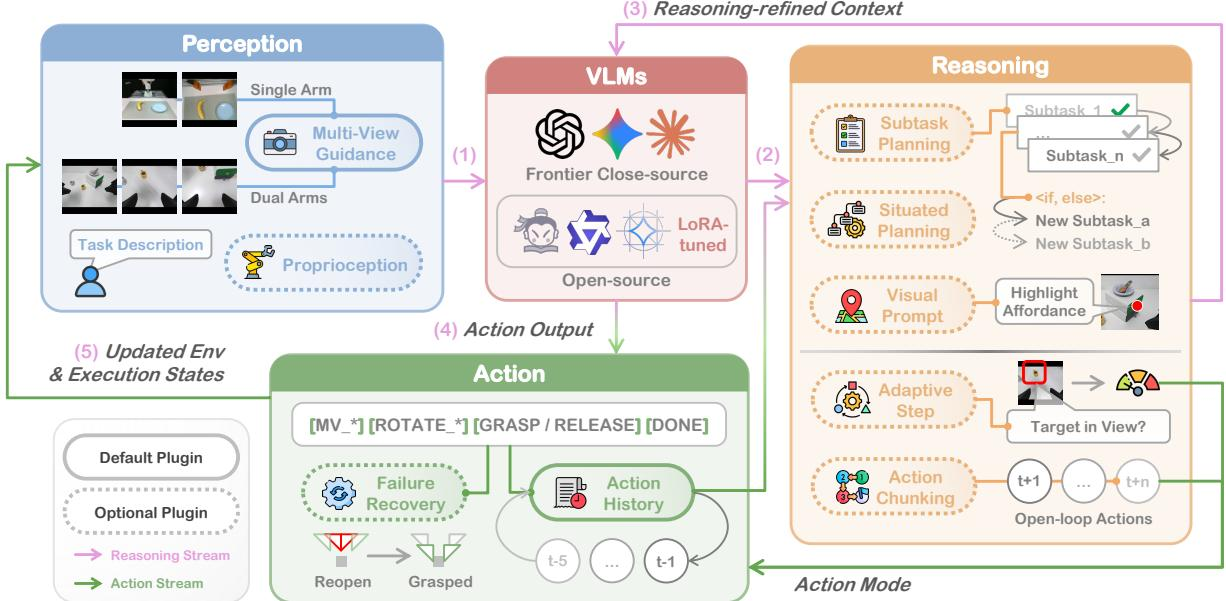
L'équipe de recherche a réalisé des évaluations sur plusieurs tâches, formes de robots et environnements, explorant les performances de ce cadre dans des scénarios de contrôle zéro-shot et de micro-ajustement léger. Les résultats montrent que Show-Harness permet aux VLM de pointe d'effectuer diverses tâches d'opérations robotiques sans micro-ajustement spécifique, et permet également d'adapter des petits modèles open source via un micro-ajustement relativement léger. L'étude montre également que des mécanismes tels que la planification contextuelle, l'historique des actions et la récupération en cas d'échec améliorent la stabilité de l'exécution. Ce travail démontre que la conception rationnelle de l'interface d'interaction entre le modèle et l'environnement peut libérer les capacités incarnées existantes des VLM fondamentaux, faisant évoluer le concept de Harness d'un cadre d'exécution logicielle vers une couche de contrôle de l'action dans le monde physique.
4. MaLiang-Harness
Titre de l'article :
MaLiang-Harness : Une voie programmable pour la génération d'images et de vidéos
Article et interprétation détaillée :
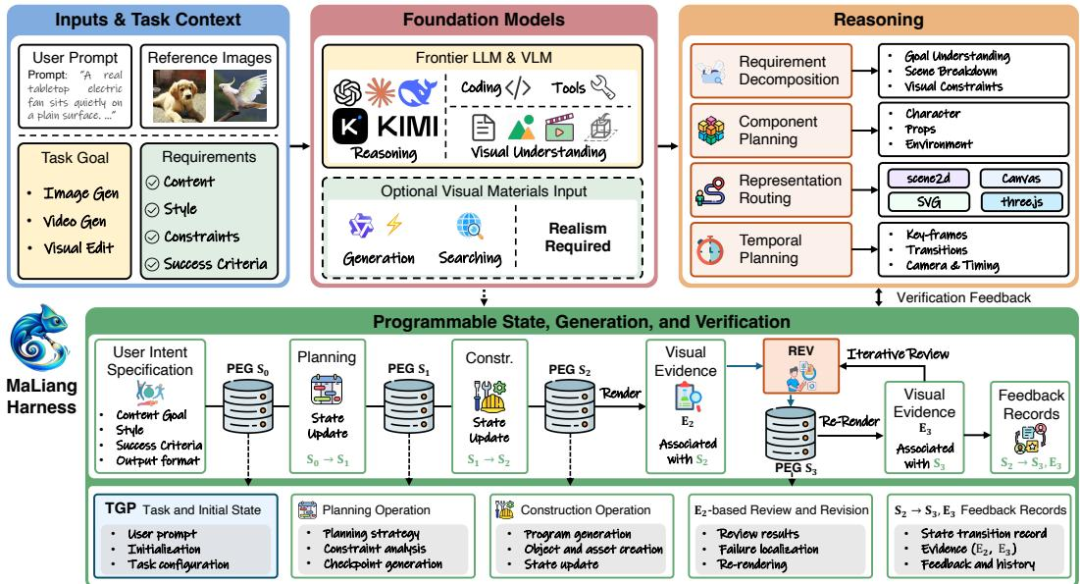
Les chercheurs ont proposé MaLiang-Harness, explorant comment étendre la philosophie de conception du Harness au domaine de la génération d'images et de vidéos. Bien que les méthodes de génération procédurale traditionnelles puissent offrir un contrôle explicite de la composition et de l'animation, le fait que le programme s'exécute avec succès ne garantit pas que le résultat visuel final corresponde aux attentes de l'utilisateur. Pour résoudre ce problème, ce cadre organise la génération visuelle pilotée par de grands modèles de langage multimodaux en un processus continu de construction, de vérification et de révision. En sauvegardant les programmes exécutables et le contexte des tâches, en suivant l'historique des modifications et les preuves de rendu, et en validant la version actuelle, le processus de génération visuelle devient plus traçable, récupérable et itératif.
L'équipe de recherche a construit MaLiang-IBench et MaLiang-VBench pour évaluer respectivement les capacités de génération d'images et de vidéos, et a testé plusieurs grands modèles de langage multimodaux de pointe. Les résultats indiquent que GPT-6-Astra a atteint un taux de réussite de génération de 100 % sur les deux références, mais que les tâches d'image satisfaisant tous les seuils de qualité visuelle représentent 96,0 %, et les tâches vidéo 76,9 %. Ce résultat montre que le succès de l'exécution du programme et l'atteinte de la qualité visuelle finale restent des critères d'évaluation distincts ; des scores de capacités similaires pour les modèles généraux ne signifient pas qu'ils ont les mêmes performances dans les tâches de génération visuelle. Cette étude fournit un cadre d'exécution systématique pour la génération visuelle programmable et élargit le champ d'application du Harness dans les scénarios d'IA générative.
5. EvoSafeHarness
Titre de l'article :
EvoSafeHarness : Faire évoluer les Harness spécifiques aux modèles et aux domaines pour sécuriser les agents
Article et interprétation détaillée :
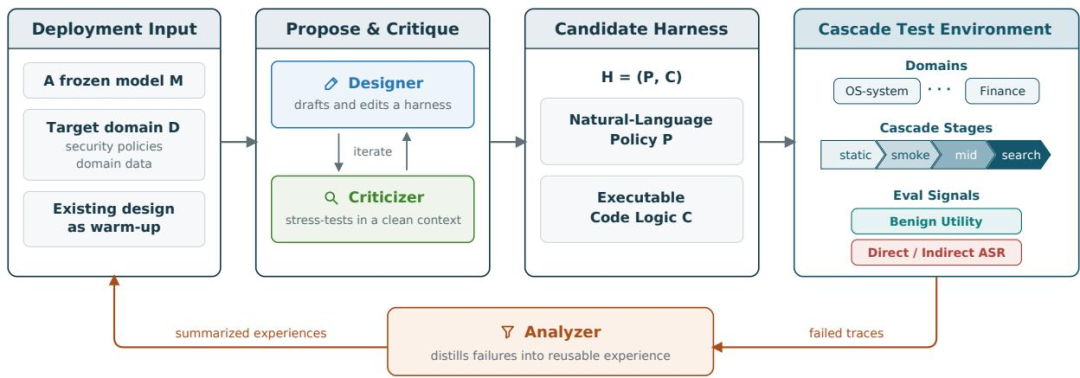
Les chercheurs ont proposé EvoSafeHarness, conçu pour résoudre les problèmes de protection de la sécurité des agents face aux demandes directement nuisibles et aux injections de prompts indirectes. Les contraintes de sécurité traditionnelles sont généralement conçues à l'avance par des experts et appliquées à différents modèles et domaines de tâches. Cependant, les caractéristiques comportementales des différents modèles et les exigences de risque des différents domaines ne sont pas identiques ; les règles fixes peuvent restreindre excessivement les tâches normales ou négliger les risques de sécurité dans des scénarios spécifiques. EvoSafeHarness transforme la conception des contraintes de sécurité en un processus optimisable, ajustant conjointement les politiques de sécurité en langage naturel et la logique de code exécutable. En intégrant les retours comportementaux du modèle cible, les normes du domaine et l'examen adversarial, il génère des ensembles de contraintes mieux adaptés à des environnements de déploiement spécifiques.
L’équipe de recherche a évalué la méthode sur plusieurs types de références de sécurité pour agents. Dans les configurations de test pertinentes de DecodingTrust-Agent, cette méthode a réduit le taux moyen de réussite des attaques de 45,6 % à 10,0 %, avec une perte d’utilité d’environ 3,3 points de pourcentage ; dans les configurations d’évaluation spécifiques d’AgentDojo, le taux de réussite des attaques est tombé à 0,0 %, tandis que l’utilité des tâches normales a atteint 82,8 %. Ces résultats montrent que la conception de mécanismes de sécurité adaptés aux modèles et aux domaines peut améliorer l’équilibre entre la sécurité et l’utilité des tâches. Toutefois, les performances en matière de sécurité dépendent toujours du type d’attaque, de l’environnement de la tâche et de la portée de l’évaluation. Ce travail étend le rôle du Harness au-delà de l’exécution des tâches pour inclure le contrôle des risques, explorant comment permettre aux agents de respecter les limites de sécurité appropriées tout en accomplissant leurs tâches.
6. Doc 2 Harness
Titre du papier :
Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
Papier et analyse détaillée :
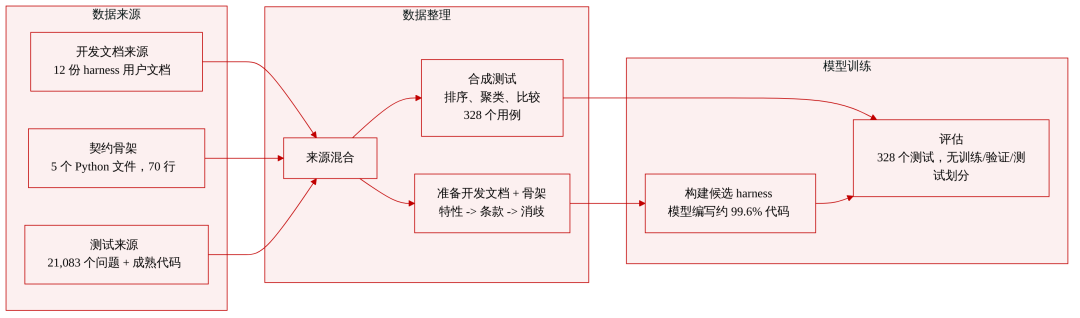
Les chercheurs ont proposé Doc2Harness, visant à évaluer directement la capacité d’ingénierie des grands modèles de langage à construire des Harness d’agents complets. Les études précédentes testaient généralement les performances des agents dans des cadres d’exécution préconçus, mais vérifiaient rarement si les modèles pouvaient construire de manière autonome des cadres d’exécution réellement opérationnels sur la base de documents de développement et de conventions d’interface. Doc2Harness conçoit l’évaluation en deux étapes : d’abord, le modèle de construction génère des Harness candidats à partir des contrats d’interface et des documents de développement ; ensuite, l’équipe de recherche exécute ce cadre dans un environnement isolé, vérifiant si son comportement réel est conforme aux exigences grâce à des informations observables telles que les requêtes du modèle, les fichiers sur disque, les codes de sortie des processus et la sortie des commandes.
L’équipe de recherche a utilisé cette référence pour évaluer 19 modèles de pointe, chaque modèle effectuant trois constructions indépendantes sur 328 cas de test. Les résultats montrent que le meilleur modèle, GPT-6 Astra, a un taux de réussite de 53,05 %, tandis que le modèle le plus faible est de 27,44 % ; même le meilleur modèle n’a pas réussi près de la moitié des cas de test. Les échecs se concentrent principalement sur les fonctionnalités nécessitant une mise en œuvre à travers plusieurs modules, ainsi que sur la répartition des responsabilités entre les différents modules. Les études montrent que la capacité d’un modèle à générer du code ne signifie pas qu’il possède déjà la capacité complète d’ingénierie pour construire des infrastructures d’exécution complexes. Doc2Harness fournit une référence d’évaluation déterministe pour mesurer la capacité d’ingénierie Harness à long terme, et offre également des références pour améliorer les capacités de construction automatique des frameworks d’agents à l’avenir.
7. Harness²
Titre du papier :
Harness²:Recursive Agent Harnessing for an Open World
Papier et analyse détaillée :
Lorsque les agents font face à des tâches réelles en constante évolution et difficiles à définir à l’avance, les Harness traditionnels dépendant de conceptions manuelles et de configurations fixes ont souvent du mal à s’adapter rapidement. Pour répondre à ce problème, la recherche propose Harness², tentant de permettre aux agents non seulement d’accomplir des tâches, mais aussi d’améliorer continuellement leur propre cadre d’exécution pendant le processus d’exécution. Cette méthode construit deux niveaux récursifs interconnectés : la récursion au niveau de la tâche utilise un processus Propose–Probe–Compose pour proposer des modifications candidates du cadre pour la tâche actuelle, exécuter des tests comparatifs, puis décider de les adopter en fonction des traces d’exécution réelles et des résultats de la tâche ; la récursion au niveau du cadre extrait des expériences réutilisables de ces modifications, mettant à jour progressivement la manière d’optimiser les cadres ultérieurs. Même en l’absence de réponses standard permettant de juger directement la correction des tâches, le système peut fournir une base pour les ajustements du cadre en comparant les performances d’exécution sous différentes configurations.
L’équipe de recherche a évalué la méthode sur trois références spécialisées et quatre configurations modèle-cadre. Les expériences montrent que l’amélioration du cadre en une seule étape peut améliorer les performances de GLM-5 et Gemini 3.5 Flash sur plusieurs références : une augmentation maximale de 11,5 points sur WorkBuddy-Bench, une augmentation de 4,5 points sur JobBench, et une augmentation de 11,8 points de pourcentage sur LAB ; à mesure que le budget de récursion au niveau de la tâche augmente, l’amplitude de l’amélioration des performances peut encore s’élargir. L’importance de Harness² réside dans le fait qu’il tente de créer un lien entre « accomplir la tâche actuelle » et « accumuler de l’expérience, améliorer les tâches futures », faisant évoluer le Harness d’une configuration unique vers un système d’exécution capable de s’adapter continuellement à de nouvelles tâches, offrant également une nouvelle approche pour l’auto-amélioration des agents dans des environnements ouverts.
8. Self-Evolving Agent Harness
Titre du papier :
Self-Evolving Agent Harness
Papier et analyse détaillée :
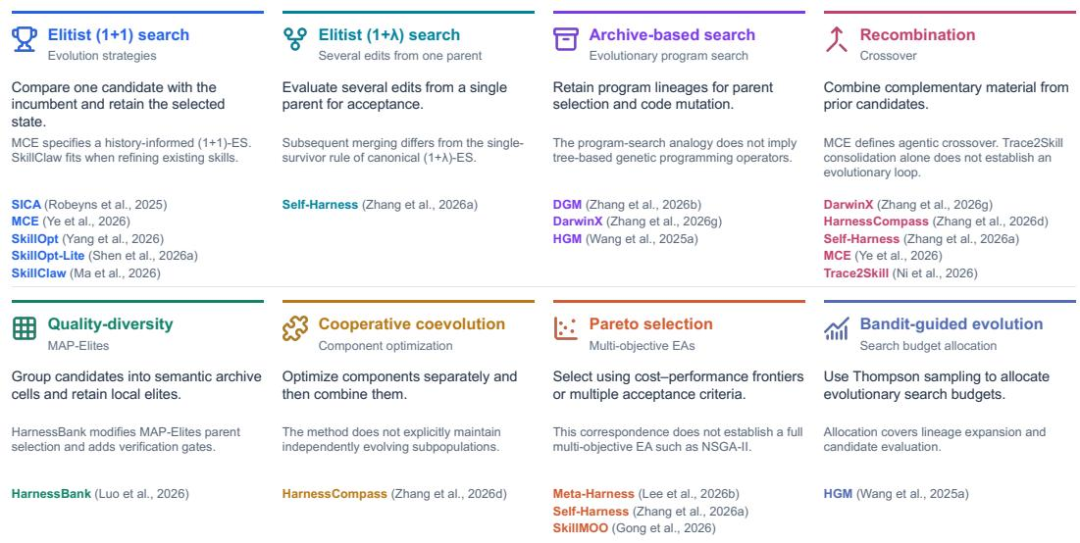
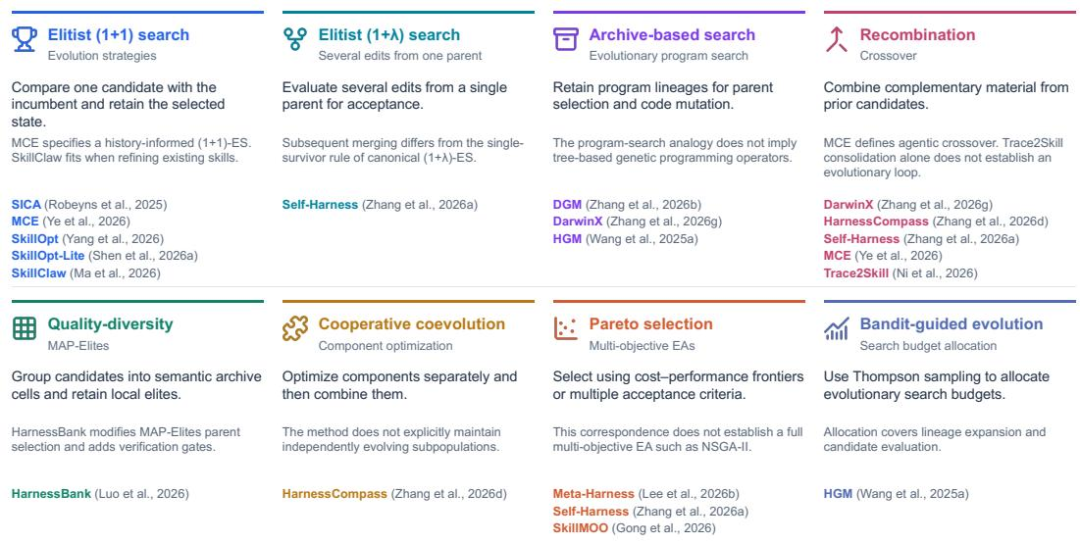
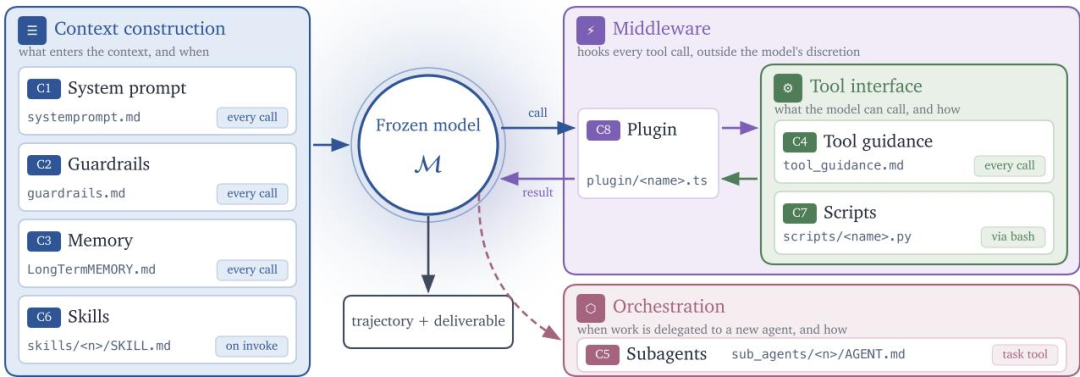
Si les recherches précédentes se concentraient sur la conception du harnais, le contrôle des actions ou l’optimisation récursive des performances des tâches, cette étude pose une question plus holistique : lorsque les agents doivent fonctionner sur le long terme, le harnais peut-il développer un mécanisme d’auto-mise à jour continu ? L’étude définit l’« auto-évolution » comme un processus continu de révision guidé par les retours : sans modifier les poids du modèle sous-jacent, le système peut ajuster les prompts, la mémoire, les flux de travail et les composants exécutables en fonction de l’expérience d’exécution, et conserver les modifications acceptées pour les exécutions futures. Les objets ajustables incluent non seulement des modules individuels, mais aussi les outils et le code, la logique de contrôle au niveau du dépôt, ainsi que les relations de composition entre différents plugins et composants. Parallèlement, l’étude souligne que la proposition de modifications, l’évaluation de leur efficacité et la décision de les adopter officiellement sont trois étapes distinctes à traiter séparément ; on ne doit pas conclure à une valeur à long terme d’une modification sur la seule base d’une amélioration des performances lors d’une tâche ponctuelle.
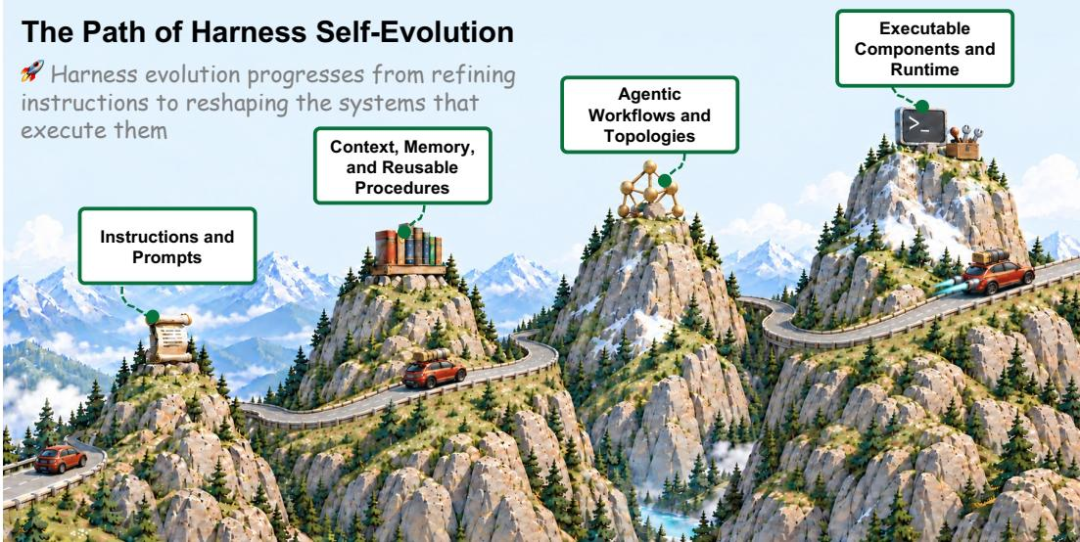
Sur le plan théorique, l’article combine l’optimisation évolutionnaire et l’apprentissage PAC continu pour analyser les problèmes de généralisation et de régression des performances auxquels le harnais peut être confronté lors de mises à jour continues. Il discute, sous des hypothèses explicites, des bornes de généralisation attendues, des bornes de préservation liées aux budgets de régression historique, ainsi que des règles d’admission des modifications candidates basées sur des données de validation totalement nouvelles et indépendantes. Contrairement aux approches consistant simplement à comparer des scores sur un benchmark, cette étude s’intéresse davantage à la manière dont le harnais conserve les expériences efficaces tout en réduisant le surapprentissage, l’oubli et la dégradation des performances sur les anciennes tâches lors d’itérations successives. L’article aborde également les questions de déploiement telles que les changements de distribution des tâches, les biais des évaluateurs, la fiabilité scientifique, la sécurité physique et la responsabilité organisationnelle, en soulignant que la validation continue et les garanties de sécurité indépendantes restent indispensables. La direction tracée est celle d’un harnais qui ne serait plus une structure logicielle statique construite autour du modèle, mais un système capable d’accumuler des retours, de modifier prudemment sa propre structure et de se soumettre à des vérifications continues.