HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
Cambrian-S: Hin zu einer räumlichen Supersensierung in Videos
Skalierung des Lernens von Agenten durch Erfahrungssynthese

V-Thinker: Interaktives Denken mit Bildern
Mit Video denken: Videoerzeugung als vielversprechendes multimodales Schlussfolgerungsparadigma
Neue Entwicklungen in der Biomolekulardynamik-Simulation von Bernstein
UltraHR-100K: Verbesserung der UHR-Bildsynthese mit einem großflächigen, hochwertigen Datensatz
Von fünf Dimensionen zu vielen: Große Sprachmodelle als präzise und interpretierbare psychologische Profiler
Knotenbasierte Bearbeitung für multimodale Generierung von Text, Audio, Bild und Video
DR. WELL: Dynamisches Reasoning und Lernen mit symbolischen Weltmodellen für körperhafte, auf Sprachmodellen basierende Multi-Agenten-Kooperation
Orion-MSP: Multi-Scale Sparse Attention für tabellenbasiertes In-Context-Lernen
TabTune: Eine einheitliche Bibliothek für die Inferenz und Feinabstimmung tabellenbasierter Grundmodelle
Technischer Bericht zu Step-Audio-EditX
LEGO-Eval: Ein Ansatz für eine feinabgestimmte Bewertung der Synthese 3D-embodierter Umgebungen mit Werkzeugerweiterung
UniAVGen: Einheitliche Audio- und Videogenerierung mit asymmetrischen, quermodalen Wechselwirkungen
Diffusions-Sprachmodelle sind überlegene Datenerlerner
UNO-Bench: Ein einheitlicher Benchmark zur Untersuchung des Zusammensetzungsgesetzes zwischen einmodalen und omni-modalen Komponenten in omni-Modellen
Dynamische, populationsverteilungsbeobachtende Generierung menschlicher Trajektorien mit Diffusionsmodellen
Text-zu-Roboter-Assemblierung mehrkomponentiger Objekte unter Verwendung von 3D-generativer KI und Vision-Sprach-Modellen
Kosmos: Ein KI-Wissenschaftler für die autonome Entdeckung
Kürzer, aber nicht schlechter: Sparsame Schlussfolgerung durch einfache Beispiele als Längenregulatoren in der Mathematik-RLVR
Brain-IT: Bildrekonstruktion aus fMRT mittels Brain-Interaction-Transformer
Wenn Modalitäten im Widerspruch zueinander stehen: Wie die Unsicherheit des unimodalen Schließens die Präferenzdynamik in multimodalen großen Sprachmodellen steuert
Blenden Sie Ihren VLA nicht aus: Anpassung visueller Darstellungen für OOD-Verallgemeinerung
Wenn Visualisieren der erste Schritt zum Schlussfolgern ist: MIRA, eine Benchmark für visuelle Kette des Denkens
VCode: Ein multimodales Kodierungsbenchmark mit SVG als symbolischer visueller Darstellung
Der KI-Produktivitätsindex (APEX)
Chain-of-Frames: Fortschritte im Verständnis von Videos in multimodalen LLMs durch rahmenbewusstes Schlussfolgern
Zu robuster mathematischer Schlussfolgerung
Zur Gestaltung einer zukünftigen, raumgestützten, hochskalierbaren Infrastruktur für künstliche Intelligenz
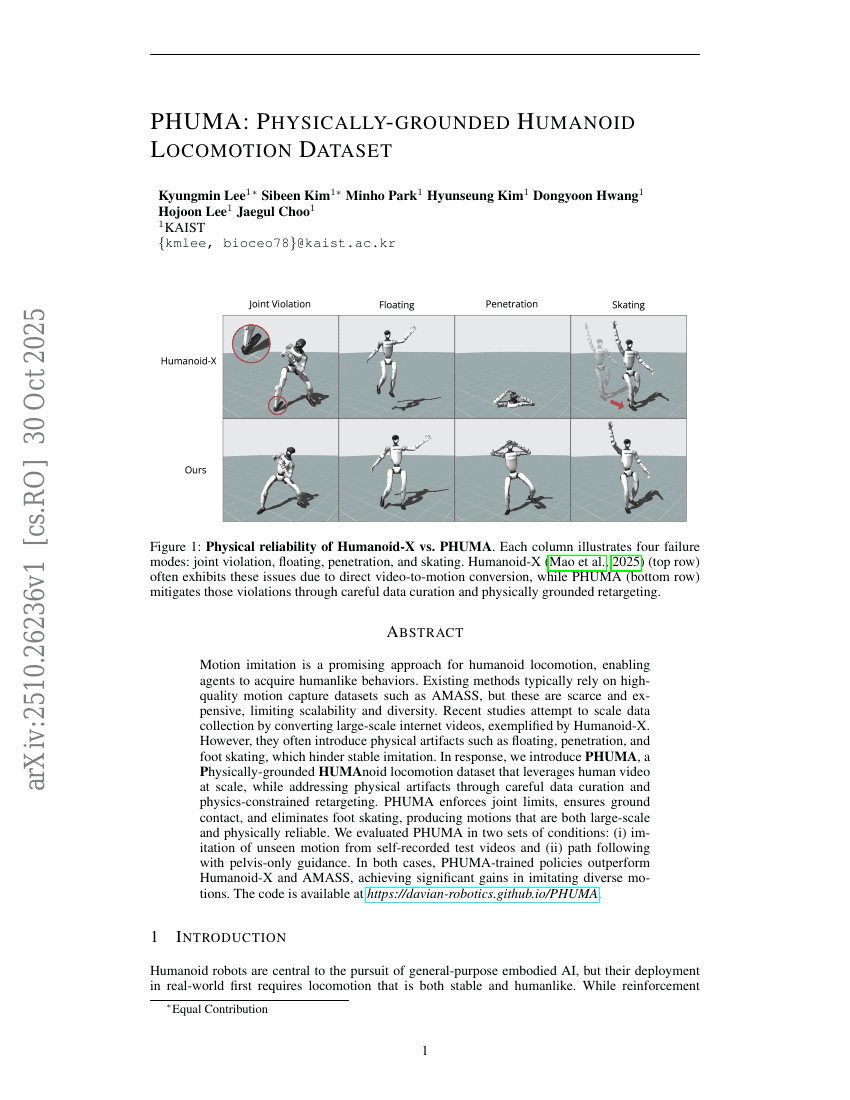
PHUMA: Physikalisch-gegründeter Datensatz für humanoides Gehen
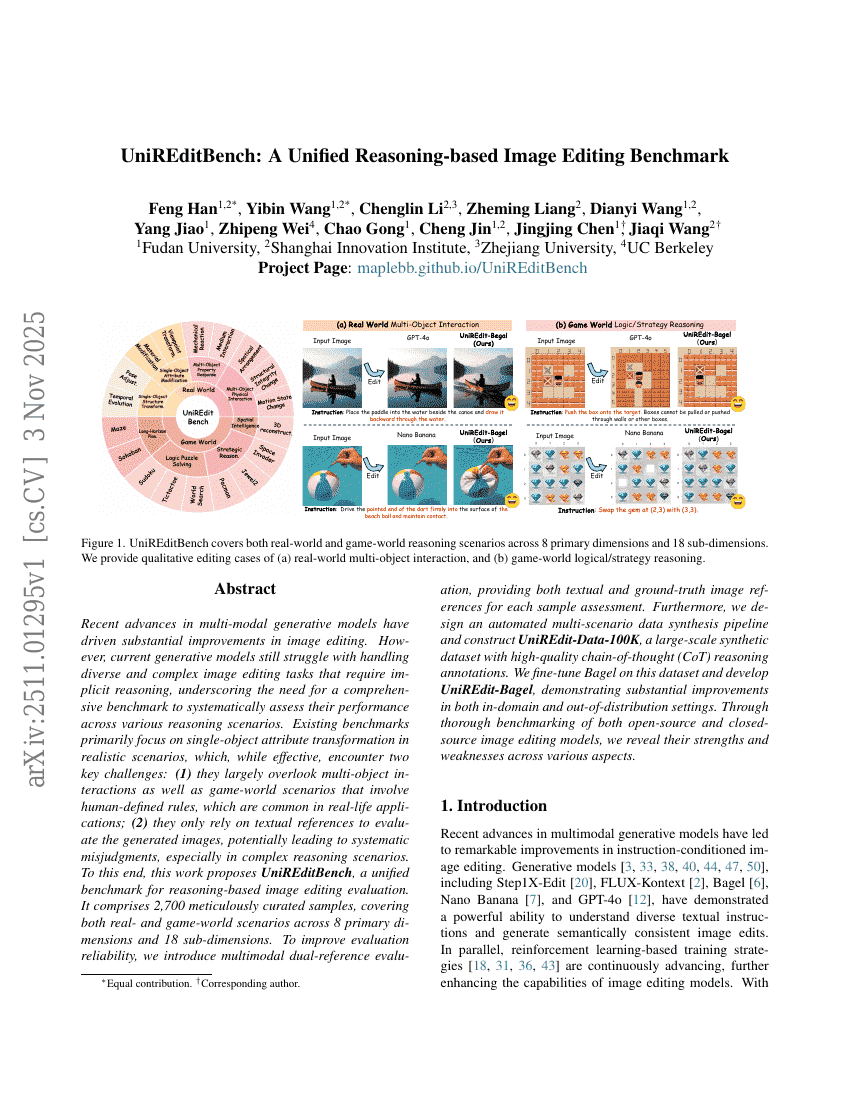
UniREditBench: Ein einheitlicher, auf Schlussfolgerung basierender Benchmark für Bildbearbeitung
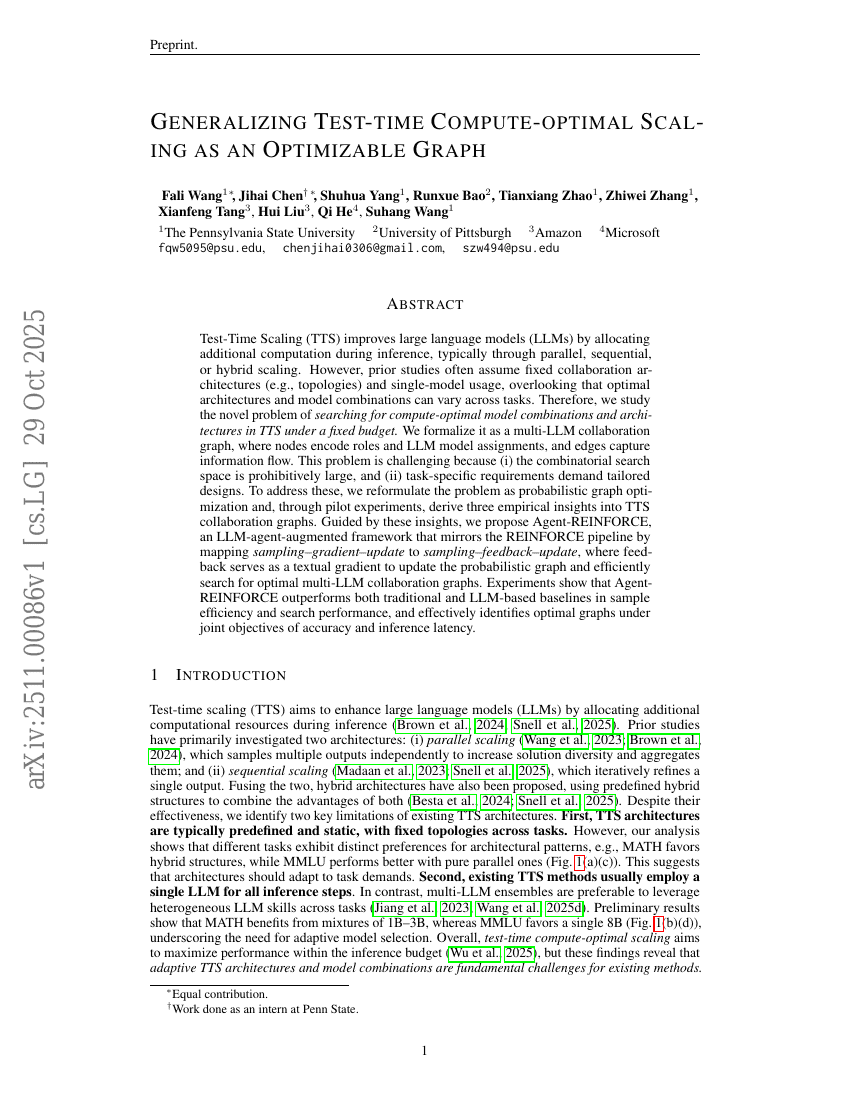
Verallgemeinerung der testzeitoptimalen Skalierung der Rechenleistung als optimierbarer Graph