Command Palette
Search for a command to run...
3600万 Zellen in Einem Einzigen Raum – Stanford University Stellt Universelles Zell-Einbettungsmodell UCE Vor, Das Über 8 Spezies Hinweg Eine Extrem Große Zellkarte Erstellt

In den vergangenen Jahren hat sich die Zellbiologie darauf konzentriert, die verschiedenen Phänotypen zu beschreiben, die Zellen annehmen können, die Beziehungen zwischen verschiedenen Zuständen sowie die Art und Weise, wie Zellen während Entwicklung und Krankheit zwischen diesen Zuständen wechseln.
Das starke Wachstum des Umfangs von Einzelzell-RNA-Sequenzierungsdatensätzen (scRNA-seq) bietet neue Möglichkeiten, solche Fragen erneut zu untersuchen. Bestehende Berechnungsmethoden haben jedoch weiterhin Schwierigkeiten, diese hochgradig vielfältigen Datensätze gemeinsam zu analysieren, da Modelle durch artspezifische Einschränkungen, datensatzspezifische Artefakte oder Batch-Effekte beeinträchtigt werden können. Einige Berechnungsmethoden für scRNA-seq-Daten konnten einige dieser Einschränkungen überwinden, allerdings auf Kosten einer speziellen Anpassung des Modells für jeden neuen Datensatz.
In diesem Zusammenhang schlug das Forschungsteam der Stanford University das universelle Zelleinbettungs-Basismodell (universal cell embedding, UCE) vor. UCE besitzt die einzigartige Fähigkeit, ohne Feinabstimmung oder erneutes Training des Modells Repräsentationen für neue Einzelzell-Genexpressionsdatensätze zu erzeugen, während es gleichzeitig robust gegenüber datensatzspezifischen und batchspezifischen Artefakten bleibt. Darüber hinaus benötigt UCE weder Zelltyp-Annotationen noch eine Vorverarbeitung wie Genfilterung der Eingabedatensätze. UCE kann auf jede beliebige Gruppe protein-kodierender Gene aus beliebigen Spezies angewendet werden, selbst wenn diese Gene keine homologe Beziehung zu Genen aufweisen, die während des Modelltrainings gesehen wurden. Auf diese Weise erlernt UCE eine universelle und intrinsisch biologische Bedeutung tragende Repräsentation der Zellbiologie, die es Forschenden ermöglicht, biologische Erkenntnisse zu gewinnen, die über die direkt beobachteten experimentellen Daten hinausgehen.
Die entsprechenden Forschungsergebnisse wurden unter dem Titel „Universal cell embedding provides a foundation model for cell biology" in Nature veröffentlicht.
Forschungshighlights:
-
Für neue Zelldaten benötigt UCE keine Datenannotation, kein erneutes Modelltraining oder Feinabstimmung, um sie in diesen einheitlichen Repräsentationsraum abzubilden
-
Die von UCE erlernten Repräsentationen zeigen eine emergente organisatorische Struktur von Zelltypen und Zellzuständen, die mit bekannten biologischen Gesetzmäßigkeiten übereinstimmt
-
UCE kann neue Daten in einen universellen Einbettungsraum abbilden, in dem bereits annotierte Referenzzellzustände existieren
Paper-Adresse:
https://www.nature.com/articles/s41586-026-10689-z
Aufbau eines IMA-Trainingsdatensatzes mit über 36 Millionen Zellen
Das Forschungsteam konstruierte einen Trainingsdatensatz namens Integrated Mega-scale Atlas (IMA), der Einzelzell-RNA-Sequenzierungsdaten aus verschiedenen öffentlichen Quellen integriert. Die Kerntrainingsdaten von UCE umfassen über 36 Millionen Zellen, wobei die überwiegende Mehrheit der Daten (insgesamt 33,9 Millionen Zellen aus 285 Datensätzen) vom Menschen und von der Maus stammt; der Rest besteht aus 2,3 Millionen Zellen aus 28 Datensätzen, die 8 verschiedene Spezies abdecken: Mensch, Maus, Zebrafisch, Rhesusaffe, Javaneraffe, Mausmaki, Frosch und Schwein.
Bei der Visualisierung des IMA, der Vorhersage von Grüne-Meerkatzen-Zelltypen, dem Abgleich von Zelltyp-Zentroiden neuer Spezies und der Vorhersage von Norn-ähnlichen Zellen verwendeten die Forscher nicht die vollständigen 36 Millionen Zellen, sondern eine repräsentative Stichprobe des IMA, um rechenintensive Aufgaben wie die UMAP-Berechnung zu beschleunigen. Diese repräsentative Stichprobe wurde durch zufällige Auswahl von 10.000 Zellen aus jedem Datensatz ohne Zurücklegen erstellt. Für Datensätze mit weniger als 10.000 Zellen wurde der gesamte Datensatz direkt einbezogen. Die resultierende repräsentative Stichprobe umfasste insgesamt 2.969.114 Zellen, wobei jeder Datensatz in der Stichprobe durchschnittlich 9.486 Zellen enthielt.
Um die Leistung des Modells auf wirklich „fremden" Daten zu bewerten, verwendete die Arbeit außerdem mehrere Datensätze, die nicht am Modelltraining beteiligt waren. Beispielsweise enthält Tabula Sapiens v.2 581.430 Zellen, 27 Gewebe, 167 Batches und 162 einzigartige Zelltypen und ist ein wichtiger Zero-Shot-Testdatensatz der Arbeit. Das Forschungsteam bereitete außerdem Daten von Spezies vor, die während der Trainingsphase nicht gesehen wurden, wie Grüne Meerkatze, Nacktmull und Huhn, um zu testen, ob UCE wirklich über artspezifische Generalisierungsfähigkeiten verfügt. Über diese Daten hinaus analysierte die Arbeit weiterhin Daten von Mäusenieren und menschlichen Lungenerkrankungen, um zu verifizieren, ob UCE neue biologische Beziehungen aus bereits existierenden Zellatlanten entdecken kann.
Alle in der Arbeit analysierten Datensätze sind öffentlich verfügbar und können heruntergeladen werden:
-
Grüne-Meerkatzen-Lunge- und Lymphknoten-Datensatz: Zugangsnummer GSE156755
-
Nacktmull-Datensatz: Zugangsnummer GSE132642
-
Hühner-Retina-Datensatz: Zugangsnummer GSE159107
-
Hühner-Herz-Datensatz: Zugangsnummer GSE149457
-
Maus-Nieren-Datensatz: Zugangsnummer GSE193321
-
Menschlicher Lungenerkrankungs-Datensatz: Zugangsnummer GSE136831
UCE: Ein auf biologischen Informationen basierendes Zell-Basismodell
UCE überwindet die Herausforderungen bei der Integration von scRNA-seq-Datensätzen, indem es Zellen als „RNA-Beutel (bags of RNA)" abstrahiert.
UCE wird vollständig selbstüberwacht trainiert und verwendet keinerlei Zelltyp-Annotationen oder datensatzbasierte Beschriftungen. Wie unten dargestellt, wandelt UCE zunächst die RNA-Genexpressionsdaten einer einzelnen Zelle in eine Gen-Stichprobe mit Expressionsgewichtung um. Anschließend nutzt es ein Protein-Sprachmodell, um die Gene in der Stichprobe anhand der Proteine, die sie kodieren, darzustellen. Dadurch kann UCE allein auf Basis der Proteinsequenzen jedes beliebige protein-kodierende Gen aus jeder Spezies sinnvoll charakterisieren – unabhängig davon, ob diese Spezies in den Trainingsdaten vorkommt. Nach der weiteren Integration von Metadaten wie der chromosomalen Position der Gene wird diese Repräsentation in ein großes Transformer-Modell eingespeist. Auf diese Weise ist UCE in der Lage, ohne weiteres Training Zellen aus beliebigem Gewebe oder beliebigen Spezies in einen gemeinsamen universellen Raum abzubilden.
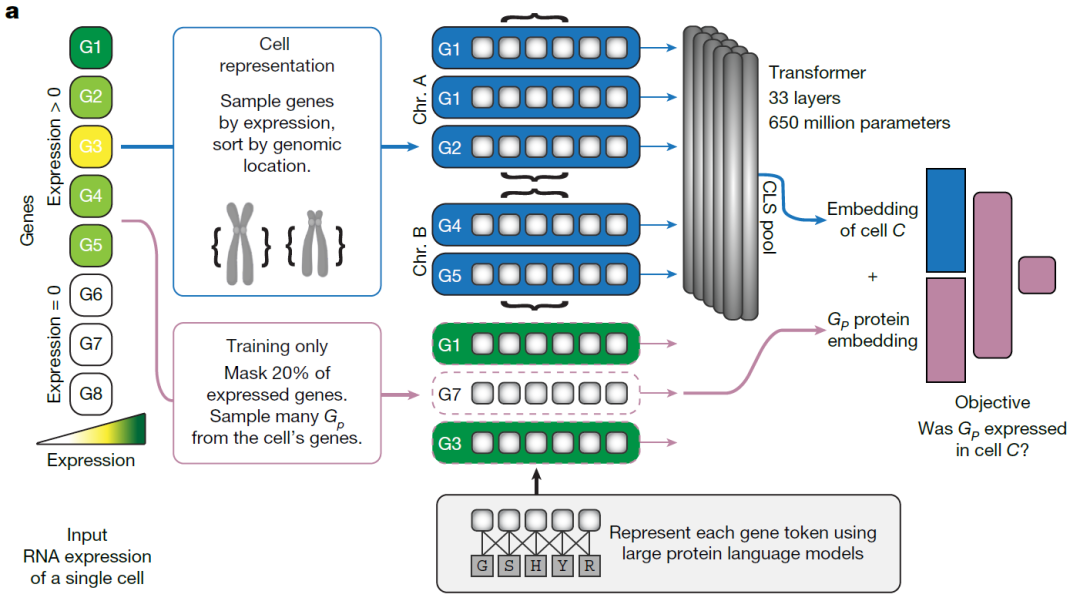
*Überblick über das UCE-Modell*
Die Eingabe von UCE besteht aus zwei Teilen: (1) scRNA-seq-Zähldaten; (2) Protein-Einbettungen, die mit dem Protein-Sprachmodell ESM2 für die Gene im Datensatz erzeugt werden. Das Protein-Sprachmodell ESM2 nimmt Aminosäuresequenzen als Eingabe und gibt eine numerische Darstellung aus, die als Protein-Einbettung (protein embedding) bezeichnet wird.
Für die Genexpressionszähldaten einer Zelle gewichtet und normalisiert UCE die Expressionswerte und sampelt Gene aus der Zelle mit Zurücklegen. Diese Stichprobe darf nur Gene mit einer Expression ungleich Null enthalten, und dasselbe Gen kann mehrfach in der Stichprobe vorkommen. Anschließend werden diese Gene tokenisiert, d.h. in die Protein-Einbettungsrepräsentationen der Proteine, die sie kodieren, umgewandelt.
Gene, die zum selben Chromosom gehören, werden durch das Setzen spezieller Marker gruppiert und nach ihrer Position im Genom sortiert. Anschließend wird ein spezieller Marker, der die gesamte Zelle repräsentiert – der CLS-Token – an den Anfang der Zellrepräsentation gesetzt. Die kombinierte Repräsentation wird in das Transformer-Neuronale Netzwerk eingespeist, und die endgültige Einbettung der Zelle wird aus der Einbettung des CLS-Tokens in der letzten Transformer-Schicht abgeleitet.
Ergebnis: Biologische Erkenntnisse, die über die direkt beobachteten experimentellen Daten hinausgehen
Basierend auf UCE konstruierten die Forscher weiterhin einen integrierten Mega-Scale-Atlas und betteten 36 Millionen Zellen ein, die mehr als 1.000 eindeutig benannte Zelltypen umfassen. Mit Hilfe dieses einheitlichen Raums konnten sie weiter analysieren, wie verschiedene Zelltypen und Gewebe darin organisiert sind.
Der Einbettungsraum von UCE zeigt emergente Fähigkeiten (emergent behaviour)
Die Studie zeigt, dass sich Zellen im UCE-Raum auf natürliche Weise nach biologischen Bedingungen wie dem Zelltyp gruppieren, während Zellen aus verschiedenen experimentellen Bedingungen, z.B. aus verschiedenen Chargen, sich vermischen können (Abbildung b unten). Da UCE während des Trainings nur unannotierte Daten verwendet, ist diese Organisationsstruktur kein explizit antrainiertes Ergebnis des Modells, sondern ein emergentes Verhalten des Modells selbst.
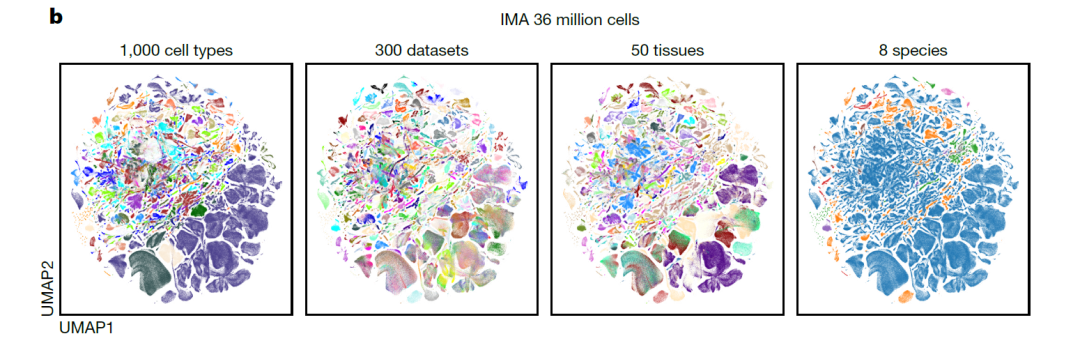
*UMAP-Visualisierung des einheitlichen Manifolds im UCE-Raum*
Das Forschungsteam untersuchte weiterhin, wie die Gewebeherkunft den Zustand verschiedener Zelltypen beeinflusst. Obwohl Makrophagen aus verschiedenen Geweben vielfältige Transkriptom-Profile aufweisen, sind sie im UCE-Raum dennoch hochgradig ausgerichtet. Beispielsweise sind menschliche Makrophagen über 73 verschiedene Gewebe verteilt, und bei 72 % (53 von 73) der gewebespezifischen Makrophagen-Zentroide ist der nächstgelegene Zelltyp im UCE-Raum das Zentroid von Makrophagen aus anderen Geweben.
Eine ähnliche gewebeübergreifende Konsistenz kann auch bei anderen zahlreich vorkommenden Zelltypen beobachtet werden, beispielsweise bei Endothelzellen und Neuronen. Dies deutet darauf hin, dass UCE ohne explizites Training oder manuelle Labels in der Lage ist, die einzigartige, über Gewebe hinweg geteilte Zellidentität von Makrophagen zu erkennen. Dies ist eine emergente Organisationsstruktur von UCE, die mit bekannten biologischen Gesetzmäßigkeiten übereinstimmt, obwohl das Modell nicht speziell auf dieses Phänomen trainiert wurde.
Zero-Shot-Einbettung neuer Datensätze
Die Forscher evaluierten die Zero-Shot-Leistung von UCE an einem neuen, noch unveröffentlichten Datensatz, Tabula Sapiens v.2. Die Ergebnisse zeigen, dass UCE insgesamt 13,9 % besser abschneidet als das beste Geneformer, wobei die Punktzahl für die Erhaltung biologischer Informationen um 16,2 % und die Punktzahl für die Korrektur von Batch-Effekten um 10,1 % höher liegt. Im Vergleich zu anderen Methoden können die von UCE erzeugten Einbettungen verschiedene Zelltypen deutlicher unterscheiden (siehe Abbildung unten).
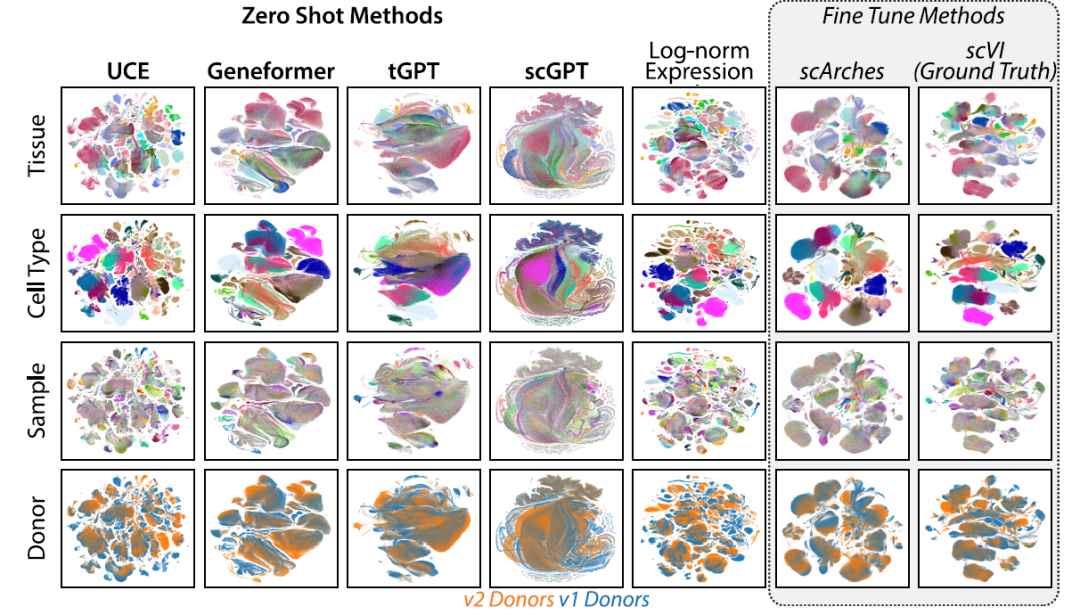
*UCE übertrifft bestehende Methoden bei der Integration von Tabula Sapiens v2*
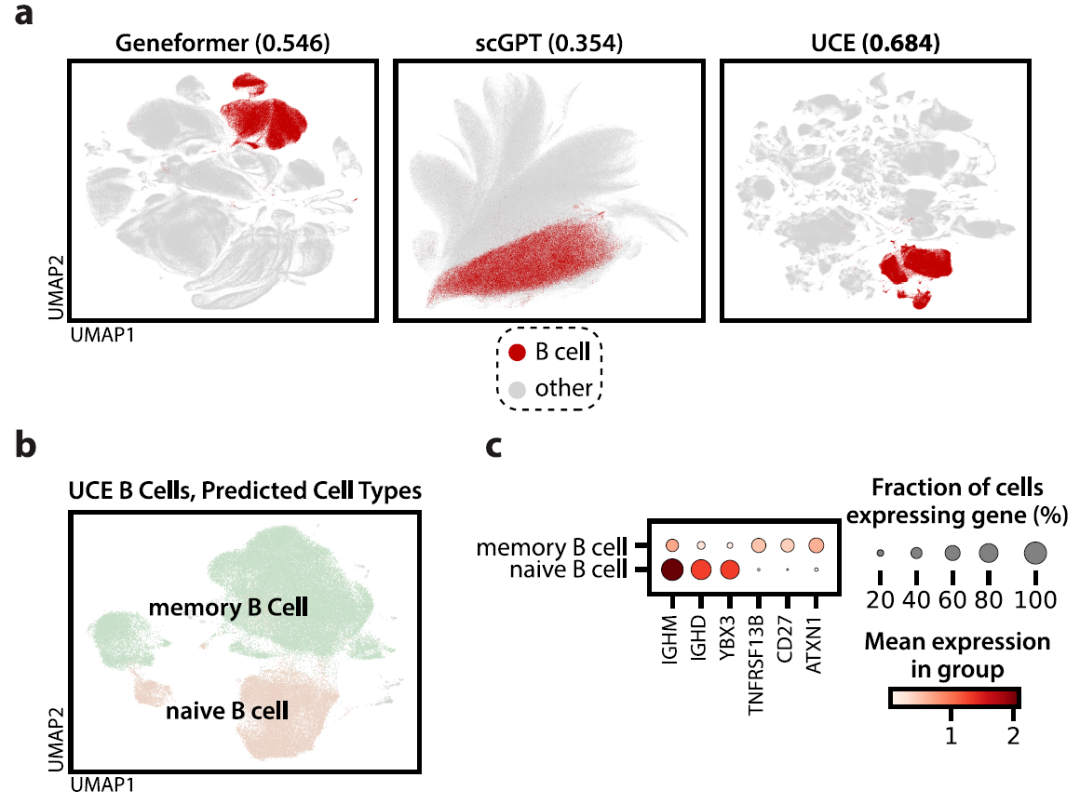
*UCE kann die B-Zell-Identität in Tabula Sapiens v2 wiedererfassen*
Zero-Shot-Einbettung neuer Spezies
Die Forscher verglichen die Leistung von UCE weiterhin mit den aktuell fortschrittlichen überwachsenen Methoden zur Kreuzspezies-Label-Transfer, SATURN und SAMap. In 3 von 4 Datensätzen übertraf UCE weiterhin SATURN und SAMap bei der Zelltyp-Label-Übertragung zwischen Mensch und neuen Spezies. UCE war sogar in der Lage, konsistente Zero-Shot-Einbettungen für stark evolutionär divergente Spezies zu erzeugen, wie beispielsweise die Fruchtfliege.
Organisationsstruktur von Zelltypen in neuen Daten
Neben den Bewertungsmetriken, die sich auf einzelne Zelltyp-Cluster konzentrieren, untersuchte das Forschungsteam auch die Struktur des universellen Einbettungsraums auf einer übergeordneten Ebene, d.h. die Analyse der relativen Positionsbeziehungen verschiedener Zellen in diesem Raum. Nachdem alle Zellen des Lungengewebes aus Tabula Sapiens v.2 eingebettet wurden, konnte eine Organisationsstruktur der Zelltypen mit klarer biologischer Bedeutung beobachtet werden (Abbildung a unten). Verschiedene Zelltypen bildeten nicht nur separate Cluster, wie z.B. T-Zellen, Monozyten und Endothelzellen, die klare Cluster bildeten, sondern auch höherrangige Zellkategorien wie Immunzellen und Epithelzellen konnten deutlich unterschieden werden.
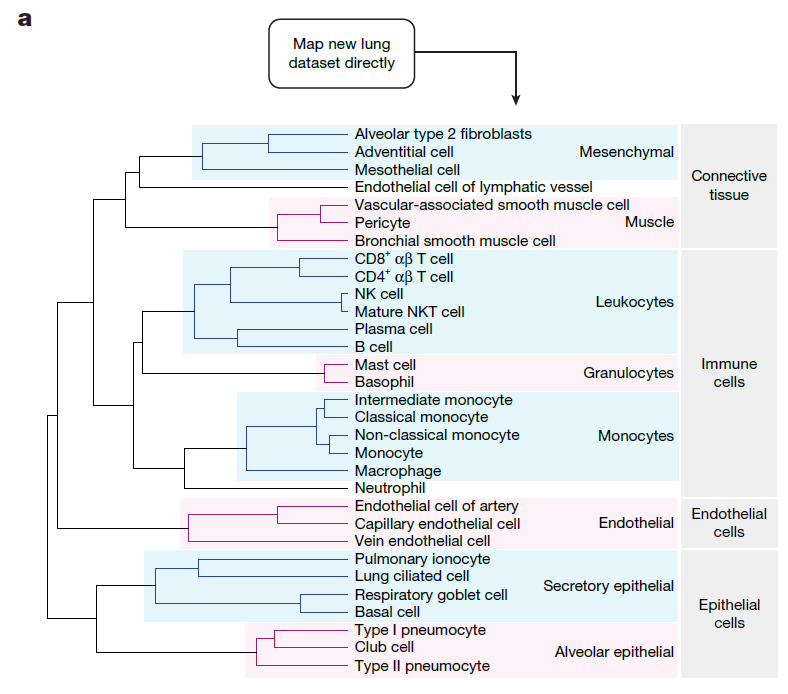
*Der UCE-Raum, der für neue, bisher nicht gesehene Daten erzeugt wurde, zeigt eine biologisch bedeutsame Organisationsstruktur der Zelltypen*
Die Forscher verglichen dieses Ergebnis weiterhin mit der auf Zellontologie basierenden Zellhierarchie. Die Ergebnisse zeigten, dass die von UCE identifizierten Zellcluster im Vergleich zu anderen Zero-Shot-Einbettungsmethoden eine höhere Ähnlichkeit mit der Cell Ontology aufwiesen.
Weitere Experimente zeigten, dass UCE in der Lage ist, effektiv eine universelle Repräsentation der Zellbiologie zu erlernen. Diese Repräsentation kann nicht nur verschiedene Zelltypen unterscheiden, sondern auch die relative Ähnlichkeit zwischen Zelltypen auf verschiedenen Skalen erfassen, was vielversprechend ist, um tiefere biologische Gesetzmäßigkeiten hinter der Zellentwicklung und -funktion aufzudecken.
Analyse von UCE zu Ergebnissen bei Lungenerkrankungen
Schließlich nutzten die Forscher UCE sowie den zuvor konstruierten Norn-Zellklassifikator, um Norn-ähnliche Zellen bei Lungenerkrankungen zu untersuchen – sie entnahmen Lungenzellen von Patienten mit idiopathischer Lungenfibrose (IPF), chronisch obstruktiver Lungenerkrankung (COPD) sowie von Kontrollpatienten und erzeugten deren Zell-Einbettungsraum. In allen drei Patientengruppen wurden Norn-ähnliche Lungenzellen identifiziert, die eine präferenzielle Expression von Norn-Markergenen zeigten (Abbildung d unten); weitere Analysen zeigten, dass diese Norn-ähnlichen Lungenzellen Expressionsunterschiede zwischen den verschiedenen Krankheitsgruppen aufwiesen (Abbildung e unten).
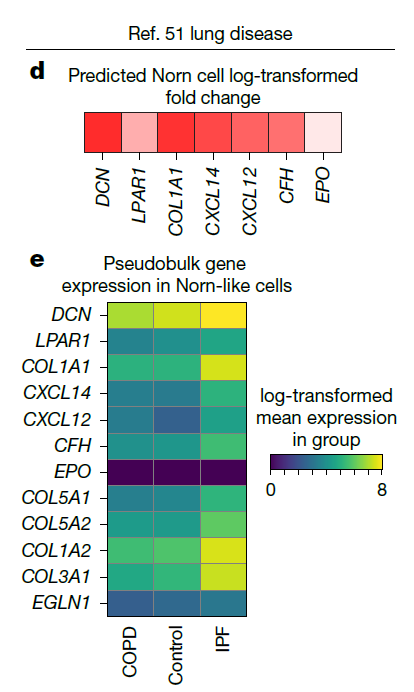
*Die Norn-Zell-Fallstudie zeigt, dass UCE weiterführende Analysen von Einzelzelldatensätzen unterstützen kann*
Sowohl COPD als auch IPF sind mit erhöhten Epo-Spiegeln im Blut verbunden, jedoch sind die Epo-Spiegel bei COPD-Patienten höher als bei IPF-Patienten. Darüber hinaus ist die sekundäre Erythrozytose bei IPF-Patienten im Vergleich zu COPD-Patienten weniger ausgeprägt oder tritt in geringerem Maße auf. Da die Studie Norn-ähnliche Zellen im Lungengewebe fand und Norn-Zellen Epo produzieren können, könnten die Unterschiede in der Prognose dieser beiden Erkrankungen mit krankheitsassoziierten Unterschieden bei Norn-ähnlichen Zellen zusammenhängen.
Insgesamt deuten diese Ergebnisse darauf hin, dass auch in anderen Geweben des Körpers Zellen mit ähnlichem Transkriptionsstatus wie Norn-Zellen gefunden werden können und dass diese Zellen möglicherweise eine bisher nicht beschriebene Rolle im Krankheitsverlauf spielen. Da UCE ein universelles Modell ist, das nicht durch Gewebe, Spezies oder Krankheitszustand eingeschränkt ist, kann es die Analyse solch groß angelegter, vielfältiger Daten erheblich erleichtern.
Fazit
Durch die Konstruktion von UCE haben die Forscher die Fähigkeiten zur Analyse von scRNA-seq-Daten weiter ausgebaut. Obwohl das Modell einen wichtigen Schritt in Richtung universeller Zelleinbettungen darstellt, gibt es dennoch einige Einschränkungen – die derzeitigen Benchmark-Tests bewerten hauptsächlich die Fähigkeit von UCE, von Experten annotierte Zelltypen wiederherzustellen, aber solche Aufgaben sind durch die Granularität und Subjektivität der vorhandenen Zelllabels begrenzt. Daher können diese Bewertungen möglicherweise nicht vollständig die Fähigkeit des Modells widerspiegeln, nuanciertere biologische Prozesse zu repräsentieren, wie z.B. die Reaktion von Zellen auf Störungen oder die Integration von Daten verschiedener Modalitäten. Darüber hinaus ist UCE, wie andere groß angelegte biologische Basismodelle, weitgehend ein Black-Box-Modell, was es schwierig macht zu erklären, warum und wie bestimmte Einbettungen entstehen. Um diese Undurchsichtigkeit zu beheben, ist die weitere Entwicklung von Interpretierbarkeitswerkzeugen erforderlich, die die vom Modell gelernten Repräsentationen mit einem Verständnis auf biologischer Mechanismenebene verbinden. Obwohl die Trainingsdaten von UCE umfangreich sind, sind sie dennoch auf Säugetierarten, insbesondere Mensch und Maus, sowie auf bestimmte Gewebe wie Gehirngewebe ausgerichtet, was Bedenken hinsichtlich der Fähigkeit des Modells zur Verallgemeinerung auf unterrepräsentierte Spezies und biologische Szenarien aufwirft.
Schließlich ist hervorzuheben, dass UCE, obwohl es die Datenausrichtung verbessern kann, indem es gemeinsame biologische Signale zwischen verschiedenen Datensätzen erfasst, es traditionelle Methoden zur Batch-Effekt-Korrektur nicht ersetzt. Für die Behandlung bekannter experimenteller Störfaktoren bleiben traditionelle Methoden weiterhin von großem Wert.
Referenzen: