Command Palette
Search for a command to run...
Nur 25 % Abtastung, Bis Zu Vierfach Höhere Bildwiederholrate: Deep Learning Revolutioniert Die Nanofluoreszenzbildgebung Lebender Zellen
Wie allgemein bekannt, sind Zellen die grundlegenden strukturellen und funktionalen Einheiten von Lebewesen. In ihnen erfüllen verschiedene hochkomplexe Organellen, das Zytoskelett und Proteinkomplexe auf der Nanometerskala ihre jeweiligen Aufgaben und treiben so die vielfältigen und komplexen Lebensvorgänge an. Bis heute weiß die Wissenschaft jedoch nur sehr wenig über die dynamischen Wechselwirkungen zwischen diesen präzisen nanostrukturierten Komponenten. Der Grund dafür ist, dass die traditionelle optische Mikroskopie durch die Abbe-Beugungsgrenze eingeschränkt ist. Dadurch bleiben viele feine Nanostrukturen im Zellinneren und ihre dynamischen Veränderungen wie in einem „unleserlichen“ Nebel gehüllt, was den Fortschritt bei der Erforschung zellulärer Substrukturen erheblich behindert.
Die Einführung der Fluoreszenz-Nanoskopie (Fluorescence nanoscopy) hat diese Barriere durchbrochen. Als eine Klasse von Fernfeld-Fluoreszenzmikroskopietechniken, die die optische Beugungsgrenze überwinden, steuert sie durch physikalische Mittel den Leuchtzustand von Fluoreszenzmolekülen und schiebt die Beobachtungsauflösung effektiv in den Nanometerbereich vor. So können Forschende die feinen Konformationen und dynamischen Veränderungen mikroskopischer Strukturen im Zellinneren direkt beobachten. Dies macht sie zu einem wichtigen Werkzeug für die Erforschung physiologischer Gesetzmäßigkeiten der Zelle, die Aufklärung pathologischer Krankheitsmechanismen und die Entschlüsselung der Geheimnisse des Lebens.
Unter den vielen technischen Ansätzen der Fluoreszenz-Nanoskopie ist die Reversible Saturable Optical Fluorescence Transitions (RESOLFT)-Nanoskopie ein sehr repräsentatives Verfahren. Sie nutzt reversibel schaltbare Fluoreszenzproteine (rsFPs) und steuert über strukturierte Lichtfelder im Raum den reversiblen Wechsel der Fluoreszenzproteine zwischen einem leuchtenden (ON-) und einem dunklen Zustand, um eine Molekül-Leuchtdichte-Sparsity zu erzeugen. Durch diese geschickte „selektive Ansteuerung“ beim Scannen werden schließlich hochauflösende Zellbilder rekonstruiert, die die Beugungsgrenze überschreiten.
Allerdings ist die RESOLFT-Nanoskopie derzeit noch nicht makellos. Auf ihrem Weg zu einer breiten Anwendung gibt es zwei Haupt-Hindernisse: Erstens weisen rsFPs selbst einen Ermüdungseffekt beim Lichtschalten auf. Wiederholte Zustandswechsel können dazu führen, dass sie ihre Fähigkeit zum reversiblen Schalten allmählich verlieren, was die Gesamtdauer der Zeitreihen-Bildgebung in lebenden Zellen direkt begrenzt. Zweitens wird die RESOLFT-Bildgebungszeit durch das Schalten der Fluoreszenzmoleküle, die Anregungszeit und die Anzahl der räumlichen Scan-Sampling-Punkte begrenzt. Je mehr Sampling-Punkte, desto länger dauert die Bildgebung. Eine unzureichende Zeitauflösung führt zudem leicht zu Bewegungsartefakten.
Um diese Herausforderungen zu bewältigen, hat ein institutsübergreifendes Forschungsteam vom Royal Institute of Technology (KTH) in Stockholm, Schweden, der Technischen Universität Dresden, Deutschland, und der Human Technopole Foundation in Mailand, Italien, Deep Learning mit der RESOLFT-Bildgebung kombiniert und zwei komplementäre rechnerische Bildgebungsstrategien entwickelt: das hierarchische DivNoising-Netzwerk (HDN) und das Fast-MoNaLISA-Framework für die Rekonstruktion bei dünner Abtastung (Sparse Sampling). Diese dienen der Wiederherstellung von Bildern mit niedrigem Signal-Rausch-Verhältnis (SNR) oder unterabgetasteten Bildern und erweitern die experimentellen Grenzen der RESOLFT-Bildgebung erheblich. Mit dem HDN-Netzwerk kann die Lichtdosis pro Einzelbild um den Faktor 10 reduziert und die Gesamtdauer der Zeitreihen-Bildgebung um bis zu den Faktor 5 verlängert werden. Mit dem Fast-MoNaLISA-Framework kann die Bildrate bei einer Abtastrate von 25 % um bis zu den Faktor 4 gesteigert werden.
Die betreffenden Ergebnisse wurden unter dem Titel „Time-lapse RESOLFT nanoscopy empowered by deep learning“ in Nature Communications veröffentlicht.
Forschungshöhepunkte:
- Auf Basis des hierarchischen DivNoising-Netzwerks HDN/HDNsup können RESOLFT-Bilder mit niedrigem SNR bei einer um den Faktor 10 reduzierten Lichtdosis rekonstruiert werden, was Zeitreihen-Nanobildgebung an lebenden Zellen über einen bis zu 5-mal längeren Zeitraum ermöglicht.
- Entwicklung des Fast-MoNaLISA-Zeitreihen-Upsampling-Modells zur superauflösenden Rekonstruktion unterabgetaster Bilder, was eine bis zu 4-fache Beschleunigung der Bildgebung und eine Reduktion von Scan-Artefakten ermöglicht.
- Aufbau multipler Datensätze zur umfassenden Validierung der Modelle, wodurch Nanobeobachtungen dynamischer Prozesse in lebenden Zellen wie mitochondrialer Vesikel und des Aktin-Netzwerks ermöglicht werden.
Link zur Publikation:
https://www.nature.com/articles/s41467-026-78580-z
Design von Multi-Source-Datensätzen für Training und unabhängige Bewertung
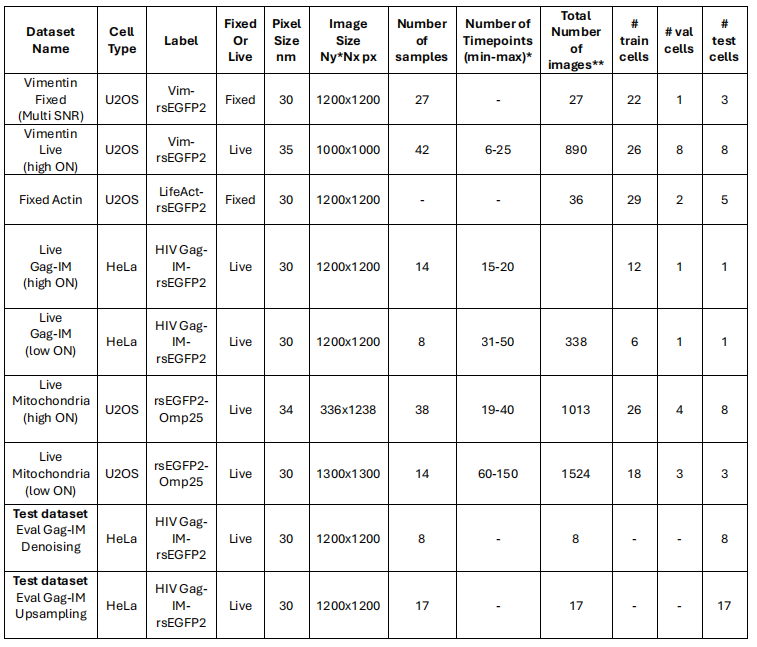
Diese Studie nutzte mehrere RESOLFT-Datensätze mit unterschiedlichen Zwecken, darunter gepaarte Datensätze (Paired datasets), ungepaarte Datensätze (Unpaired datasets) und unabhängige Datensätze (Independent datasets). Im Einzelnen:
Gepaarte Datensätze
Um einen Datensatz aus gepaarten sauberen und verrauschten Bildern zu erhalten, wurden die Zellen fixiert, um strukturelle Verschiebungen zwischen den Bildpaaren zu vermeiden. Die Fixierung schränkt die Anzahl der rsFP-Zyklen ein, was bedeutet, dass die Photobleichung schneller erfolgt als in lebenden Zellen, dennoch können hochwertige RESOLFT-Bilder erhalten werden.
Für den fixierten Vimentin-Datensatz (Fixed vimentin dataset) U2OS Vim-rsEGFP2 sammelten die Forschenden zunächst verrauschte Bilder bei einer ON-Switching-Rate von etwa 10–20 % (ca. 30 W/cm²). Anschließend wurden 5 Bilder bei einer ON-Switching-Rate von etwa 80–90 % (ca. 300 W/cm²) aufgenommen. Dieses Pseudo-Zeitreihensignal fällt schnell ab. Die Forschenden nutzten den Signalabfallprozess, um HDN, HDNsup und die Ergebnisse der Upsampling-Vorhersage bei verschiedenen SNR-Niveaus zu bewerten. Der Durchschnitt der ersten 3 Bilder der Pseudo-Zeitreihe wurde als optimaler Ground-Truth-Referenzwert verwendet.
Für den fixierten Aktin-Netzwerk-Datensatz (Fixed actin meshwork dataset) U2OS LifeAct-rsEGFP2 wurde das gleiche Verfahren angewandt. Allerdings wurde das erste Bild bei einer ON-Switching-Rate von etwa 50 % aufgenommen; anschließend wurden 5 Bilder bei einer ON-Switching-Rate von etwa 90 % gesammelt und durch Mittelbildung ein hochwertiges Ground-Truth-Referenzbild zur Schulung des HDNsup-Modells erstellt.
Unpaarige Datensätze
Unpaarige Datensätze werden hauptsächlich für das unüberwachte Denoising und Upsampling-Training verwendet.
Für das unüberwachte HDN-Denoising von Mitochondrien und HIV Gag-IM-Partikeln verwendeten die Forscher Zeitreihen mit kurzer ON-Switching-Dauer und trainierten HDN direkt auf diesen Zeitreihen mit niedrigem Signal-zu-Rausch-Verhältnis (SNR). Da einzelne Zeitreihen eine große Anzahl an Zeitpunkten enthalten, können bereits wenige Zellen ausreichend verrauschte Bilder bereitstellen.
Für den Upsampling-Trainingsdatensatz wurden konventionelle RESOLFT-Zeitreihen (mit 10–40 Frames) erfasst, deren Dauer so angepasst wurde, dass das gesamte SNR der Serie für jede Zelle und Struktur ausreichend war.
Unabhängige Testdatensätze
Für HIV Gag-IM-Partikel wurden zusätzlich zwei Testsets erfasst: ein Denoising-Evaluierungsset (mit Bildern, die unter drei Bedingungen aufgenommen wurden: kurze ON-Switching-Dauer, lange ON-Switching-Dauer und verstärkte Konfokalmikroskopie) und ein Upsampling-Evaluierungsset (mit Bildern, die nur unter zwei Bedingungen aufgenommen wurden: lange ON-Switching-Dauer und verstärkte Konfokalmikroskopie). Bemerkenswert ist, dass diese Datensätze alle an lebenden Zellen aufgenommen wurden und daher Einflüsse durch Zellbewegungen aufweisen.
Jeder Datensatz wurde zufällig in Trainings-, Validierungs- und Testsets aufgeteilt. Die Bildgrößen umfassten 64 × 64, 96 × 96 und 128 × 128 Pixel; Blöcke mit unzureichender Informationsdichte wurden verworfen. Die spezifischen Datensätze sind in der folgenden Abbildung dargestellt:
Aufteilung der zentralen Herausforderungen: Fokus auf Bild-Denoising und Rekonstruktion dünn gesampelter Daten
Diese Studie konzentriert sich auf die RESOLFT-Technologie, wobei als Basisansatz die MoNaLISA-Implementierung verwendet wird – eine derzeit state-of-the-art parallelisierte RESOLFT-Bildgebungstechnik. MoNaLISA integriert multimodale Muster für ON-Switching und Auslese sowie überlagerte periodische Linienmuster für OFF-Switching. Dies ermöglicht die Bildgebung lebender Zellen mit einer räumlichen Auflösung von 45–60 nm in einem Sichtfeld (FOV) von etwa 40 × 40 µm² bei einer Bildrate von etwa 0,5 Hz.
Auf dieser Grundlage schlugen die Forscher vor, Deep-Learning-Methoden zur Wiederherstellung von Bildern mit niedrigem SNR oder unzureichender Abtastung einzusetzen, um die Grenzen herkömmlicher RESOLFT-Verfahren zu überwinden. Die Logik dahinter ist einfach: Durch Bild-Denoising wird die für die Bildgebung erforderliche Lichtdosis reduziert und die Photobleichung verringert; zudem wird ein computergestützter Rahmen zur Rekonstruktion dünn gesampelter Daten aufgebaut, um durch rechnerisches Upsampling die zeitliche Auflösung zu verbessern.
Genauer gesagt bestimmt die Intensität des ON-Switching-Lichts die Anzahl der aktivierten rsFPs und steuert somit die Stärke des erfassten Signals. Herkömmliche Ansätze aktivieren typischerweise 80–90 % der rsFPs, um das SNR zu maximieren; diese Studie schlägt hingegen eine umgekehrte Strategie vor, bei der nur 10–20 % der rsFPs aktiviert werden, um Bilder mit niedrigem SNR zu erhalten, die anschließend durch Deep-Learning-Denoising zu hochwertigen Bildern rekonstruiert werden. Dies minimiert nicht nur die Photobleichung, sondern mildert auch die Phototoxizität, die durch die kurze Wellenlänge (typischerweise 405 nm) des ON-Switching-Lichts verursacht wird.
Auf dieser Grundlage schlugen die Forscher vor, den unüberwachten Bild-Denoising-Algorithmus HDN einzusetzen. Diese Methode basiert auf einer hierarchischen variationalen Autoencoder-Netzwerkstruktur (LVAE) und integriert gleichzeitig ein experimentell bestimmtes Rauschmodell. Darüber hinaus stellt die Studie eine überwachte Variante von HDN, HDNsup, vor, die im selben Rahmen für überwachtes Training angepasst wurde. Das Team schlug sowohl eine unüberwachte als auch eine überwachte Version vor, um überwachtes Lernen nutzen zu können, wenn hochwertige Ground-Truth-Daten (GT) vorliegen, und gleichzeitig die stabile Anwendbarkeit des unüberwachten Modus zu gewährleisten, wenn keine Ground-Truth-Daten verfügbar sind. Gleichzeitig muss die ideale Strategie eine effektive Rauschunterdrückung ohne Verlust der räumlichen Auflösung bieten.
Im HDN dient das Backbone-Netzwerk LVAE dazu, hierarchische Vorwissen über die Struktur biologischer Bilddaten zu lernen, wobei Merkmale auf mehreren Ebenen – von groben Konturen bis hin zu feinen Texturen – gleichzeitig erfasst werden. Noch wichtiger ist, dass es sich bei diesem Modell um einen multimodalen Prior handelt, der keine eindeutige Lösung ausgibt; das experimentelle Rauschmodell ist der Kern des unüberwachten Trainings von HDN, da es die bedingte Wahrscheinlichkeit des tatsächlichen sauberen Signals hinter den verrauschten Beobachtungen des Bildgebungssystems beschreibt. Darüber hinaus lässt sich dieser Rahmen leicht für überwachtes Training anpassen, sodass HDN bekannte saubere Ground-Truth-Informationen nutzen kann, während die beiden wesentlichen Eigenschaften von HDN – die multimodale Darstellung und die einstellbare Vielfalt der Ausgabe – erhalten bleiben.
Der zweite Ansatz der Studie besteht darin, einen Rahmen zur Wiederherstellung dünn gesampelter Bilder zu entwickeln, mit dem Ziel, die Visualisierung schneller dynamischer Prozesse in lebenden Zellen zu ermöglichen. Konkret hängt die Erfassungszeit von der Anzahl der Scan-Schritte ab. Durch die Kombination von dünnem Sampling mit Bildrekonstruktionstechniken lässt sich die Bildgebungsgeschwindigkeit erheblich steigern, während die Bildqualität erhalten bleibt. Die optimale Sampling-Schrittweite wird typischerweise gemäß dem Nyquist-Shannon-Abtasttheorem bestimmt, um Aliasing-Artefakte oder redundante Informationen zu vermeiden; die Schrittweite entspricht dem Doppelten der Grenzfrequenz des Systems und ist etwa halb so groß wie die erwartete Auflösung. Bei der RESOLFT-Bildgebung beträgt die Schrittweite etwa 20–30 nm.
Auf dieser Grundlage schlugen die Forscher Fast MoNaLISA vor. Diese Methode verkürzt die Erfassungszeit pro Bildrahmen, indem einige Scan-Schritte übersprungen werden, und nutzt anschließend ein Upsampling-Netzwerk zur Wiederherstellung der unterabgetasteten Bilder. Der Vorteil ist erheblich: Bei gleicher Lichtdosis lässt sich die zeitliche Auflösung verbessern. Dieser Ansatz wurde previously in der Beugungslimitierten Konfokalmikroskopie eingesetzt, aber noch nicht in der nanoskaligen Super-Resolution-Bildgebung unterhalb von 100 nm validiert. Ein weiteres zentrales technisches Detail dieser Studie besteht darin, dass die Sampling-Dichte reduziert wird, während die Lichtdosis für das OFF-Switching konstant bleibt, sodass die ursprüngliche Bildauflösung im Sample erhalten bleibt.
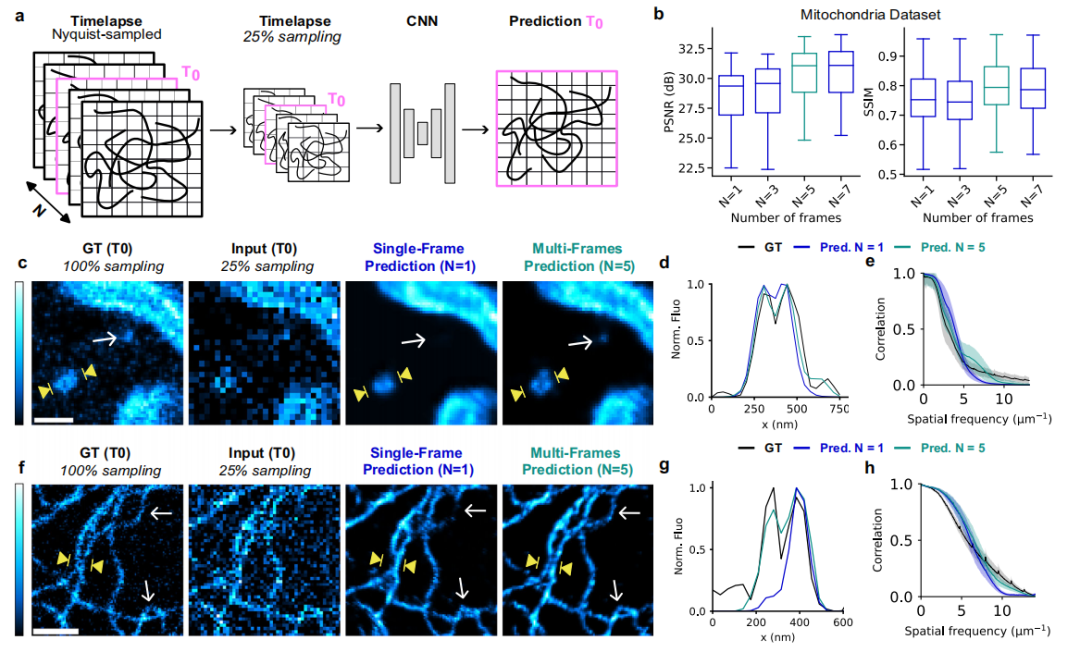
Fast MoNaLISA implementiert zwei Trainingsparadigmen: das Einzelbild-Training und das Mehrbild-Training. Das Einzelbild-Training zielt auf die Upsampling-Rekonstruktion statischer Szenen ab, wobei dem Netzwerk Daten eines einzelnen Zeitpunkts bereitgestellt werden. Das Mehrbild-Training ist eine Verbesserung des Einzelbild-Trainingsverfahrens und zielt darauf ab, schnelle dynamische Prozesse intrazellulärer Moleküle und Organellen abzubilden. Bei dieser Methode verwenden die Forscher unterabgetastete Zeitreihenbilder als Eingabe anstelle einzelner Momentaufnahmen. Für jeden Zeitpunkt werden unterabgetastete Bilder generiert, indem der gleiche zufällige Downsampling-Schritt wie beim Einzelbild-Training angewendet wird. Anschließend wird das Netzwerk darauf trainiert, die mittleren Zeitpunkte der Zeitreihe vorherzusagen. Dabei kann es zusätzlich Informationen aus dem zeitlichen Kontext der Eingabebilder nutzen, was die Rekonstruktionsgenauigkeit verbessert.
Hinsichtlich der Netzwerkarchitektur ist die Grundstruktur der Fast MoNaLISA Upsampling-Rekonstruktion UNet-RCAN, wobei die letzte Upsampling-Schicht des ursprünglichen RCAN beibehalten und nicht entfernt wird. Die Wahl dieses Netzwerks ist einfach begründet: RCAN wurde speziell für Bild-Upsampling-Aufgaben entwickelt und eignet sich daher nativ für die Wiederherstellung unterabgetasteter Bilder in dieser Studie. Darüber hinaus wurde im Hinblick auf die Architektur-Entscheidungen der U-Net-Hauptteil beibehalten, um eine schnellere Konvergenz des Modells zu unterstützen.
10-fach weniger Licht, 5-fach längere Zeitraffer, 4-fach höhere Geschwindigkeit
Die Studie bewertete zunächst die Rekonstruktionsfähigkeit von HDN bei Bildern mit geringer ON-Schaltaktivität. Experimentell wurden die unüberwachten Methoden Noise2Void (N2V) und Self-Inspired Noise2Noise (SN2N) sowie die überwachten Methoden Content-Aware Image Restoration (CARE) und UNet-RCAN ausgewählt, um HDN gegen diese zu validieren.
Die Ergebnisse zeigen, dass die durchschnittliche Halbwertsbreite (Full Width at Half-Maximum, FWHM) des Ground Truth (GT) bei 58 nm liegt. Sowohl HDN als auch HDNsup können die räumliche Auflösung aufrechterhalten, mit durchschnittlichen FWHM-Werten von 56 nm bzw. 54 nm. Im Vergleich dazu betrug die durchschnittliche FWHM der unüberwachten Methode SN2N 120 nm und die von N2V 93 nm. Die überwachten Methoden schnitten relativ besser ab, wobei CARE 73 nm und UNet-RCAN 70 nm erzielten. Da sie jedoch dazu neigen, Zellstrukturen zu glätten, gehen Detailinformationen verloren, was dazu führt, dass die durchschnittliche FWHM über dem Wert des Ground Truth liegt und die Fourier-Ring-Korrelationskurve (FRC) bei niedrigen Frequenzen abfällt. Wie im folgenden Diagramm dargestellt:
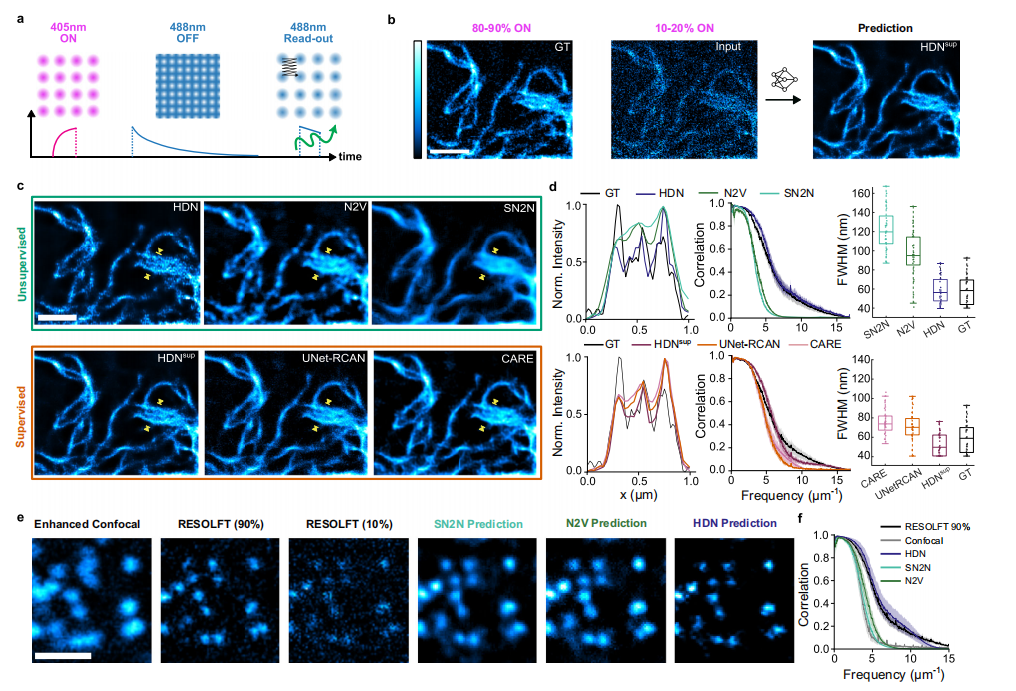
Es ist jedoch erwähnenswert, dass die begrenzte Leistungsfähigkeit der überwachten Rauschunterdrückungsmethoden nicht an der Netzwerkarchitektur selbst liegt, sondern an der mangelnden Qualität des Ground Truth. Daher ist die Leistung von HDNsup, obwohl sie exzellent ist, wie bei anderen überwachten Lernverfahren auch, weiterhin stark von der Qualität des Ground Truth abhängig.
Anschließend validierten die Forscher die Wirksamkeit der HDN-Rauschunterdrückungsmethode an dichteren Punktstrukturen. Die Ergebnisse zeigten, dass HDN solche Punktstrukturen genau rekonstruieren und superauflösende Details erhalten kann, die in der verstärkten konfokalen Bildgebung nicht beobachtbar sind. Dies ist anderen unüberwachten Rauschunterdrückungsmethoden nicht möglich, und die FRC bestätigt diese Schlussfolgerung. Natürlich nimmt die Vorhersagegenauigkeit bei extrem niedrigem Signal-Rausch-Verhältnis ab, daher müssen das Niveau der ON-Schaltaktivität sorgfältig gewählt und validiert werden, um die Zuverlässigkeit der Vorhersagen zu gewährleisten. Bei HIV Gag-IM-rsEGFP2 treten bei einem Anteil aktivierter Leuchtzustände von 5 % deutliche Rekonstruktionsartefakte auf, während 10 % als zuverlässiger Arbeitsgrenzwert gelten.
Bei der Validierung der Fähigkeit des Verfahrens, Langzeit-Zeitraffer-Bildgebung von lebenden Zellen durchzuführen, führte der Umstand, dass die verwendete UV-Vis-Energie nur etwa 1/10 der ursprünglichen Menge betrug, dazu, dass die Zeitraffer-Bildgebungszeit im Vergleich zur herkömmlichen RESOLFT-Methode mit hoher ON-Schaltaktivität um bis zu etwa das 5-fache verlängert wurde. Wie im folgenden Diagramm dargestellt. Es ist zu beachten, dass alle Experimente bei endogenen Expressionsniveaus des Vimentin-Moleküls durchgeführt wurden. Bei helleren Proben, wie der mitochondrialen Außenmembran mit rsEGFP2, wurde auf die unüberwachte HDN-Methode umgeschaltet, was eine Zeitraffer-Bildgebung von über 100 Bildern ermöglichte.
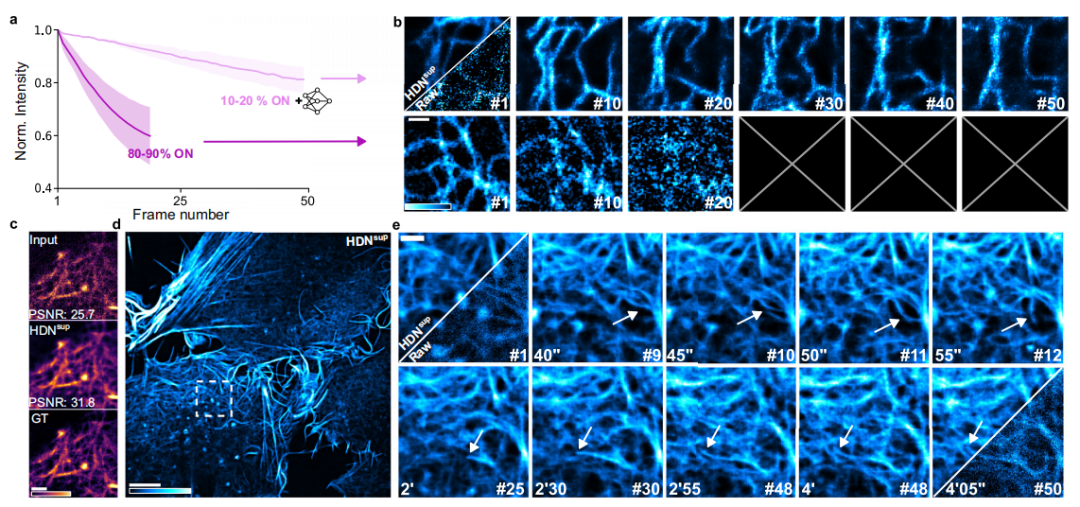
Die Forscher setzten HDNsup weiterhin für Bildgebungsexperimente an komplexen, ineinandergreifenden Strukturen wie dem Aktin-Retikulum ein. Durch die Erfassung hochwertiger Daten von fixierten Zellen, die LifeAct-rsEGFP2 exprimieren, wurde zunächst die präzise Rekonstruktion des Aktin-Retikulums validiert, bevor die Methode auf die Bildgebung lebender Zellen übertragen wurde. Die Ergebnisse zeigten, dass HDNsup erfolgreich mindestens 50 aufeinanderfolgende Bilder aufnehmen konnte, was eine Langzeitbeobachtung der dynamischen Prozesse des Aktin-Retikulums ermöglichte.
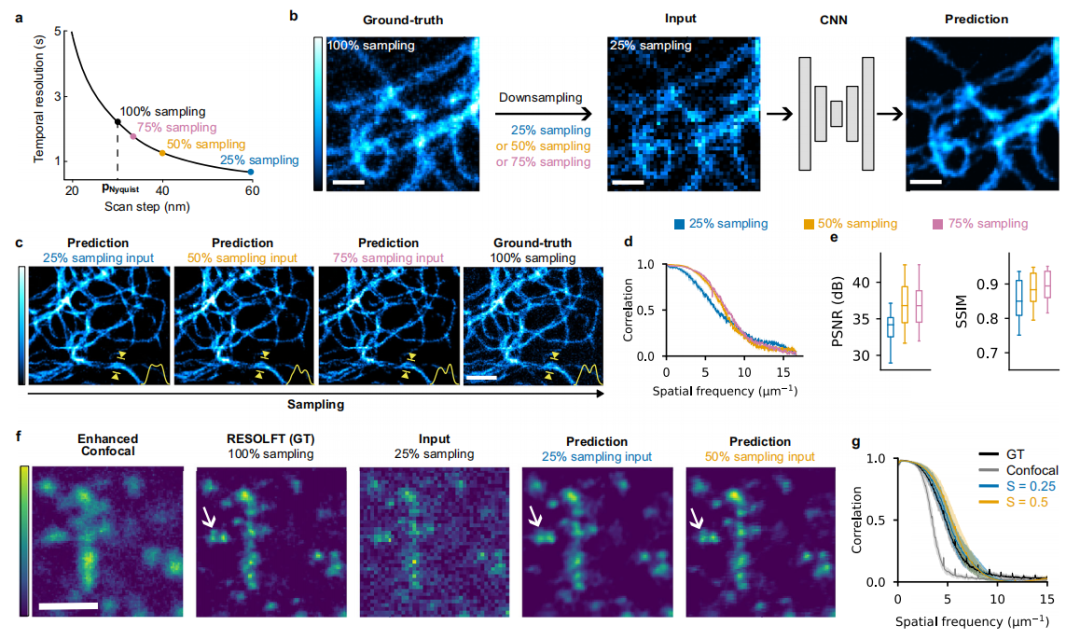
Bei der Bewertung des Einzelbild- und Mehrbild-Trainings untersuchte die Studie drei Abtastraten: 75 %, 50 % und 25 %, die einer Steigerung der Bildrate um das 1,3-fache, 2-fache bzw. 4-fache entsprechen.
Die Ergebnisse des Einzelbild-Trainings zeigen, dass Fast MoNaLISA bei Bildern mit hohem Signal-Rausch-Verhältnis die besten Ergebnisse erzielt. Daher sollte das übliche Niveau der ON-Schaltaktivität, d. h. 80–100 %, verwendet werden. Dies steht im Einklang mit dem Gesamtziel der Reduzierung der Lichtdosis, da das Unterabtasten diese Dosis bereits senkt. Zweitens spiegelt die Wahl der Abtastrate den Kompromiss zwischen Bildgeschwindigkeit und Vorhersagezuverlässigkeit wider. Eine Abtastrate von 50 % beim Einzelbild-Training stellt den robustesten Kompromiss zwischen Geschwindigkeit und Genauigkeit dar. Wie im folgenden Diagramm dargestellt:
Die Ergebnisse des Trainings mit Mehrfachbildern zeigen, dass Fast MoNaLISA Bilder auch unter Hochgeschwindigkeitsabbildungsbedingungen mit nur 25 % der Pixeldaten präzise rekonstruieren kann und damit die bisherigen Grenzen des Trainings mit Einzelbildern überwindet. Wie in der folgenden Abbildung dargestellt:
Abschließende Bemerkungen
Zusammenfassend hat diese Studie einen hybriden Ansatz entwickelt, der experimentelle Bildgebung mit computergestützter Rekonstruktion kombiniert. Basierend auf der parallelen RESOLFT-Technologie ermöglicht sie langzeitliche dynamische Beobachtungen ganzer lebender Zellen mit einer räumlichen Auflösung von etwa 60 Nanometern. Sie erfasst feine Strukturen wie das Zytoskelett und mitochondriale Vesikel und verfolgt schwache Signale sowie schnell bewegende Moleküle, die zuvor nur in statischen Aufnahmen erfasst werden konnten. Im Vergleich zu gängigen Techniken der hochauflösenden Bildgebung lebender Zellen wie SIM, SOFI und STED erreicht diese Methode eine seltene Balance zwischen einer Auflösung unter 70 Nanometern, Abbildungsgeschwindigkeit, Sichtfeldgröße und Lichtschädigung.
Besonders hervorzuheben ist, dass das Team das Software-Framework LISAI inzwischen als Open Source bereitgestellt hat. Die zugehörigen Algorithmen können zudem auf andere Scanning-Mikroskopie-Systeme wie STED oder Scheibenrotations-Konfokalmikroskope übertragen werden. Natürlich bringt die rekonstruktive Bildverarbeitung mittels Deep Learning Kompromisse bei der Parametereinstellung mit sich, die an das Signal-Rausch-Verhältnis der jeweiligen Probe angepasst werden müssen. In Zukunft könnte das Modell weiter optimiert werden, um ein integriertes Framework zu schaffen, das sowohl die Lichtdosis während der Bildgebung als auch die Erfassungszeit gleichzeitig reduziert.