Command Palette
Search for a command to run...
Generierung Von 800 Millionen Vorhergesagten Massenspektren Für Über 100 Millionen Kleine Moleküle: Cornell-Universität Stellt AIMe Vor, Das Chemische Regeln, Fragmentierungswege Und Neuronale Netzwerke Kombiniert
In der Metabolomik kann die Massenspektrometrie aus komplexen biologischen Proben eine Vielzahl von Signalen kleiner Moleküle erfassen, aber das Detektieren dieser Signale ist nur der erste Schritt; schwierig ist es tatsächlich zu bestimmen, welchen Molekülen sie entsprechen. Derzeit deckt die für den Vergleich verfügbaren experimentellen Referenzspektrenbibliotheken weniger als 1 % der bekannten Verbindungen ab, sodass bei typisch komplexen biologischen Proben mehr als 80 % des Metaboliten nicht identifiziert werden können. Gleichzeitig ist der Strukturraum kleiner Moleküle weitaus komplizierter als derjenige von DNA und Proteinen. Dasselbe Summenformel kann vielen verschiedenen Strukturen zugeordnet sein, so dass allein durch ständige Erweiterung von Standardsubstanzen und Referenzspektrenbibliotheken kaum ein ausreichender Abdeckungsgrad dieses enorm großen chemischen Raumes erreicht wird.
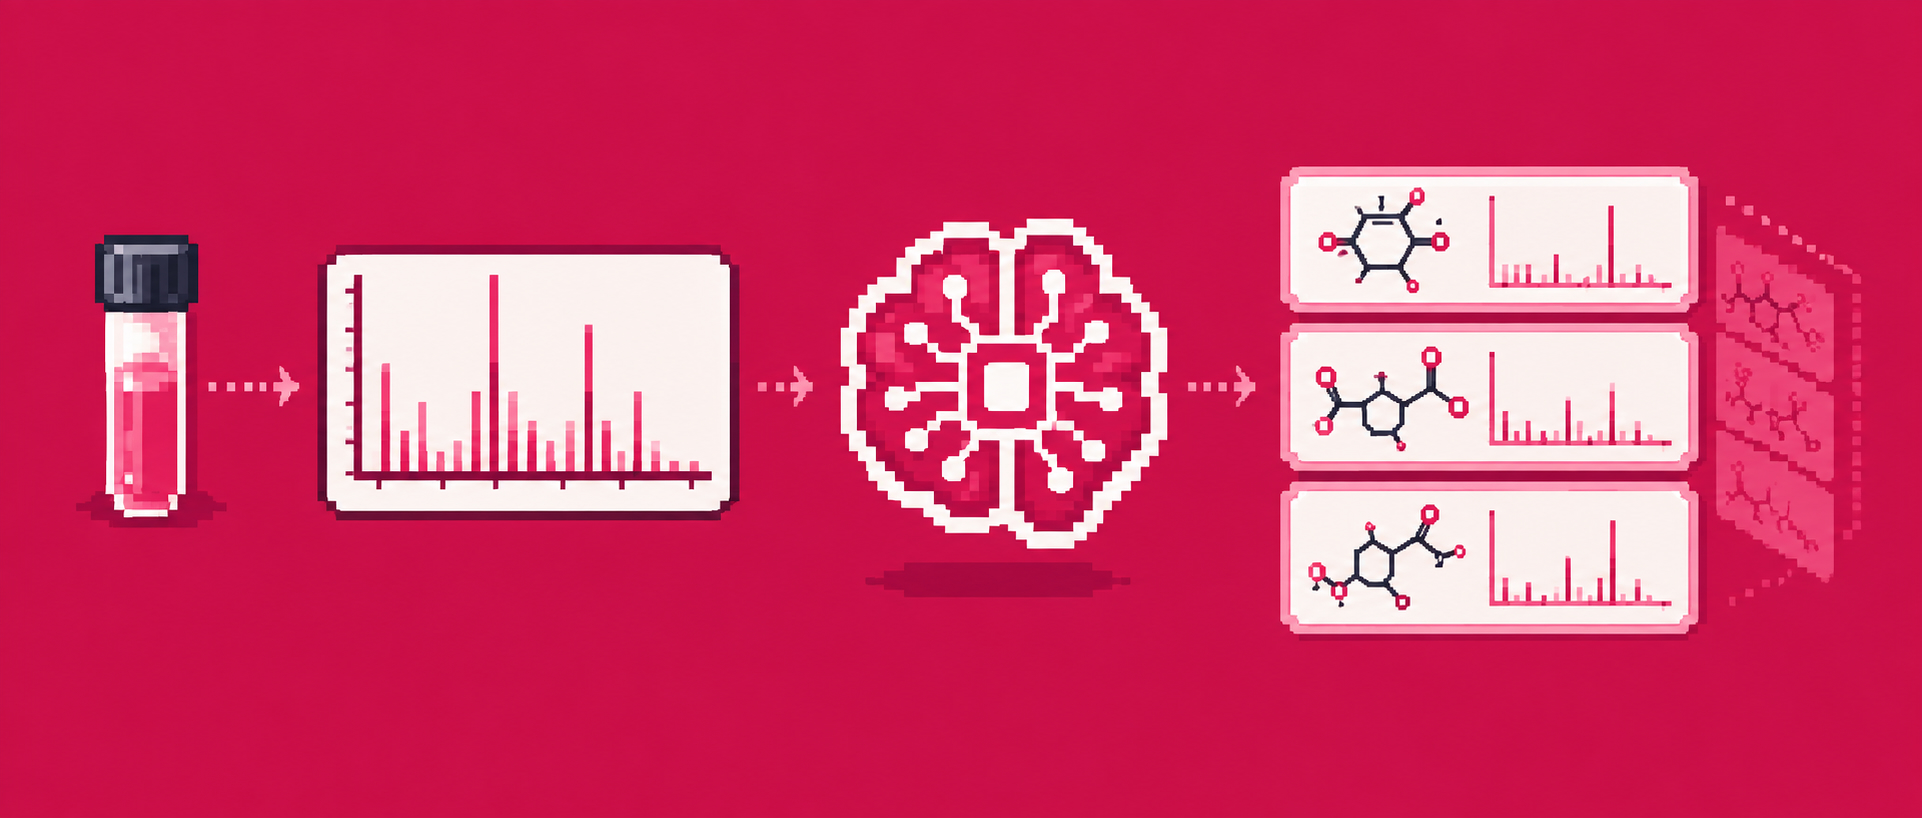
Um diesem Problem entgegenzuwirken, hat ein Forscherteam der Cornell University KI-Molecule-Explorer (AIMe) entwickelt – einen Multi-Agenten-neurosymbiotischen KI-Rahmen zur Analyse kleinmolekularer Massenspektren. Das Kernmodell DeepMS²Reasoner kombiniert chemische Regeln, Schlussfolgerung über Fragmentierungswege mit dem Lernen neuronaler Netze, um ausgehend von der Molekülstruktur Fragmentsprozesse wie Bindungsbrüche oder Wasserstoffverschiebungen nachzubilden und daraus resultierende MS²-Spektren vorherzusagen. AIMe ermöglicht damit den Ausstieg aus herkömmlichen „experimentellem Massenspektrum–Referenzspektren“-Direktabgleichen und platziert unbekannte Spektren im größeren Raum möglicher Molekülstrukturen auf Suche nach passenden Kandidaten.
Zur Erweiterung dieser Fähigkeiten hin zum bereits bekannten kleinen molekularen Raum baute das Forschungsteam zudem MS²KOSMOS auf, das für mehr als 100 Millionen kleine Moleküle in PubChem insgesamt über 800 Millionen prädiktive MS²-Spektre generierte, wodurch der Suchraum der Massenspektren gegenüber bestehenden experimentellen Bibliotheken etwa drei Größenordnungen vergrößert wurde. Für jedes unbekannte Spekter liefert AIMe neben potenziell relevanten Molekülen auch deren entsprechende Bruchpfade sowie konkrete Zuordnung spezifischer Peaks zu möglichen fragmentierten Summenformeln und Strukturelementen. Die Autoren validierten diese Fähigkeit mittels Daten aus Maus-Darmmikrobiota-bezogenen Metaboliten sowie großer öffentlicher Massenfragmentdatensätze (GNPS).
Die entsprechenden Ergebnisse wurden unter dem Titel „Charting the small-molecule universe from mass spectra with neuro-symbolic AI“ im Preprint-Server bioRxiv veröffentlicht.
Zum Originalartikel:
https://www.biorxiv.org/content/10.64898/2026.08.05.743095v1
Vom experimentellen Massenspektrum bis zum Universum hundertmillionenfacher kleiner Moleküle
Die von AIMe verwendeten Daten erfüllen vorrangig drei Aufgaben: Training eines Modells zur Vorhersage von Massenspektren, Aufbau einer durchsuchbaren Sammlung an Kleinmolekülräumen sowie Überprüfung seiner Leistungsfähigkeit anhand realer Probenproben.
Das Trainingsdatum stammt vom NIST 2020 Tandemmassenspektrometerdatenbank. Es behielt sowohl protonierte ([M+H]+)-als auch deprotionierte([M-H]-)-Spektren bei, entfernte metallhaltige Substanzen sowie unvollständig strukturell beschriebene Muster und normalisierten Peakpositionierungen zusammengefasst. Aufgeteilt gemäß vollständiger InChIKeys ergaben sich 80 Prozent Trainingssatz, zehn Prozent Validierungssatz und weitere zehn Prozent Testsampleset. Um redundante Einflüsse aufgrund ähnlicher Strukturen einzudämmten, schloss man beim abschließenden Test jene Fälle aus, wo Morgan-Fingerprints zwischen Trainigs-undTestobjekten exakt identisch(Tanimoto-Koeffizient=1,0) waren.
Externe Generalisierungstests erfolgten unabhängig davon basierend auf zwei separaten Datensätzen namens CASMI 2022sowieMassSpecGym,die keinesfalls währenddesTrainingsverwendetsind.DasStruktursuchen selbst war noch anspruchsvoller gestaltet:jeglicheProbe enthieltnebstdemwahrenObjektauchbiszu49ähnlichgewichtetePubchem-EinträgealsStörfaktoren.ZudemwurdefürCASMIeinnochstrengererIsomerietestkonzipiert,wobeiallePubchemisomerenmitderselbenSummenformelinBetrachtgezogengewordenwaren,insgesamtfast2,5MillionenKandidatendiesart.
NachAbschlussdiesesSchrittswarderForschungsbereichnunweitgehendaufbekanntekleineorganischeVerbindungeninnerhalbvonPubChemausgedehnt.Fürüber105MillionenOrganikaunterhalbvonm/z1000hatteAIMejeweilspositivenegativeIonisationsmodi sowieweiervierKollisionsenergienMS²-Vorhersagengeneriert,somitinsgesamtüber800MillionenvoraussichtlicherSpektrezugesammelteinesystematischstrukturiertesMS²KOSMOSSystemfürzukünftigesSuchverfahrenschaffendargestellt.
FürpraxisrelevanteAnwendungenstandenzwoudatasetzurVerfügung.EinerseitshandelteessichhierbeiumeineUntersuchungderFaecesmetabolitkomponentengegenübersteriler(GF-)undspezifischfreier(SP-)Maussysteme,mittelswelcherman111relativhäufigauftretendeSignalausgewählt hatte,dienochimmerdurchherkömmlicheStandardreferenzenoderpublizierteDatenbankennichtdirektidentifizierbarblieben.AndererseitsgriffmandarauföffentlichzugänglichesGNPS-Datenmaterial zurück,nachFilternkraftLadungsverhältnissenundMasseberechnungenlandetenletztendlich7.144.480konsistenteFragmentationsprofileimRahmengroßräumigerAbgleichsprozesse.
Wie Modelle lernen,Moleküle„zerfallen"zulassen
**AIMebestehtauseinandergreifendenModulen:**DeepMS²ReasonerstelltprimärVorhersagemöglichkeitenhinsichtlichMS²-ProfilenundBruchmechanismenauszustandsbeschreibendemStartpunkt.MS²KOSMOSGeneratornutzdieseKapazitäten,zumBeispielumgroßeSammlungenchemischerBausteinvorausberechnetzulassensowiedurchsuchbareVersionendesentsprechendenArchivs(MS²KOSMOS)anzulegen.SchließlichnimmtMS²KOSMOSMappeAufgabederEvaluierungunbekannterLaborwertevor indemerdortnachÜbereinstimmungenforscht.VorbereitetedetaillierteRechenoperationenkannanschliessendauffiltertkandidatischeEinzelheitenangewendetwerden.
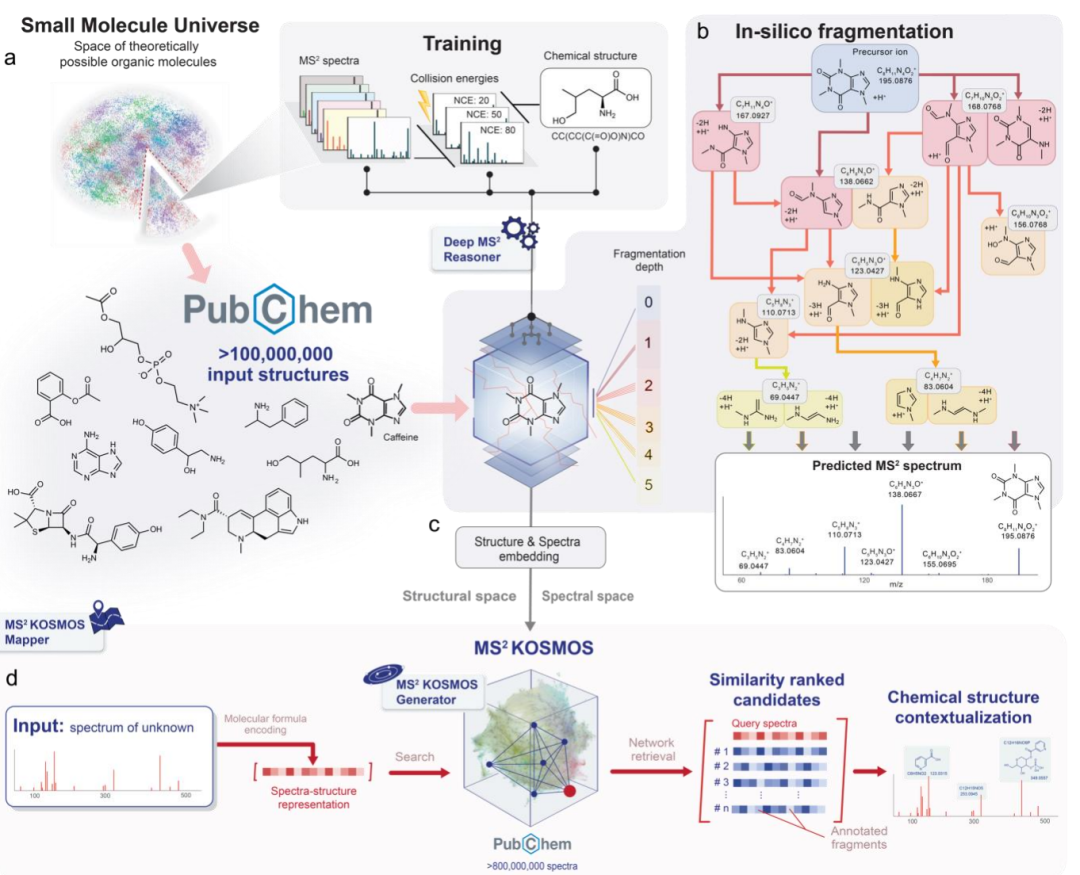
Wobei DeepMS²Reasoner die Fähigkeit zur Vorhersage von Massenspektren des gesamten Systems bestimmt. Es lernt nicht direkt „welche Peaks zu einem Molekül gehören und wie stark sie sind“, sondern simuliert schrittweise den Fragmentierungsprozess ausgehend vom Precursor-Molekül und baut dynamisch einen gerichteten azyklischen Graphen (Directed Acyclic Graph, DAG) auf. Die Knoten im Diagramm repräsentieren verschiedene Fragmente, während die Kanten spezifische Fragmentierungsaktionen darstellen. Das Modell berücksichtigt drei Mechanismen: lineare Bindungsbrüche, Ringbindungsbrüche und Eliminierungen; es zeichnet zudem Ladungsänderungen und Wasserstoffverschiebungen nach und beschränkt die Fragmentierungstiefe nicht vorab, sodass komplexe Fragmente dargestellt werden können, deren Bildung mehrstufige Bindungsbrüche, Ringöffnungen oder Umlagerungen erfordert.
Die Auswahl der Fragmentierungspfade obliegt dem neuronalen Netzkomponenten ALEA (Action Likelihood Estimator Advisor). ALEA nutzt eine Graphormer-Architektur, um basierend auf Atomen, chemischen Bindungen, Ringsystemen und Hydrogenzuständen des aktuellenragments sowie experimentellen Bedingungen wie Stoßenergie, Instrumententyp und Adduktionen Wahrscheinlichkeiten für unterschiedliche Fragmentierungsaktionen und das „Stoppen der Fragmentierung“ zuzuweisen. DeepMS²Reasoner propagiert diese Wahrscheinlichkeiten entlang der Fragmentierungspfade, wobei die kumulierten Stoppwahrscheinlichkeiten jedes Fragments schließlich als Intensität der entsprechenden Massenspektrumpunkte resultieren.
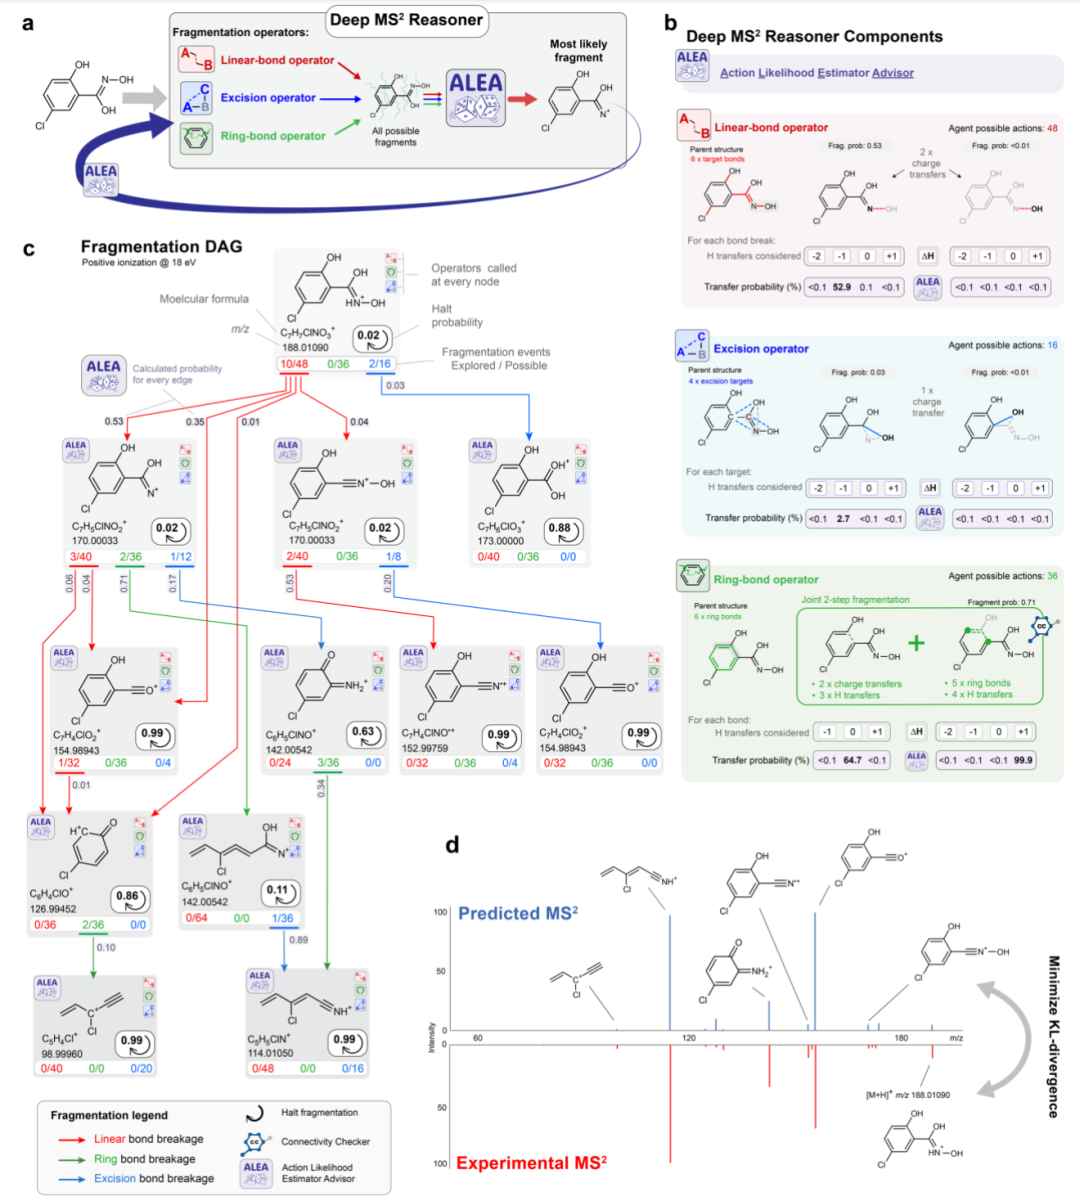
Neuronale Netze entscheiden, welcher Pfad wahrscheinlicher ist, während chemische Regeln festlegen, welche Pfade überhaupt zulässig sind. Nach jedem Schritt überprüft das System molekulare Konnektivitäten, Wasserstoffbilanzen und andere chemische Constraints; unplausible Fragmentierungen gelangen nicht in weitere Berechnungen. Fragmente mit identischer Struktur und chemischem Zustand werden zusammengefasst, was redundante Suchvorgänge reduziert. Zweige mit sehr niedriger Wahrscheinlichkeit werden nicht weiter verfolgt, wodurch vermieden wird, dass alle möglichen Fragmentierungspfade exponentiell wachsend bei steigender molekularer Komplexität vollständig exhaustiv durchsucht werden müssen.
Im Trainingsprozess lernen primär Parameter innerhalb von ALEA; restliche Fragmentierungsoperationen und Bewertungen der chemischen Plausibilität erfolgen über deterministische Regeln. Zur Messung der Abweichung zwischen vorhergesagtem und experimentellem Spektrum verwendet das Modell die Kullback-Leibler-Divergenz und integriert Regularisierungsbeschränkungen, so dass bei mehreren gleichwertigen Erklärungen eines Spektralpeaks einfachere lineare Bindungsbrüche leicht bevorzugt werden. Zudem kommt Curriculum Learning zum Einsatz: Beginnend mit kleineren Molekülen und einfacheren Fragmentierungspfaden werden sukzessive größere und komplexere Verbindungen hinzugefügt, damit das Modell zunächst generalisierbare lokale Fragmentierungsregeln erlernt.
DeepMS²Reasoner löst das Problem der „Vorhersage von Spektren aus Strukturen“, während MS²KOSMOS zusätzlich das Problem adressiert, „wie man Milliarden von Molekülen effizient durchsuchen kann“. Der MS²KOSMOSGenerator kodiziert jede vorhergesagte Spektraldarstellung als sparse Vektoren, die sich aus Summenformeln fragmentärer Bausteine zusammensetzen, und erstellt Inverted Indexes. Bei unbekannten Massenspektren muss das System nicht einzeln Millionen von Kandidaten vergleichen, sondern findet zuerst solche Kandidaten, denen gemeinsame fragmentäre Summenformen entsprechen; anschließend führt MS²KOSMOSMapper unter Berücksichtigung tatsächlicher experimenteller Bedingungen wie Stoßenergien erneut die Vorhersage dieser Kandidatenspektren durch und sortiert sie entsprechend zurück, wobei auch die dazugehörigen Fragmentierungs-DAGs geliefert werden.
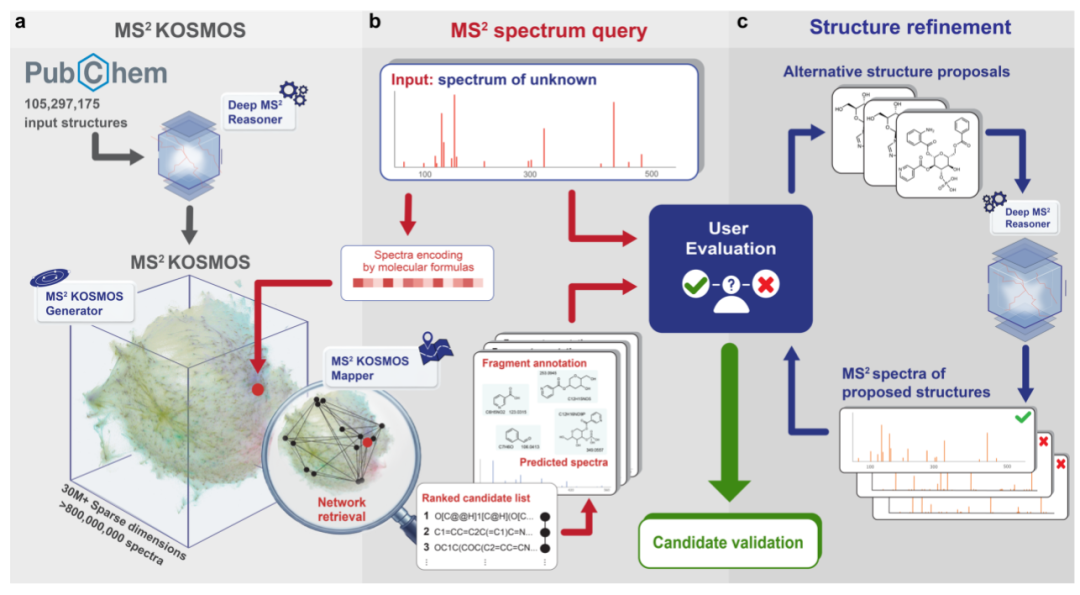
Vom vorhersagten Massenspektrum hin zur Aufklärung unbekannter Moleküle
Zunächst wurde DeepMS²Reasoner anhand grundlegendster Aufgabenstellungen zur Massenspektrenvorhersage evaluiert. Im unabhängigen Testset NIST 2020 erreichte die durchschnittliche Cosinusähnlichkeit zwischen vorhergesagtem und gemessenem Spektrum 0,83, Medianwerte betrugen 0,89; vergleichende Modelle lagen im Bereich von 0,61 bis 0,75. Auch auf komplett separaten Datensätzen wie CASMI 2022 und MassSpecGym beliefen sich die mittleren Cosinusähnlichkeitswerte von DeepMS²Reasoner jeweils auf 0,67 bzw. 0,59 – beides waren Spitzenresultate aller teilnehmenden Modelle. Am Beispiel von CASMI zeigte sich, dass in über 40 % der Probenproben DeepMS²Reasoner jene spektralen Vorhersagen lieferte, die allen Vergleichsmethoden am nächsten an den realen Ergebnissen lagen.
Neben der reinen Vorhersage von Massenspektren stellt die inverse Aufgabe, also das Auffinden korrekter Molekularstrukturen allein aufgrund empirischer Spektren, deutlich höhere Anforderungen heraus. Hier wurden echte Strukturen gemeinsam mit zahlreichen qualitativ ähnlichen sowie strukturell nah verwandten Referenzsubstanzen abgeglichen. Beim vollständigen Isomerietest von CASMI erzielte DeepMS²Reasoner Genauigkeiten (Accuracy-Werte) von 35,6 %, 64,4 % und 79,8 % für Top-1-, Top-10- und Top-50-Rankinglistenpositionen; sowohl beim Top-1- als auch beim Top-10-Ergebnis lag dies signifikant jenseits (+10 Prozentpunkte) gegenüber dem zweitplatzierten Algorithmus FraGNNet.
Fähigkeit zur Handhabung mehrgliedriger Zerfallsprozesse bewies das Modell exemplarisch mittels konkreter Substanzen. Als Beispiel dient Biotin: die berechnete Ähnlichkeit gemäß Cosinusmaßzahl betrug hier 0,88 zwischen modellierter Kurve versus tatsächlich registriertes Signalverlaufskurve. Einige dominante Bruchstücke lassen sich keineswegs durch einmaliges Spalten einer einzigen Verbindung entstehen – stattdessen bedürfen sie fortlaufender Sequenzen bestehend aus Gruppenverlust, Ringöffnung sowie weiterer Sekundärfragmentationsschritte selbstverständlich ebenfalls korrekt abgebildet inklusive zeitabhängiger Energiedepositionseffekte je nach Stoßspannungswerten.
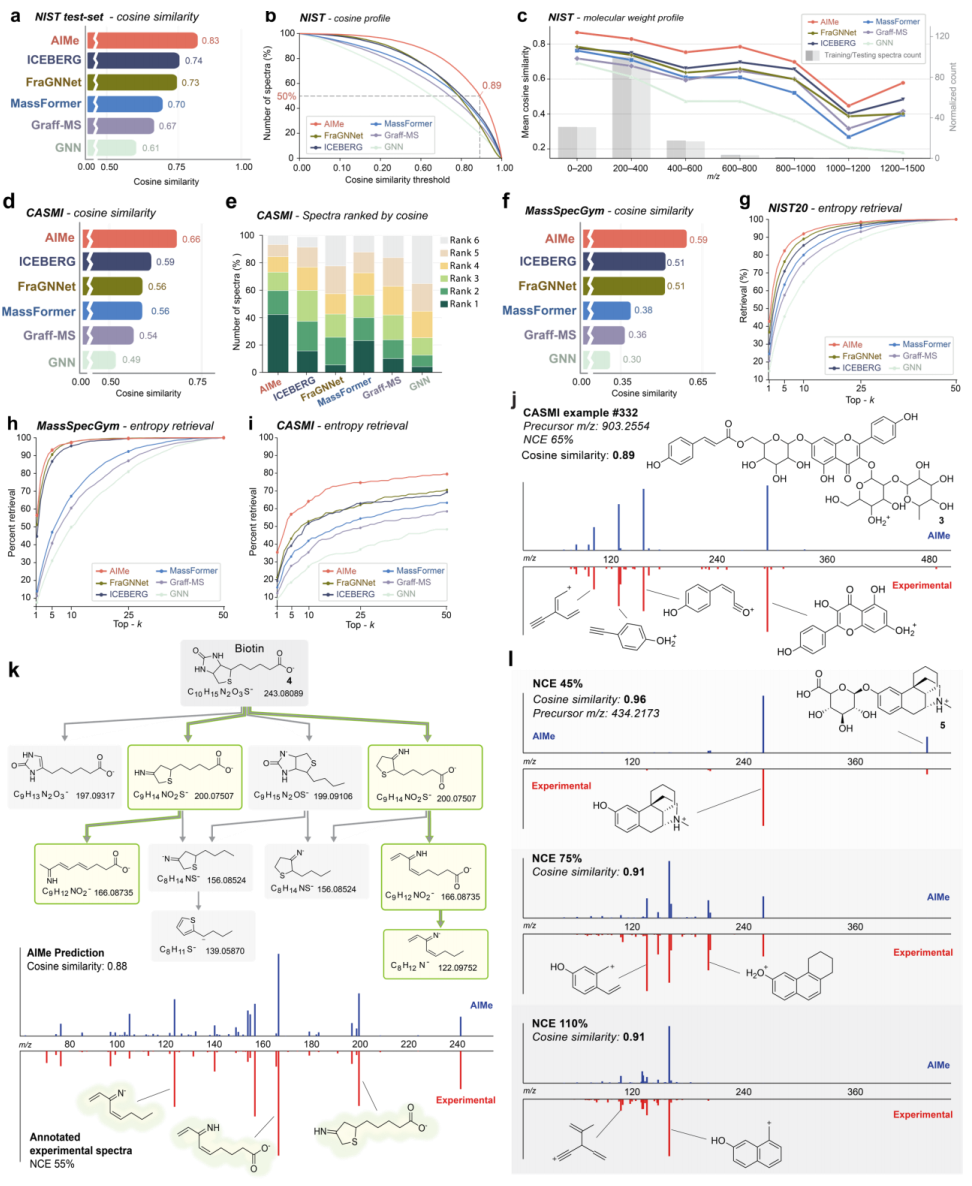
Leistungsfähigkeitsprofil der massenspektrometrischen Vorhersagemodelle generiert mittels DeepMS²Reasoner
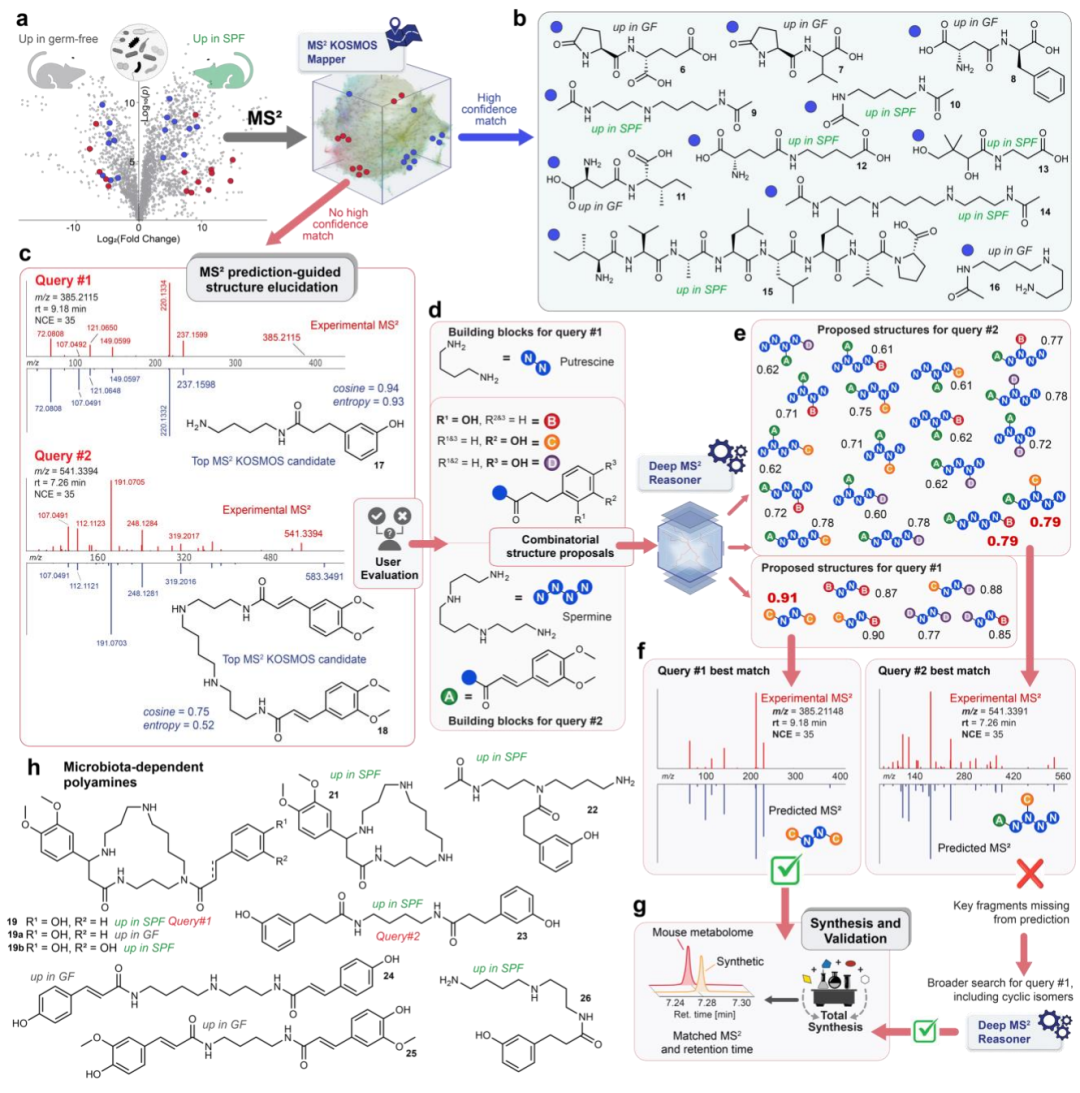
Anschließend wandte man AIMe nun wirklich unidentifizierten Metabolitenanalysen zu. Bezogen auf insgesamt hundertelf mikrobiota-abhängige Signalmuster isoliert aus Mausmetabolomdaten gelang etwa ein Drittel präziser Zuordnungen hochgradig kongruenter Treffer bekannter Naturstoffe via MS²KOSMOS-Sucheplattform; verbleibende Anteile deuten vielmehr noch beschreibungsbedürftige neue Gerüsttypen an.
Die Forscher wählten weiter zwei unbekannte Substanzen zur Strukturaufklärung aus. Basierend auf den Fragmentstrukturen, die von AIMe bereitgestellt wurden, kombinierten sie mehrere Kandidatenmoleküle und sagten deren MS²-Spektren vorher, um diese mit den experimentellen Ergebnissen zu vergleichen. Für einen der beiden unbekannten Stoffe erreichte das beste initiale Kandidatenspektrum bereits eine Cosinus-Ähnlichkeit von 0,79, jedoch fehlten noch einige für den Experimentablauf entscheidende Fragmente. Das Forschungsteam berücksichtigte daher weiterhin cyclische Strukturen und fokussierte sich schließlich auf ein seltenes makrocyclisches Sperminderivat. Durch chemische Synthese und Vergleich der Retentionszeiten sowie der MS²-Spektre konnten beide Kandidatenstrukturen letztlich verifiziert werden; darunter befand sich auch ein Polyamin, das zuvor weder bei Mäusen noch beim Menschen beschrieben worden war. Weitere Suchen zeigten, dass verschiedene verwandte Metaboliten ebenfalls in humanen Proben vorhanden sind.
Schließlich ** erweiterte das Forscherteam AIMe auf über 7,14 Millionen konsensierte Massenspektren der GNPS-Datenbank.** Mit einem Schwellenwert einer Cosinus-Ähnlichkeit von 0,7 erhielten etwa 2,69 Millionen Spektren kandidatische Annotationen, was rund einem Drittel aller Abfragen entspricht; selbst nach Anhebung des Schwellenwerts auf 0,8 kamen weitere ca. 1,27 Millionen hochähnliche Annotationen hinzu, die mehr als 26 Millionen bisher unannotierten Originalspektren innerhalb von GNPS entsprechen. Somit wurde der Anwendungsbereich von AIMe von der Vorhersage einzelner molekularer Massenspektren hin zur Annotation unbekannter Substanzen im Maßstab ganzer Datenbanken erweitert.
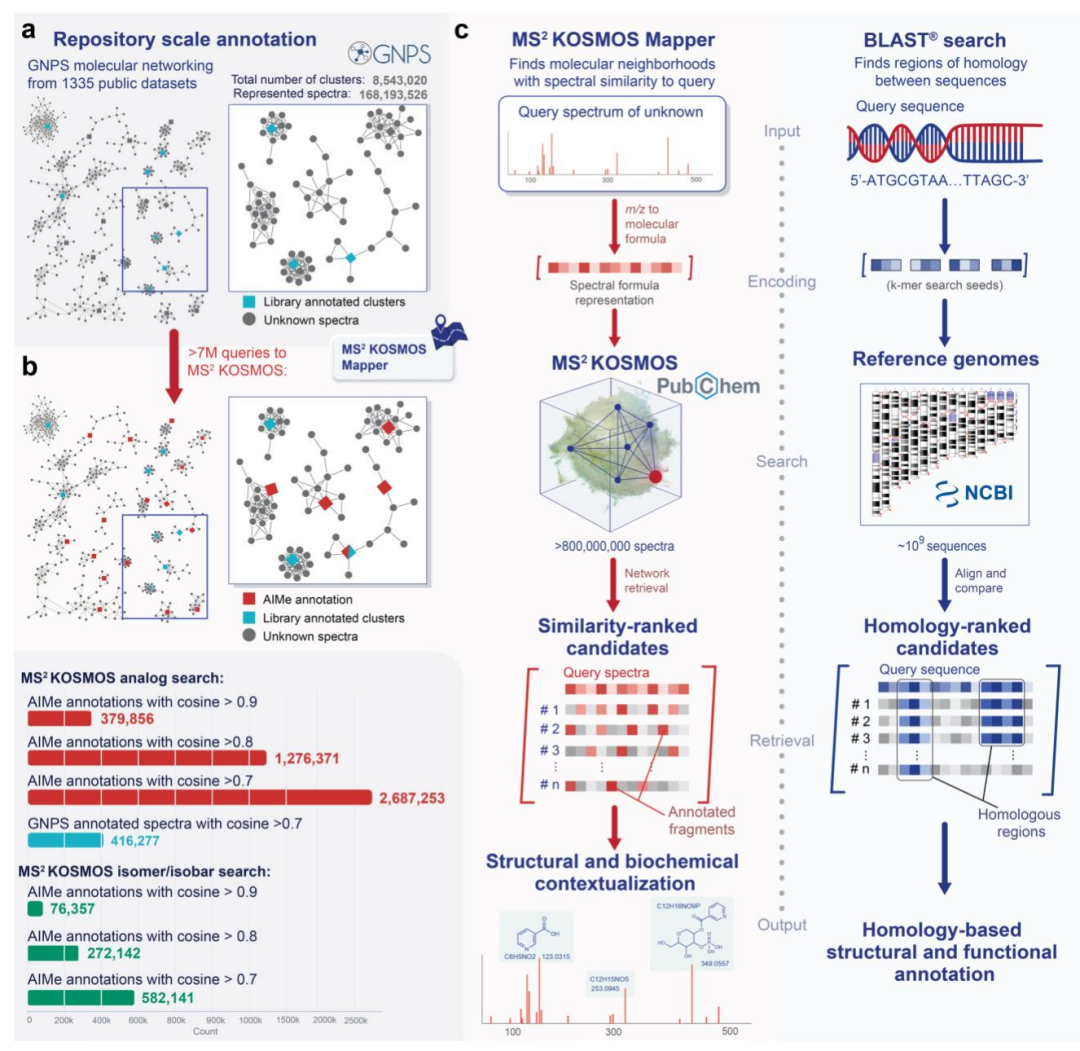 *Massehafte Annotationsergebnisse von AIMe auf der GNPS-Datenbank*
Diese Ergebnisse bedeuten nicht, dass die Identifizierung kleiner Molekülstrukturen vollständig automatisiert ist. Mit zunehmender Molmasse nehmen mögliche Zerfallspfade deutlich zu, während die Abdeckung großer Moleküle in den Trainingsdaten relativ gering bleibt, sodass die Leistungsfähigkeit von DeepMS²Reasoner weiterhin abnimmt. Noch wichtiger ist, dass MS² allein oft nicht ausreicht, um die endgültige Strukturbestätigung abzuschließen. Gemäß Standards der Metabolomik gehören die von AIMe gelieferten Ergebnisse ohne unabhängige Beweise wie Retentionszeit, NMR oder Referenzstandards vorrangig zur Ebene 3 der Annotation; ihre Hauptaufgabe besteht darin, den Raum möglicher Kandidaten einzuschränken, Strukturhypothese n zu formulieren und Begründungen für Fragmentierungen bereitzustellen – die abschließende Bestätigung erfordert stets experimentelle Validierung.
Zum Schluss
Die Bedeutung von AIMe liegt weniger in der weiteren Steigerung der Genauigkeit der Massenspektrenvorhersage, sondern vielmehr im Versuch, die Art und Weise der Aufklärung unbekannter kleiner Moleküle grundlegend zu verändern. In der Vergangenheit hatten Forscher angesichts eines unbekannten Massenspektrums meist nur die Möglichkeit, direkt im begrenzten Umfang experimenteller Spektralbibliotheken nach Übereinstimmungen zu suchen; AIMe hingegen nutzt Modelle zunächst dazu, den bekannten Raum kleiner organischer Moleküle in einen durchsuchbaren Raum vorgerechneter Massenspektren zu transformieren und schränkt dann anhand der Fragmentstruktur und -pfade sukzessive den Kreis der möglichen Kandidaten ein. Obwohl es Standardreferenzen oder NMR-basierte Verifikationen derzeit nicht ersetzen kann, eröffnet es doch die Chance, jene Signale weiterzuverfolgen, die aufgrund „fehlender Referenzspektren“ sonst kaum analysierbar gewesen wären.
Für die Metabolomik könnte dies sogar bedeutender sein als das bloße Hinzufügen neuer Einträge zu spektralen Bibliotheken: Unbekannte Massenspektren haben nun nicht mehr ausschließlich binäre Ausgänge („passend“ bzw. „nicht passend“), sondern können stattdessen als Ausgangspunkt dienen, um Strukturhypothesen zu entwickeln und zu überprüfen.