Command Palette
Search for a command to run...
Verabschiedung Des Manuellen Zähls Von Fluoreszenz: Britisches Team Entwickelt KI-Workflow Zur Bewertung Von Tollwutimpfstoffen Mit Einer AUC Von 0,999

Tollwut ist eine schwerwiegende Zoonose, die in endemischen Gebieten jährlich immer noch zehntausende Todesopfer fordert. Obwohl Impfungen Tollwut wirksam verhindern können, hängen die Diagnose einer Virusinfektion, die Bewertung des Impfschutzes nach der Impfung sowie die damit verbundene serologische Überwachung weiterhin von zuverlässigen Labormethoden ab. Bei der Zellkulturdetektion müssen Laborpersonal häufig fluoreszenzmikroskopische Bildgebung nutzen, um festzustellen, ob Zellen mit dem Tollwutvirus (RABV) infiziert sind. Der gesamte Prozess umfasst die manuelle Beobachtung und Interpretation einer großen Anzahl von Bildern, was nicht nur zeitaufwendig ist, sondern auch durch die Erfahrung des Bedieners sowie durch schwache Fluoreszenzsignale und Bildartefakte beeinflusst werden kann.
In den letzten Jahren haben Fortschritte bei der Deep-Learning-Technologie (DL) die Entwicklung der biomedizinischen Bildanalyse erheblich vorangetrieben, einschließlich der Bewertung von Virusinfektionen. Allerdings gab es zuvor keine Studien, die Deep-Learning-Methoden auf die systematische fluoreszenzmikroskopische Analyse von Tollwutvirusantigenen anwendeten. Da das Tollwutvirus üblicherweise keine ausgeprägten zytopathischen Effekte oder Synzytienbildung hervorruft, ist die Anwendbarkeit zellmorphologischer Merkmale, auf die sich viele KI-basierte Methoden stützen, bei solchen Tests begrenzt.
In diesem Zusammenhang schlug ein Forschungsteam der University of Surrey in Großbritannien den ersten KI-basierten Workflow vor, um Tollwutvirusinfektionen in BHK-21-Zellkulturen zu erkennen und Antikörpertiter zu quantifizieren. Die Forscher wählten drei fortschrittliche Deep-Learning-Architekturen – ResNet, Swin Transformer V2 und MambaOut – und trainierten sie mit einem umfangreichen Datensatz. Bei der Bewertung auf drei Ebenen – Bildregionen, Einzelbilder und Wells – übertraf das MambaOut-Modell die anderen Modelle durchweg.
Auf der Well-Ebene erreichte das Modell eine Genauigkeit von 0,996, einen F1-Score von 0,993 und eine Fläche unter der Receiver-Operating-Characteristic-Kurve (AUC-ROC) von 0,999. Um die praktische Anwendbarkeit dieser Methode zu bewerten, testeten die Forscher das Modell weiter mit bisher unbekannten Bildern aus dem von der Weltgesundheitsorganisation (WHO) und der Weltorganisation für Tiergesundheit (WOAH) empfohlenen Fluoreszenzantikörper-Virusneutralisationstest. MambaOut stimmte bei der Vorhersage der Antikörperkonzentration vollständig mit den Ground-Truth-Ergebnissen überein, was die Zuverlässigkeit dieses Workflows für die Bewertung von Impfstoffen und Tests im Zusammenhang mit Haustierreisen bestätigt.
Die Forschungsergebnisse wurden unter dem Titel „Deep learning enables rabies virus detection and antibody quantification in cell culture“ in der Zeitschrift Scientific Reports veröffentlicht.
Forschungshighlights:
-
Aufbau des ersten großen Bildgebung-Datensatzes für das Tollwutvirus
-
Automatisierung der Hochdurchsatz-Bildanalyse durch KI, die Diagnostiklabors eine skalierbare und zeitsparende Lösung bietet, insbesondere für Länder und Regionen, in denen Tollwut endemisch ist
-
Die Ergebnisse der Studie legen den Grundstein für KI-gestützte Tollwutdiagnostik und eröffnen neue Möglichkeiten für die Anwendung von Deep-Learning-Technologien bei anderen zellkulturbasierten Virusnachweismethoden
Link zum Artikel:
https://www.nature.com/articles/s41598-026-57955-8
Aufbau des LyssaScan-Datensatzes: Erkennung von Infektionssignalen aus Fluoreszenzbildern
Die Forscher erstellten zunächst den Bilddatensatz LyssaScan zur Erkennung von RABV-Infektionen. Dieser Datensatz deckt verschiedene Infektionslevel, Färbereagenzien und Bildgebungsbedingungen ab und spiegelt gleichzeitig biologische Unterschiede sowie technische Variabilität wider.
Konkret nutzten die Forscher BHK-21-Zellen, die mit dem Standard-Angriffsstamm 11 des Tollwutvirus (RABV) (CVS-11) infiziert waren, um einen standardisierten Prozess der fluoreszenzmikroskopischen Bildgebung zu etablieren. Die Zellkultur erfolgte in 96-Well-Platten mit flachem, transparentem Boden und schwarzen Seitenwänden. Nach 48 Stunden Inkubation fixierten die Forscher die Zellen und färbten sie mit polyklonalen Antikörpern gegen das Nukleokapsid des Tollwutvirus (Fujirebio), die mit Fluorescein-Isothiocyanat (FITC) markiert waren. Negative Kontrollen umfassten Wells mit nicht infizierten Zellen und Wells, die nur Kulturmedium enthielten. Einige Zellkulturen wurden mit einem anderen FITC-konjugierten Antikörper (Sifin) gefärbt. Der vollständige Bildgebungsprozess ist im folgenden Diagramm dargestellt:
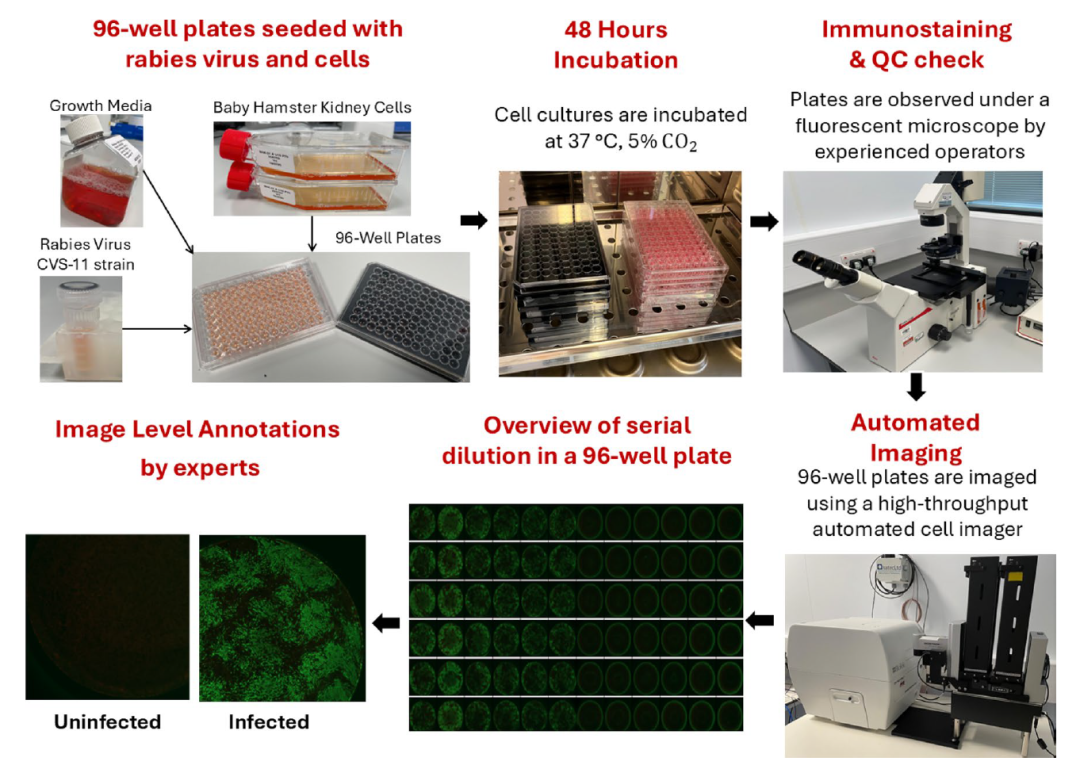
Automatisierter Workflow zur Generierung des Datensatzes
Die automatisierte Bildgebung erfolgte mit dem Cytation 5 Zellbildanalysesystem von Agilent Technologies, ausgestattet mit einem Objektiv, dessen Modellinformationen im Originaltext als fehlerhaft gekennzeichnet sind, sowie einer integrierten Weitfeldkamera. Die Forscher nutzten GFP- und Texas-Red-Filterblöcke, um die Fluoreszenzsignale der Virusnukleokapsidfärbung bzw. Bilder zur Beobachtung der Zellmonolayer zu erfassen. Jeder Well wurde an vier Eckpositionen abgebildet, wodurch pro Well vier synthetische PNG-Bilder erzeugt wurden. Insgesamt wurden 2.344 synthetische Bilder für die weitere Verarbeitung erfasst.
Anschließend wurden die Bilder auf eine bestimmte Größe vergrößert, um sie präzise in 16 überlappungsfreie Bildregionen (Patches) zu unterteilen. Diese wurden von Fachpersonal manuell annotiert, um zuverlässige Ground-Truth-Labels zu erzeugen. Fälle, in denen keine Einigkeit erzielt werden konnte, wurden als „mehrdeutig“ gekennzeichnet und von der Modellentwicklung ausgeschlossen. Letztlich umfasste der Datensatz LyssaScan insgesamt 36.822 Bildregionen, davon 9.750 infizierte und 27.072 nicht infizierte Proben.
Architekturunterschiede der drei Modelle: Von CNNs zu Gated Convolutions
Um die Leistungsfähigkeit verschiedener Deep-Learning-Architekturen bei der Erkennung von Fluoreszenzbildern zu vergleichen, wählten die Forscher drei Modelle aus: ResNet-101, Swin Transformer V2 Small (SwinT-V2) und MambaOut Small. Die Anzahl der Parameter betrug jeweils etwa 44,5 Millionen, 47 Millionen bzw. 48,5 Millionen.
ResNet-101: Faltungsneuronales Netz basierend auf Residualverbindungen
ResNet diente als Basismodell dieser Studie. Sein Kernmerkmal ist die Einführung von Sprungverbindungen (Skip Connections), die eine verbesserte Gradientenpropagation ermöglichen, während das Netz vertieft wird. Durch schichtweise Extraktion von Bildmerkmalen kann ResNet lokale Fluoreszenzstrukturen erkennen, ist jedoch bei der Unterscheidung komplexer Hintergründe und schwacher Infektionssignale möglicherweise durch die begrenzten Ausdrucksmöglichkeiten lokaler Merkmale eingeschränkt.
SwinT-V2: Integration von Kontextinformationen durch Self-Attention
SwinT-V2 gehört zu den hierarchischen Vision-Transformern und nutzt einen verschobenen Fenster-Self-Attention-Mechanismus, der die Extraktion lokaler Merkmale mit der Integration breiterer Kontextinformationen kombiniert. Bei Fluoreszenzbildern können Infektionsherde klein sein oder mit Hintergrundsignalen, Färbungsunterschieden oder anderen Strukturen vermischt werden. Daher trägt die ganzheitliche Betrachtung lokaler Darstellungen und ihrer Umgebung zur Verbesserung der Erkennungsfähigkeit bei.
MambaOut: Dynamische Merkmalssteuerung durch Gating-Mechanismen
MambaOut verwendet in dieser Studie gestapelte Gated-CNN-Module ohne Komponenten für Zustandsraummodelle. Der Gating-Mechanismus kann die Weitergabe von Merkmalen dynamisch steuern, wertvolle Signale selektiv verstärken und Hintergrundrauschen unterdrücken. Diese Eigenschaft könnte besonders geeignet sein, um schwache Fluoreszenzherde in komplexen Hintergründen zu erkennen, was einer der Hauptgründe ist, warum die Forscher ihre Leistungsfähigkeit besonders beachteten.
Die drei Architekturen repräsentieren jeweils unterschiedliche, komplementäre technische Ansätze – Faltungsneuronale Netze (CNN), Vision Transformer (ViT) und Gated Convolutional Neural Networks – und bilden die Grundlage für einen systematischen Vergleich verschiedener Architekturen.
Für das Modelltraining wurden Standard-Datenaugmentationsmethoden eingesetzt, darunter zufälliges Spiegeln und Rotieren sowie Anpassungen von Helligkeit und Kontrast, um die Robustheit der Modelle zu erhöhen. Die Modelle wurden mit vorab trainierten Gewichten von ImageNet-1k initialisiert und auf dem LyssaScan-Datensatz feinabgestimmt. Das Training erfolgte auf NVIDIA GeForce RTX 2080 Ti GPUs über 20 Trainings-Epochen mit einer Batch-Größe von 128.
Während des Optimierungsprozesses wurde der Adam-Optimizer verwendet. Die Formel für die initiale Lernrate war im Originaltext nicht eindeutig darstellbar und konnte daher nicht exakt rekonstruiert werden; es wurde eine Cosine-Annealing-Strategie für die Lernratensteuerung eingesetzt. Zur Bewältigung des Klassenungleichgewichts wurde eine gewichtete Kreuzentropie-Verlustfunktion verwendet, wobei die Klassengewichte umgekehrt proportional zur Häufigkeit der jeweiligen Klassen waren.
Während des Trainings (wie in der folgenden Abbildung dargestellt) werden die von den Modellen extrahierten Merkmale zunächst durch globale mittlere Pooling (GAP) zu einem D-dimensionalen Merkmalsdeskriptor aggregiert, dann in eine voll verbundene Schicht (FC) eingespeist, um Logits zu erzeugen, und schließlich über die gewichtete Kreuzentropie-Verlustfunktion optimiert.
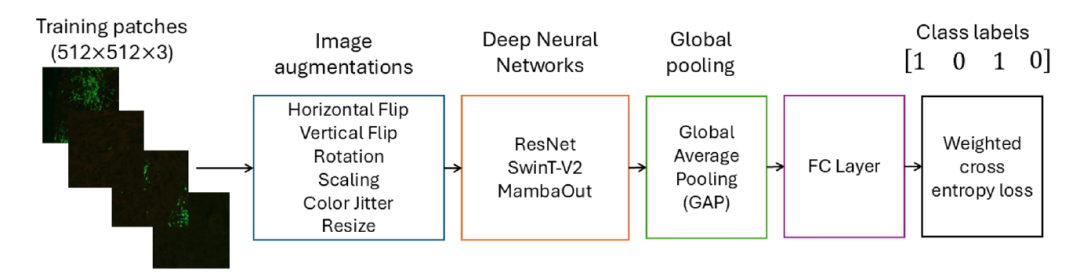
Während des Modelltrainings
In der Inferenzphase (wie in der folgenden Abbildung dargestellt) werden die Eingebildregionen nach einer Größenanpassung von dem trainierten Modell verarbeitet. Die extrahierten Merkmale werden nach der Aggregation durch globales mittleres Pooling über eine voll verbundene Schicht und eine Softmax-Schicht in Wahrscheinlichkeitswerte für jede Klasse umgewandelt. Anschließend werden anhand dieser Wahrscheinlichkeiten die verschiedenen Bewertungsmetriken des Modells berechnet.
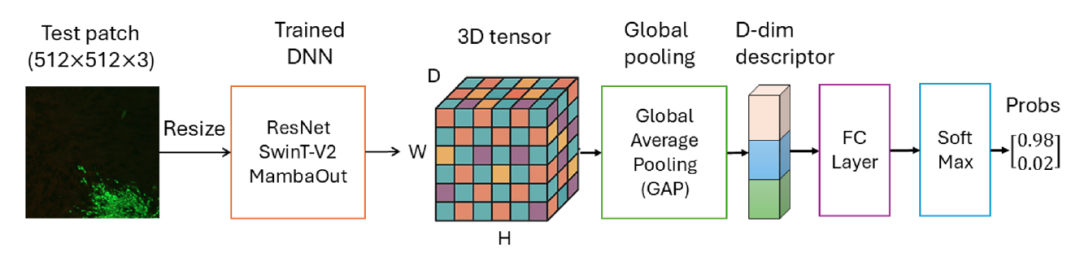
Modell-Inferenzprozess
Das MambaOut-Modell kombiniert Erkennungsgenauigkeit mit quantitativer Antikörperbestimmung
Die Forscher führten eine systematische Bewertung der drei Modelle ResNet, Swin Transformer V2 und MambaOut durch und verglichen die Leistungsfähigkeit aktueller fortschrittlicher Deep-Learning-Modelle bei der Erkennung von Tollwutviren. Dies liefert eine Grundlage für die Auswahl und Anwendung relevanter Modelle.
Bewertung der Modellleistung
Die Modellleistung wurde auf drei Ebenen bewertet. Zunächst wurde die Erkennungsleistung auf Ebene der Bildregionen (Patches) evaluiert, indem einzelne Bildregionen separat klassifiziert wurden. Die Ergebnisse sind in der folgenden Tabelle dargestellt:
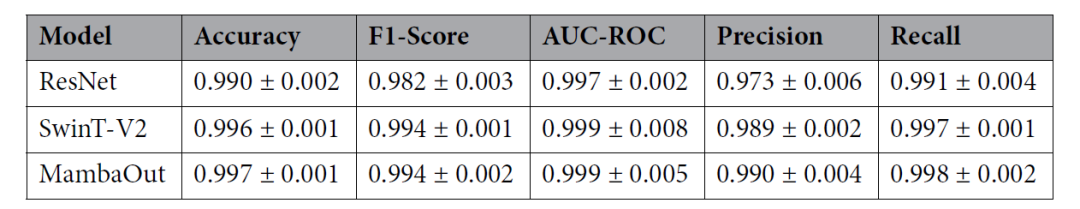
Leistungsfähigkeit (Mittelwert ± Standardabweichung) von tiefen neuronalen Netzen auf Basis einer 5-fachen Kreuzvalidierung auf Ebene der Bildregionen (Patches) des LyssaScan-Datensatzes
Anschließend wurden die Vorhersageergebnisse von 16 Bildregionen aggregiert, um das Klassifikationsergebnis für das gesamte Bild zu erhalten, und dieses mit den bodenwahren Annotationen auf Bildebene verglichen. Die Ergebnisse sind in der folgenden Tabelle dargestellt:
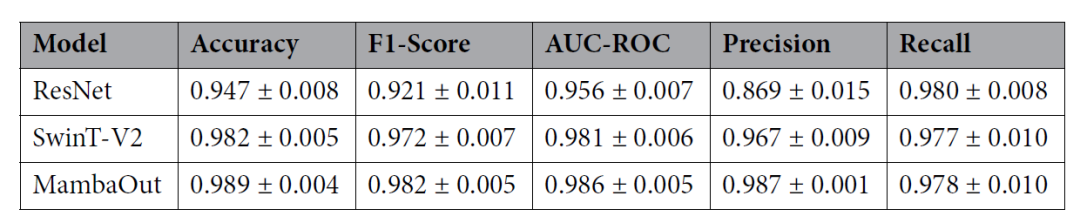
Leistungsbewertung der tiefen neuronalen Netze auf dem LyssaScan-Datensatz auf Bild-Ebene mittels 5-facher Kreuzvalidierung (Mittelwert ± Standardabweichung)
Da jeder Vertiefung vier Bilder von verschiedenen Eckenpositionen zugeordnet sind, aggregierten die Forscher die Vorhersageergebnisse der Bildbereiche abschließend auf die Vertiefungsebene und verglichen sie mit den entsprechenden bodenwahrheitsbasierten Annotationen, um die Gesamterkennungsleistung pro Vertiefung zu bewerten. Die Ergebnisse sind in der folgenden Tabelle dargestellt:
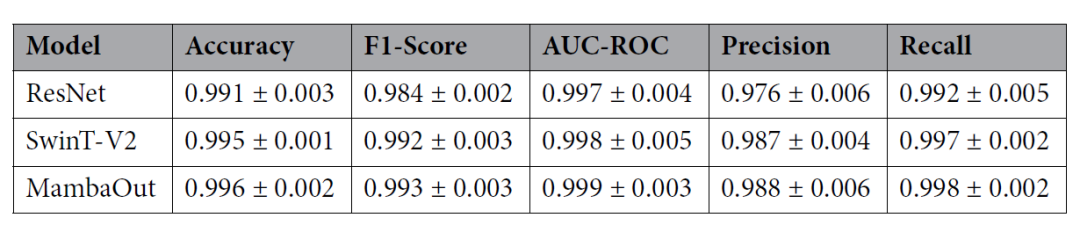
Leistungsbewertung der tiefen neuronalen Netze auf dem LyssaScan-Datensatz auf Vertiefungs-Ebene mittels 5-facher Kreuzvalidierung (Mittelwert ± Standardabweichung)
Auf den drei Bewertungsebenen Bildbereich, Einzelbild und Vertiefung erzielte MambaOut stets die besten Ergebnisse, gefolgt vom Swin Transformer V2 (SwinT-V2). Auf der Ebene der Bildbereiche zeigte MambaOut die besten Werte bei Genauigkeit, F1-Score und Präzision, was auf seine zuverlässige Erkennung von Infektionssignalen in lokalen Bildbereichen hinweist. Dieser Trend wurde auch bei der Bewertung auf Bildebene bestätigt: MambaOut erzielte eine hohe Genauigkeit und einen hohen F1-Score, während SwinT-V2 leicht hinter MambaOut lag.
ResNet wies die geringste Leistung auf Bildebene mit einer Genauigkeit von 0,947 auf, was hauptsächlich darauf zurückzuführen ist, dass das Modell empfindlich auf Klassifikationsfehler auf der Ebene der Bildbereiche reagiert. Dennoch entspricht diese Aggregationsregel der tatsächlichen biologischen Entscheidungslogik: Das Auftreten auch nur eines fluoreszenzpositiven Bereichs bedeutet, dass ein Virusantigen nachgewiesen wurde, weshalb das gesamte Bild als infiziert (positiv) eingestuft werden sollte. Im diagnostischen Kontext ist der Nachweis jeglicher Infektionsnachweise von großer Bedeutung, und falsch-negative Ergebnisse haben in der Regel schwerwiegendere Folgen als gelegentliche falsch-positive Befunde.
Eignung zur Bestimmung von Antikörpertitern im Fluoreszenz-Antikörper-Virusneutralisationstest (FAVN)
Um die Eignung des vorgeschlagenen Workflows für serologische Testszenarien zu bewerten, wandten die Forscher das Modell auf den Fluoreszenz-Antikörper-Virusneutralisationstest (FAVN) an. Die experimentellen Ergebnisse zeigten, dass MambaOut die beste Leistung erbrachte, mit einer Genauigkeit von 0,992, einem F1-Score von 0,992 und einer AUC-ROC von 0,997, was darauf hindeutet, dass das Modell in der Lage ist, lokale und globale Merkmale unter komplexen und variablen Testbedingungen effektiv zu erfassen. SwinT-V2 zeigte ebenfalls eine starke Generalisierungsfähigkeit mit einer Genauigkeit von 0,988. Im Vergleich dazu war die Leistung von ResNet geringer, mit einer Genauigkeit von 0,965.
Anschließend untersuchten die Forscher weiter die Eignung des Modells zur Bestimmung von Antikörpertitern im FAVN-Test, indem sie dieselbe Bildgruppe verwendeten und die vom Modell vorhergesagten Antikörpertiter mit den Ergebnissen menschlicher Operatoren verglichen. Die manuelle Auswertung diente dabei als Referenzstandard, wie in der folgenden Tabelle dargestellt:
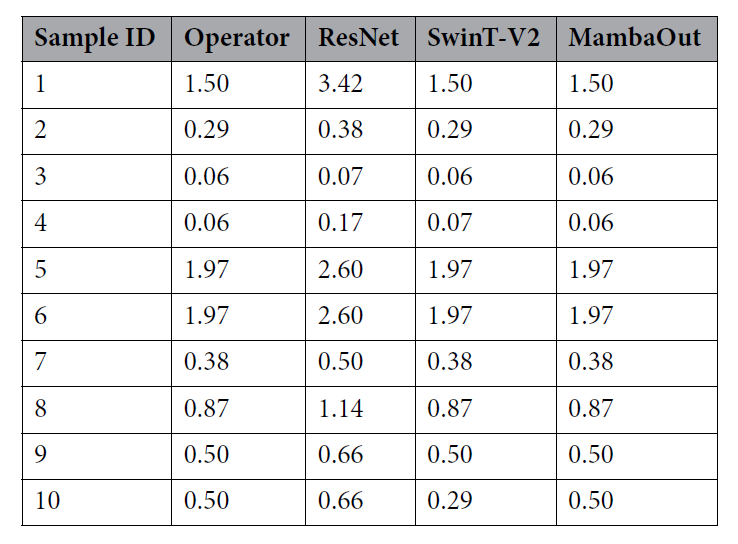
Vergleich der von ResNet, SwinT-V2 und Mamba vorhergesagten Antikörpertiter (Internationale Einheiten pro Milliliter, IU/mL) mit den manuellen Auswertungsergebnissen menschlicher Operatoren für dieselbe Stichprobengruppe
Zur Bewertung der Übereinstimmung zwischen dem Modell und den menschlichen Operatoren wurde eine Bland–Altman-Analyse durchgeführt, wie in der folgenden Abbildung dargestellt:
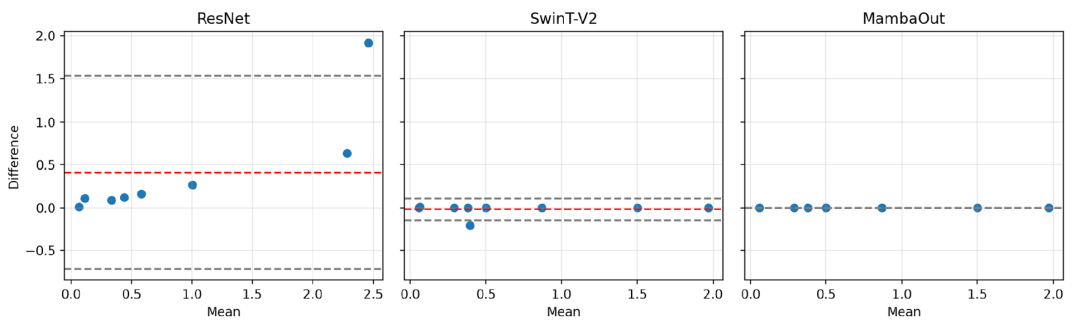
Bland–Altman-Übereinstimmungsanalyse zwischen den Vorhersagen des Deep-Learning-Modells und den Messergebnissen menschlicher Operatoren
ResNet zeigte eine deutliche positive Verzerrung mit einer mittleren Differenz von +0,41 und einem breiten Limit-of-Agreement-Bereich (LoA) von −0,71 bis +1,53. Dies deutet darauf hin, dass ResNet im Vergleich zu den manuellen Auswertungsergebnissen dazu neigt, Antikörpertiter systematisch zu überschätzen.
SwinT-V2 zeigte eine gute Übereinstimmung mit einer mittleren Differenz nahe null (−0,02) und einem engen LoA-Bereich von −0,15 bis +0,11, was darauf hindeutet, dass seine Vorhersagen über den gesamten Messbereich eine gute Austauschbarkeit mit den manuellen Auswertungsergebnissen aufweisen.
Die Vorhersagen von MambaOut stimmten vollständig mit den manuellen Auswertungen überein, wobei alle gepaarten Differenzen null betrugen.
Für SwinT-V2 und MambaOut wurden keine Hinweise auf eine proportionale Verzerrung festgestellt; bei ResNet hingegen zeigte sich eine leichte Zunahme der Differenzen mit steigendem Antikörpertiter.
Gemäß den Richtlinien der Weltgesundheitsorganisation (WHO) und der Weltorganisation für Tiergesundheit (WOAH) kann ein Antikörpertiter von 0,5 IU/mL als angemessener Nachweis für eine serologische Konversion nach der Impfung betrachtet werden und dient als Referenzstandard für die Einhaltung internationaler Vorschriften für den Heimtiertransport. Die Studie verwendete diesen Schwellenwert, um zu bewerten, wie sich Unterschiede in den vorhergesagten Titern innerhalb einer Stichprobengruppe, die den gesamten Bereich der Antikörpertiter abdeckt, auf die Ergebnisbewertung auswirken.
Innerhalb der gesamten Stichprobengruppe waren die geschätzten Antikörpertiter für ResNet im Allgemeinen höher als die tatsächlichen Referenzwerte. Diese Fehleinschätzung könnte dazu führen, dass Haustiere mit unzureichender Immunität fälschlicherweise für die Ausreise zugelassen werden.
Die Gesamtvorhersagen von SwinT-V2 lagen näher an der manuellen Interpretation, klassifizierten jedoch Probe 10 fälschlicherweise als negativ, obwohl diese Probe tatsächlich die Qualifikationskriterien erfüllte. Dies könnte zu unnötigen Wiederimpfungen und Verzögerungen bei der Ausreise führen.
Die Vorhersagen von MambaOut stimmten hingegen vollständig mit der manuellen Interpretation überein. Das Modell identifizierte nicht nur alle nicht qualifizierten Proben korrekt, sondern unterschied auch präzise zwischen Seren mit niedrigem und hohem Titer, ohne dass es bei der Schwellenwertbestimmung zu Fehlern kam.
Zusammenfassend zeigen diese Ergebnisse, dass das vorgeschlagene System nicht nur effektiv auf zellkulturbasierte Tests angewendet werden kann, sondern sich auch auf serologische Testverfahren ausweiten lässt, was seine weitere Anwendung in der Diagnose von Tollwut und der serologischen Überwachung unterstützt.
Schlussfolgerung
Zusammenfassend festigt der in dieser Studie erzielte Fortschritt bei der Erkennung von RABV-Infektionen die wissenschaftliche Grundlage für den Einsatz von Computer Vision in der Zellforschung und in diagnostischen Tests und ebnet zugleich den Weg für dessen Ausweitung auf zellkulturbasierte Tests für andere Viruspathogene. Diese Studie unterstreicht das Potenzial der künstlichen Intelligenz, die Labordiagnostik zu revolutionieren, und hilft, die Kluft zwischen expertenmäßiger Interpretationsfähigkeit und skalierbaren, benutzerfreundlichen Technologien zu schließen. Neben den technischen Beiträgen demonstriert dieser Ansatz auch das Potenzial KI-gestützter Diagnoseverfahren, die globale Tollwutlast zu verringern. Obwohl das aktuelle Protokoll noch auf spezialisierte Geräte angewiesen ist, könnte die zugrunde liegende Methode an leichter verfügbare Geräteplattformen angepasst werden, wie beispielsweise die Kombination aus Standardmikroskopen und Digitalkameras, um den Weg für skalierbare und nachhaltige diagnostische Lösungen in ressourcenarmen Regionen zu ebnen.
Referenzen:
https://phys.org/news/2026-10-ai-rabies-world.html
https://www.nature.com/articles/s41598-026-57955-8