Command Palette
Search for a command to run...
Nur 38,8 Millisekunden! Clef-Flash Vollzieht Multimodale Entscheidungen Und Verabschiedet Sich Von Der Token-für-Token-Ausgabe; Kontextfenster Im Millionenumfang, DABstep-Benchmark Bewertet Die Mehrstufige推理-fähigkeit Von Agenten
Im Zeitalter der beschleunigten Implementierung von Agenten und Automatisierungsanwendungen benötigen Unternehmen zunehmend Modelle, die direkt ausführbare Entscheidungen liefern, anstatt langer Texte, die einer nachträglichen Analyse bedürfen. Das traditionelle Paradigma großer Sprachmodelle, das auf der freien tokenweisen Generierung basiert, stößt jedoch in Szenarien strukturierter Entscheidungen weiterhin auf die altbekannten Probleme instabiler Ausgabeformate, umständlicher Parsing-Prozesse und hoher Latenzzeiten.
Um diese Einschränkung zu überwinden, hat Cloudflare im Oktober 2026 Clef-Flash veröffentlicht, ein multimodales Entscheidungsmodell mit 9 Milliarden Parametern, das als Open-Source verfügbar ist. Es basiert auf dem nachtrainierten Qwen3.5-9B und重构iert den Entscheidungsprozess von der Textgenerierung hin zur probabilistischen Bewertung in einem einzigen Vorwärtsdurchlauf, was einen direkteren technischen Ansatz für strukturierte Entscheidungen im Zeitalter der großen Modelle bietet.
Der traditionelle generative Pfad erfordert die schrittweise Decodierung von Tokens; je länger die Generierung, desto länger die Wartezeit. Entscheidungsprozesse benötigen jedoch lediglich eine Option und deren Wahrscheinlichkeit. Clef-Flash umgeht die gesamte autoregressive Generierungskette, und die offiziell gemeldete mediane Entscheidungs-Latenz beträgt nur 38,8 Millisekunden – schneller als ein Lidschlag. Gleichzeitig behält es die Verständnisfähigkeiten eines 9-Milliarden-Parameter-Modells vollständig bei, verlagert die Berechnung jedoch vom „Schreiben der Antwort“ auf das „Treffen einer Entscheidung“. Es ist zudem nativ mit der Jev System One API kompatibel, sodass Unternehmen, die solche Schnittstellen bereits nutzen, nahezu nahtlos integrieren können. Von der automatischen Klassifizierung und Weiterleitung von Kundenservice-Tickets und Support-Nachrichten über die Moderation von Bildern und Inhalten bis hin zur strukturierten Extraktion von Rechnungsstatus, Dringlichkeit und Stimmungstendenzen bietet Clef-Flash eine sofort einsetzbare Lösung für eine der häufigsten Anforderungen in Unternehmens-Workflows: schnelle, stabile und quantifizierbare Entscheidungen.
Derzeit ist auf der HyperAI-Website das Tutorial „Clef-Flash: Typisiertes probabilistisches Entscheidungsmodell“ verfügbar. Probieren Sie es jetzt aus~
Online-Nutzung:
19. Oktober – 23. Oktober, Hyper.ai Website-Update im Überblick:
- Hochwertige öffentliche Datensätze: 6
- Ausgewählte hochwertige Tutorials: 4
- Beliebte Enzyklopädie-Einträge: 5
- Top-Konferenzen mit Einreichungsfrist im November: 6
Website besuchen: hyper.ai
Ausgewählte öffentliche Datensätze
1. DABstep Multi-Step Reasoning Agent Benchmark-Datensatz
DABstep (Data Agent Benchmark for Multi-step Reasoning) ist ein von Adyen im Jahr 2025 veröffentlichter Benchmark-Datensatz für mehrstufiges logisches Denken von Daten-Agenten, der darauf abzielt, die Fähigkeit von KI-Agenten zur Bewältigung komplexer Datenfragen und mehrstufiger logischer Schlussfolgerungen zu bewerten. Der Datensatz besteht aus drei Teilmengen; die Teilmenge „tasks“ umfasst 460 reale Geschäftsaufgaben, insgesamt mehr als 1 Million Kontextproben, im JSON-Format.
Online ausführen: https://go.hyper.ai/E4hf8
2. Last Translation Benchmark Extrem-Übersetzungsbenchmark-Datensatz
Der Last Translation Benchmark ist ein von Vilém Zouhar und anderen Forschern im Jahr 2026 veröffentlichter Benchmark-Datensatz zur Bewertung von maschinellen Übersetzungsmodellen. Das zugehörige Forschungsergebnis trägt den Titel „Last Translation Benchmark“ und zielt darauf ab, die Fähigkeiten aktueller maschineller Übersetzungsmodelle bei komplexen Übersetzungsaufgaben zu testen und konkrete Fehler der Modelle in realen Szenarien zu identifizieren. Der Datensatz enthält 3.456 schwierige Übersetzungsproben, die verschiedene Sprachen und Sprachkombinationen abdecken. Die Daten stammen aus manuell erstellten und begutachteten Übersetzungsbeispielen. Die Proben umfassen multimodale Eingaben wie Text, Bild, Audio und Video und bieten für jede Probe manuell definierte Validierungsregeln.
Online ausführen: https://go.hyper.ai/yxBAk
3. Knee-Raptor-Corpus Vorkonfigurierter Stack-Datensatz für Knie-MRT
Knee-Raptor-Corpus ist ein abgeleiteter, vorkonfigurierter Datensatz, der aus den rohen Knie-MRT-Daten von fastMRI hervorgegangen ist. Er zielt darauf ab, standardisierte vorkonfigurierte Proben für Deep-Learning-Aufgaben im Bereich Knie-MRT-Bildgebung bereitzustellen. Der vollständige Datensatz ist in die Teile 1 und 2 unterteilt und umfasst insgesamt 4.407 Knie-MRT-Studien. Dieser Datensatz ist Teil 1 und enthält die ersten 3.200 Studien. Jede Studie wurde in einen Stapel von 44 uint8-Bildern mit der Größe 336 × 336 umgewandelt und mit Schnitten aus sagittalen, koronalen und axialen Sequenzen in fester Reihenfolge gefüllt.
Online ausführen: https://go.hyper.ai/roWu1
4. Knee-Raptor-Corpus-Ext Knie-MRT-Schnitt-Datensatz
Dieser Datensatz ist Teil 2 von Knee-Raptor-Corpus und enthält die verbleibenden 1.207 Studienproben. Die Daten bestehen aus rohen DICOM-Medizinbildern, die zu Stapeln von axialen Schnitten mit fester Größe resampled wurden. Jede Probe besteht einheitlich aus 44 uint8-Bildern mit der Größe 336 × 336 und ist direkt für das Training von Modellen für die medizinische Bildgebung geeignet.
Online ausführen: https://go.hyper.ai/rlTgA
5. MOF Property Diversity Datensatz für Eigenschaften metallorganischer Gerüste
MOF Property Diversity ist ein im Jahr 2026 veröffentlichter Datensatz für Eigenschaften metallorganischer Gerüste (Metal-Organic Frameworks, MOF). Er zielt darauf ab, repräsentative MOF-Daten für die Materialinformatik bereitzustellen und Aufgaben wie Materialanalyse, Clustering und maschinelles Lernen zu unterstützen.
Online ausführen: https://go.hyper.ai/BIMLz
6. prompts.chat AI-Prompt-Datensatz
prompts.chat ist eine Open-Source-Community zum Teilen von Prompts. Dieser Datensatz ist ein Export-Snapshot der Prompt-Bibliothek der Plattform. Das ursprüngliche Material stammt aus dem Open-Source-Projekt Awesome‑ChatGPT‑Prompts. Der Datensatz sammelt Prompt-Beispiele, die mit mehreren führenden großen Modellen wie ChatGPT, Claude, Gemini, Llama und Mistral kompatibel sind. Er kann für die Erforschung des Prompt-Engineerings und die Testung der Dialogqualität großer Modelle verwendet werden.
Online nutzen: https://go.hyper.ai/iDmot
Ausgewählte öffentliche Tutorials
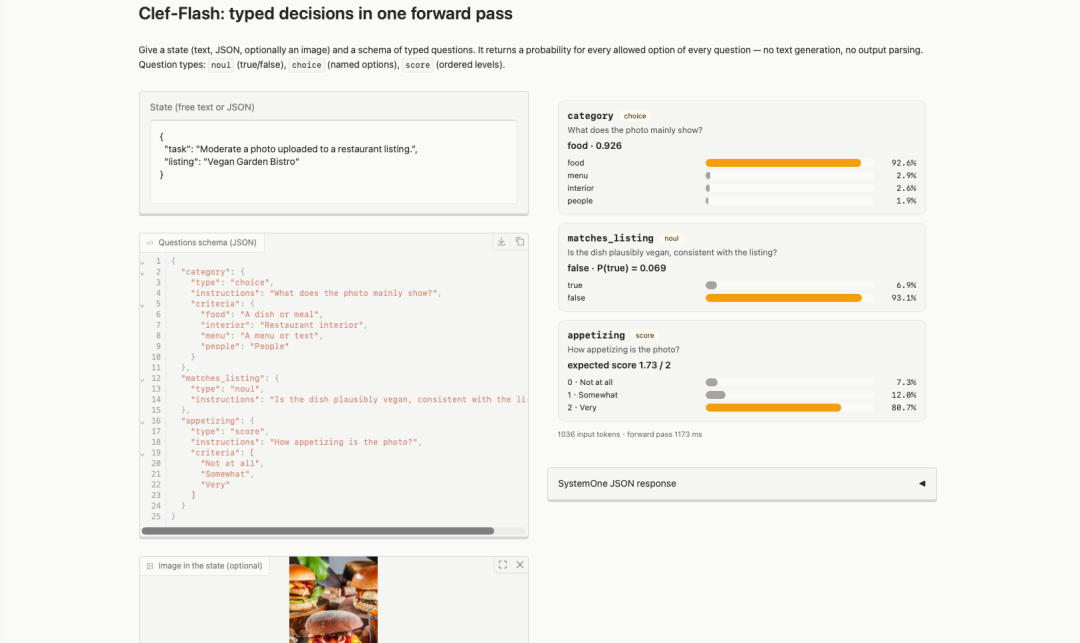
1. Clef-Flash: Typisiertes probabilistisches Entscheidungsmodell
Clef-Flash ist ein im Oktober 2026 von Cloudflare veröffentlichtes multimodales Entscheidungsmodell mit 9 Milliarden Parametern. Die offiziell gemeldete mediane Entscheidungs-Latenz beträgt nur 38,8 Millisekunden. Es ist mit der Jev System One API kompatibel und eignet sich für strukturierte Entscheidungsszenarien wie die automatische Klassifizierung und Weiterleitung von Kundenservice-Tickets, die Moderation von Bildern und Inhalten sowie die Bewertung von Rechnungsstatus und Dringlichkeit.
Online ausführen: https://go.hyper.ai/U6YW0
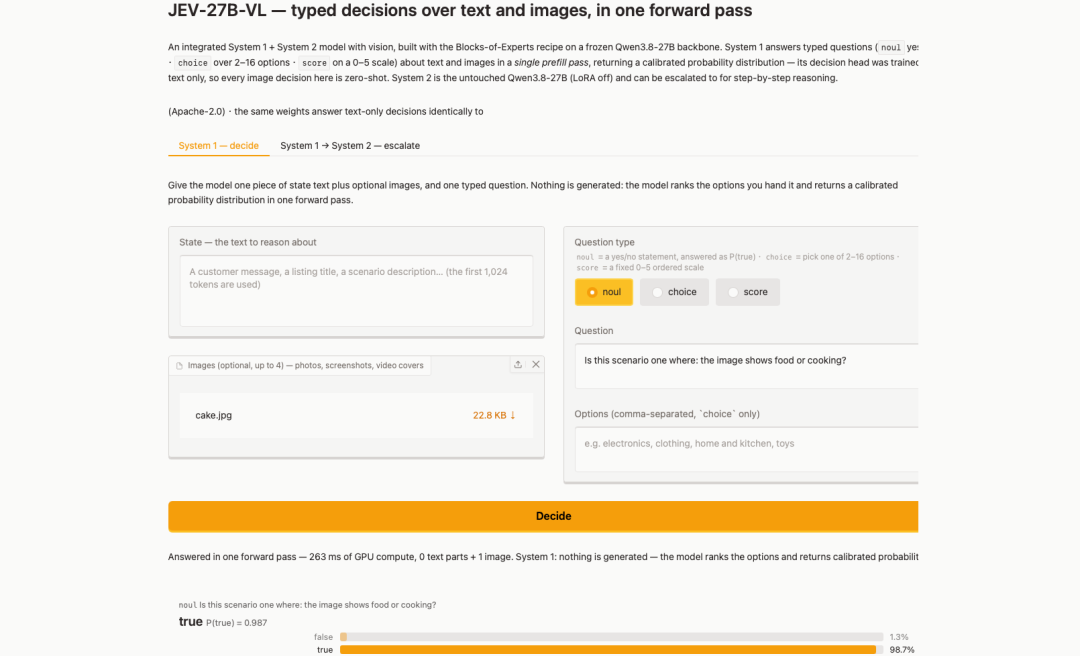
2. JEV-27B-VL: Strukturiertes Entscheidungsmodell für Text und Bild
JEV-27B-VL ist ein im Oktober 2026 von AutoTrust AI veröffentlichtes visuelles Entscheidungsmodell. Es integriert Dual-Channel-Fähigkeiten auf einem eingefrorenen Qwen3.8-27B-Rückgrat durch das Blocks-of-Experts-Verfahren. Laut den Angaben des Herausgebers belegt dieses Modell den ersten Platz unter den 20 visuellen Entscheidungsmodellen auf der visuellen Rangliste des Jev Decision Index 0.3.
Online ausführen: https://go.hyper.ai/3wow2
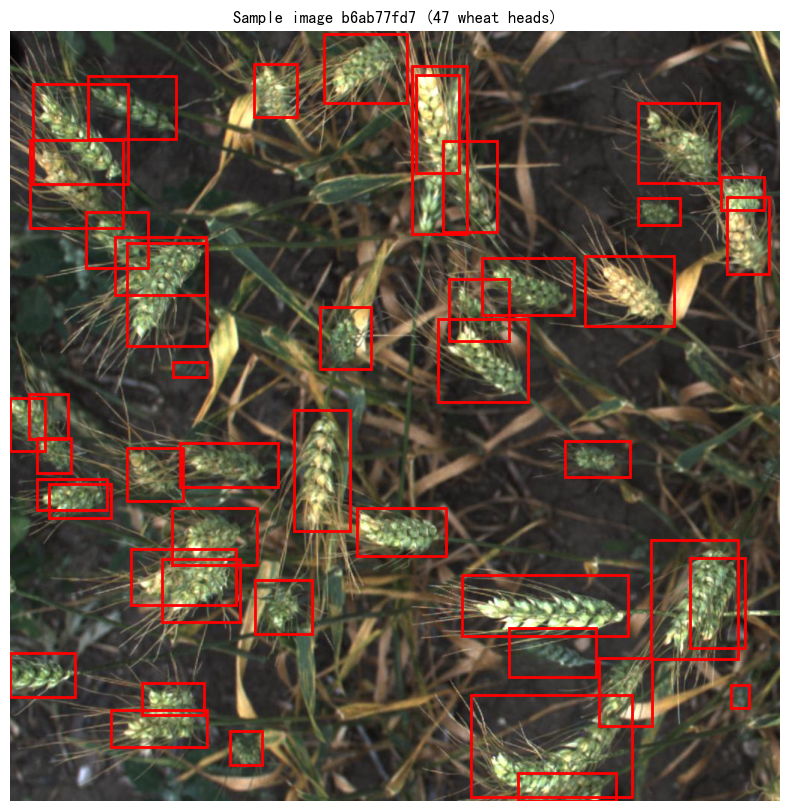
3. PyTorch-Einführung – Training eines Faster R-CNN-Modells
Dieses Tutorial basiert auf dem öffentlichen Notebook des Kaggle-Nutzers pestipeti und demonstriert, wie man mit PyTorch und torchvision ein Faster R-CNN-Objekterkennungsmodell zum Erkennen von Weizenähren in Feldbildern trainiert. Das Tutorial deckt den vollständigen Ablauf ab, einschließlich Datenladen, Datenexploration, Modellaufbau, einstufigem Training und Inferenz auf Testbildern. Es eignet sich für den Einstieg in Objekterkennung und Transfer-Learning und kann auch für Szenarien wie die Zählung von Weizenähren, die landwirtschaftliche Fernerkundung und die Pflanzenphänotyp-Analyse verwendet werden.
Online ausführen: https://go.hyper.ai/Ozwaq
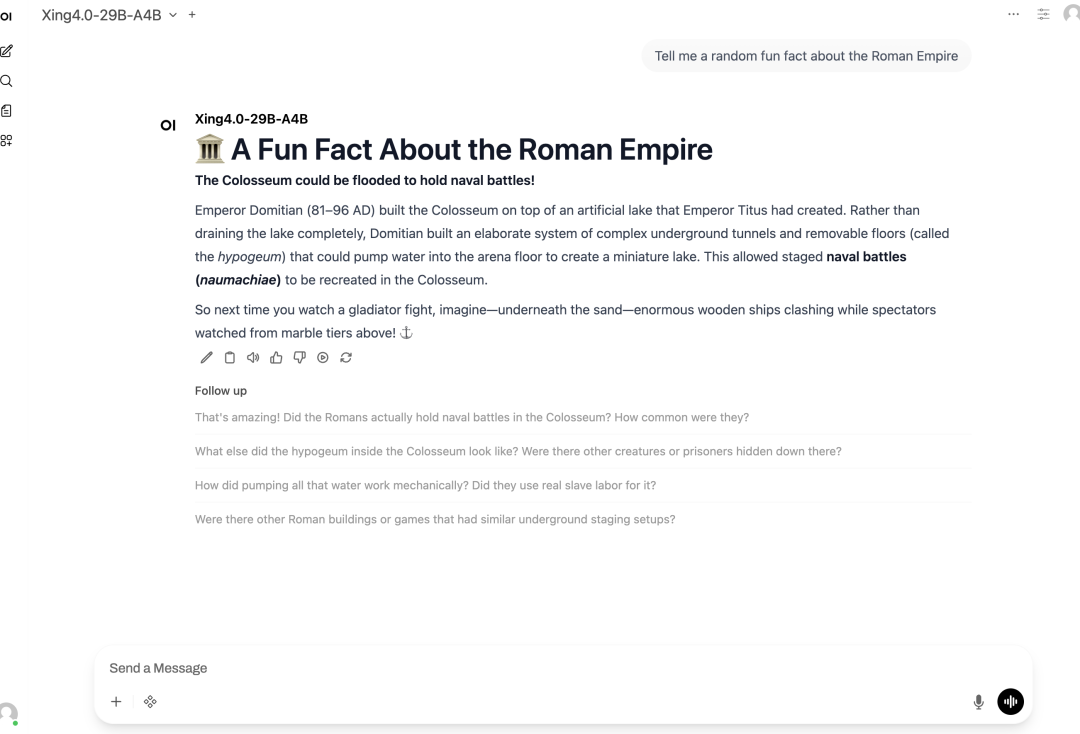
4. Xing4.0-29B-A4B Lokale Inferenz und Open WebUI-Bereitstellung
Dieses Tutorial demonstriert die lokale Inferenz und die Bereitstellung über Open WebUI für das große Modell Xing4.0-29B-A4B. Xing4.0-29B-A4B ist das neueste große Sprachmodell der Xing-Serie (vormals TeleChat), das im September 2026 von China Telecom Artificial Intelligence Technology Co., Ltd. veröffentlicht wurde. Es eignet sich für Szenarien wie komplexe Schlussfolgerungen, Codegenerierung, Tool-Aufrufe und Frage-Antwort-Aufgaben mit langem Kontext.
Online ausführen: https://go.hyper.ai/PDmlT
Ausgewählte beliebte Enzyklopädie-Einträge
1. Welt-Aktionsmodell WAM
2. Robustheit
3. Generatives vortrainiertes Transformationsmodell GPT
4. Videogenerierung
5. Einbettungsmodelle
Hier sind Hunderte von KI-bezogenen Einträgen zusammengestellt, damit Sie hier „Künstliche Intelligenz“ verstehen können: https://go.hyper.ai/wiki
Top-Konferenzen mit Einreichungsfrist im November
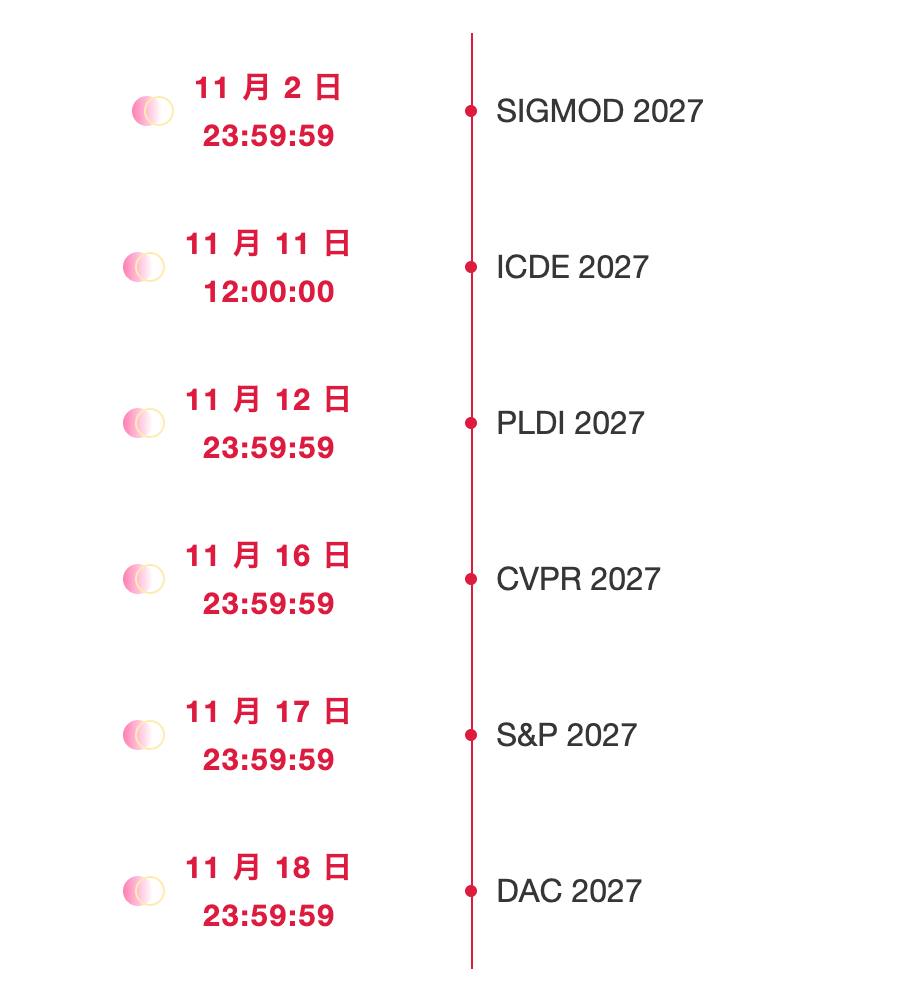
- Einreichungsfristen sind in AoE-Zeit
Verfolgung von KI-Top-Konferenzen aus einer Hand: https://go.hyper.ai/event
Das war alles aus den redaktionellen Highlights dieser Woche. Wenn Sie Ressourcen haben, die auf der offiziellen hyper.ai-Website aufgenommen werden sollen, freuen wir uns über Kommentare oder Einsendungen!
Bis nächste Woche!