Command Palette
Search for a command to run...
Wöchentlicher Forschungsbericht | 8 Papers Über Neue Fortschritte Bei Agent Harness: Fokus Auf Coding-Agenten, Embodied Control Und Bild-/Video-Generierung
Mit dem Übergang von KI-Agenten von einfachen Frage-Antwort-Szenarien zu komplexen Aufgaben wird Agent Harness zunehmend zu einem wichtigen Forschungsfeld in der Agentenentwicklung. Es handelt sich um ein Ausführungsframework, das große Sprachmodelle, Tools und Ausführungsumgebungen verbindet. Es organisiert den Aufgabenablauf, verwaltet Kontext und Gedächtnis, koordiniert Tool-Aufrufe und behandelt Fehler sowie Ergebnisvalidierungen während der Ausführung. Kurz gesagt bestimmt das Modell, was ein Agent denken kann, während der Harness maßgeblich beeinflusst, ob diese Fähigkeiten in stabile und zuverlässige Handlungen umgesetzt werden können.
Warum erhält der Harness immer mehr Aufmerksamkeit? Da die Fähigkeiten von Modellen zur Inferenz und Generierung ständig verbessert werden, beschränken sich die Herausforderungen für Agenten nicht mehr nur auf die Generierung korrekter Antworten. Sie umfassen auch die kontinuierliche Bewältigung mehrstufiger Aufgaben, die Reduzierung fehlerhafter Operationen, die Anpassung an verschiedene Ausführungsumgebungen sowie die Kontrolle von Risiken während autonomer Aktionen. Der Harness entwickelt sich von einem grundlegenden Framework zur Unterstützung von Modellen zunehmend zu einer kritischen Infrastruktur, die die Ausführungseffizienz, die Anwendungsgrenzen und die Sicherheit von Agenten beeinflusst.
In Bezug auf diese Fragen untersuchen immer mehr aktuelle Studien aus verschiedenen Perspektiven Design, Bewertung und Optimierung von Harnesses: Einige Studien analysieren durch kontrollierte Experimente die Rolle von Planung, Tools und Kontextmanagement. Andere untersuchen zuverlässigere Ausführungsmechanismen in den Bereichen Terminal-Operationen, Robotersteuerung und visuelle Generierung. Wieder andere richten ihren Fokus auf Sicherheitsbeschränkungen, automatisierte Konstruktion und rekursive Selbstverbesserung, um zu ermöglichen, dass Harnesses nicht nur ausgeführt, sondern anhand von Aufgabenfeedback kontinuierlich optimiert werden können.
In dieser Ausgabe haben wir 8 Studien zum Thema Agent Harness ausgewählt, die Erkenntnisse von NVIDIA, Google Cloud AI Research sowie von Hochschulen und Forschungseinrichtungen wie der Northwestern University und der University of Science and Technology of China zusammenfassen. Sie decken Bereiche wie Framework-Design, Ausführungssteuerung, Embodied AI, visuelle Generierung, Sicherheits-Governance, Bewertung von Engineering-Fähigkeiten, rekursive Optimierung und Selbst-Evolution ab. Sehen wir sie uns gemeinsam an!
Darüber hinaus wird der Bereich „Papers“ auf der offiziellen HyperAI-Website weiterhin kontinuierlich die neuesten Ergebnisse im Bereich der künstlichen Intelligenz verfolgen, um Ihnen zu helfen, zeitnah über relevante Forschungsentwicklungen informiert zu bleiben ⬇️
Neueste Papers anzeigen:
Paper-Empfehlungen der Woche
1. Harness Design for Coding Agents
Papertitel:
An Empirical Study of Harness Design for Coding Agents
Paper und detaillierte Analyse:
Diese Studie führt eine systematische empirische Analyse des Harness-Designs für Coding-Agenten durch und konzentriert sich darauf, wie verschiedene Ausführungsmechanismen die Leistung beeinflussen, während das zugrunde liegende Modell unverändert bleibt. Die Forscher führten kontrollierte Experimente rund um drei Kernkomponenten durch: Planungsmechanismen, Aktionsraum und Kontextmanagement. Sie versuchten, die spezifischen Auswirkungen der einzelnen Harness-Komponenten auf die Erfolgsquote der Aufgaben, die Ausführungseffizienz und die Ressourcenkosten zu klären, um zu vermeiden, dass die Wirksamkeit eines Designs nur anhand der endgültigen Leistung des Gesamtsystems beurteilt wird.
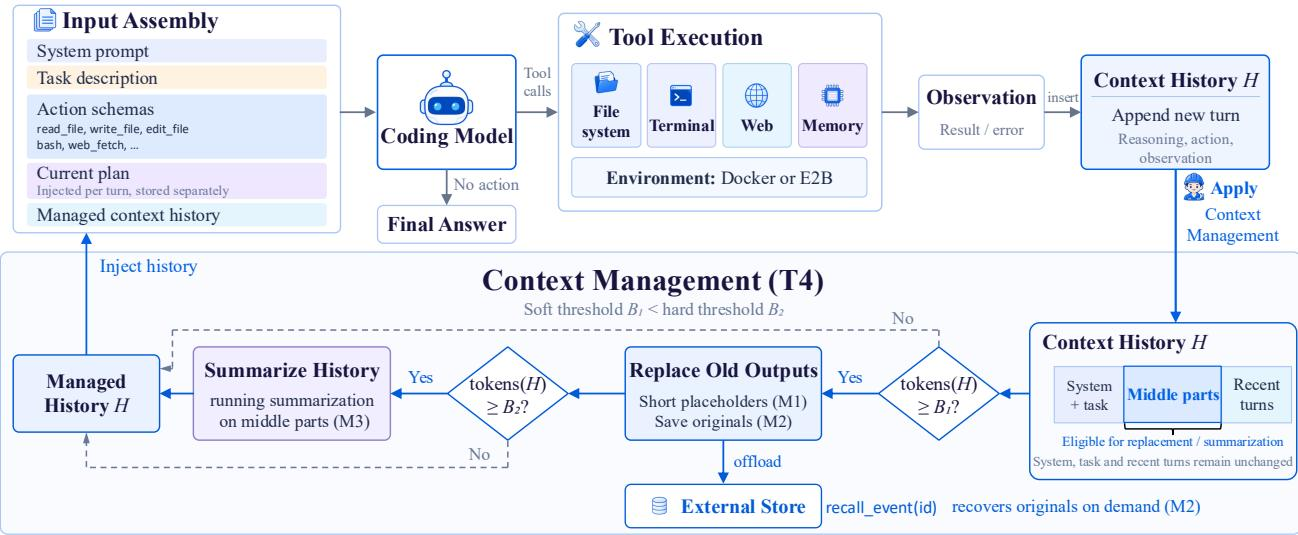
Das Forschungsteam führte mehrere gepaarte Experimente auf Benchmarks wie SWE-Bench Verified und Terminal-Bench 2.1 durch. Die Ergebnisse zeigen, dass das Kontextmanagement für langfristige Aufgaben von besonderer Bedeutung ist; die angemessene Verarbeitung historischer Informationen kann Misserfolge aufgrund von Kontextüberläufen reduzieren. Die Vorteile von Planungsmechanismen variieren je nach Modellfähigkeiten, und auch die Auswahl der Tool-Schnittstellen muss an die Eigenschaften des Modells angepasst werden. Die Studie zeigt, dass beim Harness nicht mehr Komponenten automatisch besser sind, sondern dass es entsprechend den Aufgabenanforderungen, den Modellfähigkeiten und dem Ressourcenbudget entworfen werden sollte. Dies liefert eine empirische Grundlage für zukünftige quantifizierbare Optimierungsstudien zu Harnesses.
2. Mid-Harness
Papertitel:
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
Paper und detaillierte Analyse:
Forscher von Institutionen wie NVIDIA und dem Korea Advanced Institute of Science and Technology (KAIST) haben Mid-Harness vorgeschlagen, um zu untersuchen, wie Mechanismen zur Aktionsauswahl und Validierung zwischen dem großen Sprachmodell und dem Ausführungsframework eingefügt werden können, um die Zuverlässigkeit der Ausführung von Terminal-Agenten zu verbessern. Traditionelle Terminal-Agenten führen normalerweise direkt die vom Modell generierten Befehle aus, aber fehlerhafte Operationen können die Laufzeitumgebung verändern und nachfolgende Aufgaben beeinträchtigen. Selbst wenn das Modell in der Lage ist, bessere Befehle zu generieren, liefert es möglicherweise nicht gleich beim ersten Versuch die beste Wahl. Mid-Harness generiert vor der eigentlichen Ausführung mehrere Kandidatenaktionen und vergleicht sowie filtert diese anschließend über einen Validator, um die Auswirkungen unangemessener Operationen auf den Fortgang der Aufgabe zu reduzieren.
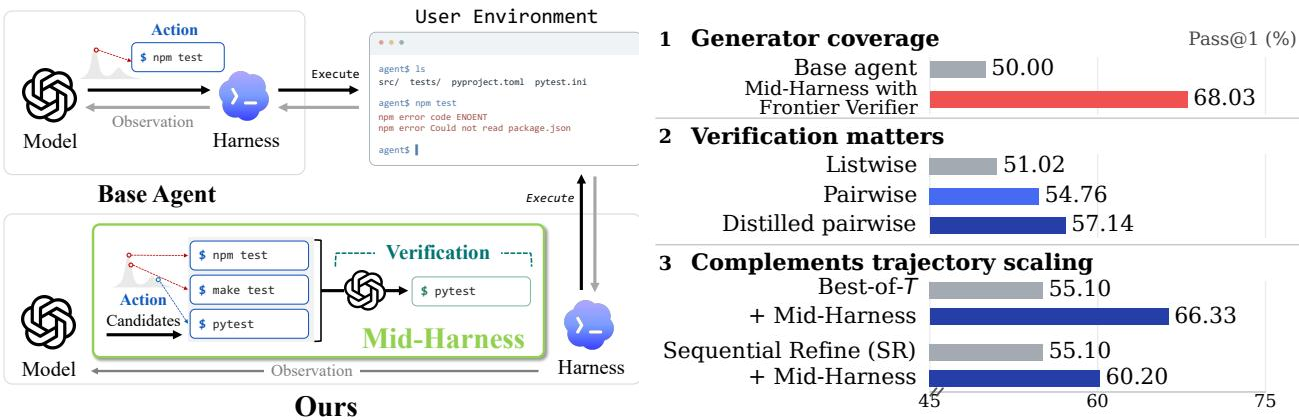
Das Forschungsteam führte Experimente durch, die sich auf die Sampling-Methoden für Kandidatenaktionen, die Auswahl der Validatoren und verschiedene Ausführungsstrategien konzentrierten, um den praktischen Wert der Zuweisung zusätzlicher Rechenressourcen zwischen dem Modell und dem Harness zu analysieren. Die Studie zeigt, dass eine Erhöhung der Kandidatenaktionen nicht zwingend zu Vorteilen führt; der Effekt hängt davon ab, ob der Validator bessere Operationen identifizieren kann. Angemessene Vergleichs- und Filtermechanismen können die Aktionsqualität verbessern und die Erfolgsquote der gesamten Aufgaben-Trace erhöhen. Diese Arbeit verschiebt den Optimierungsfokus von der reinen Verbesserung der Generierungsfähigkeit des Modells hin zur Aktionsauswahl vor der Ausführung und bietet neue Ansätze für den Aufbau zuverlässigerer Terminal-Agenten.
3. Show-Harness
Titel der Arbeit:
Show-Harness: Just a VLM Agent Can Play Robots
Arbeit und detaillierte Erläuterung:
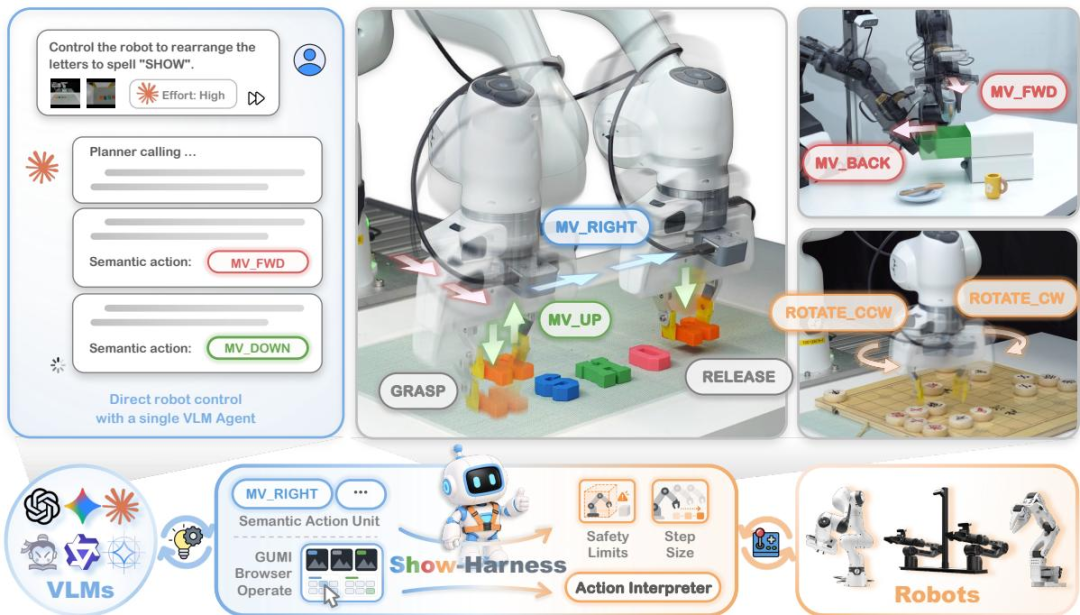
Die Forscher schlagen Show-Harness vor, um das Problem zu lösen, wie Vision-Language-Modelle (VLM) ihre Fähigkeiten zur visuellen Verständnis und sprachlichen Schlussfolgerung in tatsächliche Roboteraktionen übersetzen können. Traditionelle Robotersysteme erfordern in der Regel das spezielle Training von Vision-Language-Action-Modellen oder verlassen sich auf unabhängige Steuerungen, um Anweisungen auszuführen, die von hochrangigen Modellen generiert werden. Show-Harness hingegen entwirft eine semantische Aktions-Schnittstelle, die Roboteraktionen als diskrete Aktions-Einheiten darstellt, die vom Modell verstanden und logisch abgeleitet werden können. Ein für den jeweiligen Roboter konzipierter Interpreter wandelt diese Aktionen anschließend in tatsächliche Steuerbefehle um. Darüber hinaus hat das Forschungsteam GUMI (GUI Manipulation Interface) entwickelt, das die Erfassung von Roboter-Demonstrationen über grafische Benutzeroberflächen unterstützt und die Abhängigkeit von spezieller Teleoperation-Hardware reduziert.
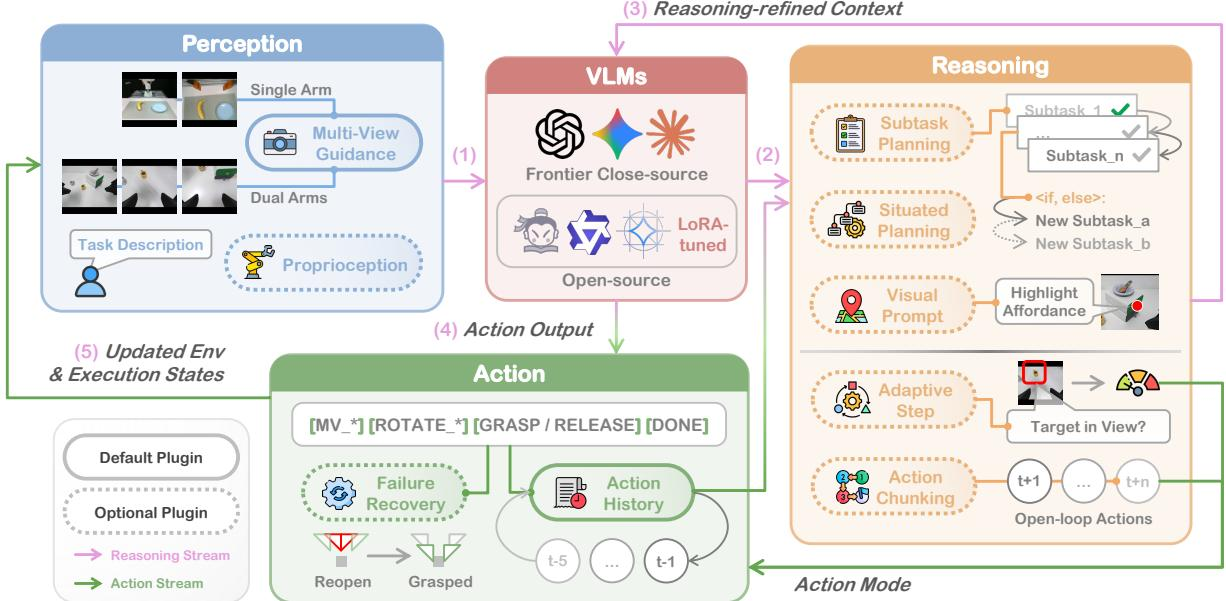
Das Forschungsteam führt Bewertungen in mehreren Aufgaben, Roboter-Formfaktoren und Umgebungen durch, um die Leistung des Frameworks in Zero-Shot-Steuerungs- und Lightweight-Fine-Tuning-Szenarien zu untersuchen. Die Ergebnisse zeigen, dass Show-Harness fortschrittliche VLMs in die Lage versetzen, verschiedene Roboter-Aktionsaufgaben ohne spezifisches Fine-Tuning auszuführen, und dass sich kleinere Open-Source-Modelle durch relativ leichtgewichtiges Fine-Tuning anpassen lassen. Die Studie zeigt auch, dass Mechanismen wie Kontextplanung, Aktions-Historie und Fehlerwiederherstellung die Ausführungsstabilität verbessern können. Diese Arbeit verdeutlicht, dass ein sorgfältig gestaltetes Interaktionsinterface zwischen Modell und Umgebung das bereits vorhandene verkörperte Potenzial der Basis-VLMs freisetzen kann, um Harness von einem reinen Software-Ausführungs-Framework zu einer Handlungskontrollschicht in der physischen Welt weiterzuentwickeln.
4. MaLiang-Harness
Titel der Arbeit:
MaLiang-Harness: A Programmable Path to Image and Video Generation
Arbeit und detaillierte Erläuterung:
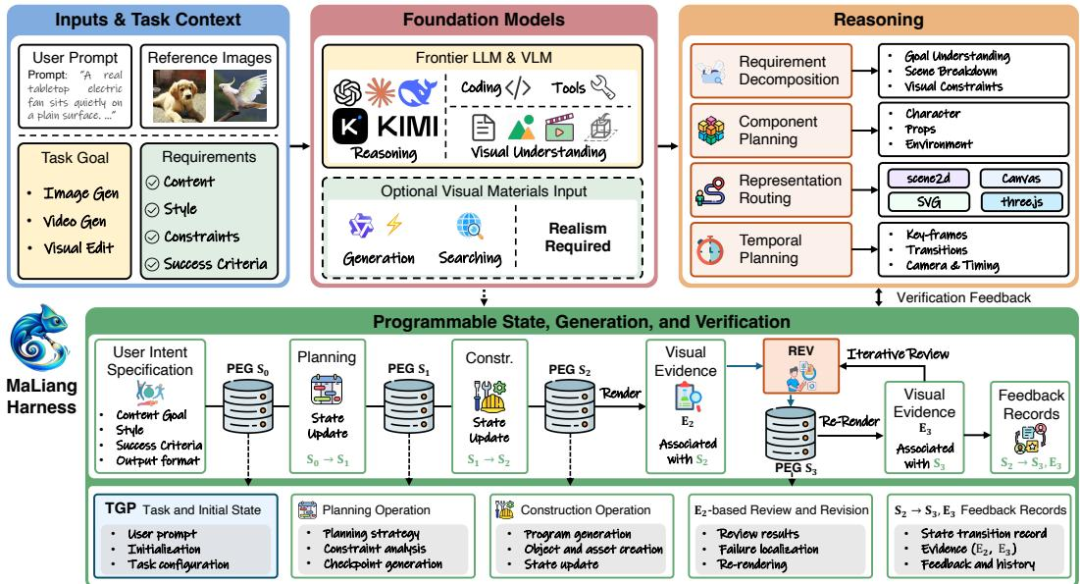
Die Forscher schlagen MaLiang-Harness vor, um zu erforschen, wie sich die Design-Prinzipien von Harness auf den Bereich der Bild- und Video-Generierung erweitern lassen. Traditionelle prozedurale Generierungsmethoden bieten zwar klare Kompositions- und Animationskontrolle, doch bedeutet der erfolgreiche Ablauf eines Programms nicht, dass das endgültige visuelle Ergebnis den Erwartungen des Benutzers entspricht. Um dieses Problem zu lösen, organisiert das Framework die durch multimodale große Sprachmodelle gesteuerte visuelle Generierung als einen kontinuierlichen Prozess aus Aufbau, Überprüfung und Überarbeitung. Durch die Speicherung ausführbarer Programme und Task-Kontexte, die Nachverfolgung von Bearbeitungshistorie und Rendering-Evidenz sowie die Validierung der aktuellen Version wird der visuelle Generierungsprozess nachvollziehbarer, wiederherstellbarer und iterativer.
Das Forschungsteam hat MaLiang-IBench und MaLiang-VBench entwickelt, um die Fähigkeiten zur Bild- bzw. Video-Generierung zu bewerten, und testet mehrere führende multimodale große Sprachmodelle. Die Ergebnisse zeigen, dass GPT-6-Astra auf beiden Benchmarks eine Erfolgsrate von 100 % bei der Generierung erreicht, wobei jedoch nur 96,0 % der Bildaufgaben und 76,9 % der Videoaufgaben alle Schwellenwerte für die visuelle Qualität erfüllen. Dies deutet darauf hin, dass der erfolgreiche Programmablauf und die Erfüllung der visuellen Qualitätsstandards weiterhin unterschiedliche Bewertungskriterien sind; ähnlich hohe allgemeine Fähigkeitswerte der Modelle bedeuten nicht, dass sie bei visuellen Generierungsaufgaben die gleiche Leistung erbringen. Diese Studie bietet ein systematisches Ausführungs-Framework für programmierbare visuelle Generierung und erweitert den Anwendungsbereich von Harness in Szenarien der generativen KI.
5. EvoSafeHarness
Titel der Arbeit:
EvoSafeHarness:Evolving Model- and Domain-Specific Harnesses for Securing Agents
Arbeit und detaillierte Erläuterung:
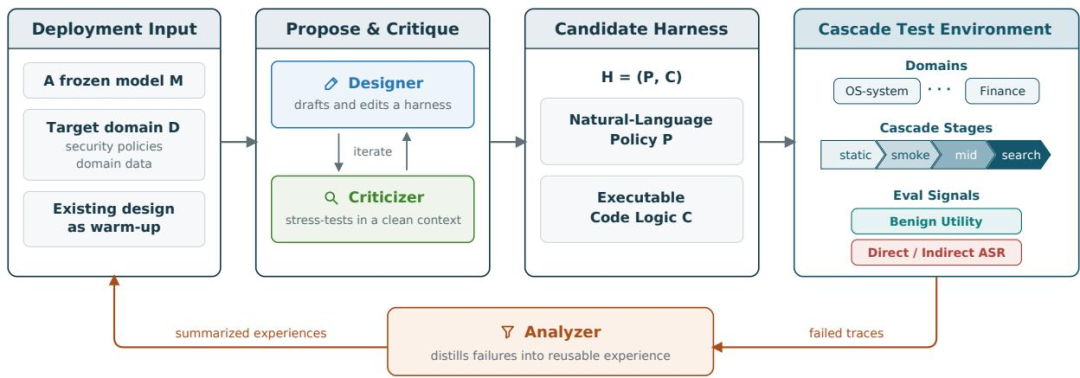
Die Forscher schlagen EvoSafeHarness vor, um die Frage der Sicherheitsabsicherung von Agenten zu lösen, die direkten schädlichen Anfragen und indirekten Prompt-Injection-Angriffen ausgesetzt sind. Traditionelle Sicherheitsbeschränkungen werden in der Regel von Experten vorab entworfen und auf verschiedene Modelle und Aufgabenbereiche angewendet. Da sich jedoch die Verhaltensmerkmale verschiedener Modelle und die Risikokriterien verschiedener Domänen unterscheiden, können starre Regeln normale Aufgaben übermäßig einschränken oder spezifische Sicherheitsrisiken in bestimmten Szenarien übersehen. EvoSafeHarness wandelt den Entwurf von Sicherheitsbeschränkungen in einen optimierbaren Prozess um, bei dem natürliche Sprach-Sicherheitsrichtlinien und ausführbare Code-Logik gemeinsam angepasst werden. Unter Einbeziehung des Verhaltens-Feedbacks des Zielmodells, domänenspezifischer Normen und adversarialer Prüfungen werden Beschränkungs-Suiten generiert, die besser für die jeweilige Bereitstellungsumgebung geeignet sind.
Das Forschungsteam führte Bewertungen auf mehreren Benchmarks für die Sicherheit von Agenten durch. In den entsprechenden Testkonfigurationen von DecodingTrust-Agent senkte die Methode die durchschnittliche Angriffserfolgsrate von 45,6 % auf 10,0 %, wobei der Nutzenverlust etwa 3,3 Prozentpunkte betrug; unter den spezifischen Bewertungskonfigurationen von AgentDojo sank die Angriffserfolgsrate auf 0,0 %, während die Nutzenbewertung für normale Aufgaben 82,8 % erreichte. Diese Ergebnisse zeigen, dass maßgeschneiderte Sicherheitsmechanismen, die auf Modelle und Domänen zugeschnitten sind, das Gleichgewicht zwischen Sicherheit und Aufgabennutzen verbessern können. Die Sicherheitsleistung hängt jedoch weiterhin von der Art der Angriffe, der Aufgabe-Umgebung und dem Bewertungsumfang ab. Diese Arbeit erweitert die Rolle des Harness von der reinen Task-Ausführung hin zur Risikokontrolle und erkundet, wie Agenten bei der Erfüllung von Aufgaben gleichzeitig entsprechende Sicherheitsgrenzen einhalten können.
6. Doc 2 Harness
Papiertitel:
Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
Papier und detaillierte Erläuterungen:
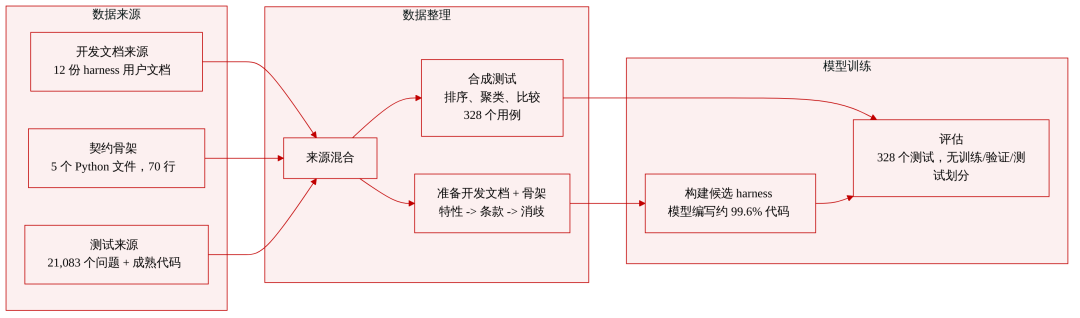
Forscher haben Doc2Harness vorgeschlagen, um die Fähigkeit großer Sprachmodelle (LLMs), vollständige Agent-Harnesses zu konstruieren, direkt zu bewerten. Frühere Studien testeten die Aufgabenleistung von Agenten in der Regel in vorab entworfenen Betriebsframeworks, prüften jedoch selten, ob Modelle in der Lage sind, basierend auf Entwicklungsdokumentation und Schnittstellenverträgen eigenständig wirklich lauffähige Ausführungsframeworks zu erstellen. Doc2Harness gestaltet die Bewertung in zwei Phasen: Zunächst generiert das Modell basierend auf Schnittstellenverträgen und Entwicklungsdokumentation Kandidaten-Harnesses; anschließend führt das Forschungsteam das Framework in einer isolierten Umgebung aus und überprüft anhand beobachtbarer Informationen wie Modellabfragen, Dateien auf der Festplatte, Prozess-Exit-Codes und Befehlausgaben, ob das tatsächliche Verhalten den Anforderungen entspricht.
Das Forschungsteam nutzte diesen Benchmark, um 19 führende Modelle zu bewerten, wobei jedes Modell drei unabhängige Konstruktionen für 328 Testfälle durchführte. Die Ergebnisse zeigen, dass das beste Modell, GPT-6 Astra, eine Bestehensrate von 53,05 % erreichte, während das schwächste Modell bei 27,44 % lag; selbst das beste Modell bestand fast die Hälfte der Testfälle nicht. Die Misserfolge konzentrierten sich hauptsächlich auf Funktionen, die die Implementierung über mehrere Module hinweg erfordern, sowie auf die Aufgabenteilung zwischen verschiedenen Modulen. Die Studie zeigt, dass die Fähigkeit eines Modells, Code zu generieren, nicht bedeutet, dass es bereits über die vollständige ingenieurtechnische Kompetenz verfügt, komplexe Ausführungsinfrastrukturen zu erstellen. Doc2Harness bietet einen deterministischen Bewertungsbenchmark zur Messung der Fähigkeiten im Langzeit-Harness-Engineering und dient als Referenz für zukünftige Verbesserungen der automatischen Konstruktionsfähigkeit von Agenten-Frameworks.
7. Harness²
Papiertitel:
Harness²:Recursive Agent Harnessing for an Open World
Papier und detaillierte Erläuterungen:
Wenn Agenten auf sich ständig ändernde, schwer vorab definierbare reale Aufgaben treffen, können sich herkömmliche Harnesses, die auf manueller Gestaltung und festen Konfigurationen basieren, oft nicht rechtzeitig anpassen. Um dieses Problem anzugehen, schlägt die Studie Harness² vor und versucht, Agenten dazu zu befähigen, nicht nur Aufgaben zu erfüllen, sondern auch ihr eigenes Ausführungsframework während des Prozesses kontinuierlich zu verbessern. Dieser Ansatz erstellt zwei miteinander verbundene rekursive Ebenen: Die aufgabenbezogene Rekursion schlägt über den Propose–Probe–Compose-Prozess Änderungen am aktuellen Framework vor, führt Vergleichstests durch und entscheidet basierend auf den tatsächlichen Ausführungsverläufen und den Aufgabenergebnissen über deren Annahme; die frameworkbezogene Rekursion extrahiert aus diesen Änderungen wiederverwendbare Erfahrungen und aktualisiert schrittweise die Methode für die spätere Framework-Optimierung. Selbst wenn keine Standardantworten vorliegen, die die Korrektheit der Aufgabe direkt bestimmen können, kann das System die Grundlage für Framework-Anpassungen liefern, indem es die Ausführungsleistung unter verschiedenen Konfigurationen vergleicht.
Das Forschungsteam führte Bewertungen auf drei spezialisierten Benchmarks und vier Modell-Framework-Konfigurationen durch. Die Experimente zeigen, dass einzelne Framework-Verbesserungen die Leistung von GLM-5 und Gemini 3.5 Flash auf mehreren Benchmarks steigern können: eine maximale Verbesserung von 11,5 Punkten auf WorkBuddy-Bench, 4,5 Punkten auf JobBench und 11,8 Prozentpunkten auf LAB; mit zunehmendem Budget für die aufgabenbezogene Rekursion kann die Leistungssteigerung noch weiter ausgebaut werden. Die Bedeutung von Harness² liegt darin, dass es versucht, die Verbindung zwischen „Erfüllung der aktuellen Aufgabe“ und „Sammeln von Erfahrungen zur Verbesserung zukünftiger Aufgaben“ herzustellen, sodass Harnesses von einmaligen Konfigurationen allmählich zu Ausführungssystemen werden, die sich kontinuierlich an neue Aufgaben anpassen können, und bietet einen neuen Ansatz für die Selbstverbesserung von Agenten in offenen Umgebungen.
8. Self-Evolving Agent Harness
Papiertitel:
Self-Evolving Agent Harness
Papier und detaillierte Erläuterungen:
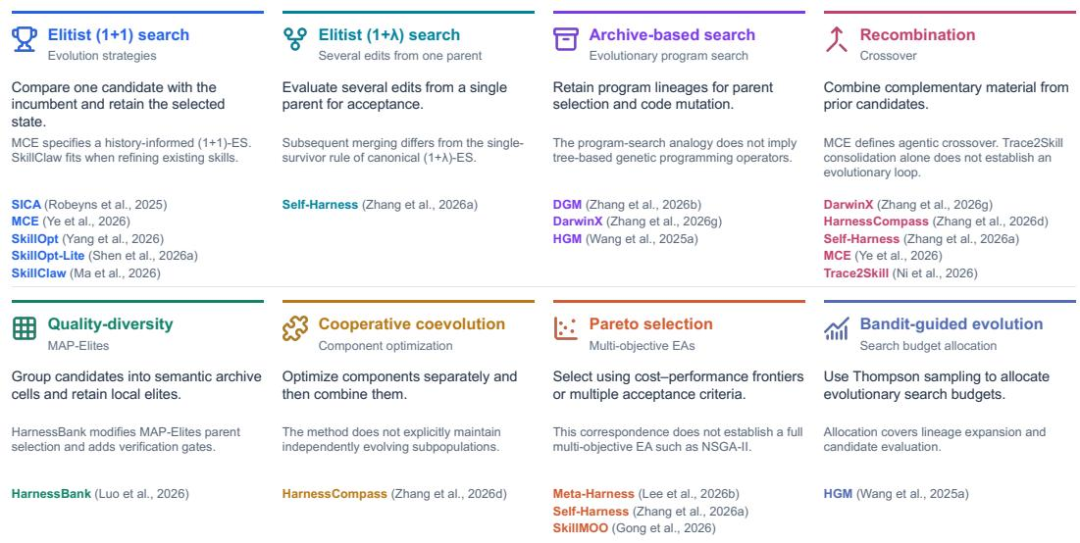
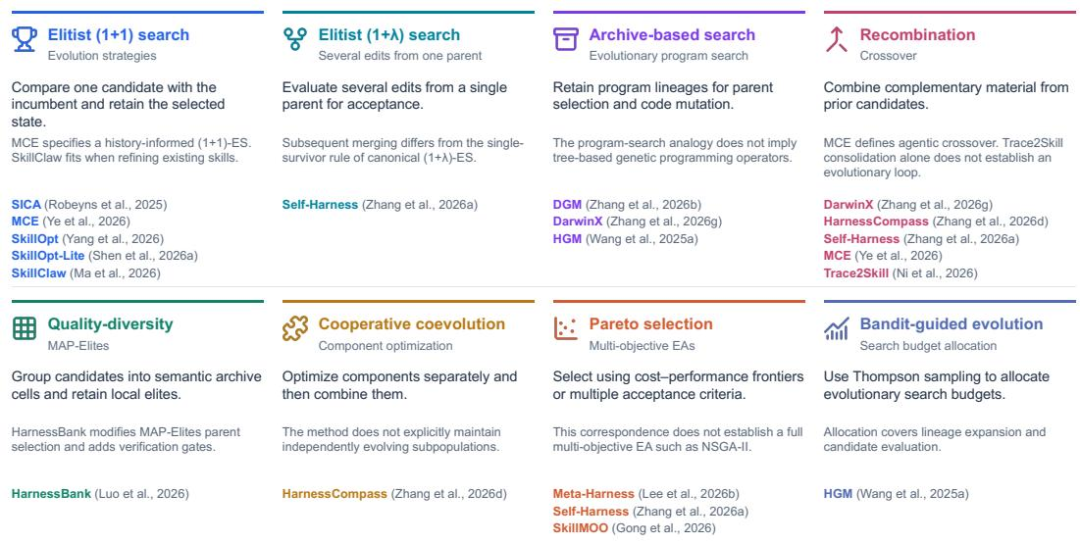
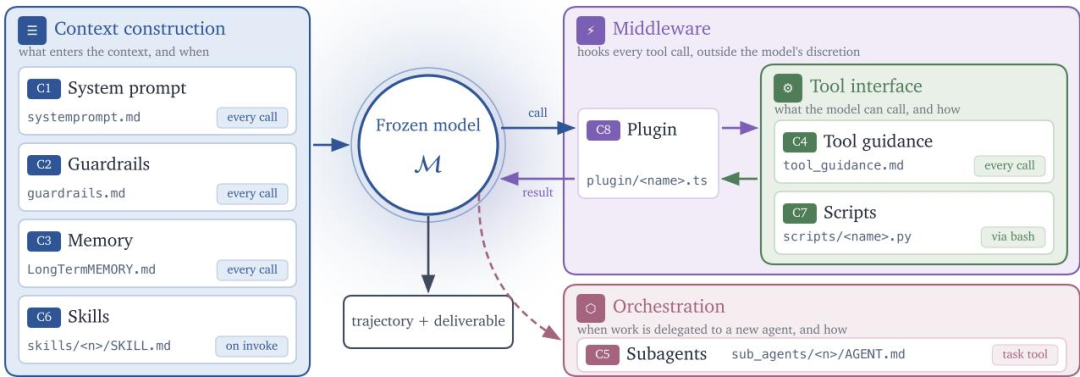
Wenn sich die vorangegangenen Studien auf die Gestaltung von Harnesses, die Steuerung von Aktionen oder die rekursive Optimierung der Task-Performance konzentrierten, stellt diese Studie eine noch umfassendere Frage: Kann ein Harness einen Mechanismus zur kontinuierlichen Selbstaktualisierung bilden, wenn Agenten über einen langen Zeitraum laufen müssen? Die Studie definiert „Selbstevolution“ als einen durch Feedback gesteuerten kontinuierlichen Revisionsprozess: Ohne die Gewichte des zugrunde liegenden Modells zu verändern, kann das System Prompts, Speicher, Workflows und ausführbare Komponenten auf der Grundlage von Ausführungserfahrungen anpassen und die akzeptierten Änderungen für zukünftige Läufe beibehalten. Die anpassbaren Objekte umfassen nicht nur einzelne Module, sondern auch Tools und Code, repository-weite Steuerungslogiken sowie die Kombinationsbeziehungen zwischen verschiedenen Plugins und Komponenten. Gleichzeitig betont die Studie, dass das Vorschlagen von Änderungen, die Beurteilung ihrer Wirksamkeit und die Entscheidung über ihre formale Übernahme drei separate Schritte sind, die nicht allein auf der Grundlage einer verbesserten Task-Performance als langfristig wertvoll eingestuft werden dürfen.
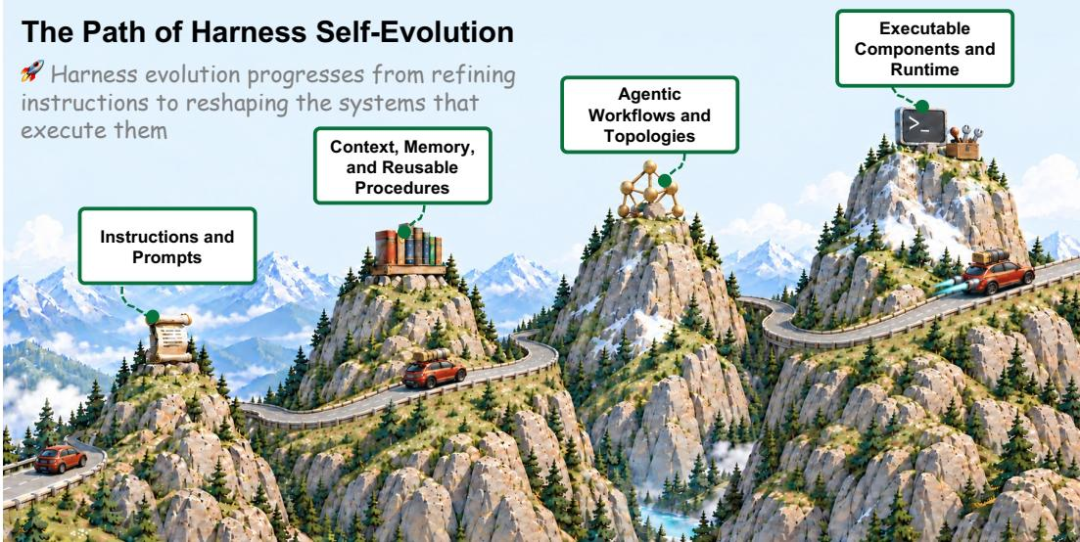
Auf theoretischer Ebene kombiniert das Paper evolutionäre Optimierung und kontinuierliches PAC-Lernen, um die Probleme der Generalisierung und der Leistungsverschlechterung zu analysieren, die bei der kontinuierlichen Aktualisierung von Harnesses auftreten können. Unter klar definierten Annahmen werden erwartete Generalisierungsgrenzen, Aufbewahrungsgrenzen im Zusammenhang mit historischen Regressionsbudgets sowie Zulassungsregeln für Kandidatenänderungen auf Basis neuer, unabhängiger Validierungsdaten diskutiert. Im Gegensatz zu bloßen Vergleichen der Punktzahlen auf bestimmten Benchmarks konzentriert sich diese Studie darauf, wie ein Harness wirksame Erfahrungen über wiederholte Iterationen hinweg bewahren und gleichzeitig Überanpassung, Vergessen und die Verschlechterung der Leistung bei früheren Aufgaben reduzieren kann. Das Paper erörtert zudem Fragen zur Änderung der Aufgabenverteilung, zu Verzerrungen bei den Auswertungsmethoden sowie zu Implementierungsaspekten wie wissenschaftlicher Zuverlässigkeit, physischer Sicherheit und organisatorischer Rechenschaftspflicht, und weist darauf hin, dass kontinuierliche Validierung und unabhängige Sicherheitsvorkehrungen weiterhin unerlässlich sind. Die skizzierte Richtung ist, dass ein Harness nicht mehr nur eine statische Softwarestruktur um ein Modell herum ist, sondern zu einem System werden kann, das Feedback akkumuliert, vorsichtige Änderungen an sich selbst vornimmt und sich kontinuierlichen Prüfungen unterzieht.