Command Palette
Search for a command to run...
TimesFM 3.0 Ermöglicht Zero-Shot-Prognosen Für Zeitreihen Und Deckt Analyseanforderungen in Mehreren Szenarien Ab; VLX-Seek Integriert Zielortung Und Feinkörniges Verständnis Und Erweitert Die Verkörperte Visuelle Wahrnehmungsfähigkeit.
VLX-Seek ist ein von OmAI Lab im Juli 2026 veröffentlichtes visuell-sprachliches Modell mit feinkörniger Wahrnehmung, das für verkörperte visuelle Anwendungen auf Edge-Geräten wie Robotern und Drohnen entwickelt wurde. Angesichts des Problems, dass in praktischen Aufgaben schwer zu bestimmen ist, auf welches Objekt sich eine Anweisung genau bezieht, kombiniert dieses Modell Sprachverständnis mit regionsbezogener visueller Wahrnehmung. Es unterstützt das Auffinden von Objekten anhand von Zielmerkmalen und Referenzbeziehungen und führt rund um die ausgewählte Region Texterkennung, Inhaltsbeschreibung und Zählung durch. Darüber hinaus führt das Modell einen Ablehnungsmechanismus für den Fall ein, dass das Zielobjekt fehlt, was eine Grundlage für nachfolgende Such- und Aufgabenanpassungen bietet. VLX-Seek verlagert den Anwendungsschwerpunkt visueller Modelle weiter auf die Identifikation und Interaktion mit konkreten Objekten und bietet grundlegende Fähigkeiten, um verkörperte intelligente Systeme mit der Verbindung von Umgebungswahrnehmung und Handlungsentscheidung zu unterstützen.
Derzeit ist auf der HyperAI-Website bereits „VLX-Seek: Feinkörniges Wahrnehmungs-Vision-Language-Modell" online verfügbar – probieren Sie es doch gleich aus~
Online-Nutzung: https://go.hyper.ai/oeM9
18. September – 24. September, Übersicht der Updates auf hyper.ai:
-
Hochwertige öffentliche Datensätze: 5
-
Ausgewählte hochwertige Tutorials: 8
-
Beliebte Enzyklopädie-Einträge: 5
-
Top-Konferenzen mit Abgabefrist im Oktober: 5
Website besuchen: hyper.ai
Ausgewählte öffentliche Datensätze
1. GooseReason-0.7M – Datensatz für verifizierbares Reinforcement-Learning-Reasoning
GooseReason-0.7M ist ein von NVIDIA im Jahr 2026 veröffentlichter groß angelegter Datensatz für verifizierbares Reinforcement-Learning-Reasoning (RLVR), der darauf abzielt, den Engpass knapper verifizierbarer Trainingsdaten zu lösen. Über die Golden-Goose-Pipeline werden unbegrenzt RLVR-Aufgaben aus umfangreichen, reasoning-bezogenen Internettexten synthetisiert. Der Datensatz umfasst mehr als 700.000 Aufgaben aus den Bereichen Mathematik, Programmierung und allgemeine Naturwissenschaften und erreicht eine Datengröße von 0,7 M. Er wird hauptsächlich zum Training des Modells GooseReason-4B-Instruct verwendet, das in 15 Benchmarks aus Mathematik, Programmierung, STEM-Reasoning, Anweisungsbefolgung und Logikrätseln neue Spitzenergebnisse auf 4B-Modellniveau erzielt hat.
Online-Nutzung: https://go.hyper.ai/eQ6X7
2. GR1-100 – Datensatz für Roboter-Manipulationsdemonstrationen
GR1-100 ist ein von NVIDIA im Jahr 2025 veröffentlichter Datensatz für Roboter-Manipulationen, der 92 Videoclips enthält und darauf abzielt, hochwertige Videodaten für das Robotertraining bereitzustellen. Die Daten liegen im MP4-Format vor und haben eine Gesamtgröße von etwa 142,3 MB. Sie eignen sich für die Forschung in den Bereichen Computer Vision und Roboterlernen. Der Datensatz dokumentiert hauptsächlich Videos aus der Third-Person-Perspektive, in denen ein Fourier-Roboter namens GR1-T2 in einer Laborumgebung verschiedene Aufgaben ausführt.
Online-Nutzung: https://go.hyper.ai/BulTI
3. GraspGen: Scaling Sim2Real Grasping – Datensatz zur Greifbewegungsgenerierung
GraspGen: Scaling Sim2Real Grasping ist ein von NVIDIA im Jahr 2025 veröffentlichter groß angelegter simulierter Greifdatensatz. Er enthält mehr als 57 Millionen Greifdaten, die auf Basis von 8.515 Objekten aus dem Objaverse-XL-(LVIS)-Datensatz generiert wurden und speziell für den Franka Panda, den Industriegreifer Robotiq-2f-140 und einen Einpunktkontakt-Sauggreifer (30 mm Radius) entwickelt wurden. Ziel ist es, durch groß angelegte Simulationsdaten die Übertragungsfähigkeit von Roboter-Greiffähigkeiten von der Simulation in die Realität zu verbessern. Der Datensatz liegt im WebDataset-Format vor und umfasst insgesamt mehr als 57 Millionen simulierte Greifdaten mit drei verschiedenen Roboter-Greifertypen. Er eignet sich für Forschung in den Bereichen Robotergreifen, Simulation-zu-Realität-Transfer (Sim2Real) und Roboterlernen.
Online-Nutzung: https://go.hyper.ai/81LdN
4. LiveCodeBench-CPP – Evaluierungsdatensatz für Codegenerierung
LiveCodeBench-CPP ist ein von NVIDIA im Jahr 2025 veröffentlichter Evaluierungsdatensatz für die C++-Codegenerierung, der großen Sprachmodellen eine Benchmark zur Bewertung der Codegenerierungs- und Debugging-Fähigkeiten auf Basis aktueller Programmieraufgaben bieten soll. Der Datensatz enthält 454 Programmieraufgaben, die hauptsächlich von AtCoder (287 Aufgaben) und LeetCode (167 Aufgaben) stammen und den Zeitraum von Oktober 2024 bis Mai 2025 abdecken. Die Daten umfassen Aufgabenbeschreibungen, Plattformquellen, Schwierigkeitsgrade, Testfälle und zugehörige Metadaten und dienen hauptsächlich der Bewertung der Codegenerierungs- und Problemlösungsfähigkeiten von Modellen in realen Programmieraufgaben.
Online-Nutzung: https://go.hyper.ai/YdSXz
5. HelpSteer – Datensatz für hilfreiche Ausrichtung
HelpSteer ist ein von NVIDIA im Jahr 2023 veröffentlichter Datensatz zur Ausrichtung großer Sprachmodelle. Er zielt darauf ab, die Hilfreichkeit, Korrektheit und Kohärenz von Modellantworten zu verbessern und unterstützt die Anpassung von Komplexität und Detailgrad der Antworten. Der Datensatz enthält 37.120 Stichproben, die verschiedene Aufgabentypen wie Umschreiben, Zusammenfassen, Klassifizieren, Extrahieren und Frage-Antwort abdecken. Jede Stichprobe enthält einen Prompt, eine Modellantwort sowie fünf von Menschen annotierte Attributbewertungen für Hilfreichkeit, Korrektheit, Kohärenz, Komplexität und Detailgrad, wobei die Bewertungsskala von 0 bis 4 reicht. Die Daten wurden von Scale AI annotiert und werden hauptsächlich für das Training, die Evaluierung und die Ausrichtungsforschung großer Sprachmodelle verwendet.
Online-Nutzung: https://go.hyper.ai/B5OPS
Ausgewählte öffentliche Tutorials
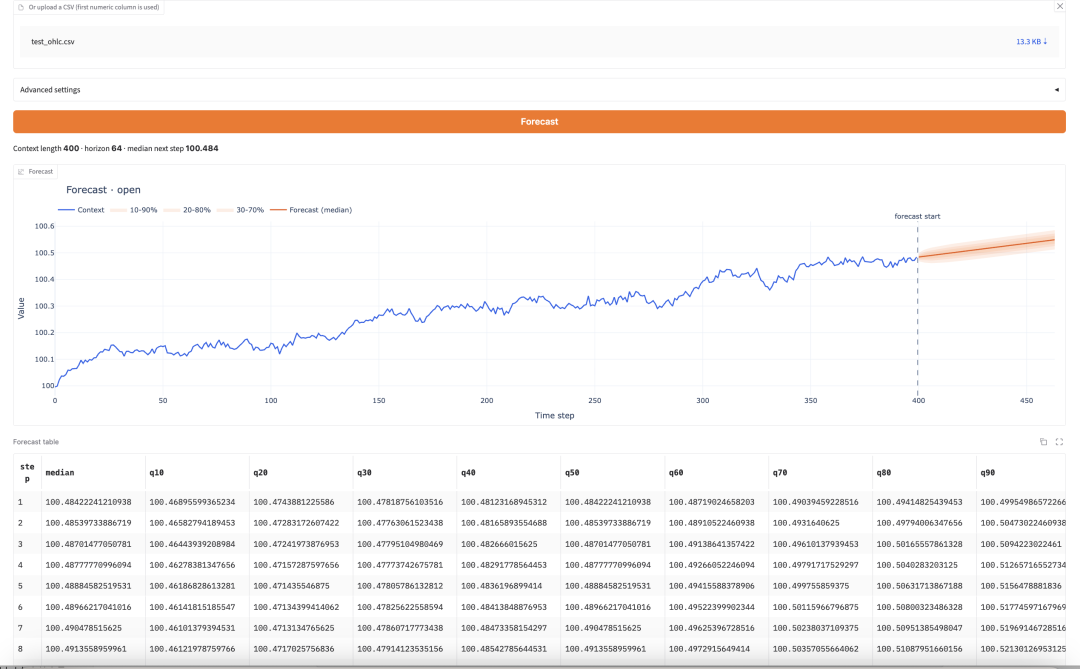
1. TimesFM 3.0: Zero-Shot-Zeitreihenprognose
TimesFM 3.0 ist ein von Google Research im August 2026 veröffentlichtes Zeitreihen-Basismodell, das vortrainierte Zero-Shot-Prognosen verwendet und neue Zeitreihen ohne aufgabenspezifisches Feintuning vorhersagen kann. Das Modell unterstützt nativ univariate, multivariate und Kovariaten-Eingaben und stärkt die Zero-Shot-Generalisierungsfähigkeit. Es eignet sich für Zeitreihenanalysen in Bereichen wie Einzelhandelsumsatz, Finanzanalyse, Wetter- und Energiebedarf sowie Lieferkettenprognose.
Online ausführen: https://go.hyper.ai/DRk3i
Demo-Seite
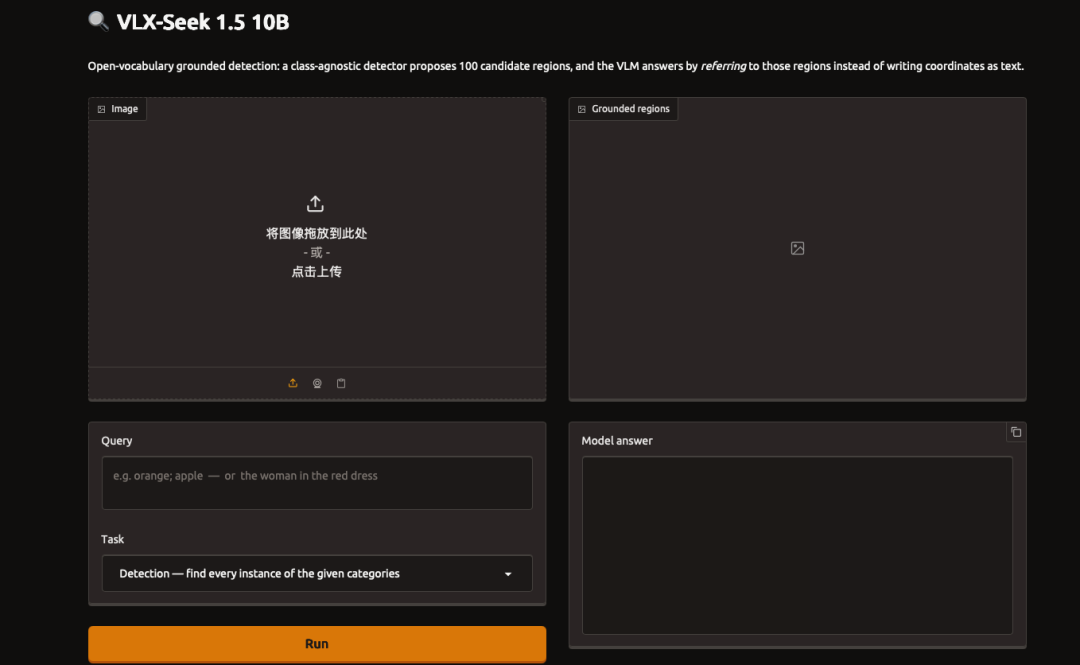
2. VLX-Seek: Fein granuläres visuell-sprachliches Modell
VLX-Seek ist ein von OmAI Lab im Juli 2026 veröffentlichtes fein granuläres visuell-sprachliches Modell (VLM) für eingebettete verkörperte visuelle Szenarien. Es kann Objektlokalisierung, Instanzunterscheidung und fein granulare visuelle Wahrnehmung durchführen, während es Bildinhalte versteht. Das Modell unterstützt Objekterkennung, referenzielle Ausdrucksverständnis, Regionsbeschreibung, Regions-OCR, Zählung und Inferenzerkennung. Über einen Open-Vocabulary-Ablehnungsmechanismus wird bei nicht vorhandenen Objekten „None“ ausgegeben. Es eignet sich für verkörperte intelligente Szenarien wie Roboter und Drohnen.
Online ausführen: https://go.hyper.ai/oeM92
Demo-Seite
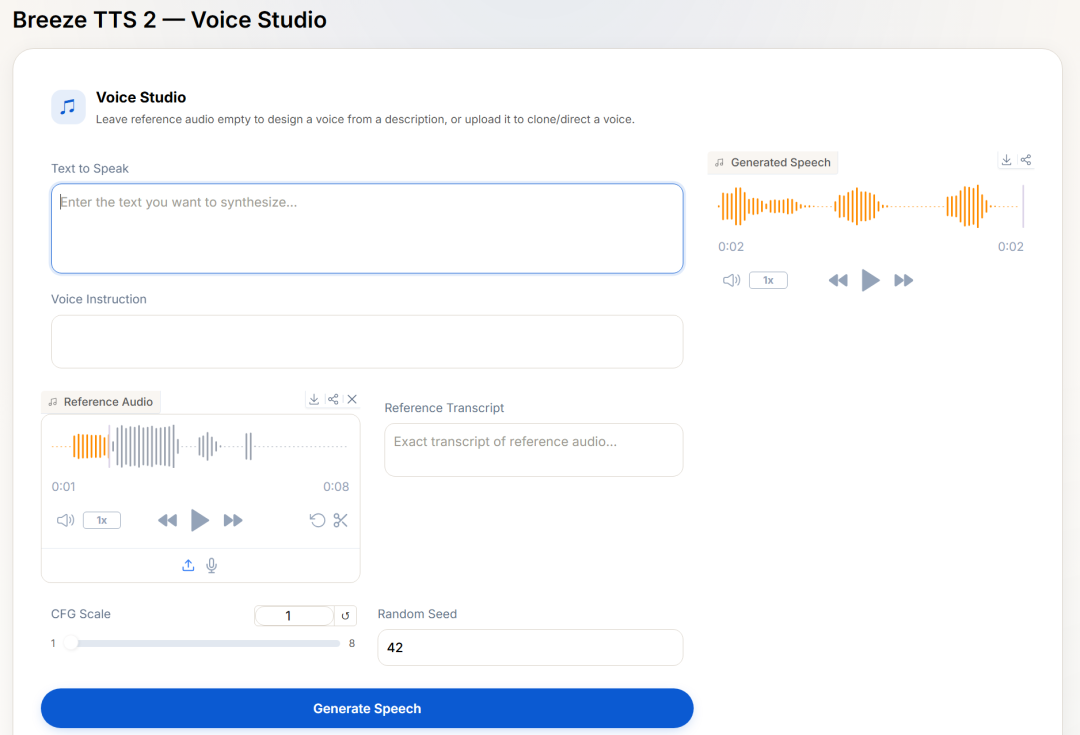
3. Breeze TTS 2 – Open-Source-Text-to-Speech-Modell in Echtzeit
Breeze TTS 2 ist ein von BreezeBlue im August 2026 veröffentlichtes Text-to-Speech-Modell mit offenen Gewichten für Echtzeit-Sprachinteraktion. Es unterstützt Sounddesign, Stimmklonierung und Emotionssteuerung über natürliche Sprache. Das Modell unterstützt Chinesisch und Englisch, kann Tonfall, Sprechgeschwindigkeit und Emotionen über Textbefehle anpassen und unterstützt Soundereignisse wie Lachen und Seufzen sowie Streaming-Generierung mit extrem geringer Latenz. Es eignet sich für Echtzeit-Sprachassistenten, Audioinhalte, Lokalisierung von Synchronisationen und Barrierefreiheitsdienste.
Online ausführen: https://go.hyper.ai/JStch
Demo-Seite
4. Einführungstutorial zur statistischen Lernmethode
Dieses Tutorial wurde 2018 vom Kaggle-Nutzer DATAI veröffentlicht. Am Beispiel des Breast Cancer Wisconsin Diagnostic Dataset werden Grundlagen der statistischen Lernmethode und gängige Analysemethoden von Grund auf erklärt. Das Tutorial umfasst Datenexploration und -visualisierung, deskriptive Statistik wie Mittelwert und Varianz, kumulative Verteilungsfunktionen, Effektstärke und Korrelation, Hypothesentests und p-Werte sowie Normalverteilung und Z-Score-Berechnung. Es eignet sich für Anfänger der statistischen Lernmethode.
Online ausführen: https://go.hyper.ai/fVzMx
5. EfficientDet-Trainingstutorial: Objekterkennung von Weizenähren
Dieses Tutorial basiert auf dem von Alex Shonenkov für den Kaggle Global Wheat Detection-Wettbewerb erstellten Trainingsablauf und übt das EfficientDet-Objekterkennungsmodell von Grund auf. Das Tutorial umfasst Umgebungskonfiguration und GPU-Überprüfung, Laden des Wettbewerbsdatensatzes, Albumentations-Datenaugmentierung, Erstellung des EfficientDet-D5-Modells und den vollständigen Trainingsablauf. Es eignet sich für Entwickler, die Training und praktische Anwendung von Objekterkennungsmodellen erlernen möchten.
Online ausführen: https://go.hyper.ai/AtDMM
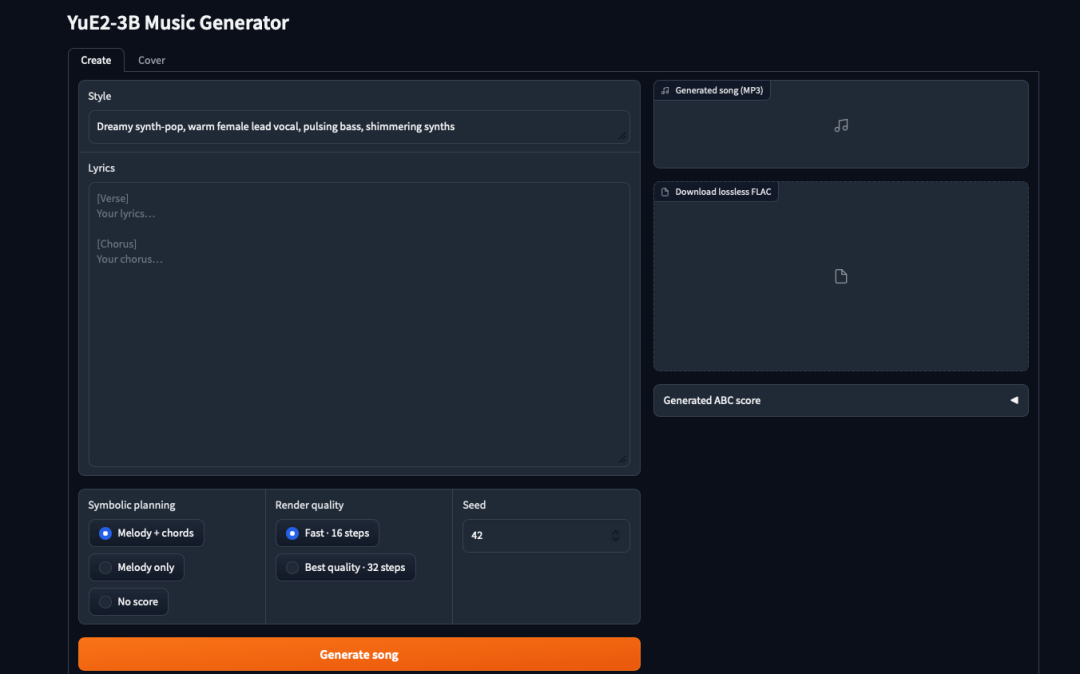
6. YuE2-3B: Modernes Open-Source-Musikgenerierungsmodell
YuE2-3B ist ein von Multimodal Art Projection (m-a-p) im Jahr 2026 veröffentlichtes Open-Source-Musikgenerierungsmodell, das basierend auf Liedtexten und Stilhinweisen vollständige Songs mit Gesang und Begleitung generieren kann. Das Modell verwendet eine AR–NAR Mixture-of-Transformers-Architektur, unterstützt drei Modi: Melodie und Akkorde, nur Melodie sowie direkte Generierung, und unterstützt 48-kHz-Stereoaustgabe. Es eignet sich für Szenarien wie Text-zu-Musik, Song-Cover und intelligente Musikbearbeitung.
Online ausführen: https://go.hyper.ai/t4G7M
Demo-Seite
7. FFmpeg-Videoplayer-Entwicklungstutorial: Von der Bildaufnahme zur Sprungnavigation
Diese Tutorialreihe basiert auf dem klassischen Tutorial „An ffmpeg and SDL Tutorial“ von Stephen Dranger aus dem Jahr 2015 und implementiert die Kerninhalte mit Python und FFmpeg-Befehlszeilentools neu. Sie erklärt die Funktionsweise digitaler Audio- und Videotechnik von Grund auf. Das Tutorial umfasst grundlegende Konzepte wie Container, Streams, Codecs, Pakete, Frames und Zeitstempel und übt schrittweise Videosynchronisation, Audiosynchronisation und Medienadressierung durch ausführbare Experimente. Es eignet sich für alle, die Technologien rund um Player, Transkodierung, Streaming und Computer Vision erlernen möchten.
Online ausführen: https://go.hyper.ai/rtrW4
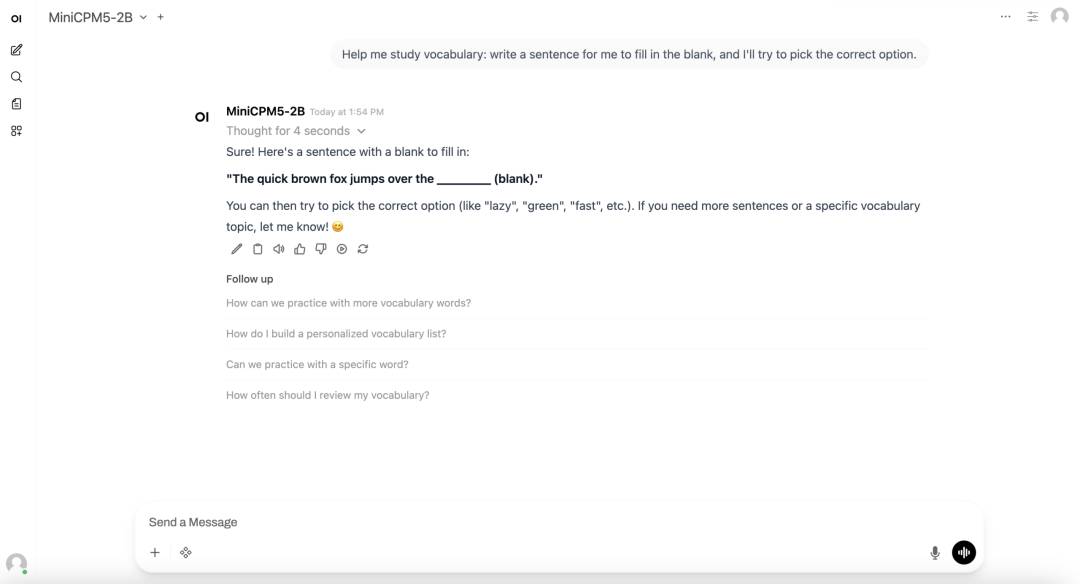
8. MiniCPM5-2B: SOTA-Inferenz großer Modelle auf Endgeräten mit 2B-Parametern
MiniCPM5-2B ist ein von OpenBMB im September 2026 veröffentlichtes Open-Source-Sprachmodell der 2B-Klasse und das zweite Modell der MiniCPM5-Serie. Es verwendet die Standard-LlamaForCausalLM-Architektur und ist für Edge-Bereitstellung, lokale Inferenz und ressourcenbeschränkte Szenarien konzipiert. Das Modell unterstützt bis zu 131K Kontext und bietet Code- und Mathematiklogik, Tool-Aufrufe sowie Agent-Fähigkeiten. Es eignet sich für lokale KI-Assistenten, Programmierhilfe, Wissensbeantwortung und Agenten-Anwendungen.
Online-Demo: https://go.hyper.ai/D8jnq
Demo-Seite
Ausgewählte beliebte Enzyklopädie-Einträge
1. Optische Zeichenerkennung OCR
2. World Action Model WAM
3. Fernerkundung Remote Sensing
4. Glitch-Token
5. Generative Pre-trained Transformer GPT
Hier sind Hunderte von KI-bezogenen Einträgen zusammengestellt, damit du hier die „Künstliche Intelligenz" verstehen kannst:
Top-Konferenzen mit Einreichungsfrist im Oktober
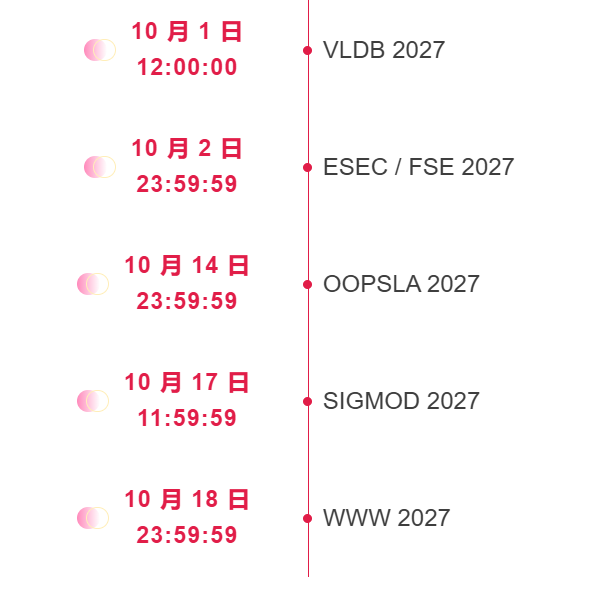
*Einreichungsfrist in AoE-Zeit
Verfolge KI-Akademikerkonferenzen auf einen Blick: https://go.hyper.ai/event
Das war alles aus der wöchentlichen Redaktionsauswahl. Wenn du Ressourcen auf der offiziellen Website von hyper.ai aufnehmen möchtest, kannst du uns gerne einen Kommentar hinterlassen oder uns eine Nachricht senden!
Bis nächste Woche!