Command Palette
Search for a command to run...
3600万 خلية في نفس المساحة، جامعة ستانفورد تقدم نموذج التضمين الخلوي العام UCE، بناء خريطة خلوية فائقة النطاق عبر 8 أنواع

على مدى السنوات الماضية، كرّس علم الأحياء الخلوي جهوده لوصف الأنماط الظاهرية المتنوعة التي قد تظهرها الخلايا، والعلاقات المتبادلة بين الحالات المختلفة، وكيفية انتقال الخلايا بين هذه الحالات أثناء التطور والمرض.
لقد وفّر النمو الهائل في حجم مجموعات بيانات تسلسل الحمض النووي الريبي أحادي الخلية (scRNA-seq) فرصة جديدة لإعادة النظر في هذه الأنواع من الأسئلة. ومع ذلك، لا تزال الأساليب الحسابية الحالية تواجه صعوبات عند التحليل المشترك لمجموعات البيانات شديدة التنوع هذه، وذلك لأن النماذج قد تتأثر بقيود خاصة بالأنواع، أو تشوهات خاصة بمجموعات البيانات، أو تأثيرات الدفعات. وقد تمكنت بعض الأساليب الحسابية المصممة لبيانات scRNA-seq من التغلب على بعض هذه القيود، ولكن على حساب: تتطلب كل مجموعة بيانات جديدة ضبطًا خاصًا للنموذج.
في هذا السياق، اقترح فريق بحثي من جامعة ستانفورد نموذج التضمين الخلوي الشامل (universal cell embedding، UCE). تتميز UCE بقدرة فريدة: فهي تولّد تمثيلات لمجموعات بيانات جديدة للتعبير الجيني أحادي الخلية دون الحاجة إلى ضبط دقيق أو إعادة تدريب للنموذج، مع الحفاظ في الوقت نفسه على المتانة ضد التشوهات الخاصة بمجموعات البيانات والدفعات. علاوة على ذلك، لا تتطلب UCE تعليقات توضيحية لأنواع الخلايا، ولا تتطلب معالجة مسبقة مثل فحص الجينات لمجموعة بيانات الإدخال. يمكن تطبيق UCE على أي مجموعة من الجينات المشفرة للبروتينات من أي نوع، حتى لو لم تكن هذه الجينات متجانسة مع الجينات التي شوهدت أثناء تدريب النموذج. وبهذه الطريقة، تتعلم UCE تمثيلًا شاملاً وذو معنى بيولوجي جوهري لعلم الأحياء الخلوي، مما يمكّن الباحثين من الحصول على رؤى بيولوجية تتجاوز البيانات التي يمكن ملاحظتها مباشرة من التجارب.
نُشرت النتائج ذات الصلة في مجلة Nature بعنوان «Universal cell embedding provides a foundation model for cell biology».
أبرز النقاط:
-
بالنسبة لبيانات الخلايا الجديدة، يمكن لـ UCE تعيينها في فضاء التمثيل الموحد هذا دون الحاجة إلى تعليقات توضيحية للبيانات أو إعادة تدريب النموذج أو ضبط دقيق
-
يُظهر التمثيل الذي تتعلمه UCE بنية تنظيمية ناشئة لأنواع الخلايا وحالاتها، ويتوافق مع القوانين البيولوجية المعروفة
-
تستطيع UCE تعيين البيانات الجديدة في فضاء تضمين موحد، يحتوي هذا الفضاء بالفعل على حالات مرجعية للخلايا تم شرحها
رابط البحث:
https://www.nature.com/articles/s41586-026-10689-z
بناء مجموعة بيانات تدريب IMA تضم أكثر من 36 مليون خلية
قام الفريق البحثي ببناء مجموعة بيانات تدريبية باسم Integrated Mega-scale Atlas (IMA)، لدمج بيانات تسلسل الحمض النووي الريبي أحادي الخلية من مصادر عامة مختلفة. تتضمن البيانات الأساسية لتدريب UCE أكثر من 36 مليون خلية، حيث تأتي الغالبية العظمى من هذه البيانات (إجمالي 33.9 مليون خلية، و285 مجموعة بيانات) من البشر والفئران، بينما يتكون الجزء المتبقي من 2.3 مليون خلية من 28 مجموعة بيانات، تغطي 8 أنواع مختلفة: الإنسان، والفأر، وسمك الزرد، وقرد الريسوس، وقرد المكاك طويل الذيل، وليمور الفأر، والضفدع، والخنزير.
عند تصور IMA، والتنبؤ بأنواع خلايا قرد النيل الأخضر، ومطابقة النقط الوسطى لأنواع الخلايا الجديدة، والتنبؤ بالخلايا الشبيهة بـ Norn، لم يستخدم الباحثون كامل 36 مليون خلية، بل استخدموا عينة تمثيلية من IMA، وذلك لتسريع المهام الحسابية الثقيلة مثل حسابات UMAP. تم بناء هذه العينة التمثيلية عن طريق الاختيار العشوائي لـ 10,000 خلية من كل مجموعة بيانات، مع أخذ العينات دون استبدال. بالنسبة لمجموعات البيانات التي تحتوي على أقل من 10,000 خلية، تم تضمين مجموعة البيانات بأكملها مباشرة. تحتوي العينة التمثيلية النهائية على 2,969,114 خلية، بمتوسط 9,486 خلية لكل مجموعة بيانات في العينة.
لتقييم أداء النموذج على بيانات «غير مألوفة» حقًا، استخدمت الورقة أيضًا مجموعات بيانات متعددة لم تشارك في تدريب النموذج. على سبيل المثال، يحتوي Tabula Sapiens v.2 على 581,430 خلية، و27 نوعًا من الأنسجة، و167 دفعة، و162 نوعًا خلويًا فريدًا، وهو مجموعة بيانات اختبارية مهمة للتعلم الصفري في الورقة. كما أعد الفريق البحثي بيانات لأنواع لم تظهر في مرحلة التدريب مثل قرد النيل الأخضر، والفأر عاري الخلد، والدجاج، لاختبار ما إذا كانت UCE تمتلك بالفعل قدرة على التعميم عبر الأنواع. بالإضافة إلى هذه البيانات، قامت الورقة أيضًا بتحليل بيانات كلى الفأر، وأمراض الرئة البشرية، وغيرها، للتحقق مما إذا كانت UCE قادرة على اكتشاف علاقات بيولوجية جديدة من الخرائط الخلوية الموجودة.
جميع مجموعات البيانات التي تم تحليلها في الورقة متاحة للجمهور ويمكن تنزيلها:
-
مجموعة بيانات الرئة والعقد الليمفاوية لقرد النيل الأخضر: رقم الإيداع GSE156755
-
مجموعة بيانات الفأر عاري الخلد: رقم الإيداع GSE132642
-
مجموعة بيانات شبكية الدجاج: رقم الإيداع GSE159107
-
مجموعة بيانات قلب الدجاج: رقم الإيداع GSE149457
-
مجموعة بيانات كلى الفأر: رقم الإيداع GSE193321
-
مجموعة بيانات أمراض الرئة البشرية: رقم الإيداع GSE136831
UCE: نموذج أساسي للخلايا يعتمد على المعلومات البيولوجية
تتغلب UCE على التحديات المرتبطة بدمج مجموعات بيانات scRNA-seq من خلال تجريد الخلايا كـ «أكياس من الحمض النووي الريبي (bags of RNA)».
يتم تدريب UCE بالكامل بطريقة التعلم الذاتي، دون استخدام أي تعليقات توضيحية لأنواع الخلايا أو معلومات تعتمد على مجموعات البيانات. كما هو موضح في الشكل أدناه، يقوم UCE أولاً بتحويل بيانات التعبير الجيني للحمض النووي الريبوزي (RNA) لخلية واحدة إلى عينة جينية مرجحة بمستوى التعبير، ثم يستخدم نموذج لغة البروتين لتمثيل الجينات في العينة بناءً على البروتينات التي ترمز لها هذه الجينات. وهذا يمكّن UCE من تمثيل أي جين مشفر للبروتين من أي نوع بشكل ذي معنى، استنادًا فقط إلى تسلسل البروتين، دون التقيد بما إذا كان هذا النوع موجودًا في بيانات التدريب أم لا. بعد دمج بيانات وصفية إضافية مثل موقع الكروموسوم للجين، يتم إدخال هذا التمثيل في نموذج محول (Transformer) كبير. وبهذا، يستطيع UCE تعيين الخلايا من أي نسيج أو نوع إلى فضاء عام مشترك دون الحاجة إلى تدريب إضافي.
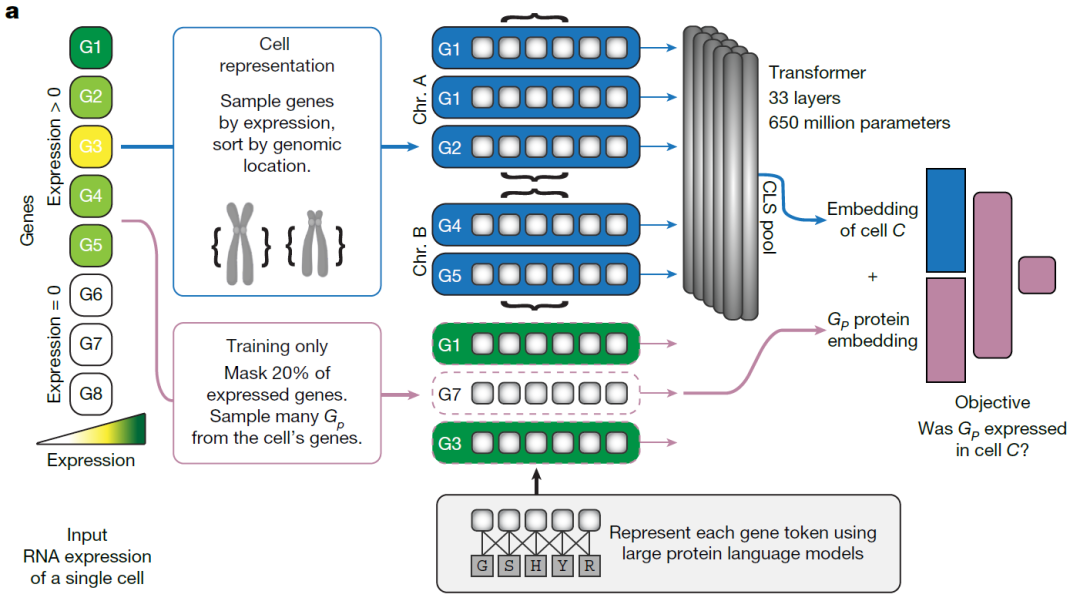
*نظرة عامة على نموذج UCE*
يتكون إدخال UCE من جزأين: (1) بيانات عد scRNA-seq؛ (2) تضمينات البروتين المقابلة للجينات في مجموعة البيانات، والتي تم إنشاؤها باستخدام نموذج لغة البروتين ESM2. يستقبل نموذج لغة البروتين ESM2 تسلسلات الأحماض الأمينية كمدخلات، ويخرج تمثيلًا رقميًا يسمى تضمين البروتين (protein embedding).
بالنسبة لبيانات عدد التعبير الجيني لخلية معينة، يقوم UCE بترجيحها وتطبيعها وفقًا لمستوى التعبير، ويقوم بأخذ عينات من الجينات في تلك الخلية مع السماح بالتكرار. يمكن أن تحتوي هذه العينة فقط على جينات ذات تعبير غير صفري، ويمكن أن يظهر الجين نفسه عدة مرات في العينة. بعد ذلك، يتم ترميز هذه الجينات (tokenized)، أي تحويلها إلى تمثيلات تضمين البروتين للبروتينات التي ترمز لها.
يتم تجميع الجينات التي تنتمي إلى نفس الكروموسوم عن طريق وضع علامات خاصة، وترتيبها وفقًا لمواقعها في الجينوم. بعد ذلك، تتم إضافة علامة خاصة تمثل الخلية بأكملها، وهي CLS token، في بداية تمثيل الخلية بالكامل. يتم إدخال التمثيل المدمج الناتج في الشبكة العصبية المحولة (Transformer)، ويتم أخذ التضمين النهائي للخلية من التضمين المقابل لـ CLS token في الطبقة الأخيرة من المحول.
النتائج: الحصول على رؤى بيولوجية تتجاوز البيانات المرصودة تجريبيًا بشكل مباشر
بناءً على UCE، قام الباحثون ببناء أطلس الخلايا فائق الضخامة المتكامل (Integrated Mega-scale Atlas)، حيث قاموا بتضمين 36 مليون خلية، بما في ذلك أكثر من 1000 نوع خلوي مُسمى بشكل فريد. بفضل هذا الفضاء الموحد، أصبح من الممكن تحليل كيفية تنظيم أنواع الخلايا والأنسجة المختلفة فيه.
يُظهر فضاء التضمين في UCE بعض القدرات الناشئة (emergent behaviour)
وجدت الدراسة أنه في فضاء UCE، تتجمع الخلايا بشكل طبيعي وفقًا للظروف البيولوجية مثل نوع الخلية، بينما يمكن للخلايا من ظروف تجريبية مختلفة، مثل الخلايا من دفعات مختلفة، أن تختلط معًا (الشكل ب أدناه). نظرًا لأن UCE استخدم فقط بيانات غير موسومة أثناء التدريب، فإن هذا التنظيم الهيكلي ليس نتيجة تدريب النموذج بشكل صريح، بل هو سلوك ناشئ للنموذج نفسه.
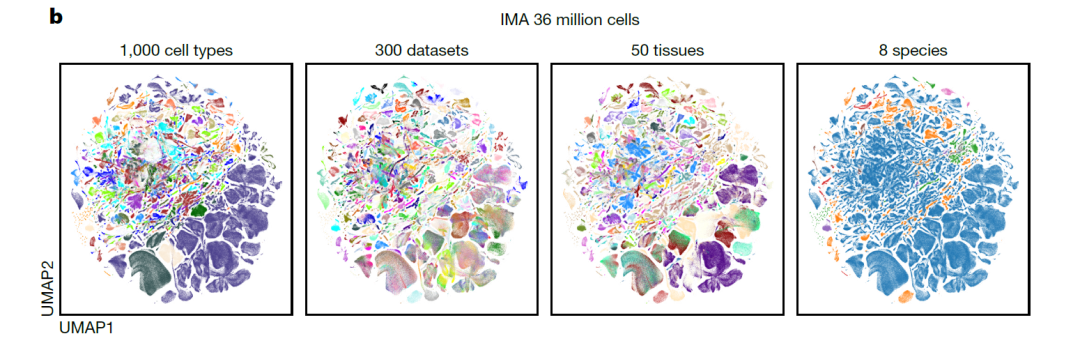
*تصور UMAP للتقريب والإسقاط الموحد للمشعب في فضاء UCE*
قام فريق البحث بفحص كيفية تأثير مصدر النسيج على حالة أنواع الخلايا المختلفة. على الرغم من أن الخلايا البلعمية (macrophages) من أنسجة مختلفة تمتلك سمات نسخية متنوعة، إلا أنها تظل متوافقة بشكل كبير في فضاء UCE. على سبيل المثال، تتوزع الخلايا البلعمية البشرية في 73 نسيجًا مختلفًا، وفي 72% منها (53 نسيجًا)، تكون أقرب خلية إلى مركز كتلة الخلايا البلعمية الخاصة بالنسيج هي مركز كتلة الخلايا البلعمية من نسيج آخر.
يمكن ملاحظة اتساق مماثل عبر الأنسجة في أنواع الخلايا الأخرى الموجودة بكثرة، مثل الخلايا البطانية والخلايا العصبية. يشير هذا إلى أن UCE قادر على تحديد الهوية الخلوية الفريدة المشتركة بين الخلايا البلعمية عبر الأنسجة المختلفة، دون الحاجة إلى تدريب صريح أو تسميات بشرية. هذا هو بالضبط التنظيم الهيكلي الناشئ لـ UCE الذي يتوافق مع القوانين البيولوجية المعروفة، على الرغم من أن النموذج لم يتم تدريبه خصيصًا على هذه الظاهرة.
التضمين الصفري لمجموعة بيانات جديدة
قام الباحثون بتقييم الأداء الصفري لـ UCE على مجموعة بيانات جديدة غير منشورة، وهي Tabula Sapiens v.2. أظهرت النتائج أن النتيجة الإجمالية لـ UCE كانت أعلى بنسبة 13.9% من أفضل نموذج Geneformer، حيث كانت نتيجة الحفاظ على المعلومات البيولوجية أعلى بنسبة 16.2%، ونتيجة تصحيح تأثير الدفعة أعلى بنسبة 10.1%. مقارنة بالطرق الأخرى، كانت التضمينات التي أنشأها UCE قادرة على التمييز بين أنواع الخلايا المختلفة بشكل أكثر وضوحًا (كما هو موضح في الشكل أدناه).
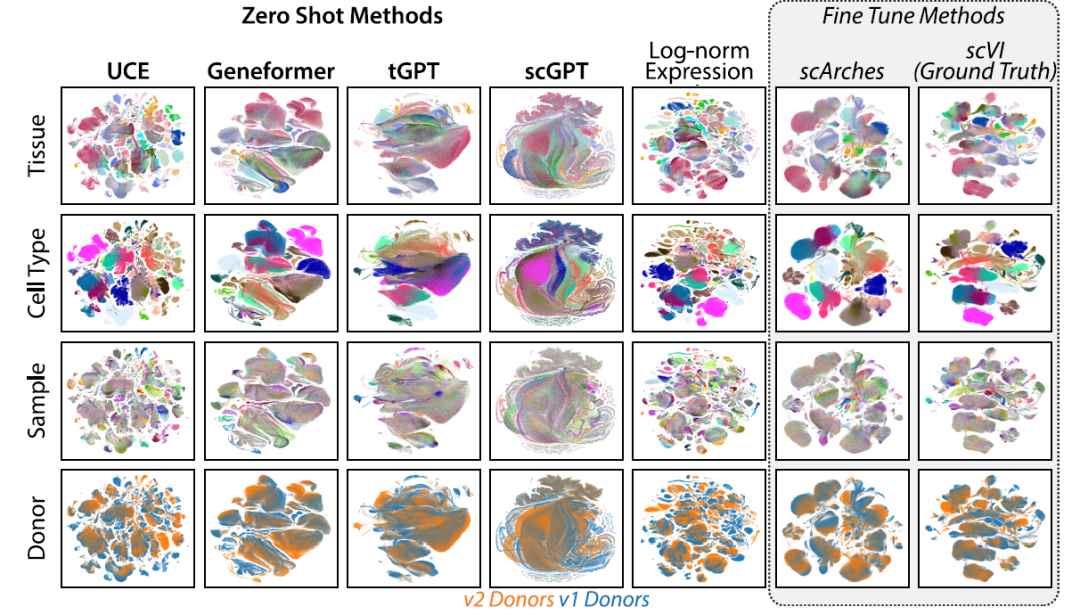
*يتفوق UCE على الطرق الحالية في دمج Tabula Sapiens v2*
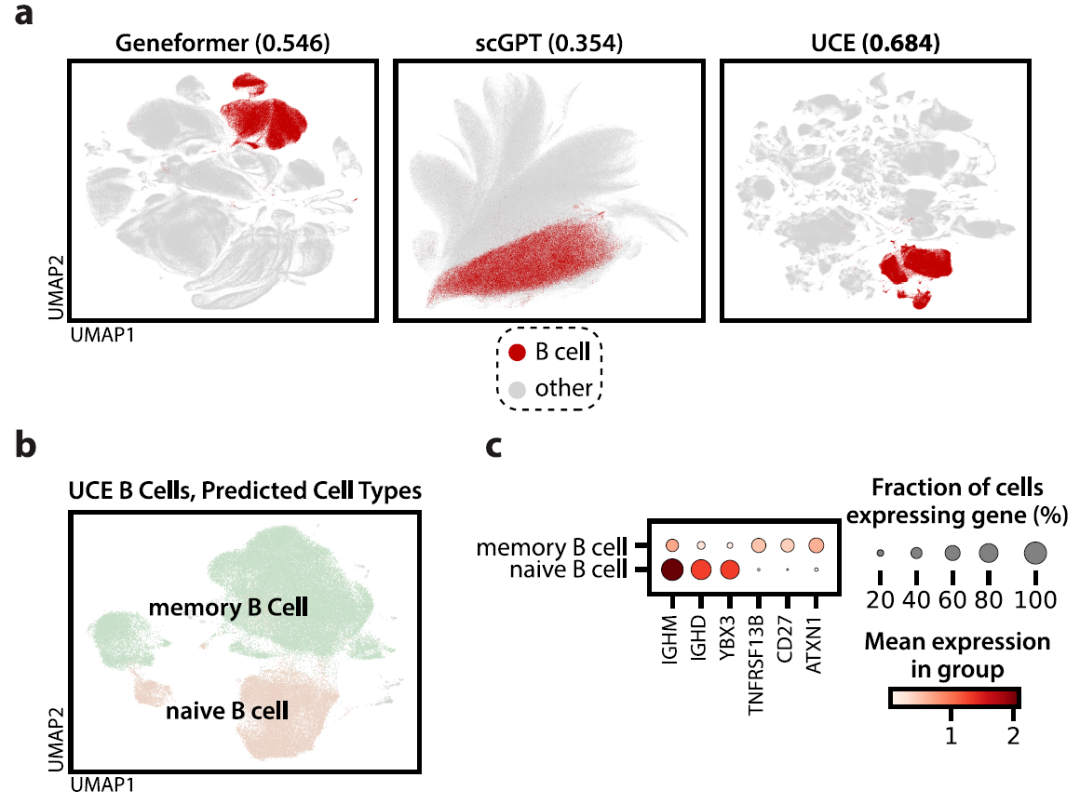
*يستطيع UCE إعادة التقاط هوية الخلايا البائية في Tabula Sapiens v2*
التضمين الصفري لأنواع جديدة
قام الباحثون بمقارنة أداء UCE مع الطرق المتقدمة الحالية لنقل التسميات عبر الأنواع، وهي SATURN وSAMap. في 3 من أصل 4 مجموعات بيانات، تفوق UCE على SATURN وSAMap في نقل تسميات أنواع الخلايا بين البشر والأنواع الأخرى. بل إن UCE قادر على توليد تمثيلات متسقة للعينات الصفرية (zero-shot embeddings) للأنواع شديدة التباعد تطوريًا، مثل ذبابة الفاكهة.
البنية التنظيمية لأنواع الخلايا في البيانات الجديدة
إلى جانب التركيز على مقاييس تقييم تجمّع أنواع الخلايا الفردية، قام فريق البحث أيضًا بفحص بنية الفضاء التضميني العام من منظور شامل، أي تحليل العلاقات الموضعية النسبية بين الخلايا المختلفة في هذا الفضاء. عند تضمين جميع خلايا أنسجة الرئة من Tabula Sapiens v.2، يمكن ملاحظة بنية تنظيمية لأنواع الخلايا ذات دلالة بيولوجية واضحة (الشكل أ أدناه). لا تقتصر أنواع الخلايا المختلفة على التجمّع بشكل منفصل، مثل خلايا T والخلايا الوحيدة والخلايا البطانية التي تشكل تجمعات واضحة، بل يمكن أيضًا تمييز الفئات الأعلى من الخلايا، مثل الخلايا المناعية والخلايا الظهارية، بشكل واضح.
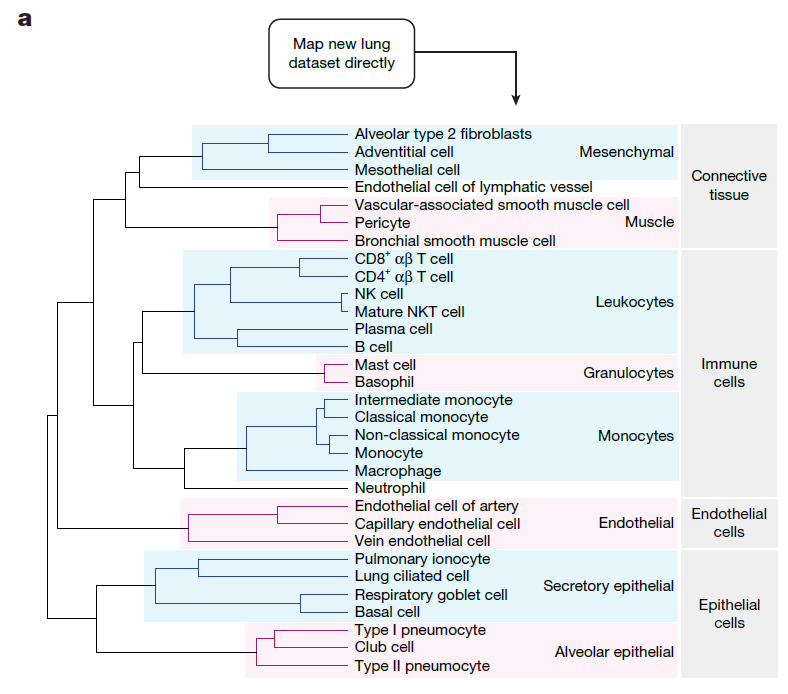
*الفضاء التضميني UCE المُولَّد لبيانات جديدة غير مسبوقة يُظهر بنية تنظيمية لأنواع الخلايا ذات دلالة بيولوجية*
قارن الباحثون أيضًا هذه النتيجة بالبنية الهرمية للخلايا المستندة إلى علم أنطولوجيا الخلايا (Cell Ontology). أظهرت النتائج أنه مقارنة بطرق التضمين الصفري الأخرى، فإن تجمعات الخلايا التي حددها UCE تُظهر تشابهًا أعلى مع Cell Ontology.
أظهرت تجارب إضافية أن UCE قادر على تعلم تمثيل بيولوجي شامل للخلايا بشكل فعال. هذا التمثيل لا يميز بين أنواع الخلايا المختلفة فحسب، بل يلتقط أيضًا أوجه التشابه النسبية بين أنواع الخلايا على مستويات مختلفة، مما قد يكشف عن قوانين بيولوجية أعمق وراء تطور الخلايا ووظائفها.
تحليل UCE لنتائج أمراض الرئة
أخيرًا، استخدم الباحثون UCE ومصنف خلايا Norn الذي تم بناؤه سابقًا لدراسة الخلايا الشبيهة بـ Norn في أمراض الرئة—حيث قاموا بأخذ عينات من خلايا الرئة من مرضى التليف الرئوي مجهول السبب (idiopathic pulmonary fibrosis، IPF)، ومرضى مرض الانسداد الرئوي المزمن (chronic obstructive pulmonary disease، COPD)، ومرضى المجموعة الضابطة، وقاموا بتوليد فضاء التضمين الخلوي الخاص بهم. في المجموعات الثلاث، تم تحديد خلايا رئوية شبيهة بـ Norn تُظهر تعبيرًا تفضيليًا للجينات المميزة لـ Norn (الشكل د أدناه)؛ وكشف تحليل إضافي أن هذه الخلايا الرئوية الشبيهة بـ Norn تُظهر اختلافات في التعبير بين مجموعات الأمراض المختلفة (الشكل هـ أدناه).
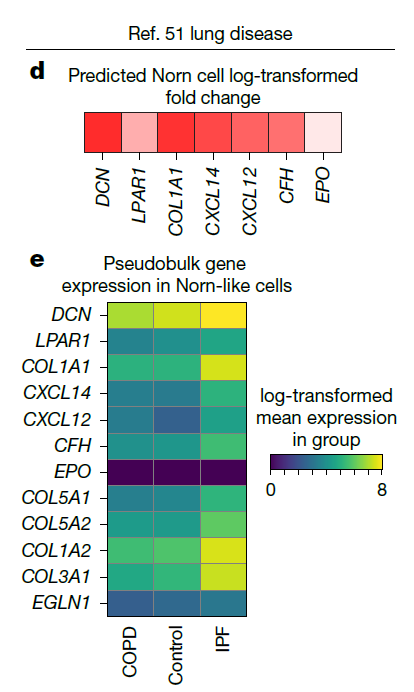
*دراسة حالة خلايا Norn تُظهر أن UCE قادر على دعم التحليل الإضافي لمجموعات بيانات الخلايا المفردة*
يرتبط كل من COPD وIPF بارتفاع مستويات Epo في الدم، لكن مستويات Epo لدى مرضى COPD أعلى منها لدى مرضى IPF. بالإضافة إلى ذلك، مقارنة بمرضى COPD، فإن كثرة الكريات الحمر الثانوية (secondary erythrocytosis) لدى مرضى IPF أقل وضوحًا أو أقل شدة. نظرًا لأن الدراسة وجدت خلايا شبيهة بـ Norn في أنسجة الرئة، وأن خلايا Norn قادرة على إنتاج Epo، فإن الاختلافات في التشخيص بين هذين المرضين قد تكون مرتبطة باختلافات في الخلايا الشبيهة بـ Norn المرتبطة بالمرض.
بشكل عام، تشير هذه النتائج إلى أنه يمكن العثور على خلايا ذات حالات نسخية مشابهة لخلايا Norn في أنسجة أخرى من الجسم، وقد تلعب هذه الخلايا أدوارًا لم يتم وصفها سابقًا في العمليات المرضية. نظرًا لأن UCE نموذج عام غير مقيد بالأنسجة أو الأنواع أو الحالات المرضية، فإنه يمكن أن يسهل بشكل كبير تحليل مثل هذه البيانات الضخمة والمتنوعة.
الخاتمة
من خلال بناء UCE، وسّع الباحثون قدرات تحليل بيانات scRNA-seq. على الرغم من أن هذا النموذج يمثل خطوة مهمة نحو تضمين الخلايا العام، إلا أنه لا تزال هناك بعض القيود—حيث تقيّم الاختبارات الحالية بشكل أساسي قدرة UCE على استعادة أنواع الخلايا المُعلَّقة من قبل الخبراء، لكن هذه المهام نفسها محدودة بحبيبات وذاتية تسميات الخلايا الحالية. لذلك، قد لا تعكس هذه التقييمات بشكل كافٍ قدرة النموذج على تمثيل العمليات البيولوجية الأكثر دقة، مثل استجابة الخلايا للاضطرابات، أو التكامل بين بيانات الأنماط المختلفة. بالإضافة إلى ذلك، مثل النماذج الأساسية البيولوجية واسعة النطاق الأخرى، يظل UCE إلى حد كبير نموذجًا صندوقًا أسود، مما يجعل من الصعب تفسير سبب وكيفية تشكل بعض التضمينات. لمعالجة هذا الغموض، يلزم تطوير أدوات قابلية للتفسير تربط التمثيلات التي تعلمها النموذج بالفهم على المستوى البيولوجي الآلي. على الرغم من أن بيانات تدريب UCE ضخمة، إلا أنها لا تزال تميل نحو الأنواع الثديية، خاصة البشر والفئران، وكذلك نحو بعض الأنسجة المحددة مثل أنسجة الدماغ، مما يثير مخاوف بشأن قدرة النموذج على التعميم إلى الأنواع والسيناريوهات البيولوجية غير الممثلة بشكل كافٍ.
أخيرًا، يجدر التأكيد على أنه على الرغم من أن UCE قادر على تحسين محاذاة البيانات من خلال التقاط الإشارات البيولوجية المشتركة بين مجموعات البيانات المختلفة، إلا أنه لا يحل محل طرق تصحيح تأثير الدفعة التقليدية. بالنسبة لمعالجة العوامل المربكة التجريبية المعروفة، لا تزال الطرق التقليدية ذات قيمة مهمة.
المراجع: