HyperAI
Command Palette
Search for a command to run...
Papers
최신 AI 트렌드를 파악할 수 있도록 매일 업데이트되는 최첨단 AI 연구 논문
개의 논문
GroupRank: 강화학습에 의해 구동되는 그룹 기반 재정렬 프레임워크
MMaDA-Parallel: 사고 인식 편집 및 생성을 위한 다중모달 대규모 확산 언어 모델

TiViBench: 영상 생성 모델을 위한 Think-in-Video 추론 평가
Part-X-MLLM: 부분 인지형 3D 다중모달 대규모 언어 모델
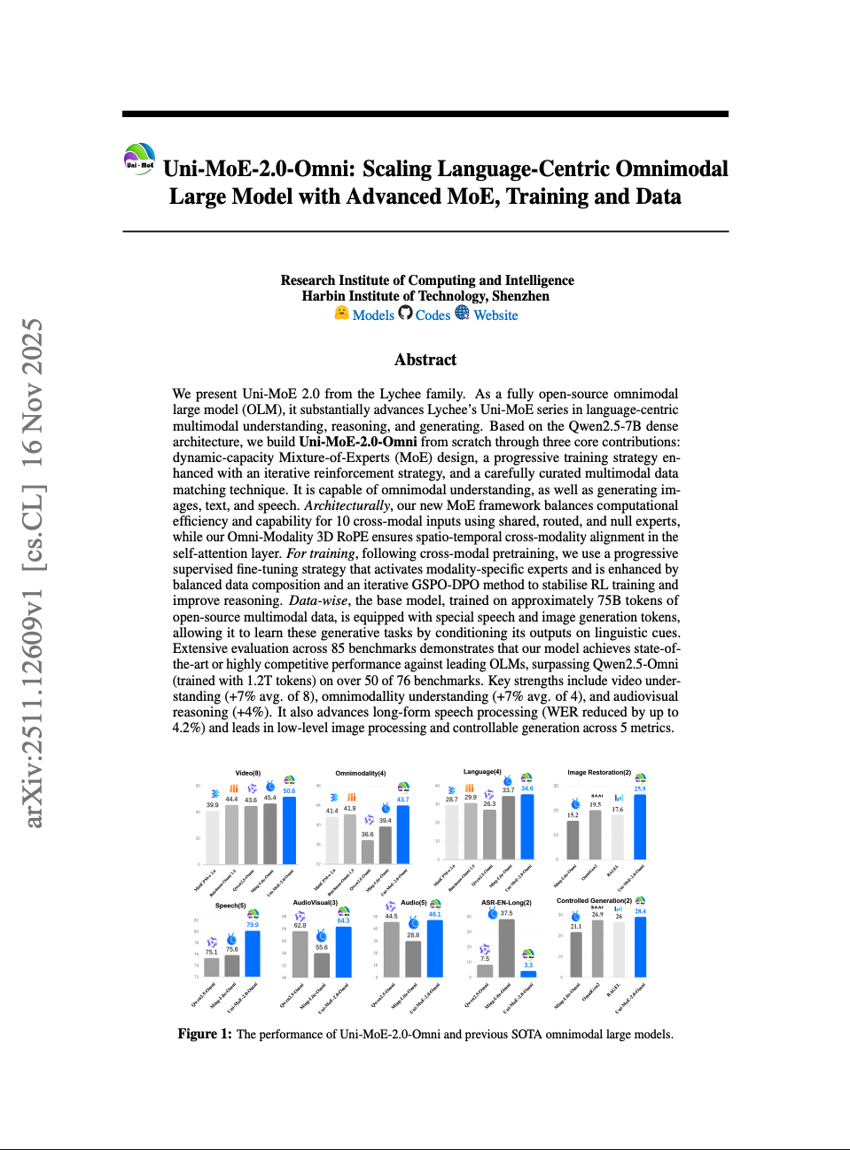
Uni-MoE-2.0-Omni: 고급 MoE, 훈련 및 데이터를 활용한 언어 중심 옴니모달 대규모 모델의 확장
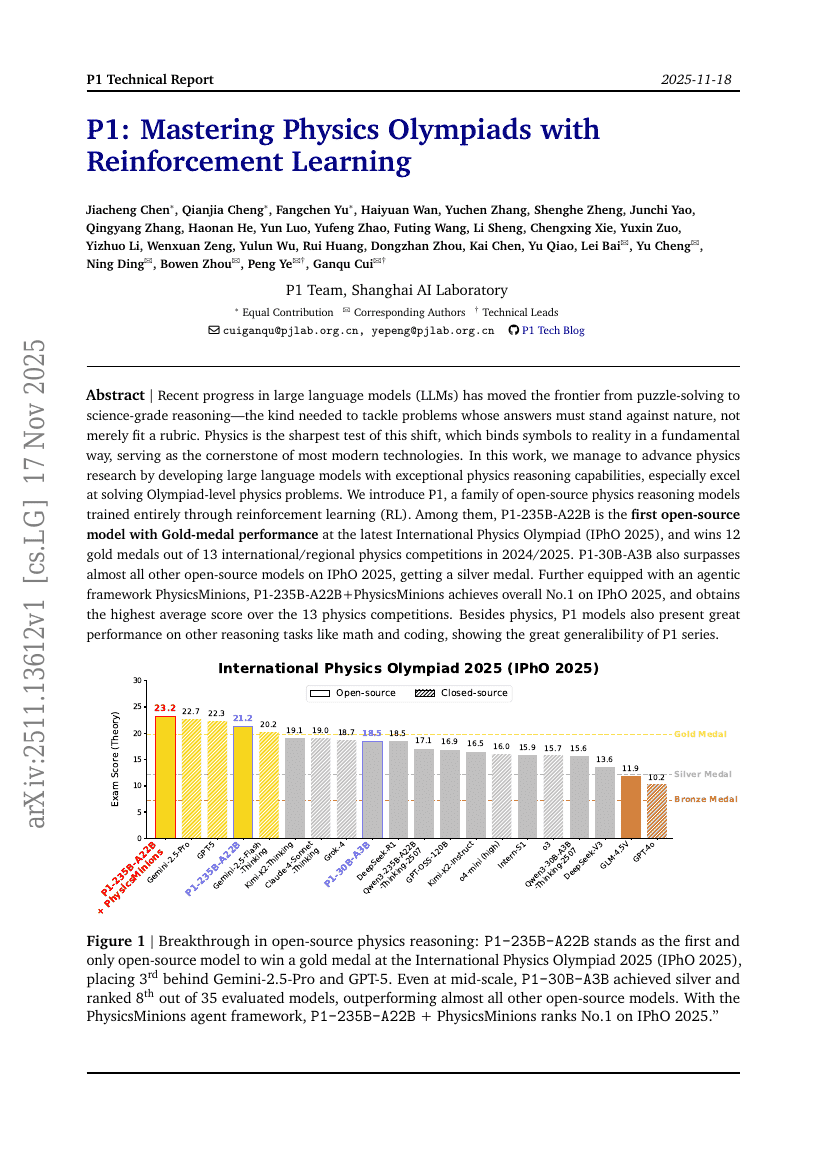
P1: 강화학습을 통한 물리올림피아드 정복
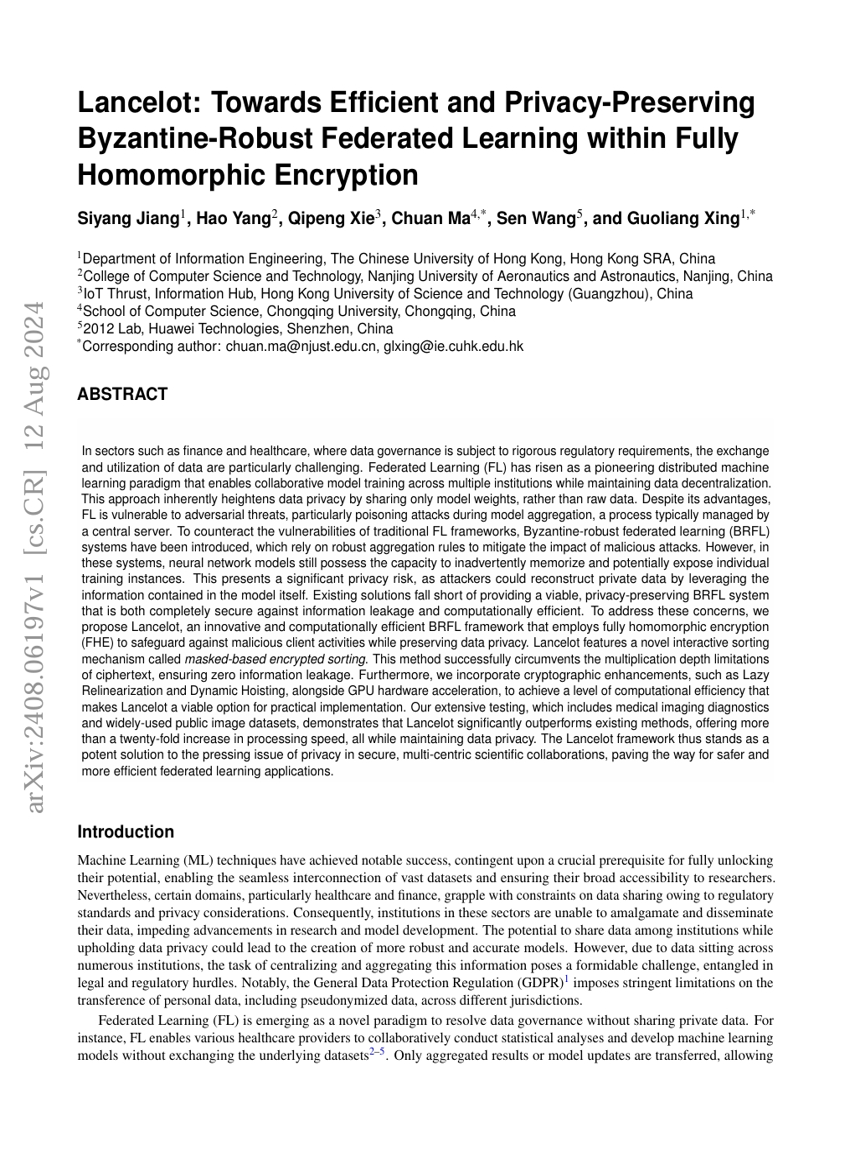
랜슬로트: 완전 동형 암호화 내에서 효율적이고 프라이버시를 보장하는 바지안-저항성 분산 학습을 위한 방향
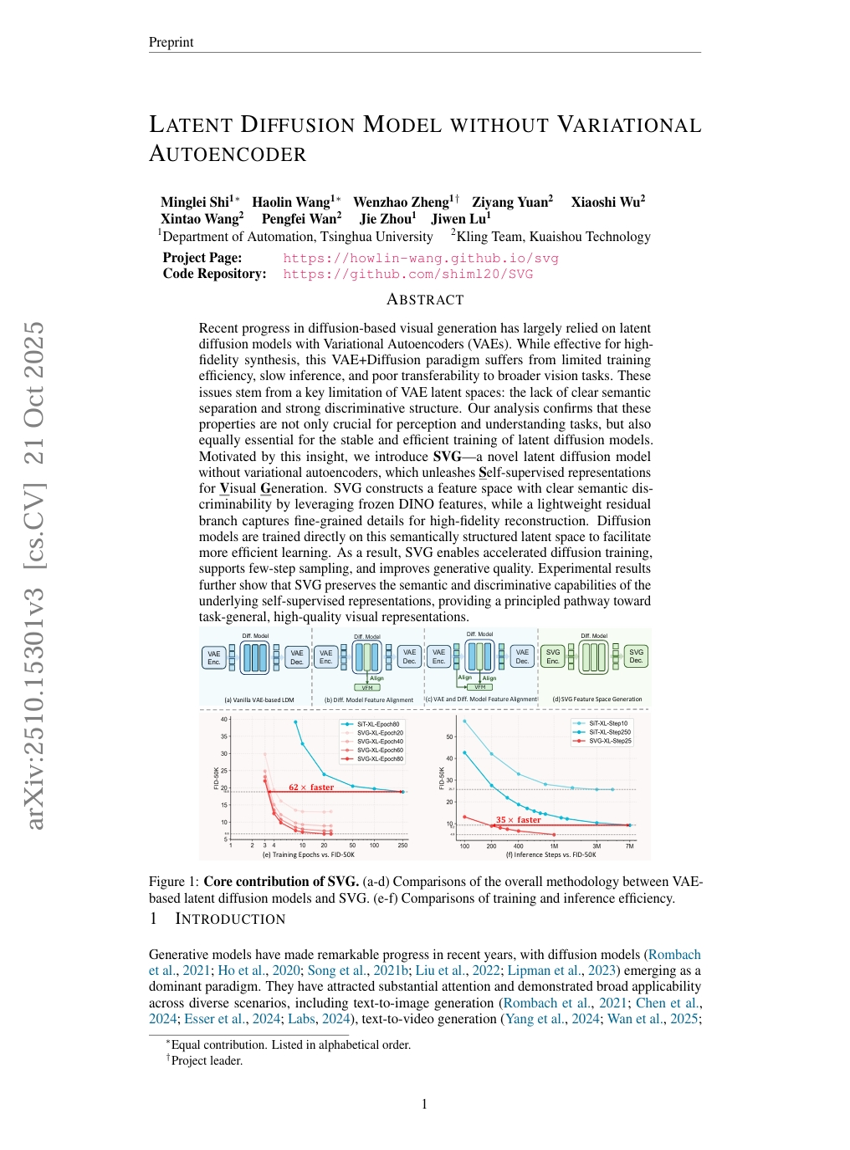
변분 오토인코더 없이 사용하는 잠재 확산 모델
RewardMap: 미세한 시각적 추론에서 희소 보상 문제에 다가가기 위한 다단계 강화 학습을 통한 접근
ReinFlow: 온라인 강화 학습을 통한 플로우 매칭 정책의 피니어 투닝
이성 능력에 대한 음성 평가: 모달리티 유도 성과 격차 진단
MarsRL: 에이전트형 파이프라인 병렬화를 통한 강화 학습을 통한 다중 에이전트 추론 시스템의 발전
가상 폭 네트워크
AIonopedia: 이온 액체 탐사에 대한 다중 모달 학습을 조율하는 LLM 에이전트
UI2CodeextN: 테스트 시각적 확장 가능한 인터랙티브 UI-to-Code 생성을 위한 시각 언어 모델
GGBench: 통합 다중모달 모델을 위한 기하학적 생성 추론 벤치마크
WEAVE: 맥락 내 혼합 이해 및 생성의 잠재력 해방과 벤치마킹
DoPE: 복원 회전 위치 임베딩
BRFL: 블록체인 기반의 바이잔트 강건 편제 학습 모델
지수-가우시안 혼합망을 통한 영상 시청 시간 예측을 위한 다중 과립도 분포 모델링
SAC 플로우: 속도 재파라미터화된 순차 모델링을 통한 샘플 효율적인 기반 플로우 정책 강화 학습
특징 최적 일치를 통한 폐쇄형 MLLM에 대한 적대적 공격
Hail to the Thief: 분산형 GRPO에서의 공격 및 방어 탐구
블랙박스 온폴리시 드리스틸레이션: 대규모 언어 모델의 경우
UniVA: 오픈소스 다음 세대 비디오 종합 모델을 위한 유니버설 비디오 에이전트
PAN: 일반적이고 상호작용 가능하며 장기적인 시계열 세계 시뮬레이션을 위한 월드 모델
잠재 공간에서의 한 걸음, 픽셀 공간에서의 거대한 도약: 당신의 확산 모델을 위한 빠른 잠재 크기 확대 어댑터
YOLOv13: 고차원 그래프 기반 적응형 시각 인지 강화를 통한 실시간 객체 탐지
MonkeyOCR: 구조 인식 관계 삼중체 패러다임을 활용한 문서 파싱
안전한 생성형 AI를 위한 공감대 샘플링
아르거스: 엔드투엔드 자율주행시스템을 위한 회복력 기반 안전 보장 프레임워크
WMPO: 시각-언어-행동 모델을 위한 세계 모델 기반 정책 최적화