HyperAI
Command Palette
Search for a command to run...
Papers
최신 AI 트렌드를 파악할 수 있도록 매일 업데이트되는 최첨단 AI 연구 논문
개의 논문
PROTECT-90: 전력 계통 보호를 위한 고장 데이터셋
Activation Oracle이 읽지 않는 법을 배울 때: 미세 조정된 Oracle의 개념별 맹점
YOLO-PEFT: YOLO 계열을 위한 매개변수 효율적 미세 조정
StreamArena: 지속적, 대화형, 장기적 에이전트 스트리밍 비디오 이해를 향하여
SimWAM: 종단 간 자율주행을 위한 단순한 세계-행동 모델
SFT는 충돌하고 RL은 공존한다: 대규모 언어 모델을 위한 다중 작업 학습 패러다임의 이론적 및 경험적 분석
단순한 환경 확장을 넘어: 멀티모달 에이전트 학습을 위한 효과적인 환경 분포 설계
MatrAIx: 83억 개의 페르소나 에이전트로 세상을 시뮬레이션하다
EvoHarness-RL: 장기 과업 수행 LLM 에이전트를 위한 자기 진화형 런타임 하네스 학습
EnvACE: 에이전트 강화 학습을 위한 세계 리허설을 통한 환경 역학의 내재화
GST-Bench: VLM은 비디오로부터 전역적 공간 인지 능력을 갖출 수 있는가?
WorldClaw: 에이전트 기반 대규모 3D 오픈 월드 생성
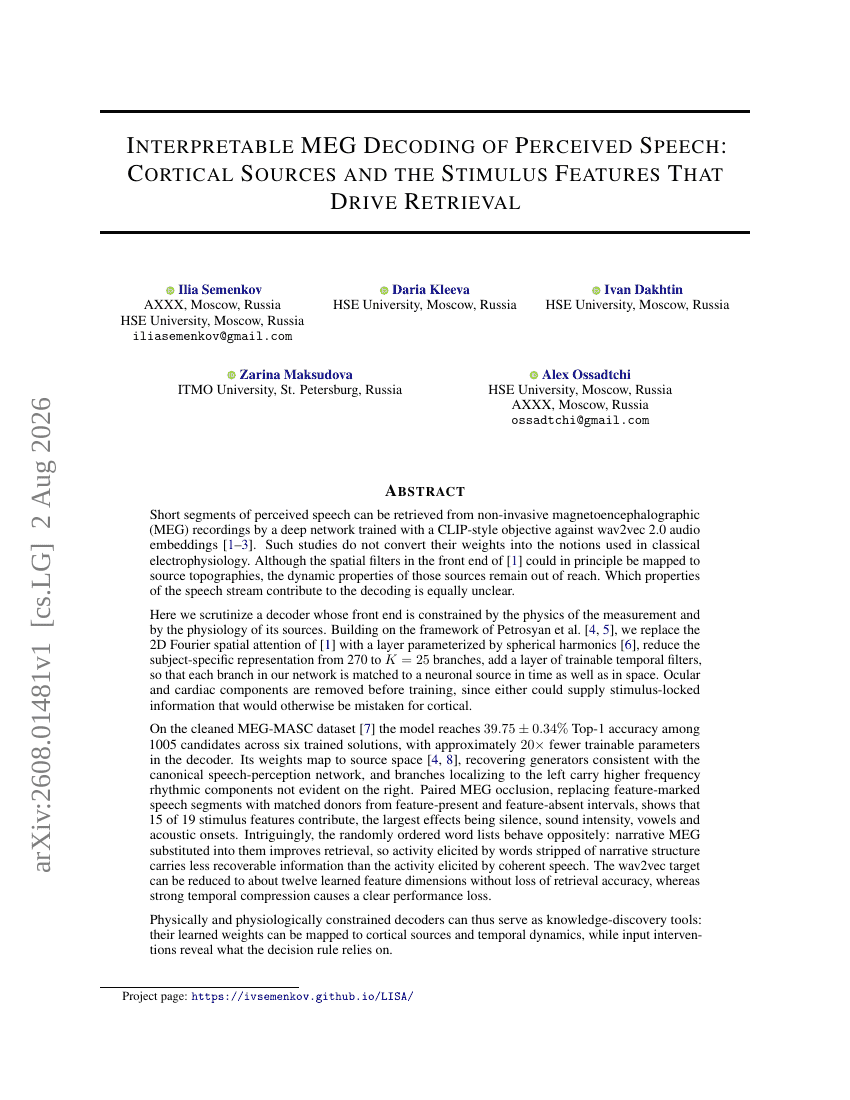
지각된 음성의 해석 가능한 MEG 디코딩: 피질 신호원과 검색을 유도하는 자극 특징
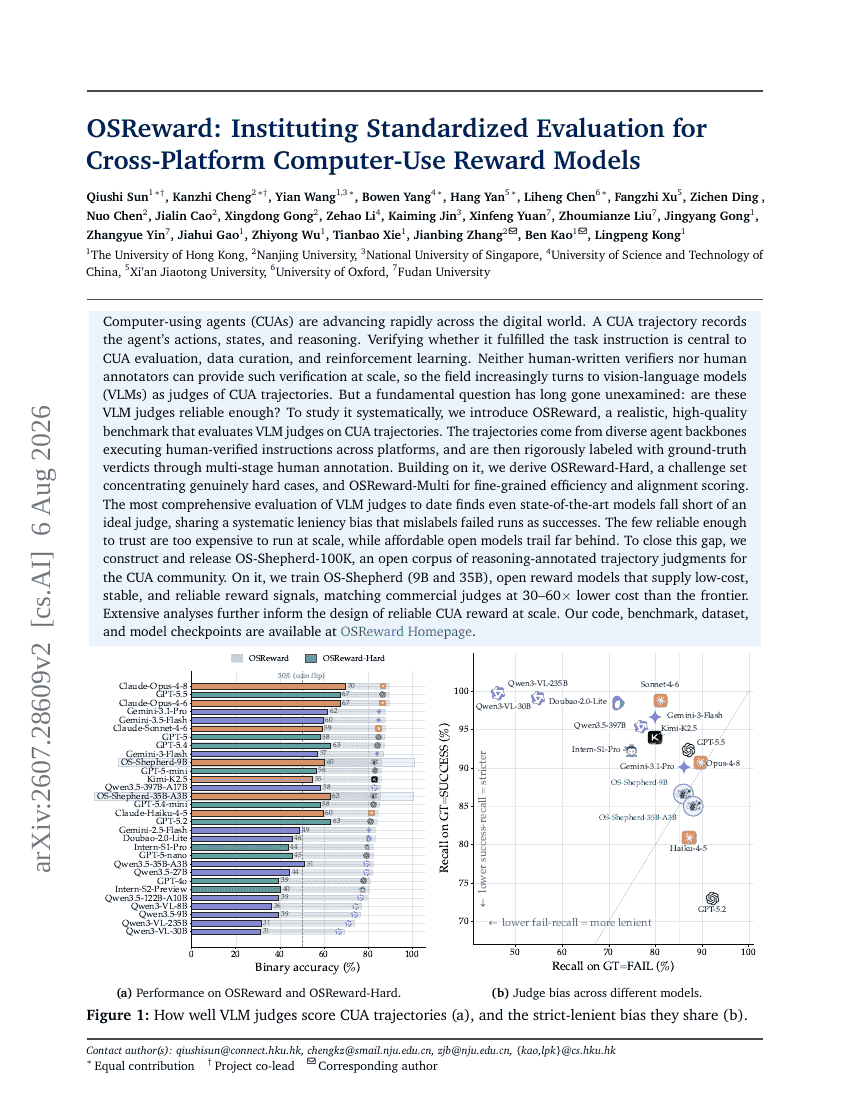
OSReward: 크로스 플랫폼 컴퓨터 사용 보상 모델을 위한 표준화된 평가 체계 수립
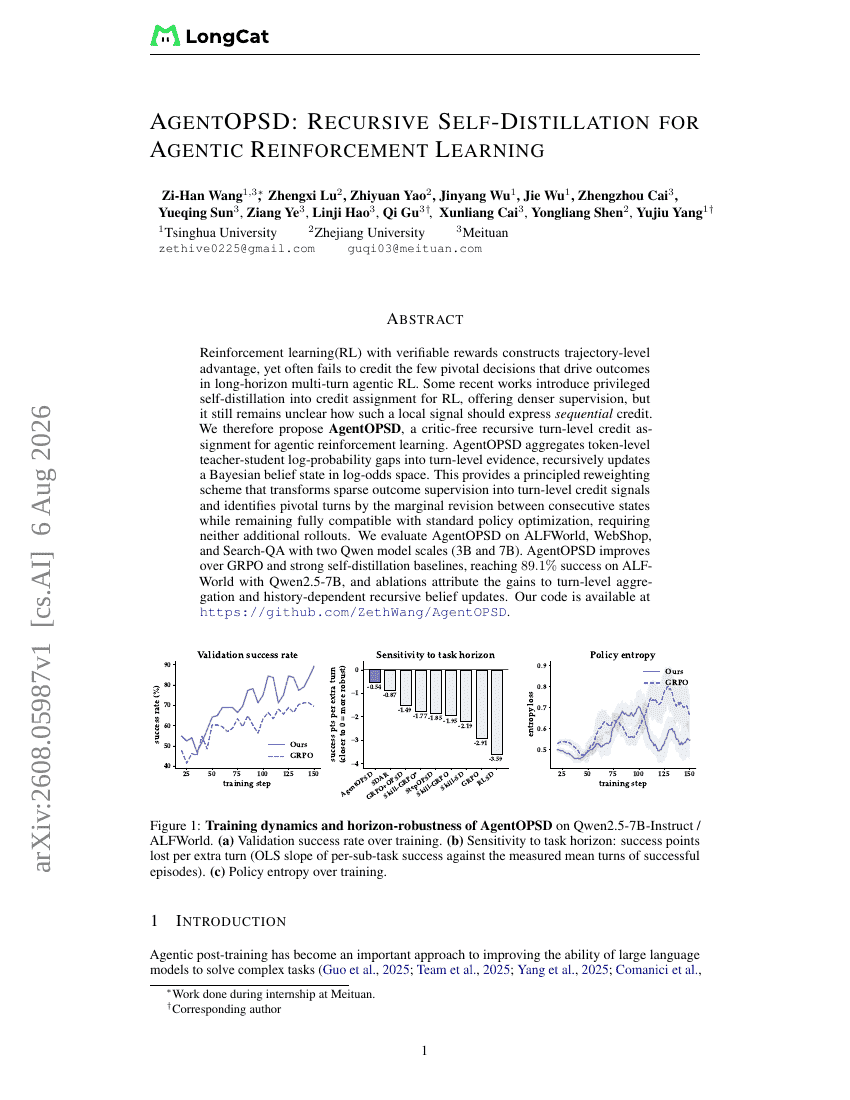
AGENTOPSD: 에이전트 강화 학습을 위한 재귀적 자기 증류
장기 과업을 위한 행위자 중심 컨텍스트 관리(ACM)
실시간 복강경 수술 안내를 위한 AI 기반 단일 촬영 구조광 깊이 복원
얕은 깊이에서 공유된 고전적 무작위성을 통한 단일 및 채널 양자 생성 모델 간의 표현적 분리
보상 구조가 강화학습의 에피소드 탐색과 신경망 메모리 간 상호작용을 결정한다
안정 밀도 능선: 부분 공간 제약 평균 이동의 일관성과 수렴성
프라이버시 보호형 교실 사고 인식을 위한 강건하고 효율적인 동작 추론
ABSeeker: 답변 역추적 기반 크레딧 할당을 통한 장기 탐색 에이전트 훈련
PG-LLM: 단백질 변이체 순위 평가를 위한 범용 언어 모델 벤치마크
DataSpace: 이기종 작업 공간에서의 검증 가능한 분석을 위한 데이터 에이전트 벤치마크
정책 지연 하에서의 롤아웃 재사용: 대규모 언어 모델 강화 학습을 위한 접두사 정규화 정책 최적화
Harness-R1: 에이전트 실패 궤적에서 실행 가능한 런타임 하네스 편집 학습
FinanceHarness: 자율 금융 심층 연구 프레임워크
DeepSeek-V4: 고효율 백만 토큰 컨텍스트 지능을 향하여
지식-기하 구조 분리: 스트리밍 추천을 위한 지속적 갱신형 사전 학습 전이
Video-DeepResearch: 차세대 멀티모달 심층 연구 에이전트를 향하여
AURORA-LM: 연속 잠재 공간 확산 언어 모델링을 위한 자동 인코딩 통합 표현
Hunyuan3D-Buffalo 1.0: 확장 가능한 3D 생성, 이해 및 편집을 위한 통합 멀티모달 모델