HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
SAM 2:画像および動画におけるアノテーションの汎用化
Llama 3 モデル群

InternLM-XComposer-2.5:長文入出力に対応する汎用的大規模視覚言語モデル
MMDU:LVLMs向けのマルチターン・マルチイメージ対話理解ベンチマークおよびインストラクションチューニングデータセット
視覚言語モデルを構築する際に重要な要素は何ですか?
DDOS:ドローン深度および障害物セグメンテーションデータセット
自己回帰モデルとフローマッチング:テキストから音楽への生成モデリングの比較研究
SeerAttention-R: 長い推論のためのスパースアテンション適応
プレイヤーワン:自己中心的な世界シミュレーター
ComfyUI-R1: ワークフロー生成のための推論モデルの探求
自己回帰敵対的後学習によるリアルタイムインタラクティブビデオ生成
自信がすべて:言語モデルのFew-Shot RLファインチューニング
自然な発話合成における自己教師型音声表現の利用に関する考察
大規模分子シミュレーションのための有機系対象効率的な機械学習力場
MIRAGE:医療教育における多モード画像およびテキストの検索と生成
ComfyGPT: ComfyUI ワークフロー包括的生成のための自己最適化型マルチエージェントシステム
現代のIDEにおけるコード補完のためのシーケンスモデル設計
ACE-Step:音楽生成基盤モデルへの一歩
自己教師あり音声表現モデルを条件としたゼロショットテキストから音声への合成
小規模および推論型大規模言語モデルは、研究の質に基づいて学術論文を評価できるか、そして平均化やfew-shot学習はそれを助けるか
物理主義の理論的限界:ジェミニ定理の非技術的解説
EmoSSLSphere: 球面ベクトルと離散音声トークンを用いた多言語感情音声合成
分数形非線形シュレーディンガー方程式における円形AIRIガウス渦ビームの伝播ダイナミクス
デジタル画像の画素における情報量
TesseractオープンソースOCRエンジンを用いた手書きローマ字文字の認識
TimeSenCLIP: リモートセンシングのための時系列ビジョン言語モデル
一般化された時空間ガウス過程モデルを用いた空間依存性の時間発展の学習
TripoSG: Large-Scale Rectified Flow Models を用いた高忠実度 3D 形状合成
Qwen2.5-Omni テクニカルレポート
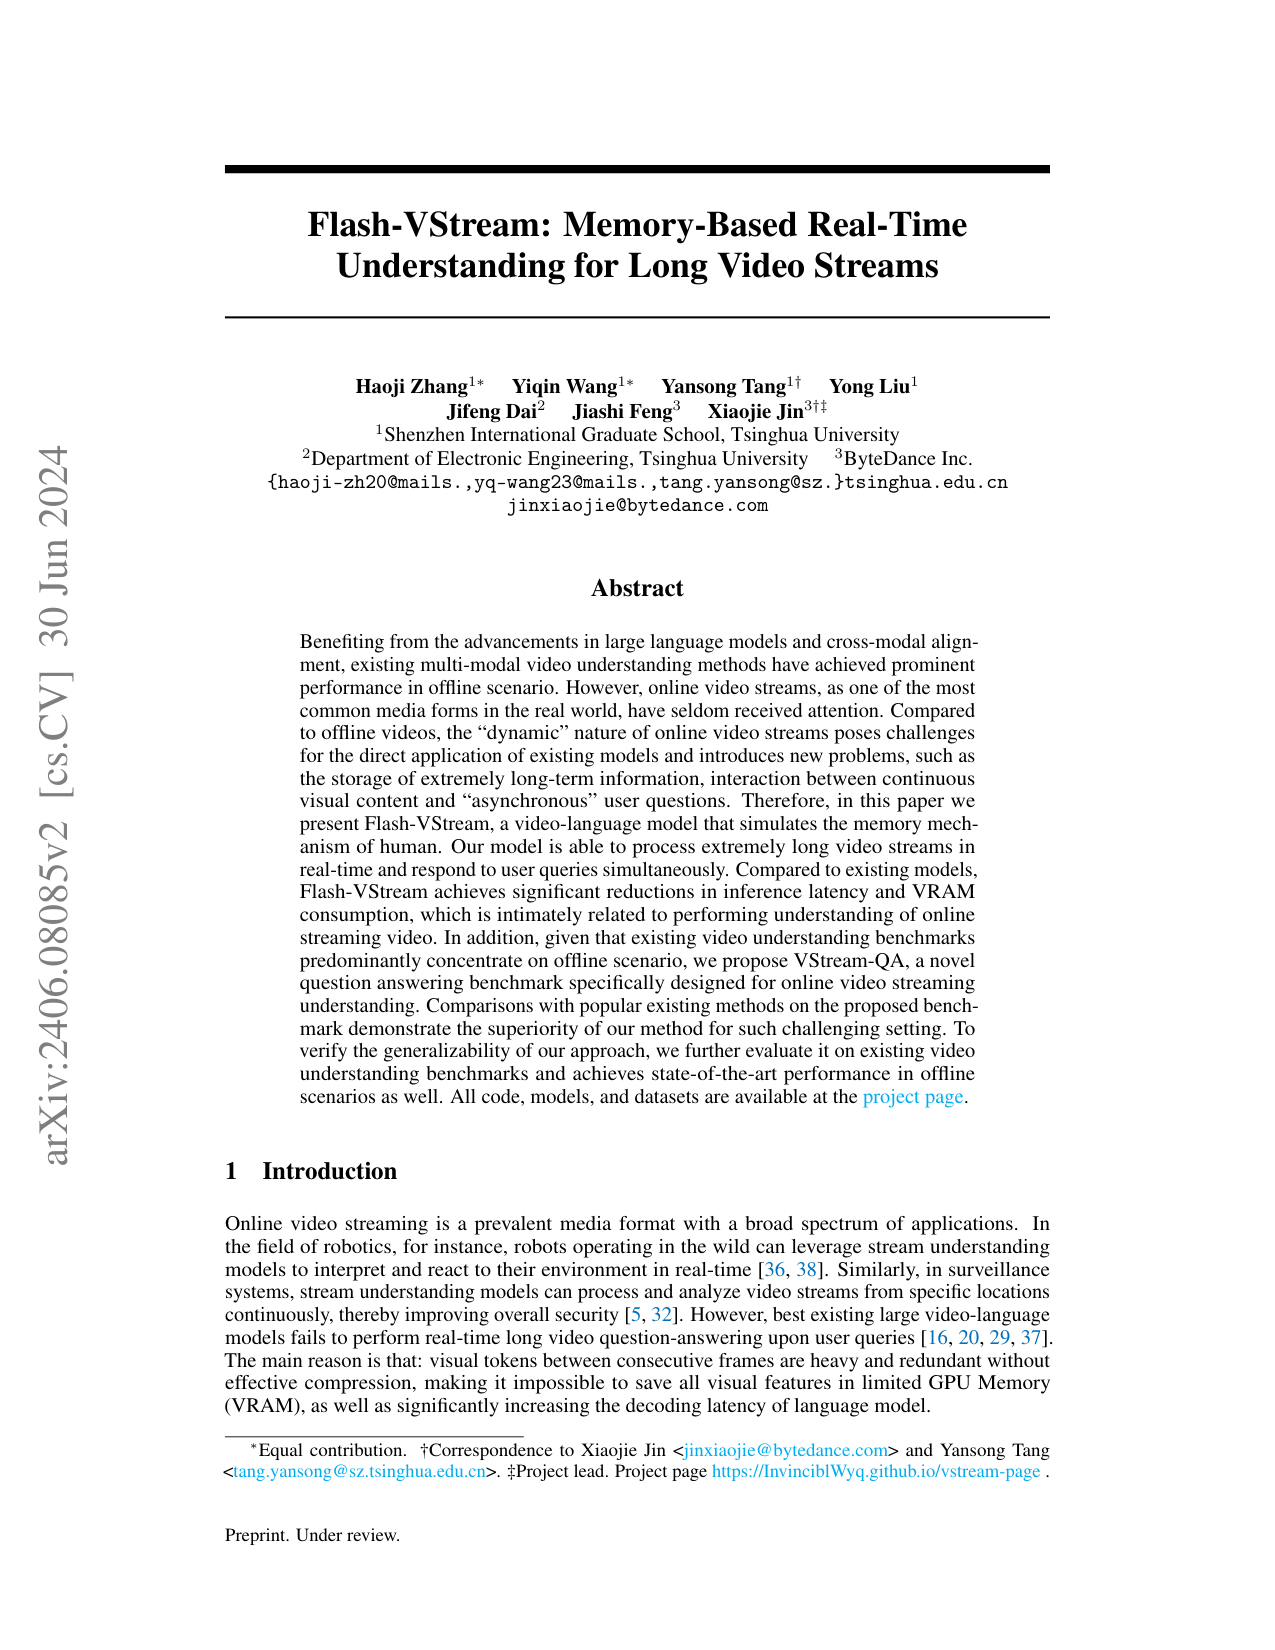
Flash-VStream: 長期ビデオストリームのメモリベースのリアルタイム理解
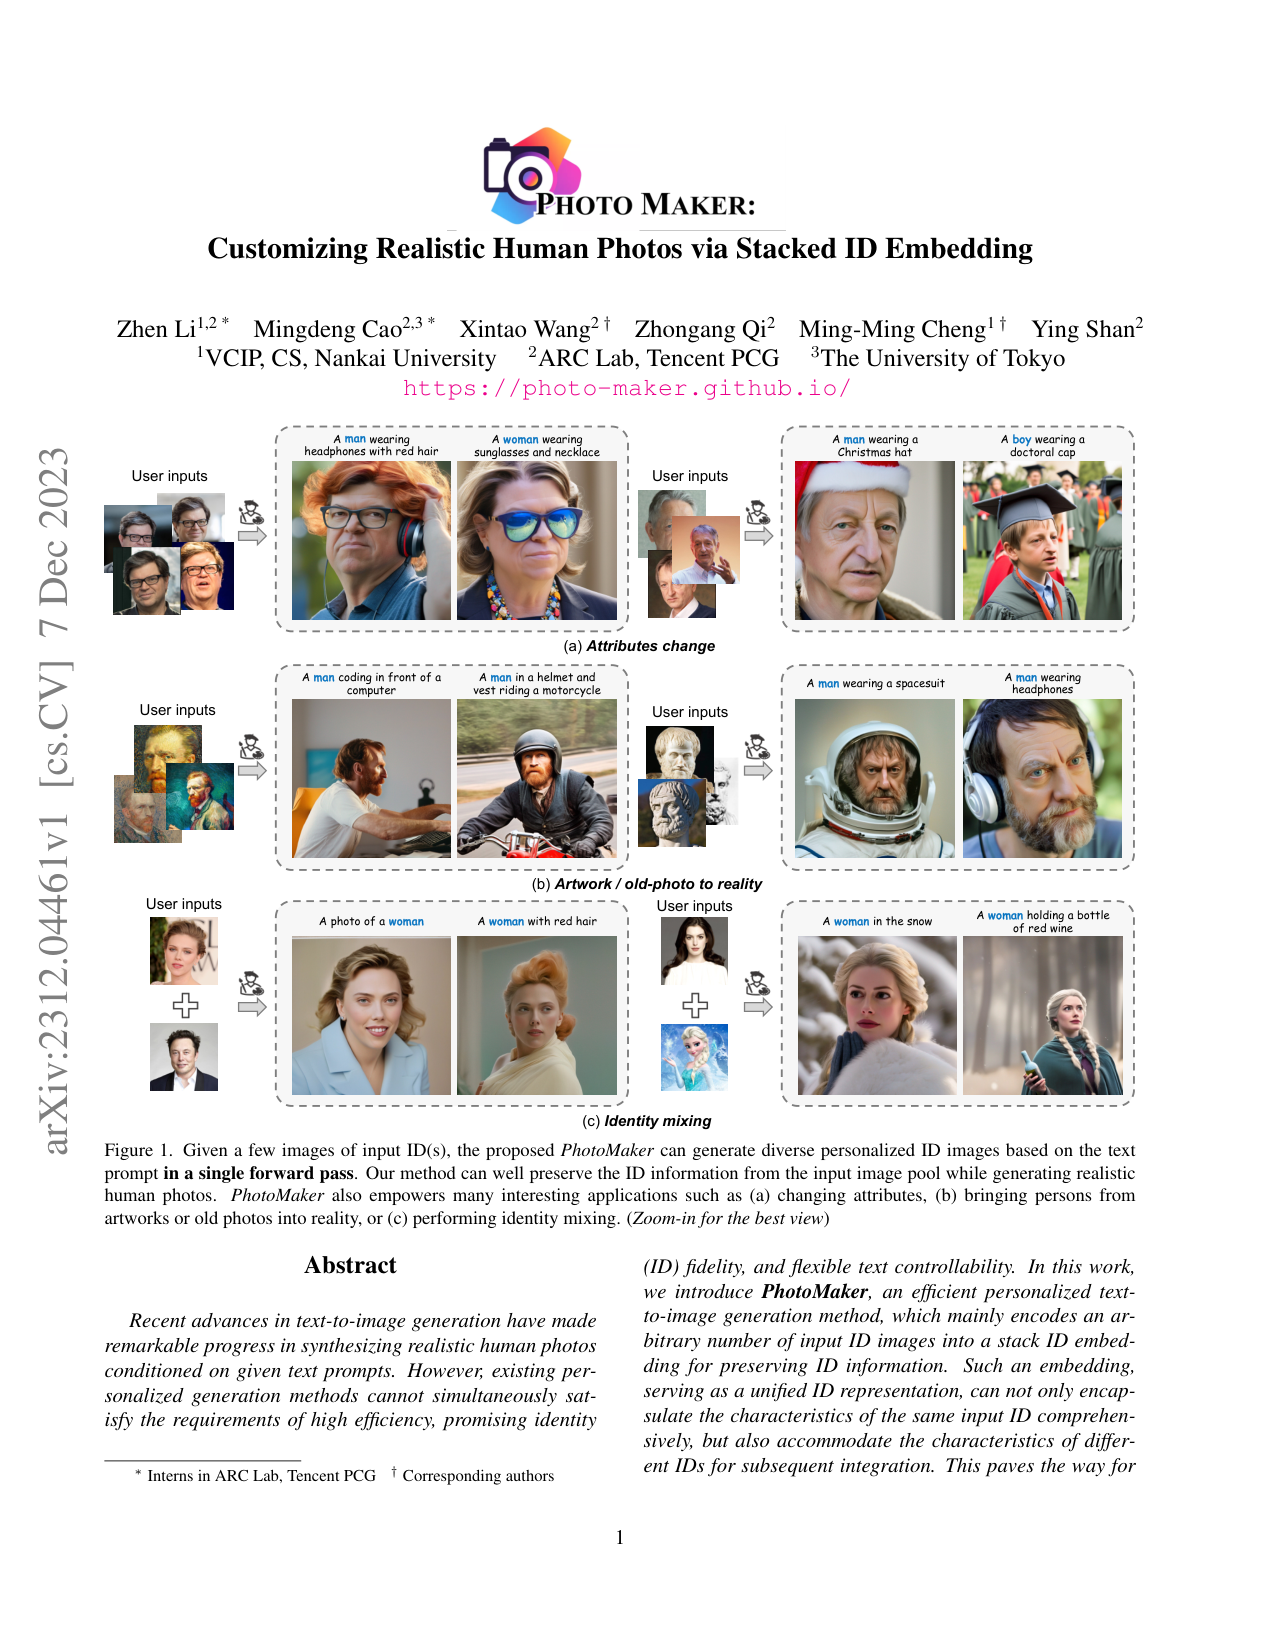
PhotoMaker: 積み重ねられたID埋め込みによるリアルな人物写真のカスタマイズ
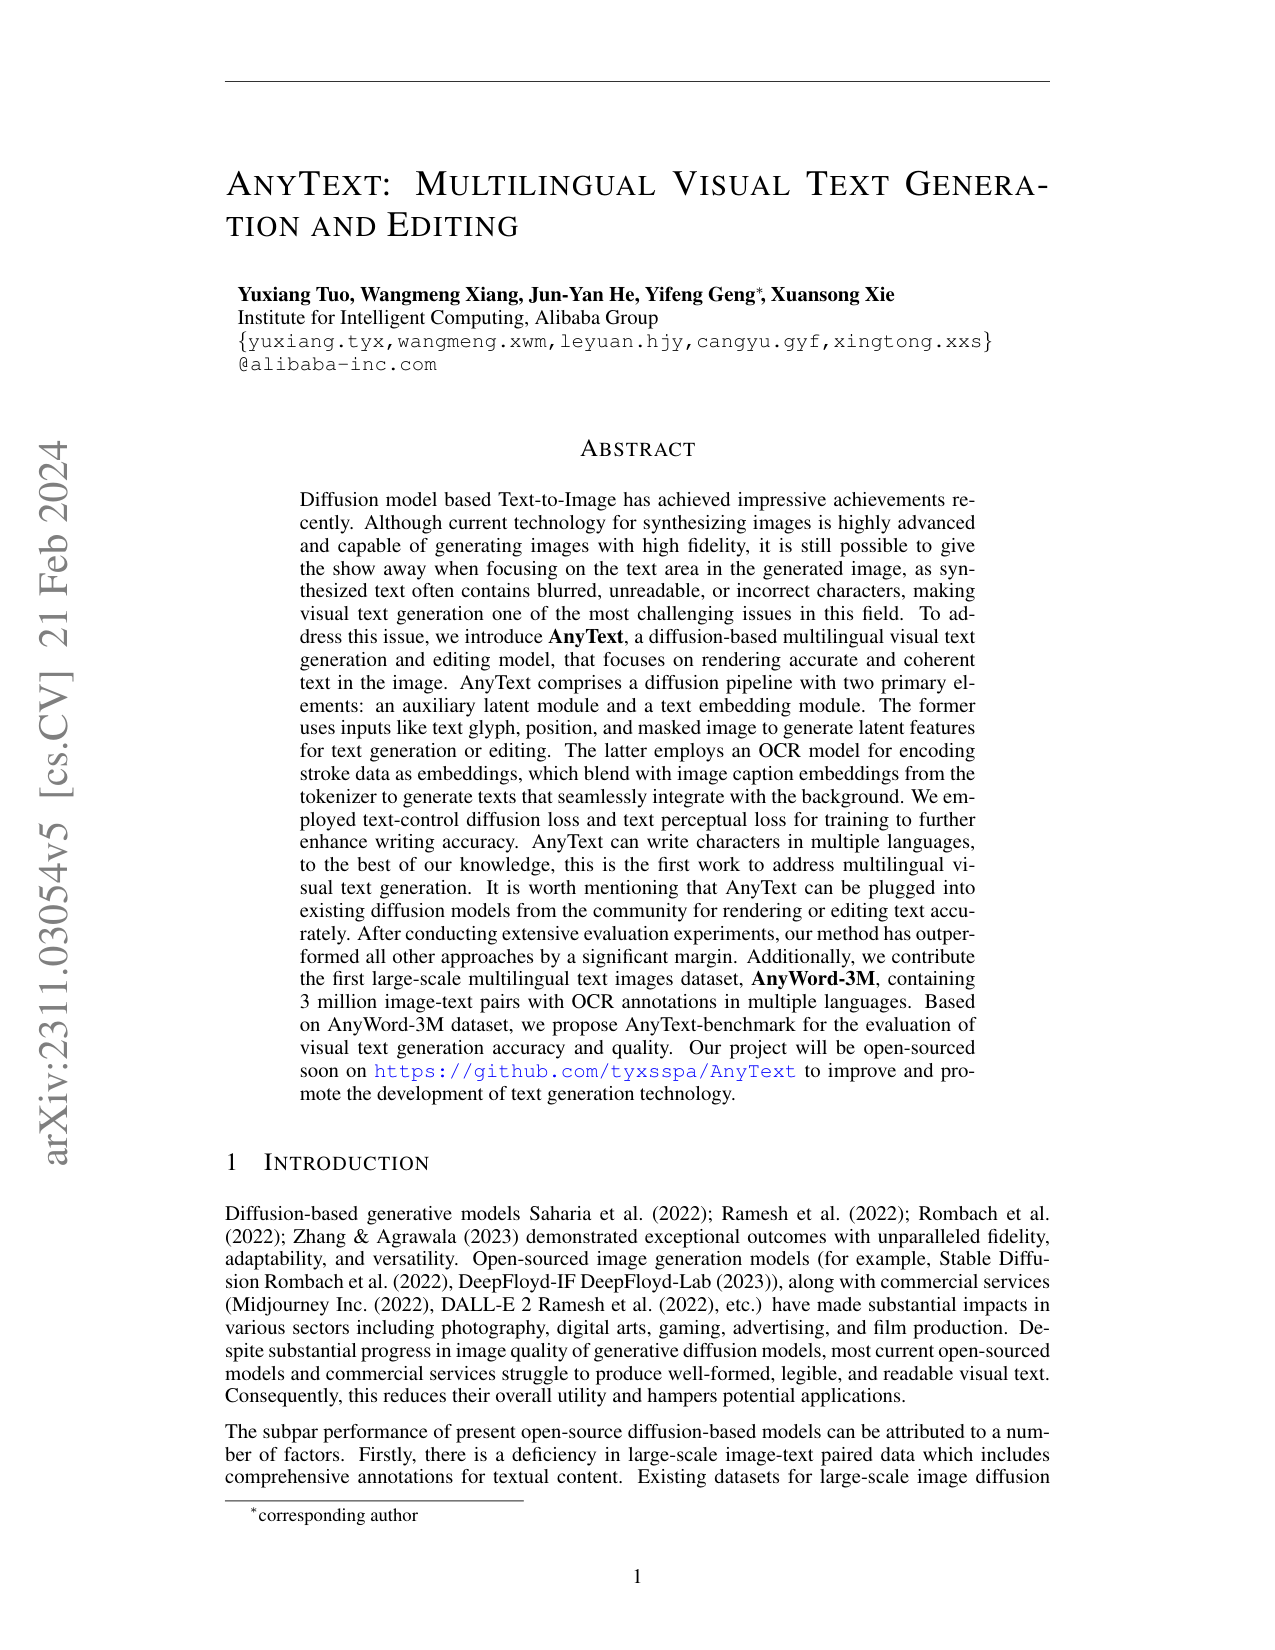
AnyText: 多言語の視覚的テキスト生成と編集