HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
VCRL:大規模言語モデル向けの分散に基づくカリキュラム強化学習
MultiEdit:多様で困難なタスクにおける指示に基づく画像編集の進展
BRISC:Swin-HAFNetを用いた脳腫瘍セグメンテーションおよび分類のためのアノテーション付きデータセット
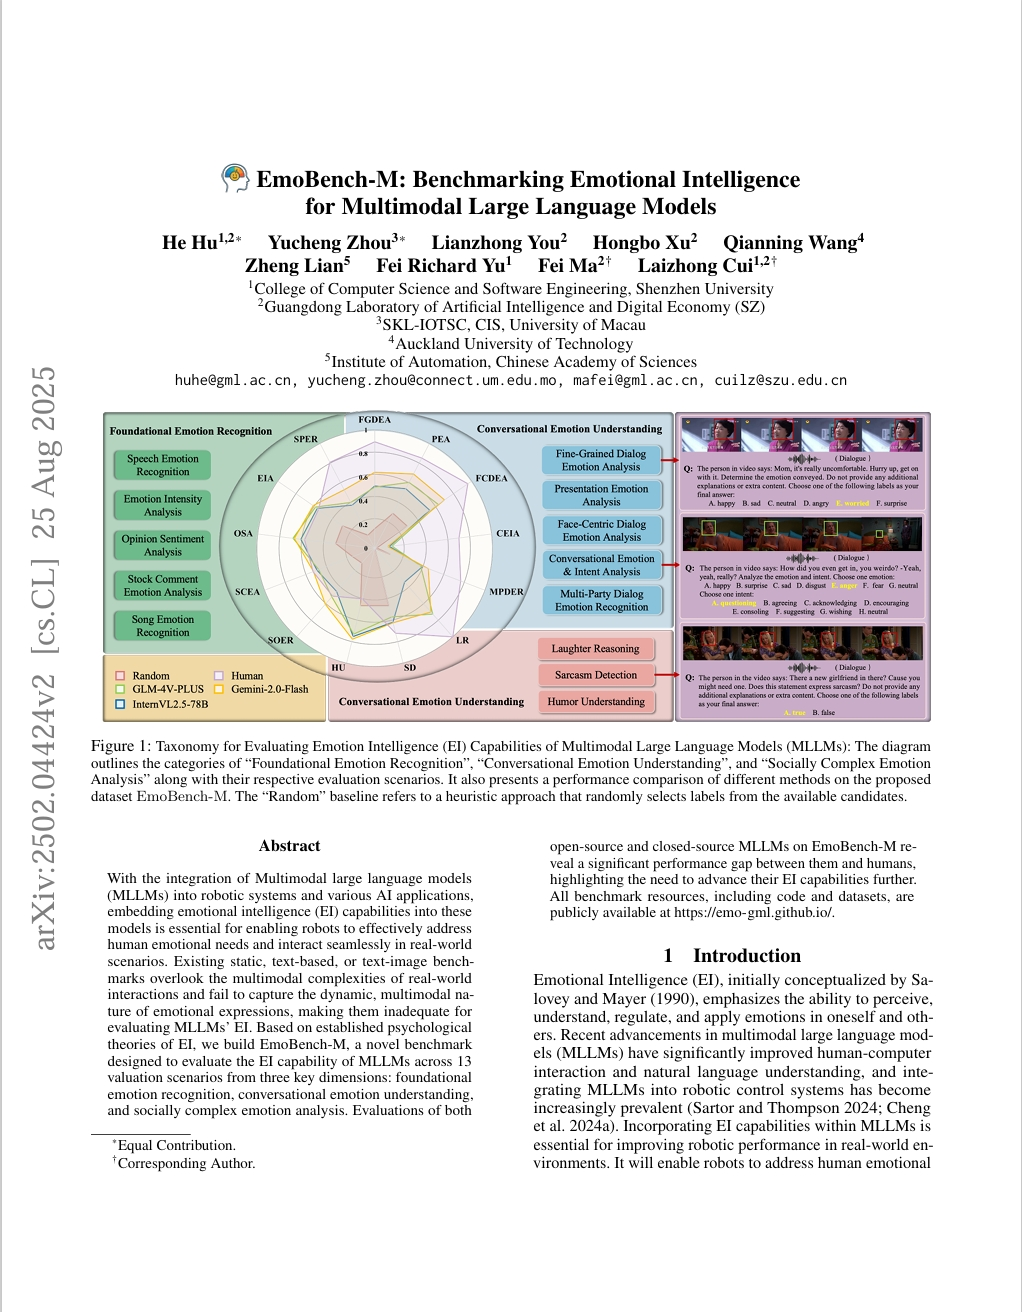
EmoBench-M:マルチモーダル大規模言語モデルの感情知能のベンチマーク評価
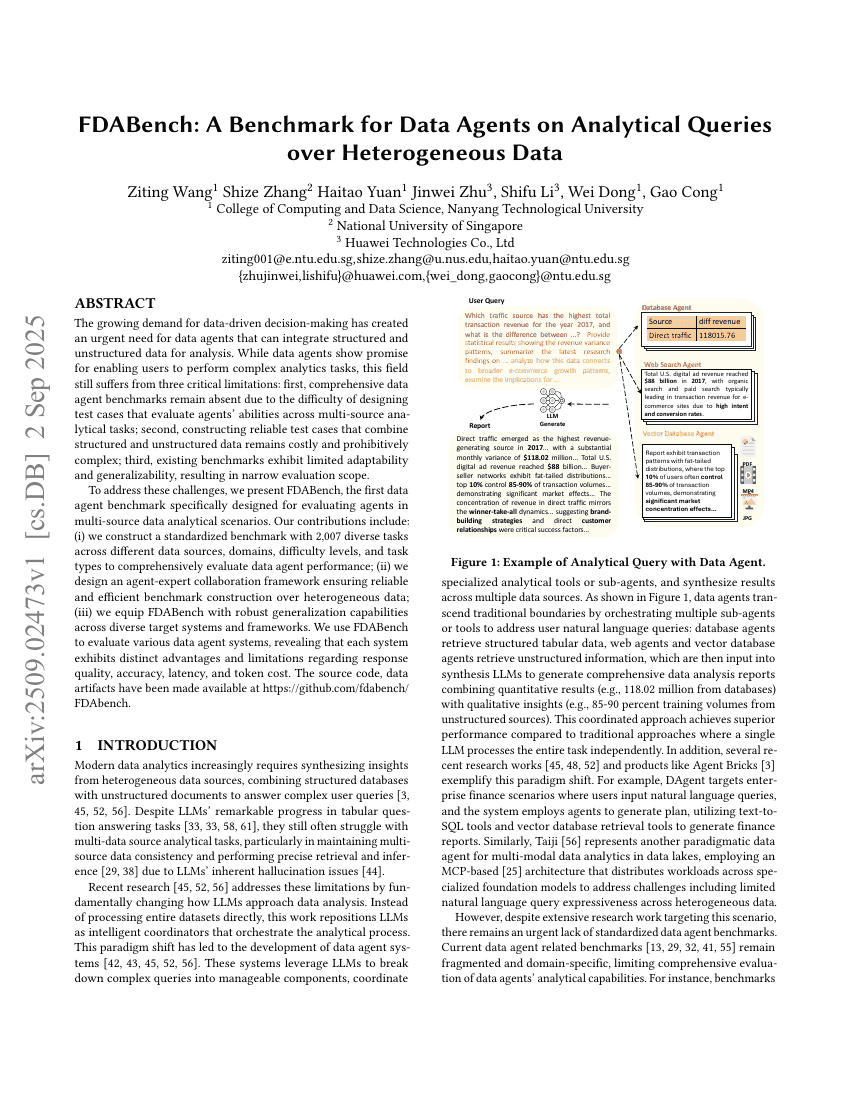
FDABench:異種データ上の分析クエリ向けデータエージェントのベンチマーク
思考するより絵を描くほうが簡単:テキストから画像を生成するモデルは舞台を設定できるが、演出まではできないか?
UniVerse-1:エキスパートのステッチングによる統合型音声・映像生成
基礎モデルは段階的エムボディド推論においてどれほど優れているか?
スパイキングブレイン技術報告書:スパイキングブレインをインスパイアした大規模モデル
SAGE:意味理解のための現実的なベンチマーク
WAVECLIP:適応的解像度CLIPのためのウェーブレットトークナイゼーション
EmbeddingGemma:強力で軽量なテキスト表現
GRPOを用いた音声認識言語モデルにおける音声理解の進展
VLMが視覚空間的知能からどれほど離れているのか? ベンチマーク駆動型の視点から
SIM-CoT:教師付き暗黙的チェーン・オブ・シンキング
SWE-QA:言語モデルはリポジトリレベルのコード質問に答えられるか?
動画モデルはゼロショット学習者かつ推論者である。
機械工学解析問題の重要課題に対するN-Plus-1 GPTエージェンシー
メモリQA:マルチモーダル記憶を基にしたリコール質問への回答
MAPO:ミックスドアドバンテージポリシー最適化
ハイパーバゲル:マルチモーダル理解および生成のための統合型高速化フレームワーク
事前学習データにおける強化学習
視覚運動方策に本体感觉状態は必要か?
Baseer:アラビア語文書からMarkdownへのOCR向け視覚言語モデル
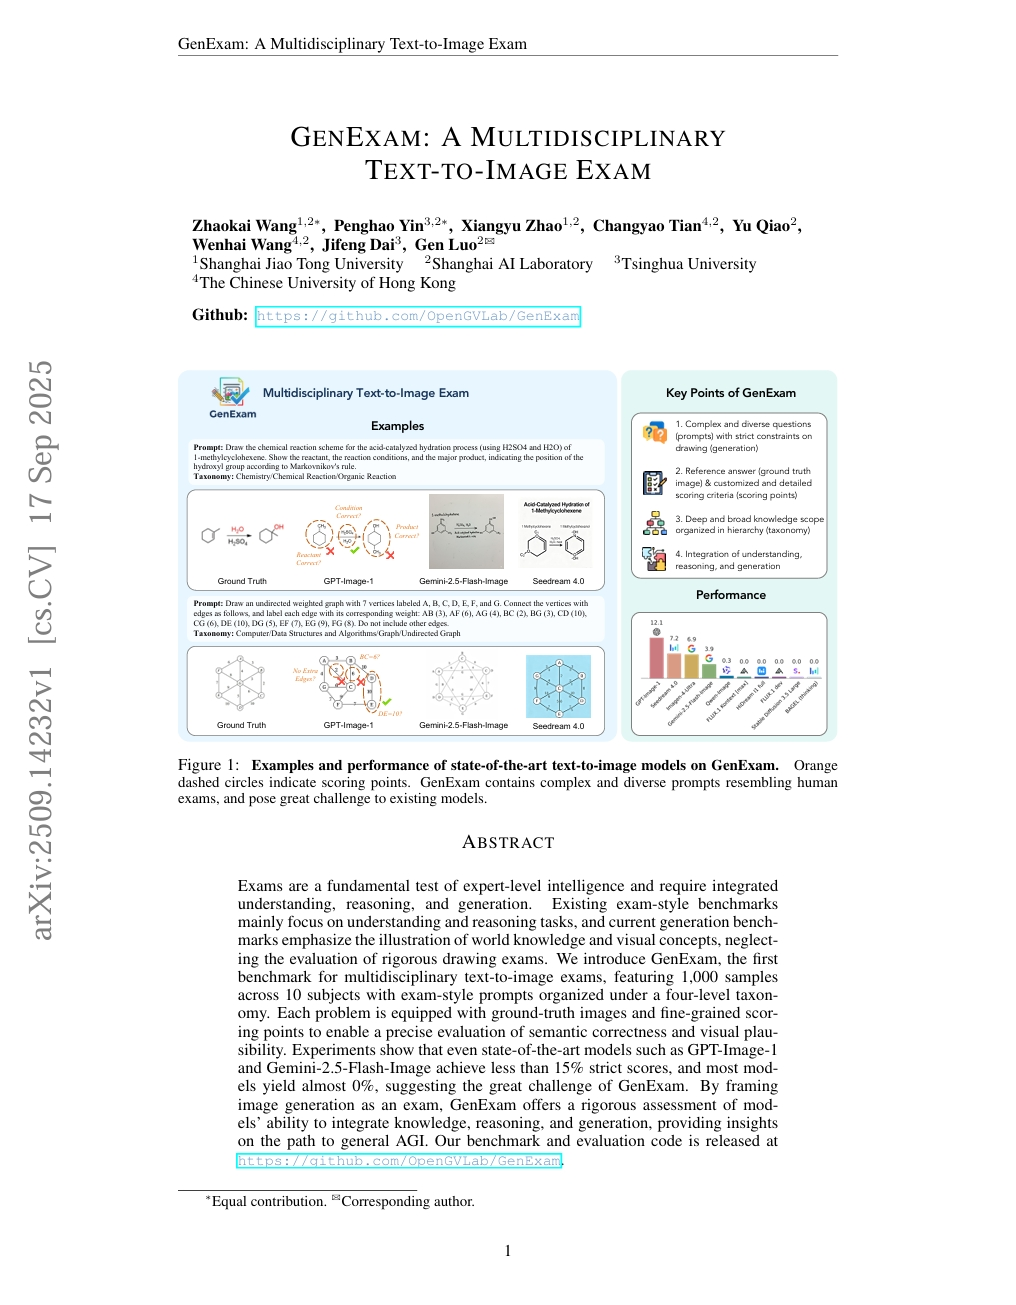
GenExam:多分野テキスト-to-画像試験
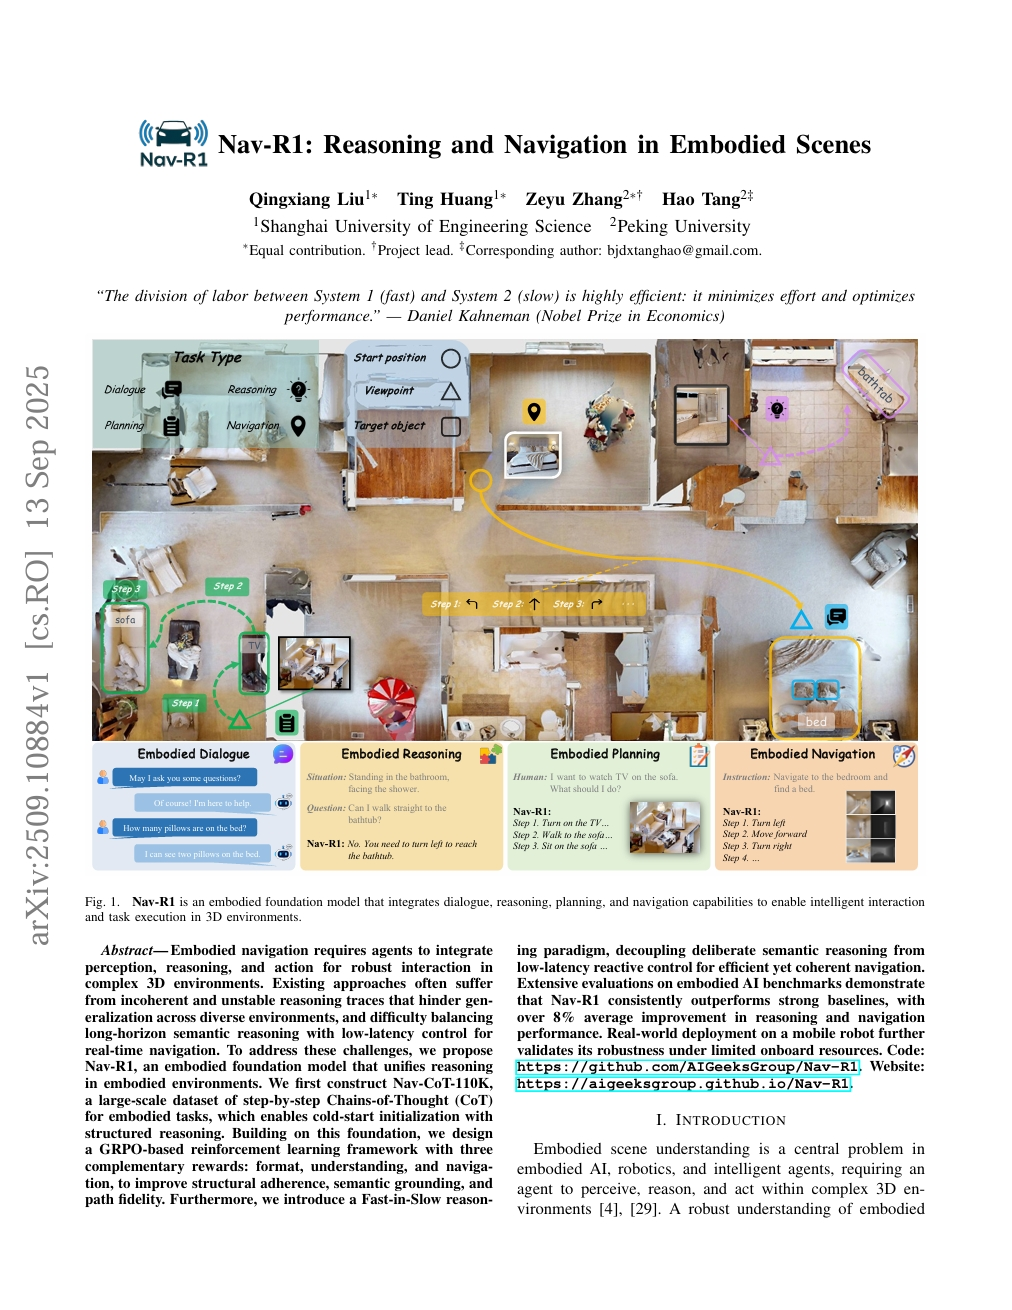
Nav-R1:身体化されたシーンにおける推論とナビゲーション
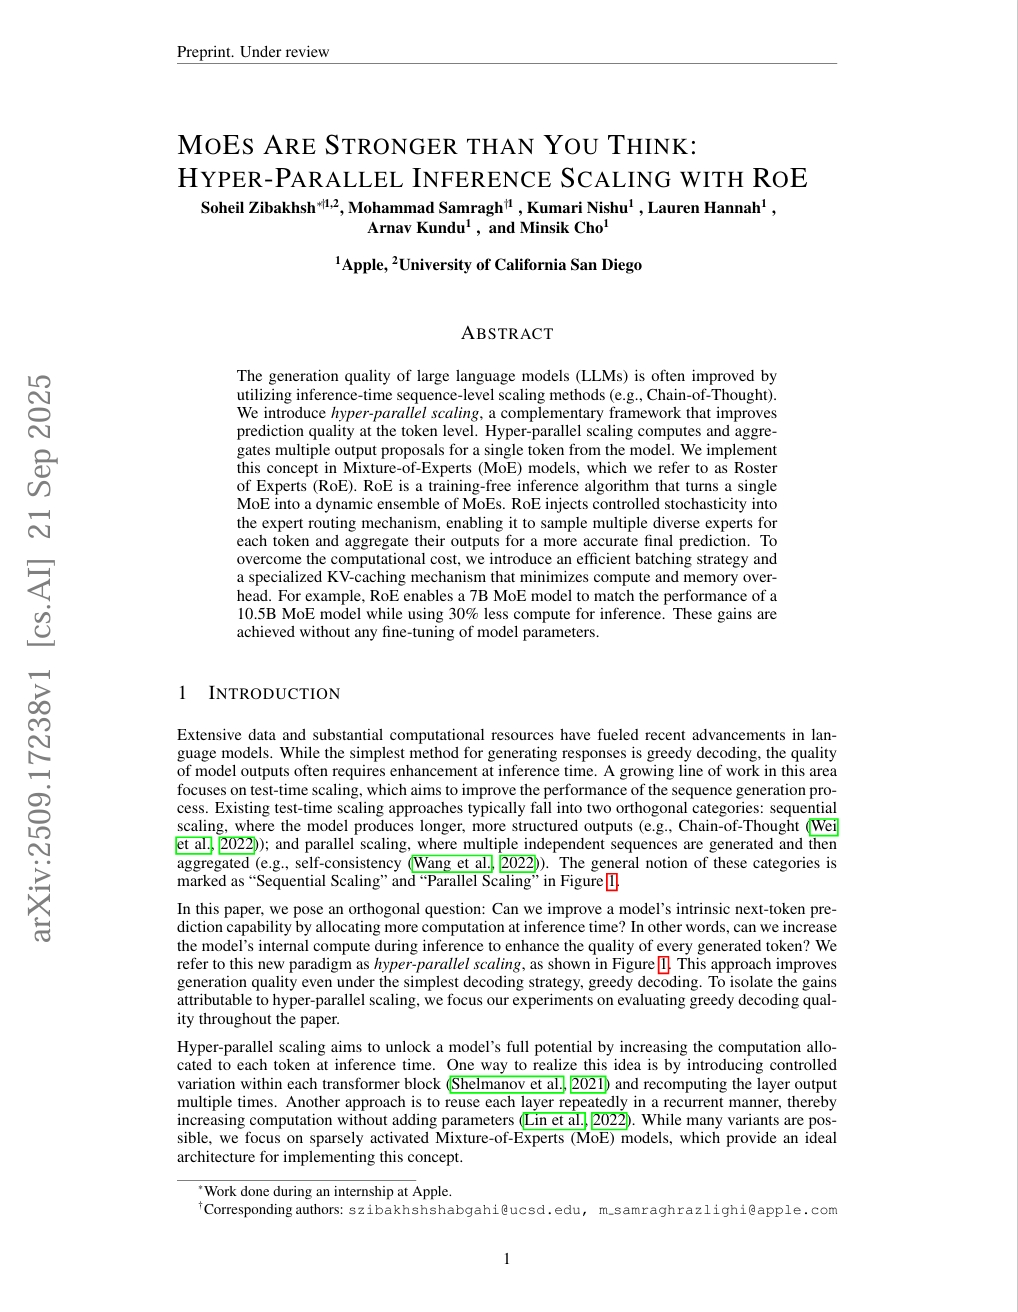
MoEはあなたが思っているよりも強い:RoEによるハイパープアラレル推論スケーリング
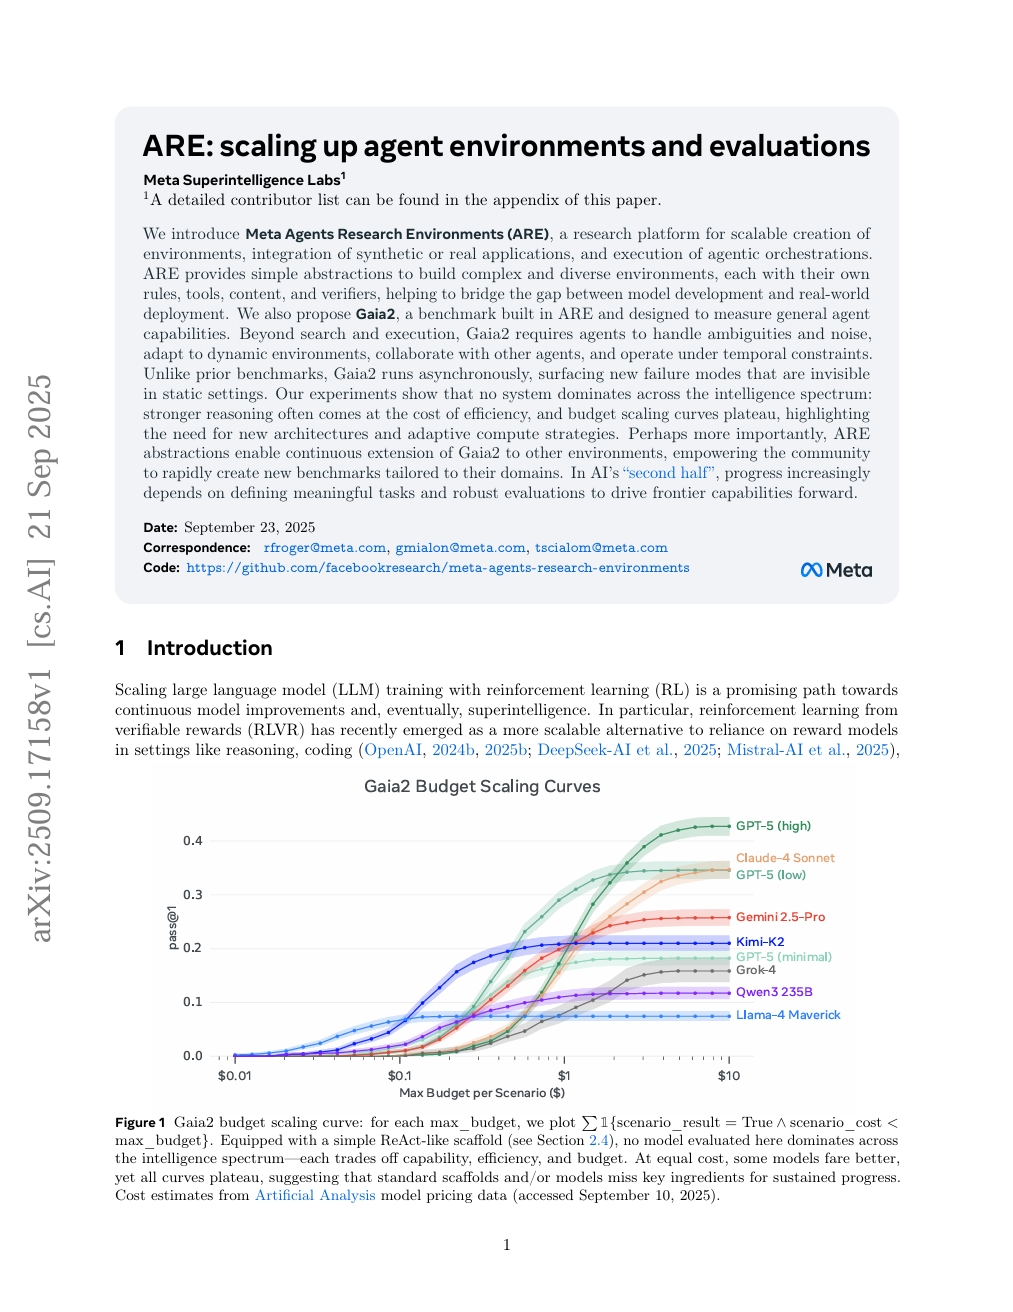
ARE:エージェント環境および評価のスケーリング
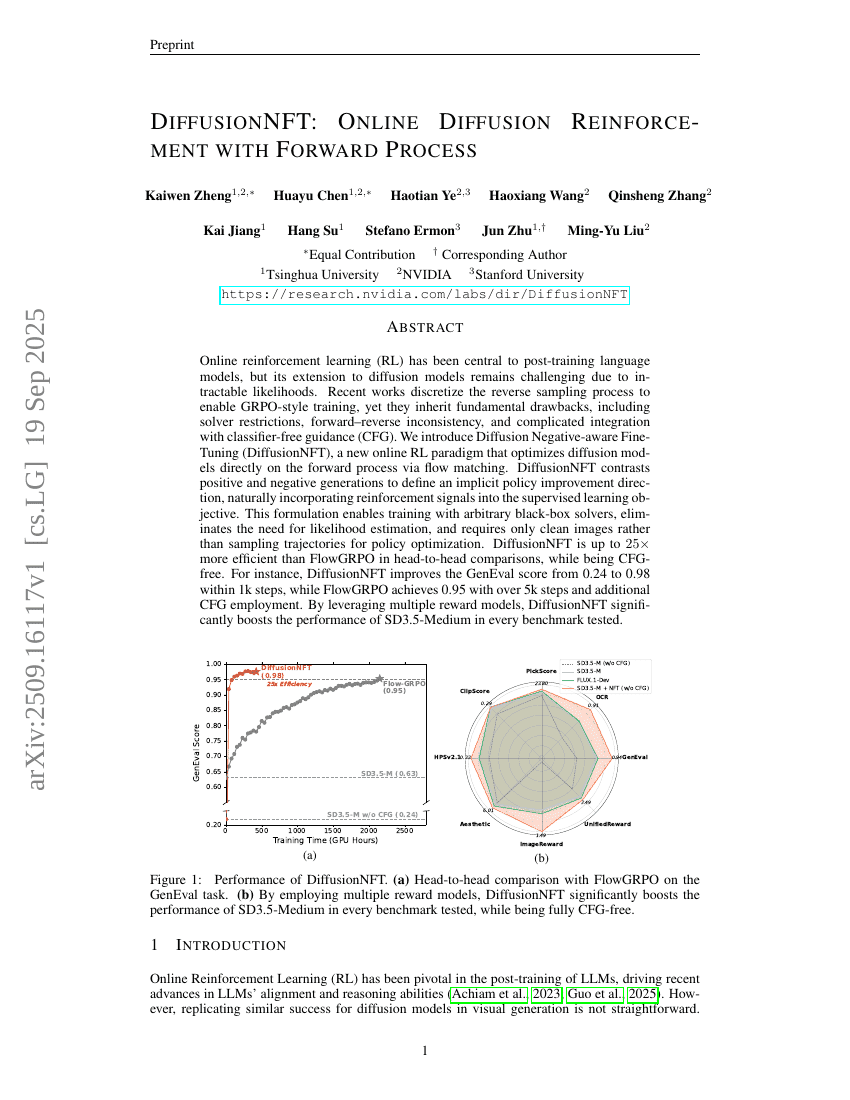
DiffusionNFT:前方過程を用いたオンラインディフュージョン強化学習
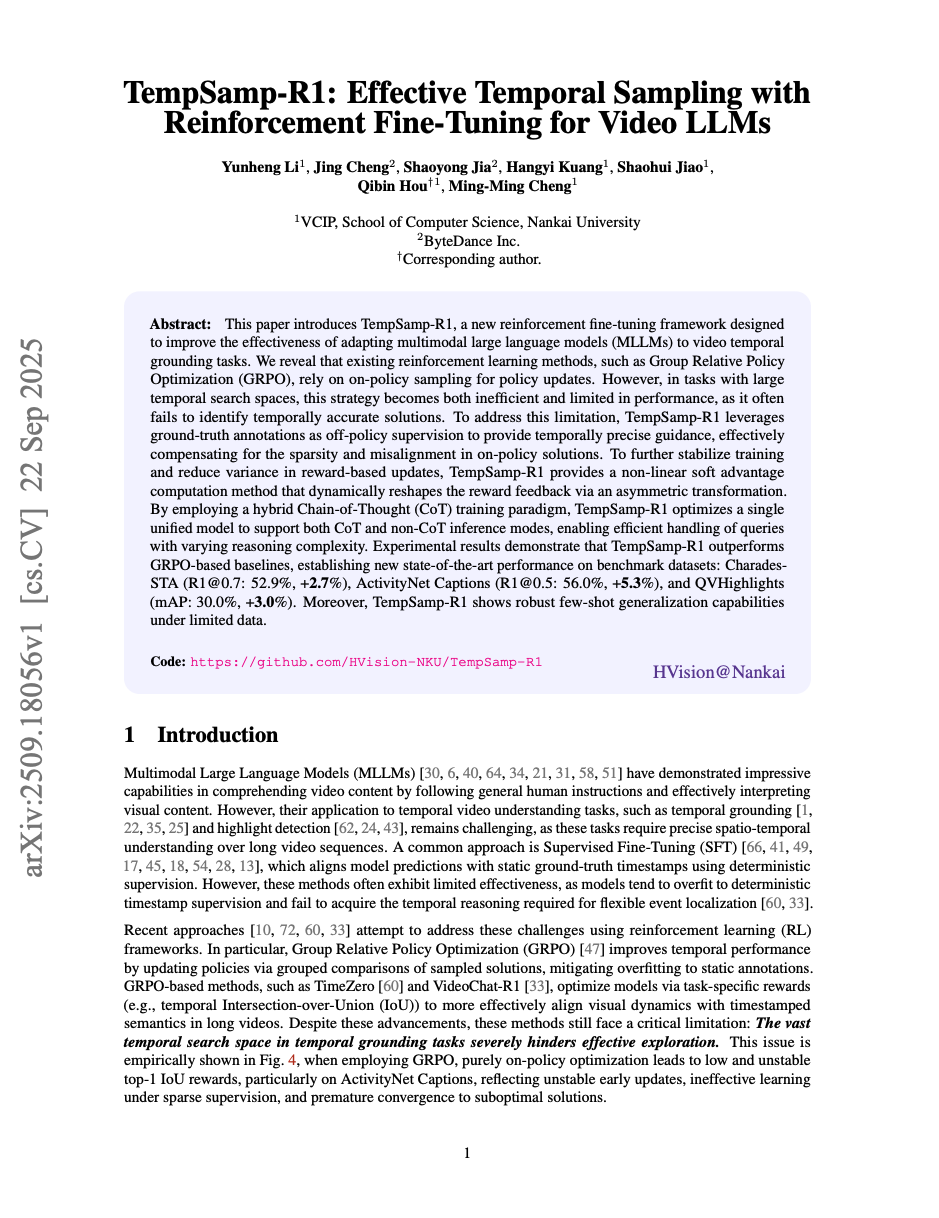
TempSamp-R1:強化学習微調整を用いた効果的な時系列サンプリングによる動画LLM向け手法
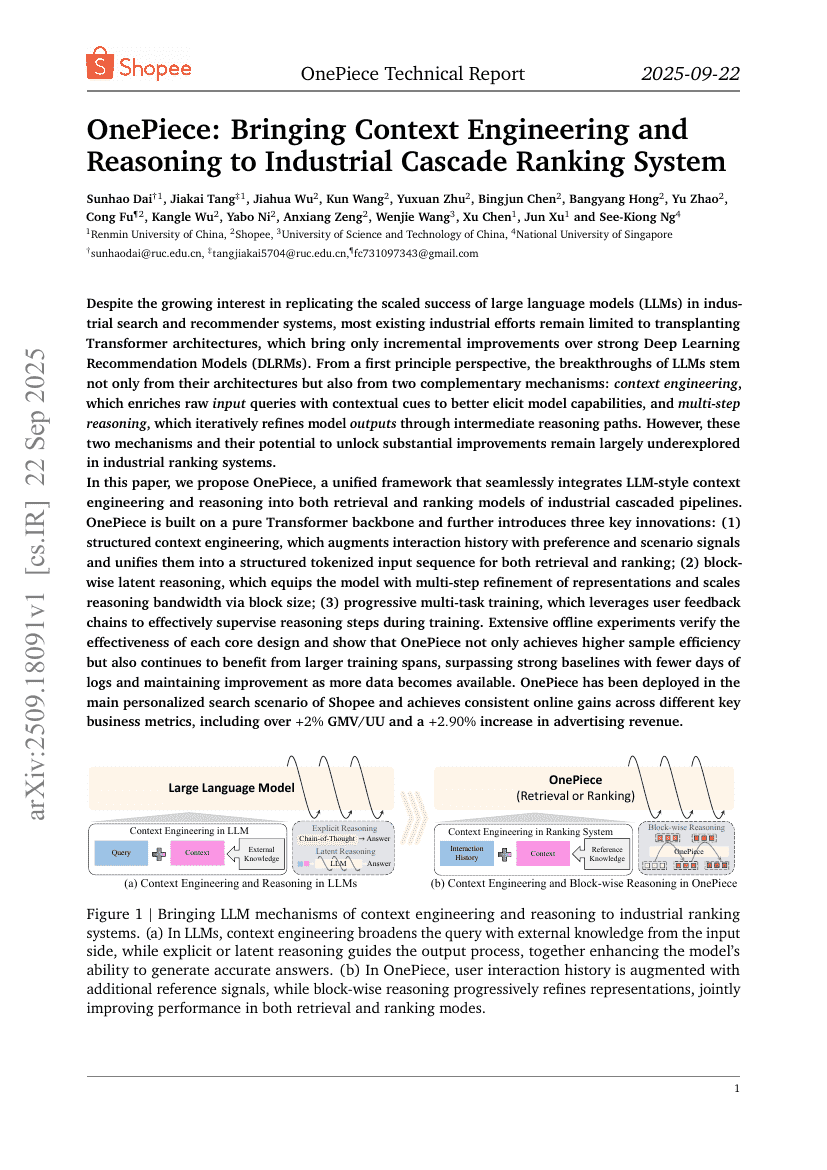
ワンピース:コンテキスト工学と推論を産業用カスケードランキングシステムに導入する
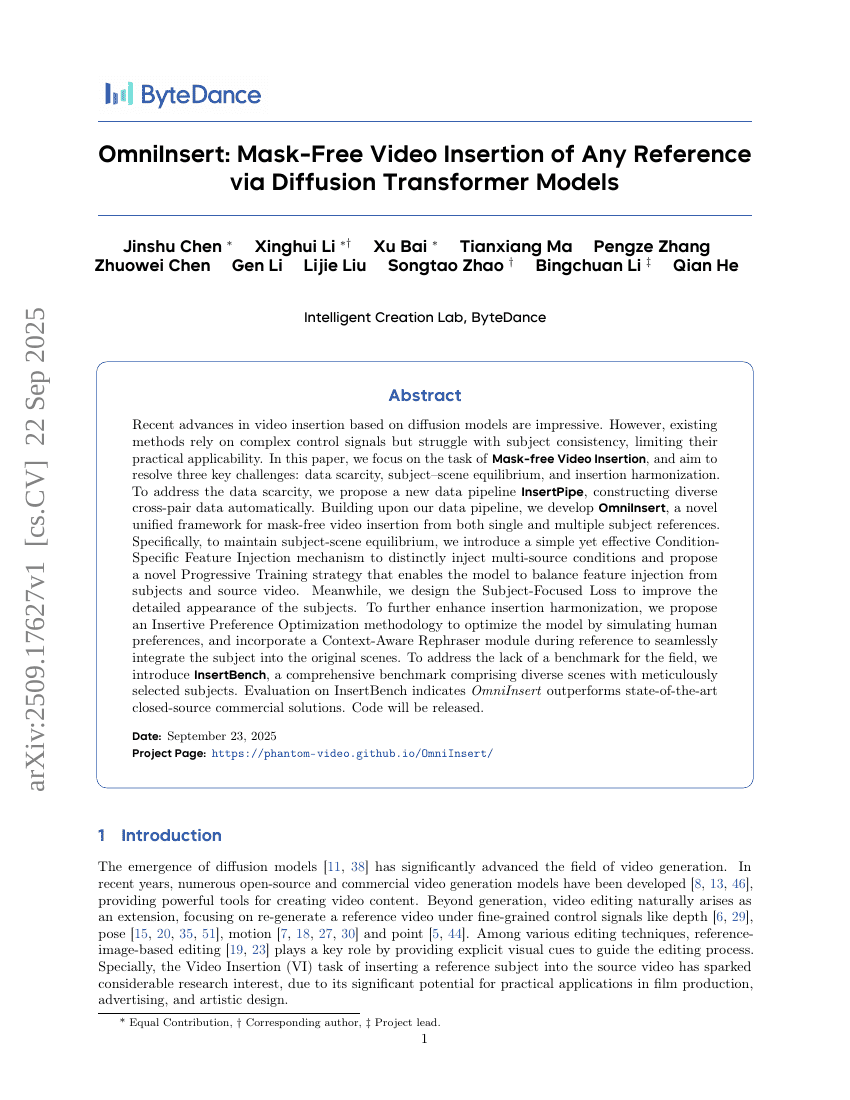
OmniInsert:拡散変換器モデルを用いた参照画像の自由なマスクフリー動画挿入