Command Palette
Search for a command to run...
3600万の細胞を同じ空間に収め、スタンフォード大学が汎用細胞埋め込みモデルUCEを提案、8種の種を横断した超大規模細胞アトラスを構築

過去数年にわたり、細胞生物学は細胞が示しうるさまざまな表現型、異なる状態間の相互関係、そして発生や疾患の過程で細胞がこれらの状態間をどのように遷移するかを描き出すことに注力してきた。
単一細胞RNAシーケンシング(scRNA-seq)データセットの規模の大幅な拡大は、この種の問題を再検討する新たな機会を提供している。しかし、既存の計算手法は、これらの極めて多様なデータセットを統合的に解析する際に依然として困難に直面している。これは、モデルが種特異的な制約、データセット特異的なアーティファクト、またはバッチ効果の影響を受ける可能性があるためである。scRNA-seqデータ向けの一部の計算手法は、いくつかの限界を克服できるが、その代償として、新しいデータセットのたびにモデルを特別にチューニングする必要がある。
このような背景の中、スタンフォード大学の研究チームは、ユニバーサル細胞埋め込み(universal cell embedding、UCE)基盤モデルを提案した。 UCEは独自の能力を持つ:モデルの微調整や再トレーニングを必要とせずに、新しい単一細胞遺伝子発現データセットの表現を生成しつつ、データセット特異的およびバッチ特異的なアーティファクトに対するロバスト性を維持することができる。さらに、UCEは細胞型のアノテーションを必要とせず、入力データセットに対する遺伝子スクリーニングなどの前処理も要求しない。UCEは、任意の種由来の任意のタンパク質コード遺伝子セットに適用でき、たとえこれらの遺伝子がモデルのトレーニング中に見た遺伝子と相同関係にない場合でも適用可能である。このようにして、UCEは普遍的で内在的な生物学的意味を持つ細胞生物学の表現を学習し、研究者が実験の直接的な観測データを超えた生物学的洞察を得ることを可能にする。
関連する研究成果は「Universal cell embedding provides a foundation model for cell biology」と題され、Natureに掲載された。
研究のハイライト:
-
新しい細胞データに対して、データのアノテーション、モデルの再トレーニング、微調整を必要とせずに、UCEはこれを統一された表現空間にマッピングできる
-
UCEが学習した表現は、細胞型と細胞状態の創発的な組織構造を示し、既知の生物学的法則と一致している
-
UCEは新しいデータを、アノテーション済みの参照細胞状態がすでに存在するユニバーサル埋め込み空間にマッピングできる
論文アドレス:
https://www.nature.com/articles/s41586-026-10689-z
3,600万以上の細胞からなるIMAトレーニングデータセットの構築
研究チームは、Integrated Mega-scale Atlas(IMA)と呼ばれるトレーニングデータセットを構築し、さまざまな公開ソースからの単一細胞RNAシーケンシングデータを統合した。UCEのコアトレーニングデータは3,600万以上の細胞を含み、 その大部分(合計3,390万細胞、285データセット)はヒトとマウスに由来し、残りは28のデータセットからの230万細胞で構成され、8つの異なる種(ヒト、マウス、ゼブラフィッシュ、アカゲザル、カニクイザル、マーモセット、カエル、ブタ)をカバーしている。
IMAの可視化、グリーンモンキー細胞型の予測、新種の細胞型セントロイドとのマッチング、Norn様細胞の予測において、研究者らは完全な3,600万細胞を使用せず、IMAの代表的なサンプルを採用した。 これは、UMAP計算などの計算負荷の高いタスクを高速化するためである。この代表的なサンプルは、各データセットからランダムに10,000細胞を非復元抽出で選択して構築された。細胞数が10,000未満のデータセットについては、データセット全体が直接含まれた。最終的に得られた代表的なサンプルは合計2,969,114細胞を含み、サンプル内の各データセットは平均9,486細胞を含む。
モデルを真に「未知の」データで評価するために、論文ではトレーニングに参加していない複数のデータセットも使用された。例えば、Tabula Sapiens v.2は581,430細胞、27組織、167バッチ、162のユニークな細胞型を含み、論文の重要なゼロショットテストデータセットである。 研究チームはまた、グリーンモンキー、ハダカデバネズミ、ニワトリなど、トレーニング段階で見たことのない種のデータも準備し、UCEが真に種を超えた汎化能力を持つかをテストした。これらのデータに加えて、論文ではマウス腎臓、ヒト肺疾患などのデータもさらに分析し、UCEが既存の細胞アトラスから新しい生物学的関係を発見できるかを検証した。
論文で分析されたすべてのデータセットは公開されており、ダウンロード可能である:
-
グリーンモンキー肺およびリンパ節データセット:アクセッション番号GSE156755
-
ハダカデバネズミデータセット:アクセッション番号GSE132642
-
ニワトリ網膜データセット:アクセッション番号GSE159107
-
ニワトリ心臓データセット:アクセッション番号GSE149457
-
マウス腎臓データセット:アクセッション番号GSE193321
-
ヒト肺疾患データセット:アクセッション番号GSE136831
UCE:生物学的情報に基づく細胞基盤モデル
UCEは、細胞を「RNAバッグ(bags of RNA)」として抽象化することで、scRNA-seqデータセットの統合における課題を克服している。
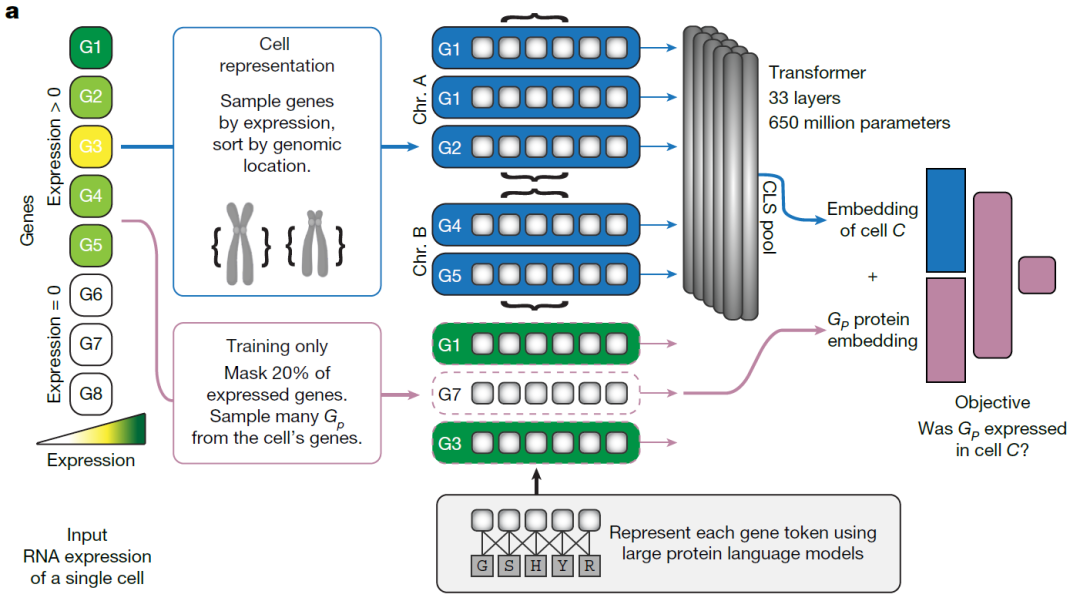
UCEは完全に自己教師あり方式で訓練されており、細胞型のアノテーションやデータセットベースのアノテーション情報を一切使用しません。 下図に示すように、UCEはまず単一細胞のRNA遺伝子発現データを、発現量で重み付けされた遺伝子サンプルに変換し、その後、タンパク質言語モデルを用いて、これらの遺伝子がコードするタンパク質に基づいてサンプル内の遺伝子を表現します。これにより、UCEはタンパク質配列のみに基づいて、任意の生物種由来の任意のタンパク質コード遺伝子を、その生物種が訓練データに含まれているかどうかにかかわらず、有意義に特徴付けることができます。遺伝子の染色体上の位置などのメタデータをさらに統合した後、この表現は大規模なTransformerモデルに入力されます。これにより、UCEは追加の訓練を必要とせずに、任意の組織または生物種由来の細胞を、共有の普遍的な空間にマッピングすることができます。
*UCEモデルの概要*
UCEの入力は2つの部分で構成されます: (1)scRNA-seqカウントデータ、(2)タンパク質言語モデルESM2を用いて生成された、データセット内の遺伝子に対応するタンパク質埋め込み。 ESM2タンパク質言語モデルはアミノ酸配列を入力として受け取り、タンパク質埋め込み(protein embedding)と呼ばれる数値表現を出力します。
ある細胞の遺伝子発現カウントデータについて、UCEは発現量に従って重み付けし正規化した上で、重複抽出を許可しながら、その細胞内の遺伝子をサンプリングします。このサンプルには、非ゼロの発現量を持つ遺伝子のみを含めることができ、同じ遺伝子がサンプル内に複数回出現することもあります。その後、これらの遺伝子はトークン化(tokenized)され、すなわち、それらがコードするタンパク質のタンパク質埋め込み表現に変換されます。
同じ染色体に属する遺伝子は、特別なマーカーを配置することでグループ化され、ゲノム上の位置に従ってソートされます。その後、細胞全体の表現の最前端に、細胞全体を表す特別なマーカー、すなわちCLSトークンが追加されます。組み合わせられた表現はTransformerニューラルネットワークに入力され、細胞の最終的な埋め込みは、Transformerの最終層におけるCLSトークンに対応する埋め込みから取得されます。
成果:実験による直接的な観測データを超えた生物学的洞察の獲得
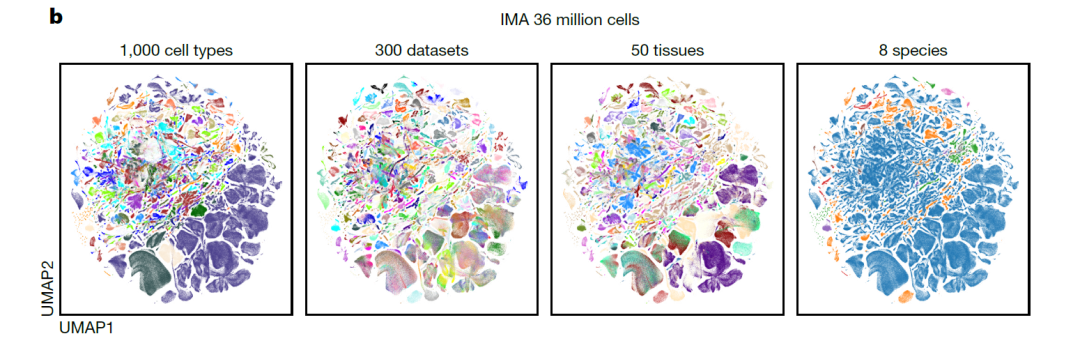
UCEに基づき、研究者らはさらに統合メガスケール細胞アトラス(Integrated Mega-scale Atlas)を構築し、3,600万個の細胞の埋め込みを行いました。これには、1,000種類以上の一意な名称を持つ細胞型が含まれます。この統一された空間を利用することで、異なる細胞型と組織がその中でどのように組織化されているかをさらに分析することが可能になりました。
UCEの埋め込み空間は、創発的能力(emergent behaviour)を示します
研究により、UCE空間では、細胞は細胞型などの生物学的条件に基づいて自然にクラスタリングされると同時に、異なる実験条件下の細胞、例えば異なるバッチ由来の細胞は、互いに混合できることがわかりました(下図b)。UCEは訓練中にラベルなしデータのみを使用したため、この組織構造はモデルが明示的に訓練された結果ではなく、モデル自身の創発的行動です。
*UCE空間の統一された多様体近似と投影(UMAP)可視化*
研究チームはさらに、組織の由来が異なる細胞型の状態にどのように影響するかを調査しました。異なる組織由来のマクロファージは多様なトランスクリプトーム特徴を持っていますが、UCE空間では依然として高度に整列することができます。例えば、ヒトのマクロファージは73種類の異なる組織に分布しており、そのうち72%(53個)の組織特異的マクロファージの重心は、UCE空間において最も近い細胞が他の組織由来のマクロファージの重心となっています。
同様の組織横断的な一貫性は、内皮細胞やニューロンなど、他の多く存在する細胞型でも観察できます。これは、UCEが明示的な訓練や人工ラベルを必要とせずに、マクロファージが持つ、組織間で共有される独自の細胞同一性を認識できることを示しています。これはまさに、既知の生物学の法則と一致するUCEの創発的な組織構造であり、モデルはこの現象について特別に訓練されていないにもかかわらずです。
新しいデータセットのゼロショット埋め込み
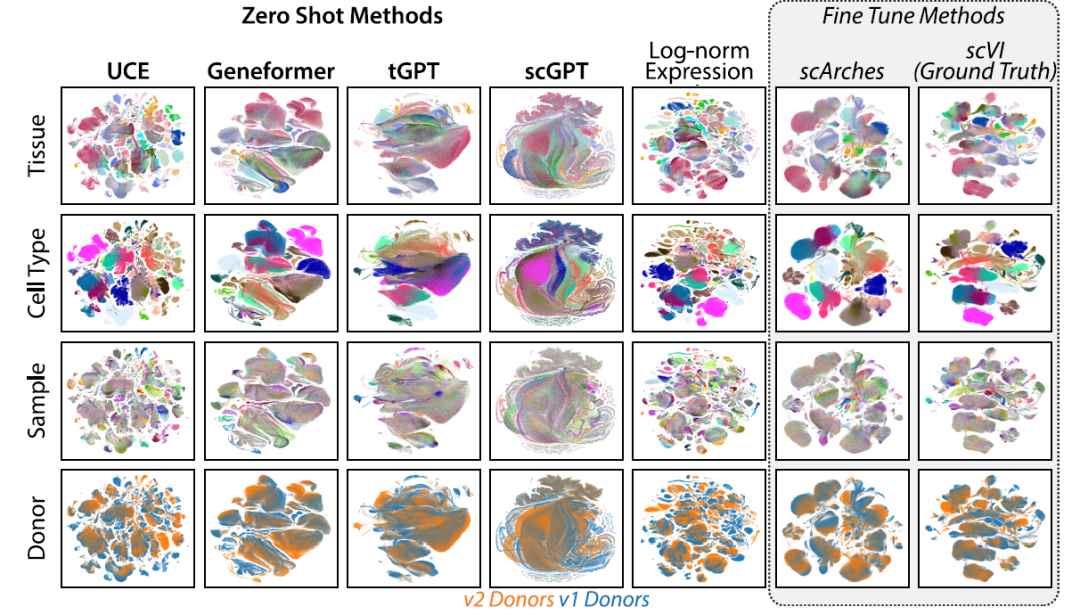
研究者らは、まだ発表されていない新しいデータセットTabula Sapiens v.2において、UCEのゼロショット性能を評価しました。結果は、UCEの総合スコアが最も優れたGeneformerより13.9%高く、そのうち生物学的情報保持スコアは16.2%、バッチ効果補正スコアは10.1%高いことを示しました。他の方法と比較して、UCEが生成する埋め込みは、異なる細胞型をより明確に区別することができます(下図参照)。
*UCEはTabula Sapiens v2の統合において既存の方法より優れています*
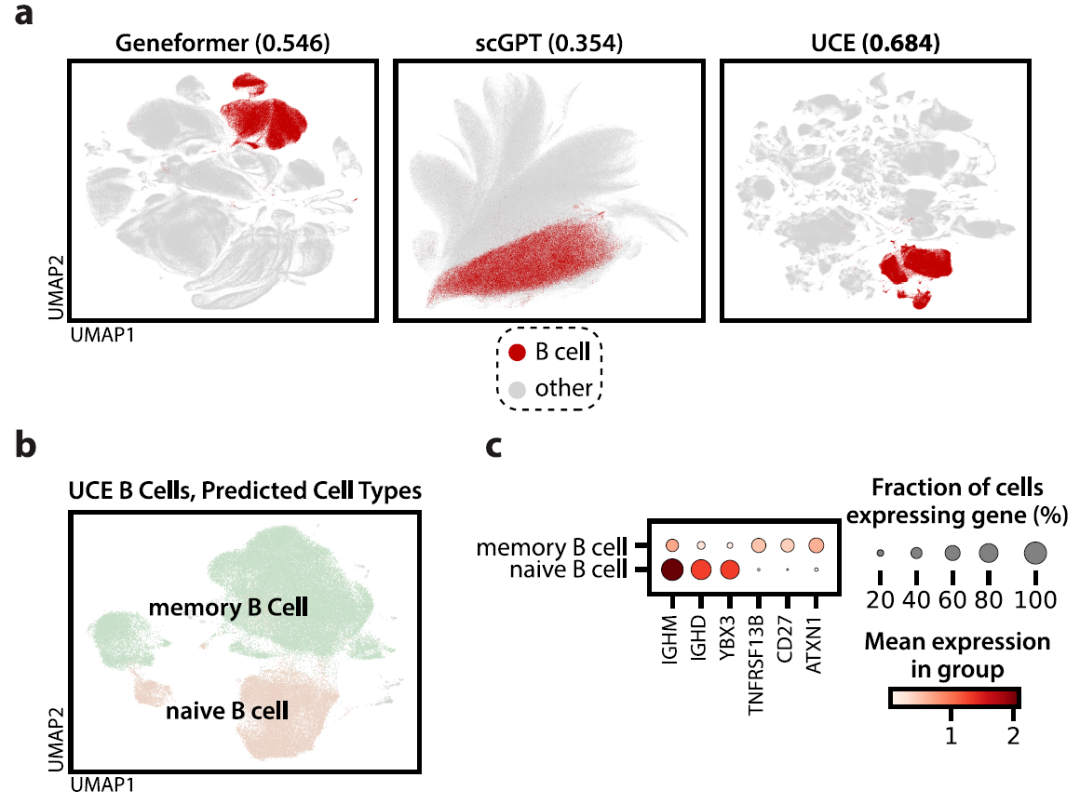
*UCEはTabula Sapiens v2におけるB細胞の同一性を再捕捉できます*
新しい生物種のゼロショット埋め込み
研究者らはさらに、UCEの性能を、現在最先端のクロス種ラベル転移教師あり手法であるSATURNおよびSAMapと比較した。4つのデータセットのうち3つにおいて、UCEはヒトと新規種間での細胞型ラベル転移において、依然としてSATURNおよびSAMapを上回る性能を示した。UCEは、ショウジョウバエなど、高度に進化的に分化した種に対しても、一貫性のあるゼロショット埋め込みを生成することができた。
新規データにおける細胞型の組織構造
個々の細胞型クラスタリングの評価指標に注目するだけでなく、研究チームは全体レベルでも汎用埋め込み空間の構造、すなわち異なる細胞がその空間内でどのような相対的位置関係にあるかを考察した。Tabula Sapiens v.2の肺組織由来の全細胞を埋め込んだところ、明確な生物学的意味を持つ細胞型の組織構造が観察された(下図a)。異なる細胞型はそれぞれクラスタリングされるだけでなく、例えばT細胞、単球、内皮細胞は明確なクラスターを形成し、さらに免疫細胞や上皮細胞といったより高次の細胞カテゴリーも明確に区別された。
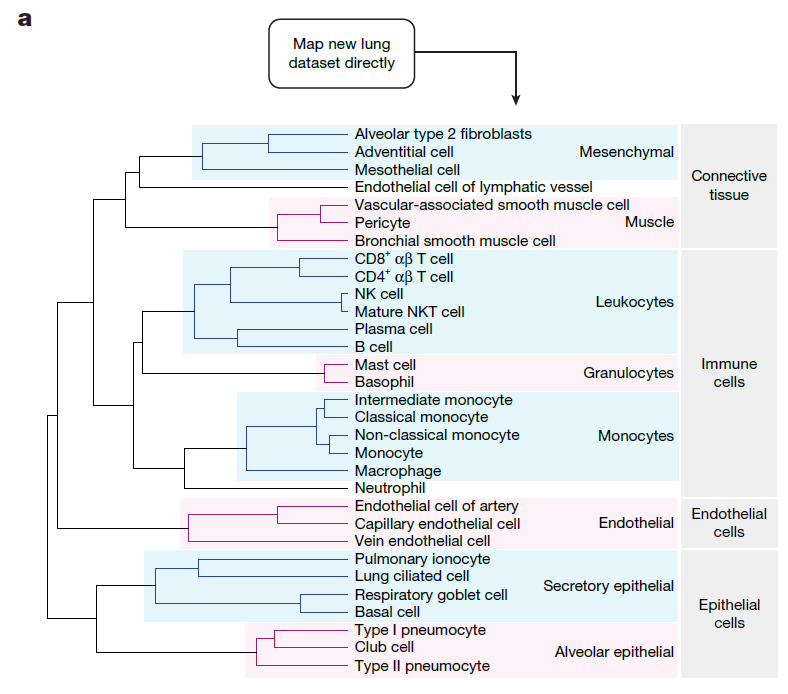
*新規かつ未見のデータに対して生成されたUCE空間は、生物学的意味を持つ細胞型の組織構造を示す*
研究者らはさらに、この結果を細胞オントロジーに基づく細胞階層構造と比較した。その結果、他のゼロショット埋め込み手法と比較して、UCEが識別した細胞クラスターはCell Ontologyとの間でより高い類似性を示した。
さらに実験を進めたところ、UCEは普遍的な細胞生物学の表現を効果的に学習できることが示された。この表現は異なる細胞型を区別できるだけでなく、異なるスケールにおける細胞型間の相対的な類似性も捉えることができ、これにより細胞の発生と機能の背後にあるより深層の生物学的法則をさらに解明できる可能性がある。
UCEによる肺疾患転帰の解析
最後に、研究者らはUCEと、以前に構築したNorn細胞分類器を用いて、肺疾患におけるNorn様細胞を研究した。具体的には、特発性肺線維症(idiopathic pulmonary fibrosis、IPF)、慢性閉塞性肺疾患(chronic obstructive pulmonary disease、COPD)の患者および対照群の患者から採取した肺細胞をサンプリングし、その細胞埋め込み空間を生成した。3つの患者群すべてにおいて、Nornマーカー遺伝子の偏好的発現を示すNorn様肺細胞が同定された(下図d)。さらに分析を進めると、これらのNorn様肺細胞は疾患群間で発現差を示すことが明らかになった(下図e)。
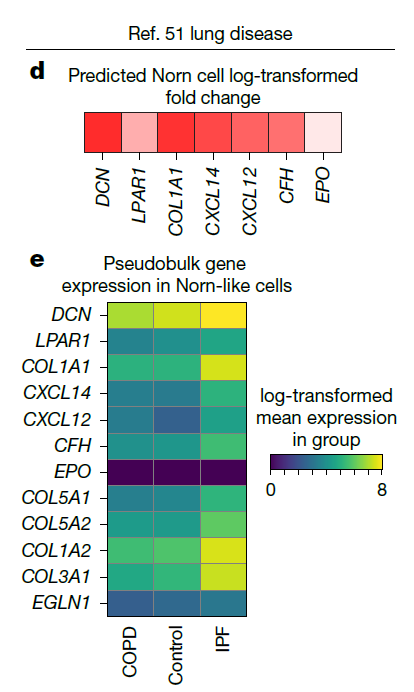
*Norn細胞のケーススタディは、UCEが単一細胞データセットのさらなる解析をサポートできることを示している*
COPDとIPFはどちらも血液中のEpoレベルの上昇と関連しているが、COPD患者のEpoレベルはIPF患者よりも高い。さらに、IPF患者ではCOPD患者と比較して、続発性赤血球増加症(secondary erythrocytosis)は顕著ではないか、その発生程度が低い。研究で肺組織においてNorn様細胞が発見され、Norn細胞がEpoを産生できることを踏まえると、これら2つの疾患における予後の差は、疾患に関連するNorn様細胞の差異と関連している可能性がある。
総合的に見ると、これらの結果は、生体の他の組織においてもNorn細胞と類似した転写状態を持つ細胞が発見され得ること、そしてこれらの細胞が疾患プロセスにおいてこれまで記載されていなかった役割を果たす可能性があることを示している。UCEは組織、種、または疾患状態に制限されない汎用モデルであるため、このような大規模かつ多様なデータの解析を大幅に促進することができる。
結語
UCEを構築することで、研究者らはscRNA-seqデータを解析する能力をさらに拡張した。このモデルは汎用細胞埋め込みへの重要な一歩を表しているが、依然としていくつかの限界が存在する。現在のベンチマークテストは主に、UCEが専門家によってアノテーションされた細胞型を復元する能力を評価しているが、この種のタスク自体が既存の細胞ラベルの粒度と主観性に制約されている。したがって、これらの評価は、細胞の撹乱への応答や異なるモダリティデータ間の統合など、より微妙な生物学的プロセスをモデルが表現する能力を十分に反映していない可能性がある。さらに、他の大規模生物学基盤モデルと同様に、UCEは依然として大部分がブラックボックスモデルであり、特定の埋め込みがなぜ、どのように形成されるのかを説明することは困難である。この不透明性を解決するには、モデルが学習した表現と生物学的メカニズムレベルの理解を結びつける、解釈可能性ツールのさらなる開発が必要である。UCEのトレーニングデータは大規模ではあるが、依然として哺乳類種、特にヒトとマウスに偏っており、また脳組織などの特定の組織にも偏っているため、代表性の低い種や生物学的シナリオへのモデルの汎化に関する懸念が生じている。
最後に強調すべき点として、UCEは異なるデータセット間で共有される生物学的シグナルを捉えることでデータのアライメントを改善できるものの、従来のバッチ効果補正手法の代替にはならない。既知の実験的交絡因子を処理する上では、従来手法が依然として重要な価値を持つ。
参考文献: