Command Palette
Search for a command to run...
3600万细胞装入同一空间,斯坦福大学提出通用细胞嵌入模型UCE,跨越8个物种构建超大规模细胞图谱

Au cours des dernières années, la biologie cellulaire s'est efforcée de décrire les différents phénotypes que les cellules peuvent présenter, les relations entre les différents états, ainsi que la manière dont les cellules effectuent des transitions entre ces états au cours du développement et de la maladie.
L'augmentation considérable de la taille des ensembles de données de séquençage d'ARN sur cellules uniques (scRNA-seq) offre une nouvelle opportunité de réexaminer ce type de questions. Cependant, les méthodes de calcul existantes rencontrent encore des difficultés pour analyser conjointement ces ensembles de données très diversifiés, car les modèles peuvent être affectés par des limitations spécifiques à l'espèce, des artefacts spécifiques à l'ensemble de données ou des effets de lot. Certaines méthodes de calcul pour les données scRNA-seq ont pu surmonter certaines de ces limitations, mais au prix de : un ajustement spécialisé du modèle est nécessaire pour chaque nouvel ensemble de données.
Dans ce contexte, l'équipe de recherche de l'Université de Stanford a proposé le modèle de fondation d'incorporation cellulaire universelle (universal cell embedding, UCE). L'UCE possède une capacité unique : il génère des représentations pour de nouveaux ensembles de données d'expression génique sur cellules uniques sans nécessiter d'ajustement ou de réentraînement du modèle, tout en maintenant une robustesse face aux artefacts spécifiques à l'ensemble de données et aux artefacts spécifiques au lot. De plus, l'UCE ne nécessite ni annotation de type cellulaire, ni prétraitement tel que le filtrage des gènes sur les ensembles de données d'entrée. L'UCE peut être appliqué à n'importe quel ensemble de gènes codant pour des protéines provenant de n'importe quelle espèce, même si ces gènes n'ont pas de relation d'homologie avec les gènes vus lors de l'entraînement du modèle. De cette manière, l'UCE apprend une représentation de la biologie cellulaire qui est universelle et intrinsèquement significative sur le plan biologique, permettant aux chercheurs d'obtenir des informations biologiques qui vont au-delà des données directement observées expérimentalement.
Les résultats de la recherche associée ont été publiés dans Nature sous le titre « Universal cell embedding provides a foundation model for cell biology ».
Points forts de la recherche :
-
Pour les nouvelles données cellulaires, sans annotation des données, réentraînement du modèle ou ajustement, l'UCE peut les mapper dans cet espace de représentation unifié
-
Les représentations apprises par l'UCE présentent une structure organisationnelle émergente des types et états cellulaires, et sont cohérentes avec les lois biologiques connues
-
L'UCE peut mapper de nouvelles données dans un espace d'incorporation universel, où existent déjà des états cellulaires de référence annotés
Adresse de l'article :
https://www.nature.com/articles/s41586-026-10689-z
Construction d'un ensemble de données d'entraînement IMA de plus de 36 millions de cellules
L'équipe de recherche a construit un ensemble de données d'entraînement nommé Integrated Mega-scale Atlas (IMA), intégrant des données de séquençage d'ARN sur cellules uniques provenant de différentes sources publiques. Les données d'entraînement centrales de l'UCE contiennent plus de 36 millions de cellules, dont la grande majorité (33,9 millions de cellules, 285 ensembles de données) provient de l'humain et de la souris, le reste étant composé de 2,3 millions de cellules provenant de 28 ensembles de données, couvrant 8 espèces différentes : humain, souris, poisson zèbre, macaque rhésus, macaque crabier, microcèbe, grenouille et porc.
Lors de la visualisation de l'IMA, de la prédiction des types cellulaires du singe vert, de l'appariement des centroïdes des types cellulaires de nouvelles espèces et de la prédiction des cellules de type Norn, les chercheurs n'ont pas utilisé les 36 millions de cellules complètes, mais ont plutôt utilisé un échantillon représentatif de l'IMA, afin d'accélérer les tâches de calcul intensif telles que le calcul UMAP. Cet échantillon représentatif a été construit en sélectionnant aléatoirement 10 000 cellules de chaque ensemble de données, avec un échantillonnage sans remise. Pour les ensembles de données contenant moins de 10 000 cellules, l'ensemble du jeu de données a été inclus directement. L'échantillon représentatif final contient 2 969 114 cellules, avec une moyenne de 9 486 cellules par ensemble de données dans l'échantillon.
Pour évaluer les performances du modèle sur des données véritablement « inconnues », l'article utilise également plusieurs ensembles de données qui n'ont pas participé à l'entraînement du modèle. Par exemple, Tabula Sapiens v.2 contient 581 430 cellules, 27 tissus, 167 lots et 162 types cellulaires uniques, et constitue un important ensemble de données de test zero-shot pour l'article. L'équipe de recherche a également préparé des données d'espèces non vues lors de l'entraînement, comme le singe vert, le rat-taupe nu et le poulet, afin de tester si l'UCE possède réellement une capacité de généralisation inter-espèces. En plus de ces données, l'article analyse également des données sur le rein de souris, les maladies pulmonaires humaines, etc., pour vérifier si l'UCE peut découvrir de nouvelles relations biologiques à partir d'atlas cellulaires existants.
Tous les ensembles de données analysés dans l'article sont publics et peuvent être téléchargés :
-
Ensemble de données du poumon et des ganglions lymphatiques du singe vert : numéro d'accès GSE156755
-
Ensemble de données du rat-taupe nu : numéro d'accès GSE132642
-
Ensemble de données de la rétine de poulet : numéro d'accès GSE159107
-
Ensemble de données du cœur de poulet : numéro d'accès GSE149457
-
Ensemble de données du rein de souris : numéro d'accès GSE193321
-
Ensemble de données des maladies pulmonaires humaines : numéro d'accès GSE136831
UCE : un modèle de fondation cellulaire basé sur des informations biologiques
L'UCE surmonte les défis de l'intégration des ensembles de données scRNA-seq en abstraisant les cellules comme des « sacs d'ARN (bags of RNA) ».
L'UCE est entièrement entraîné de manière auto-supervisée, sans utiliser aucune annotation de type cellulaire ni annotation basée sur des ensembles de données. Comme illustré ci-dessous, l'UCE convertit d'abord les données d'expression génique RNA d'une seule cellule en un échantillon de gènes pondéré par les niveaux d'expression, puis utilise un modèle de langage protéique pour représenter les gènes de l'échantillon en fonction des protéines qu'ils codent. Cela permet à l'UCE de caractériser de manière significative tout gène codant pour une protéine provenant de n'importe quelle espèce, uniquement sur la base de la séquence protéique, sans être limité par la présence ou non de cette espèce dans les données d'entraînement. Après avoir intégré davantage de métadonnées telles que les positions chromosomiques des gènes, cette représentation est introduite dans un grand modèle Transformer. Ainsi, l'UCE est capable de mapper les cellules de n'importe quel tissu ou espèce vers un espace commun partagé, sans nécessiter d'entraînement supplémentaire.
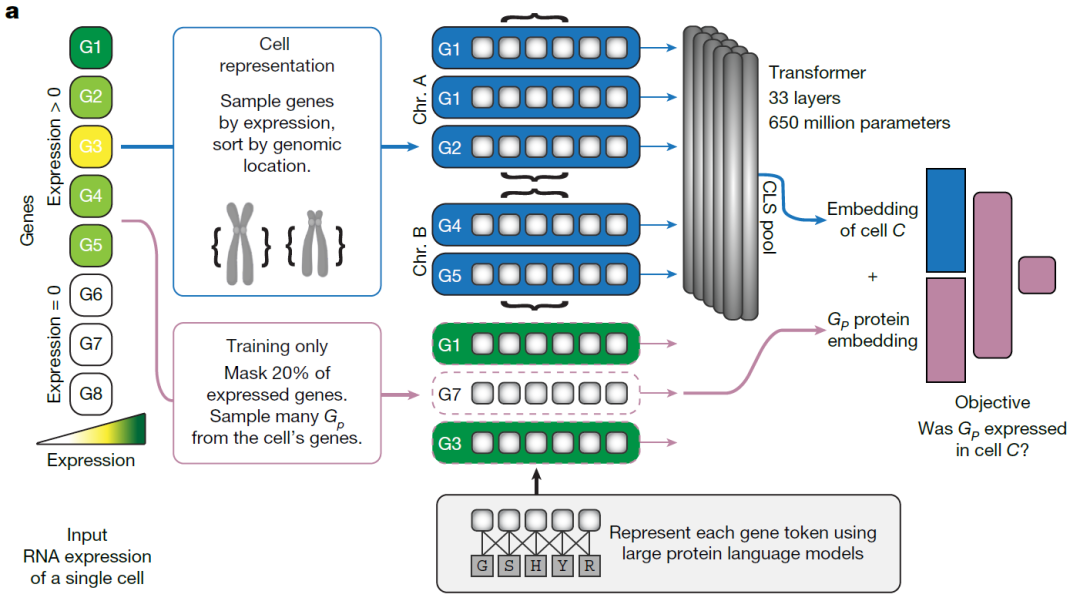
*Aperçu du modèle UCE*
L'entrée de l'UCE comprend deux parties : (1) les données de comptage scRNA-seq ; (2) les plongements protéiques générés par le modèle de langage protéique ESM2, correspondant aux gènes de l'ensemble de données. Le modèle de langage protéique ESM2 prend en entrée des séquences d'acides aminés et produit une représentation numérique appelée plongement protéique (protein embedding*).
Pour les données de comptage d'expression génique d'une cellule donnée, l'UCE pondère et normalise selon les niveaux d'expression, puis échantillonne les gènes de la cellule avec remplacement. Cet échantillon ne peut contenir que des gènes ayant une expression non nulle, et le même gène peut apparaître plusieurs fois dans l'échantillon. Ensuite, ces gènes sont tokenisés, c'est-à-dire convertis en représentations de plongements protéiques des protéines qu'ils codent.
Les gènes appartenant à un même chromosome sont regroupés en plaçant des marqueurs spéciaux, puis triés en fonction de leur position dans le génome. Ensuite, un marqueur spécial représentant la cellule entière, le token CLS, est ajouté au début de la représentation cellulaire. La représentation combinée est introduite dans un réseau neuronal Transformer, et le plongement final de la cellule est extrait du plongement correspondant au token CLS dans la dernière couche du Transformer.
Résultats : obtenir des informations biologiques allant au-delà des observations expérimentales directes
Sur la base de l'UCE, les chercheurs ont en outre construit un atlas cellulaire intégré à très grande échelle (Integrated Mega-scale Atlas), intégrant 36 millions de cellules, comprenant plus de 1 000 types cellulaires avec des noms uniques. Grâce à cet espace unifié, il est possible d'analyser plus en détail la manière dont les différents types cellulaires et tissus y sont organisés.
L'espace de plongement de l'UCE présente des capacités émergentes
L'étude a révélé que dans l'espace de l'UCE, les cellules se regroupent naturellement en fonction de conditions biologiques telles que le type cellulaire, tandis que les cellules provenant de différentes conditions expérimentales, par exemple de différents lots, peuvent se mélanger (figure b ci-dessous). Étant donné que l'UCE n'utilise que des données non annotées pendant l'entraînement, cette organisation n'est pas le résultat d'un entraînement explicite du modèle, mais plutôt un comportement émergent du modèle lui-même.
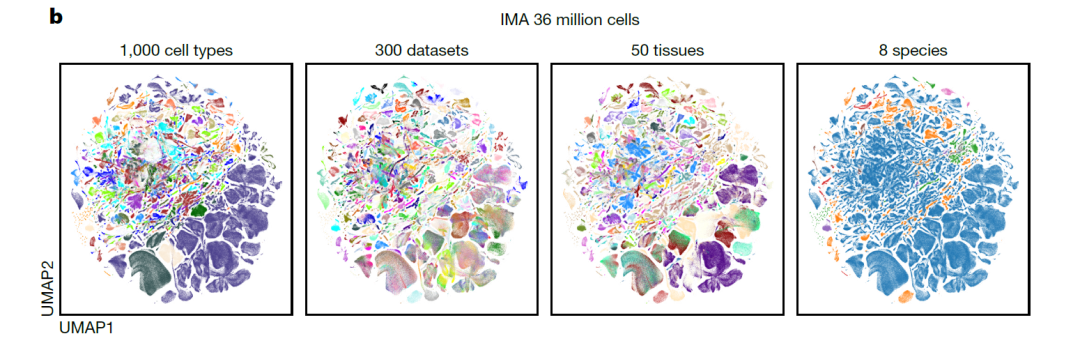
*Visualisation UMAP de l'espace unifié de l'UCE*
L'équipe de recherche a également examiné comment l'origine tissulaire influence l'état des différents types cellulaires. Bien que les macrophages provenant de différents tissus présentent des caractéristiques transcriptomiques diverses, ils restent fortement alignés dans l'espace de l'UCE. Par exemple, les macrophages humains sont répartis dans 73 tissus différents, et pour 72 % (53) des centroïdes de macrophages spécifiques aux tissus, le centroïde le plus proche dans l'espace de l'UCE est celui de macrophages provenant d'autres tissus.
Une cohérence inter-tissus similaire peut également être observée dans d'autres types cellulaires abondants, tels que les cellules endothéliales et les neurones. Cela indique que l'UCE, sans entraînement explicite ni étiquettes artificielles, est capable d'identifier l'identité cellulaire distincte des macrophages, partagée entre les tissus. C'est une organisation émergente de l'UCE conforme aux lois biologiques connues, bien que le modèle n'ait pas été spécifiquement entraîné pour ce phénomène.
Plongement en zero-shot sur de nouveaux ensembles de données
Les chercheurs ont évalué les performances en zero-shot de l'UCE sur un nouvel ensemble de données non encore publié, Tabula Sapiens v.2. Les résultats montrent que le score global de l'UCE est supérieur de 13,9 % à celui du meilleur Geneformer, avec un score de préservation des informations biologiques supérieur de 16,2 % et un score de correction des effets de lot supérieur de 10,1 %. Par rapport à d'autres méthodes, les plongements générés par l'UCE permettent de distinguer plus clairement les différents types cellulaires (voir figure ci-dessous).
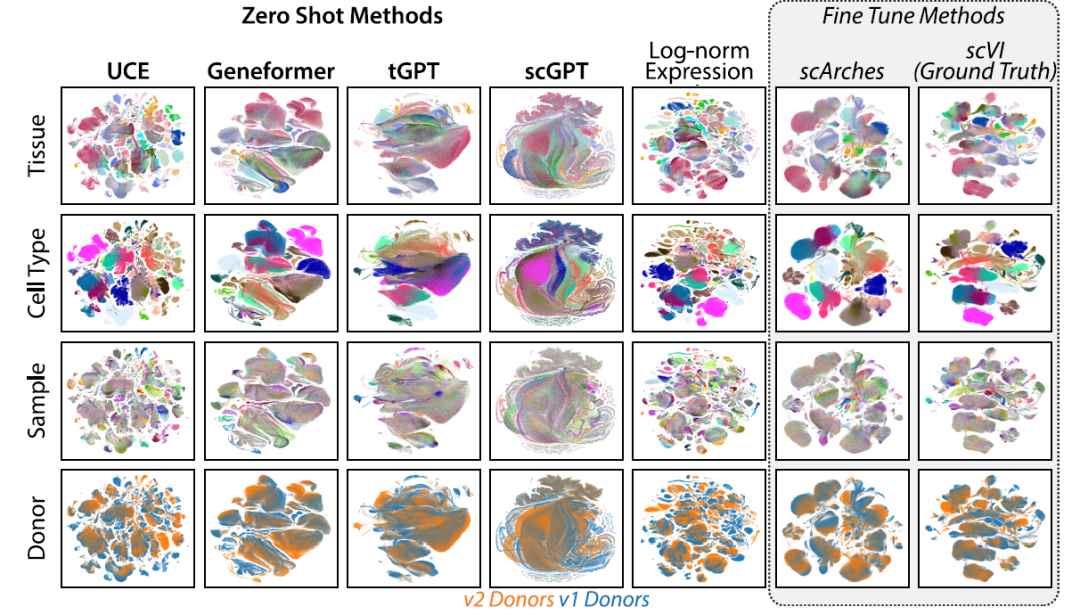
*L'UCE surpasse les méthodes existantes pour l'intégration de Tabula Sapiens v2*
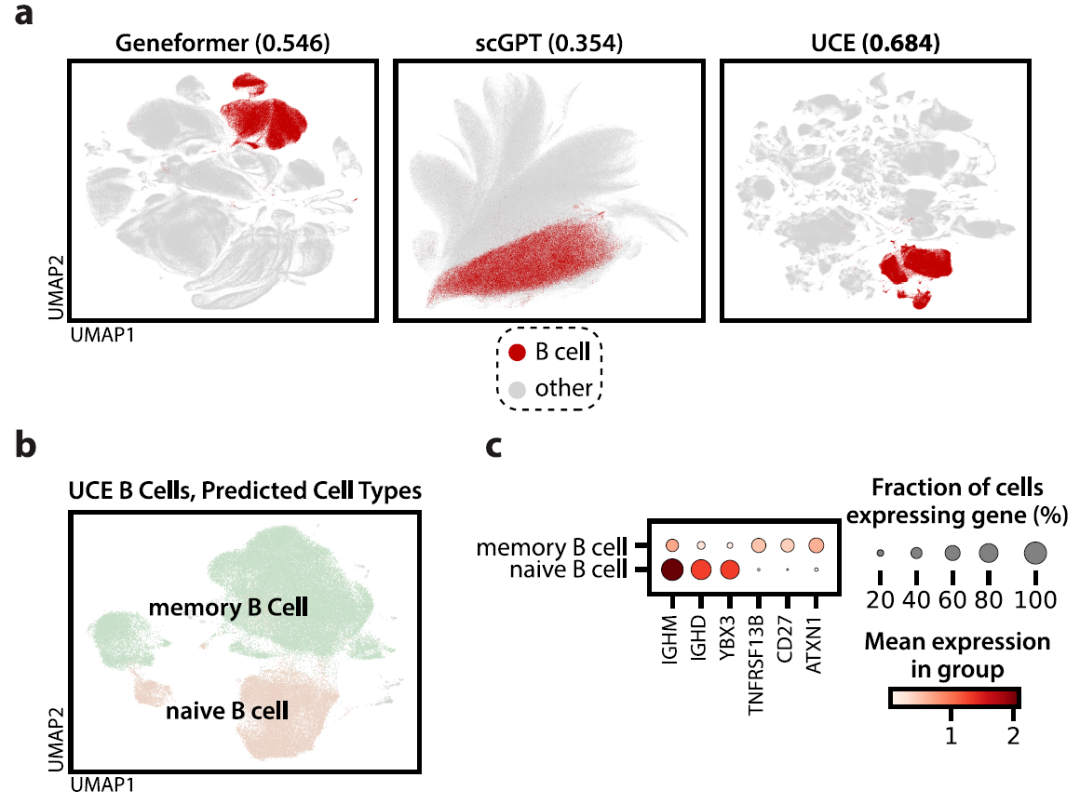
*L'UCE recapture l'identité des cellules B dans Tabula Sapiens v2*
Plongement en zero-shot sur de nouvelles espèces
Les chercheurs ont également comparé les performances de l'UCE avec celles de méthodes supervisées de transfert de labels entre espèces, SATURN et SAMap, actuellement à la pointe de la technologie. Sur 3 des 4 ensembles de données, l'UCE a surpassé SATURN et SAMap lors du transfert de labels de types cellulaires entre l'humain et de nouvelles espèces. L'UCE est même capable de générer des embeddings zero-shot cohérents pour des espèces hautement divergentes sur le plan évolutif, comme la drosophile.
Organisation structurelle des types cellulaires dans les nouvelles données
Au-delà des métriques d'évaluation se concentrant sur le clustering de types cellulaires individuels, l'équipe de recherche a également examiné la structure de l'espace d'embedding universel à un niveau global, c'est-à-dire en analysant les relations de position relative entre différentes cellules dans cet espace. Après avoir intégré toutes les cellules du tissu pulmonaire de Tabula Sapiens v.2, on peut observer une organisation structurelle des types cellulaires ayant une signification biologique claire (figure a ci-dessous). Non seulement différents types cellulaires se regroupent séparément, par exemple les cellules T, les monocytes et les cellules endothéliales forment des clusters distincts, mais des catégories cellulaires de niveau supérieur, comme les cellules immunitaires et les cellules épithéliales, peuvent également être clairement distinguées.
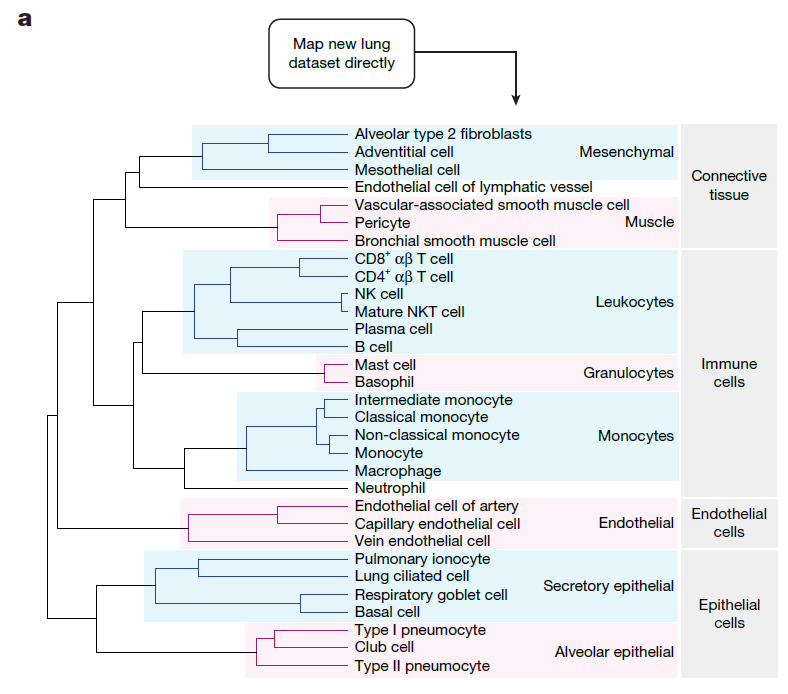
*L'espace UCE généré pour des données nouvelles et jamais vues présente une organisation structurelle des types cellulaires biologiquement significative*
Les chercheurs ont ensuite comparé ce résultat avec la hiérarchie cellulaire dérivée de l'ontologie cellulaire. Les résultats montrent que, par rapport à d'autres méthodes d'embedding zero-shot, les clusters cellulaires identifiés par l'UCE présentent une similarité plus élevée avec Cell Ontology.
Des expériences supplémentaires ont révélé que l'UCE peut apprendre efficacement une représentation universelle de la biologie cellulaire. Cette représentation permet non seulement de distinguer différents types cellulaires, mais aussi de capturer les similarités relatives entre types cellulaires à différentes échelles, ce qui pourrait ouvrir la voie à la découverte de lois biologiques plus profondes sous-tendant le développement et la fonction cellulaires.
Analyse des résultats de maladies pulmonaires par l'UCE
Enfin, les chercheurs ont utilisé l'UCE ainsi que le classificateur cellulaire Norn précédemment construit pour étudier les cellules de type Norn dans les maladies pulmonaires. Ils ont échantillonné des cellules pulmonaires de patients atteints de fibrose pulmonaire idiopathique (idiopathic pulmonary fibrosis, IPF), de bronchopneumopathie chronique obstructive (chronic obstructive pulmonary disease, COPD) et de patients témoins, puis ont généré leur espace d'embedding cellulaire. Dans les trois groupes de patients, des cellules pulmonaires de type Norn présentant une expression préférentielle des gènes marqueurs de Norn ont été identifiées (figure d ci-dessous) ; des analyses supplémentaires ont révélé que ces cellules pulmonaires de type Norn présentent des différences d'expression entre les différents groupes de maladies (figure e ci-dessous).
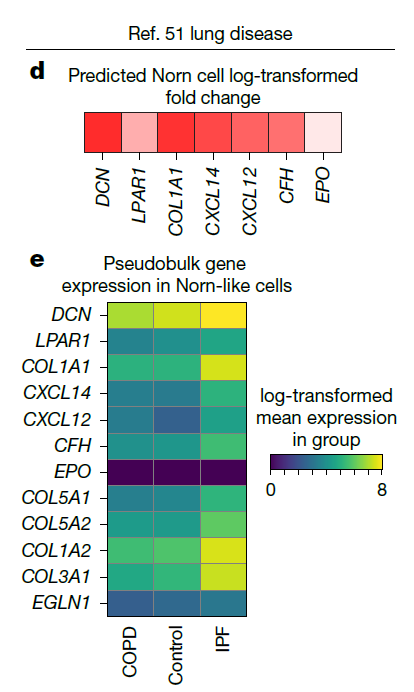
*L'étude de cas sur les cellules Norn montre que l'UCE peut soutenir des analyses approfondies d'ensembles de données unicellulaires*
La COPD et l'IPF sont toutes deux associées à des niveaux élevés d'Epo dans le sang, mais les niveaux d'Epo chez les patients atteints de COPD sont plus élevés que chez ceux atteints d'IPF. De plus, par rapport aux patients atteints de COPD, l'érythrocytose secondaire (secondary erythrocytosis) chez les patients atteints d'IPF est moins prononcée ou se produit à un degré moindre. Étant donné que l'étude a découvert des cellules de type Norn dans le tissu pulmonaire et que les cellules Norn peuvent produire de l'Epo, les différences de pronostic entre ces deux maladies pourraient être liées à des différences dans les cellules de type Norn associées à la maladie.
Dans l'ensemble, ces résultats indiquent que des cellules présentant des états transcriptionnels similaires à ceux des cellules Norn peuvent également être trouvées dans d'autres tissus de l'organisme, et que ces cellules pourraient jouer un rôle jusqu'ici non décrit dans les processus pathologiques. Étant donné que l'UCE est un modèle universel non limité par le tissu, l'espèce ou l'état pathologique, il peut considérablement faciliter l'analyse de données à si grande échelle et aussi diverses.
Conclusion
En construisant l'UCE, les chercheurs ont encore étendu la capacité d'analyse des données scRNA-seq. Bien que ce modèle représente une étape importante vers un embedding cellulaire universel, il présente encore certaines limitations. Les benchmarks actuels évaluent principalement la capacité de l'UCE à retrouver des types cellulaires annotés par des experts, mais ces tâches sont elles-mêmes limitées par la granularité et la subjectivité des labels cellulaires existants. Par conséquent, ces évaluations pourraient ne pas refléter pleinement la capacité du modèle à représenter des processus biologiques plus subtils, tels que la réponse cellulaire aux perturbations ou l'intégration de données de différentes modalités. De plus, comme d'autres modèles de fondation biologiques à grande échelle, l'UCE reste en grande partie un modèle de type boîte noire, ce qui rend difficile l'explication de la raison et de la manière dont certains embeddings se forment. Pour remédier à cette opacité, il est nécessaire de développer davantage d'outils d'interprétabilité reliant les représentations apprises par le modèle à une compréhension au niveau des mécanismes biologiques. Bien que les données d'entraînement de l'UCE soient vastes, elles restent biaisées vers les espèces de mammifères, en particulier l'humain et la souris, ainsi que vers certains tissus spécifiques, comme le tissu cérébral, ce qui soulève des inquiétudes quant à la capacité du modèle à généraliser à des espèces et des scénarios biologiques sous-représentés.
Enfin, il convient de souligner que, bien que l'UCE puisse améliorer l'alignement des données en capturant les signaux biologiques partagés entre différents ensembles de données, il ne remplace pas les méthodes traditionnelles de correction des effets de lot. Pour traiter les facteurs de confusion expérimentaux connus, les méthodes traditionnelles restent d'une grande valeur.
Références :