Command Palette
Search for a command to run...
تم تحسين الحساسية بواسطة 56%، واقترح CUHK/Fudan/Yale وآخرون بشكل مشترك طريقة جديدة للكشف عن نظائر البروتين
البروتين هو الأساس المادي للحياة والناقل الرئيسي للأنشطة الحيوية. في عصر ما بعد الجينوم، ومع تطور تكنولوجيا تحديد البروتين، ازداد حجم قواعد بيانات تسلسل البروتين بشكل كبير. من أجل الحصول على فهم أعمق لتنوع ووظائف البروتينات، فإن تحديد البروتين مهم بشكل خاص في علم الأحياء.
**في عملية التعرف على البروتين، يعد تحديد تشابه تسلسل البروتين أحد أهم المهام.**ويمكن أن يساعد العلماء على فهم العلاقات التطورية والخصائص البنيوية ووظائف البروتينات. على الرغم من أن طرق محاذاة تسلسل البروتين التقليدية تعمل بشكل جيد في العديد من الحالات، إلا أنها غير قادرة على التعامل مع نظائر بعيدة. غالبًا ما يتم تجاهل هذه المتماثلات البعيدة في المحاذاة الروتينية بسبب تشابه تسلسلها المنخفض، مما يحد من فهم الباحثين الشامل لتنوع البروتين وتعقيده.
ولحل نقاط الألم في أبحاث التشابه البروتيني البعيد، استنادًا إلى نماذج لغة البروتين وتكنولوجيا الاسترجاع الكثيف، اقترح لي يو من الجامعة الصينية في هونج كونج، بالتعاون مع صن سي تشي، وهو باحث شاب من مختبر الأنظمة المعقدة الذكية في جامعة فودان ومختبر الذكاء الاصطناعي في شنغهاي، ومارك جيرستين من جامعة ييل، إطار عمل للكشف عن التشابه فائق السرعة والحساسية - جهاز الاسترجاع الكثيف للتشابه (DHR).
يمكن لـ DHR تحديد نظائر بعيدة مخفية عميقًا في التسلسل دون الاعتماد على محاذاة التسلسل التقليدية، من خلال القدرات القوية لهيكل المشفر المزدوج ونموذج لغة البروتين، مما يوفر سرعة وحساسية غير مسبوقة لتحديد النظائر. نُشر البحث في المجلة العالمية الشهيرة Nature Biotechnology تحت عنوان "الكشف السريع والحساس عن نظائر البروتين باستخدام الاسترجاع الكثيف العميق".
أبرز الأبحاث:
* بالمقارنة مع الطرق السابقة، تعمل تقنية DHR على تحسين الحساسية بأكثر من 10% وتحسن الحساسية بأكثر من 56% على مستوى العائلة الفرعية للعينات التي يصعب تحديدها باستخدام الطرق القائمة على المحاذاة
* استعلامات كود DHR التسلسلية وقواعد البيانات أسرع بـ 22 مرة من الطرق التقليدية مثل PSI-BLAST وDIAMOND، وأسرع بـ 28700 مرة من HMMER
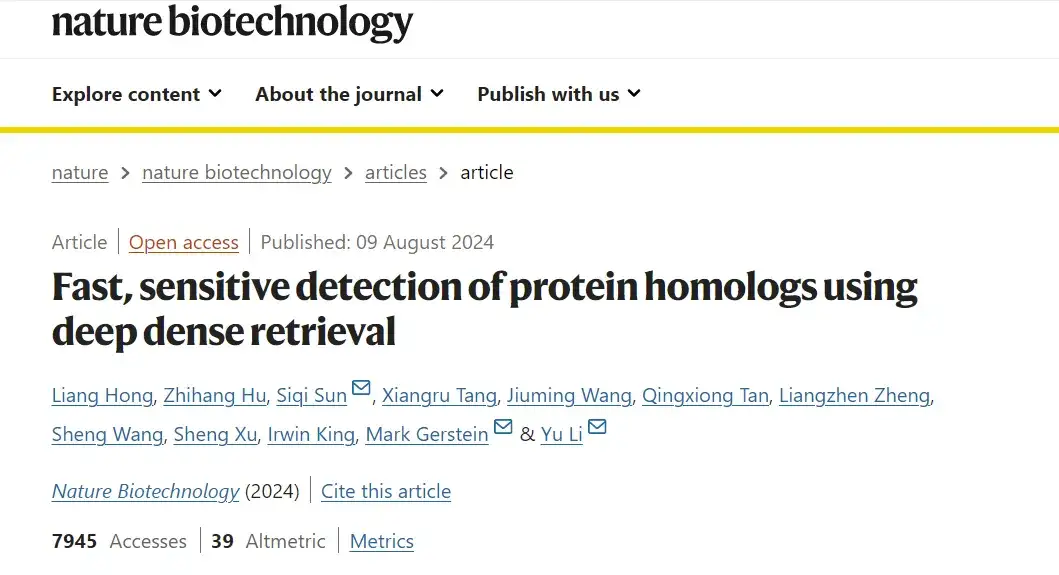 عنوان الورقة:
https://doi.org/10.1038/s41587-024-02353-6
يجمع المشروع المفتوح المصدر "awesome-ai4s" أكثر من مائة تفسير ورقي لـ AI4S ويوفر مجموعات وأدوات ضخمة من البيانات: https://github.com/hyperai/awesome-ai4s
إنشاء مجموعات البيانات في أبعاد متعددة لاستكشاف مجموعة أوسع من تسلسلات البروتين
**تتضمن مجموعة التدريب التي تم إنشاؤها في هذه الدراسة 2 مليون تسلسل استعلام تم اختيارها بعناية من UR90.**باستخدام خوارزمية JackHMMER، بحثت هذه الدراسة بشكل متكرر عن تسلسلات مرشحة في Uni-Clust30 وقامت بمحاذاة التسلسلات المرشحة مع محاذاة التسلسلات المتعددة (MSA). احتوى كل MSA على 1000 نظير، مما يضمن الاحتفاظ فقط بالتسلسلات الأكثر ارتباطًا. بعد الفحص الدقيق، تم إعادة نشر JackHMMER لمعالجة التسلسلات المختلفة التي تم الحصول عليها واستخدام نفس إعدادات المعلمات الفائقة مثل AF2 (AlphaFold 2) لتسهيل المقارنة العادلة.
**في دراسة مجموعات البيانات الكبيرة، اختارت الدراسة مجموعة بيانات BFD/MGnify.**إنها قاعدة بيانات ضخمة تحتوي على حوالي 300 مليون بروتين، مما يتيح استكشاف مجموعة أوسع من تسلسلات البروتين.
طريقة DHR: خط أنابيب بحث عن التشابه البروتيني فائق السرعة والحساسية
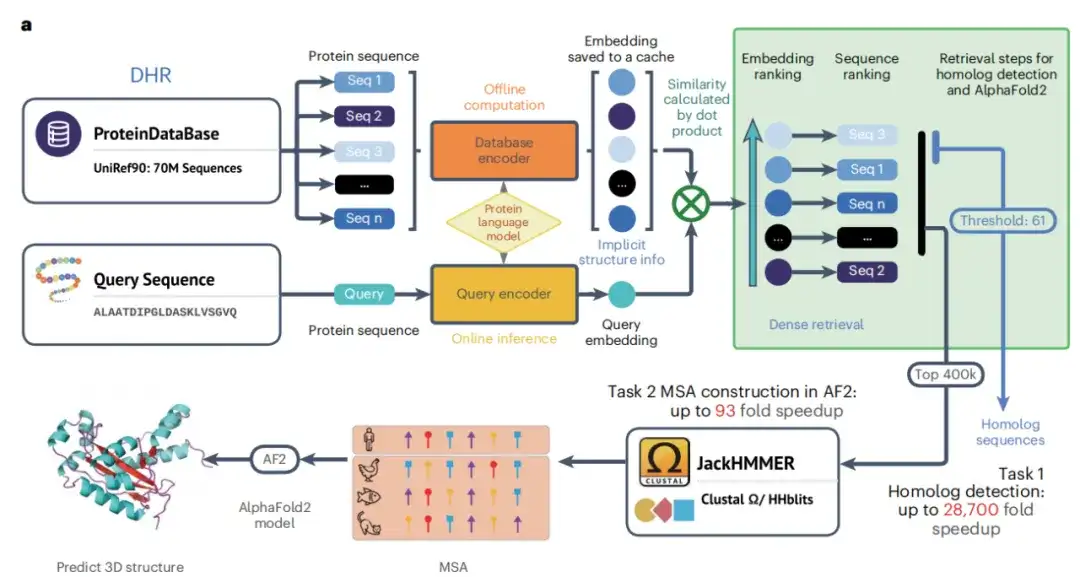
**الفكرة الأساسية لطريقة DHR هي ترميز تسلسلات البروتين في متجهات تضمين كثيفة بحيث يمكن حساب التشابه بين التسلسلات بشكل فعال.**على وجه التحديد، قامت هذه الدراسة بتدريب مشفر التسلسل بشكل فعال من خلال تهيئة ESM ودمج تقنيات التعلم التبايني، وبالتالي خلق الظروف لبناء نموذج لغة البروتين وتمكين استخدام DHR بشكل أكثر فعالية لاسترجاع المتماثلات.
كما هو موضح في الشكل أ أدناه، مع اكتمال مرحلة تدريب المشفر المزدوج، أصبحت الدراسة قادرة على توليد تضمينات تسلسل بروتيني عالية الجودة غير متصلة بالإنترنت. ثم استخدمت الدراسة هذه التضمينات وخوارزميات البحث عن التشابه لاسترجاع نظائر لكل بروتين استعلام. من خلال تحديد التشابه كمقياس استرجاع، يمكن العثور على البروتينات المتشابهة بدقة أكبر من الطرق التقليدية، ويمكن استخدام التشابه بين بروتينين لمزيد من التحليل. أخيرًا، قام JackHMMER ببناء MSA للنظائر المسترجعة، وحصلت الدراسة على تقنية DHR التي يمكنها اكتشاف النظائر بسرعة وفعالية.
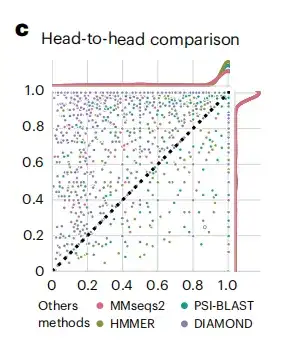
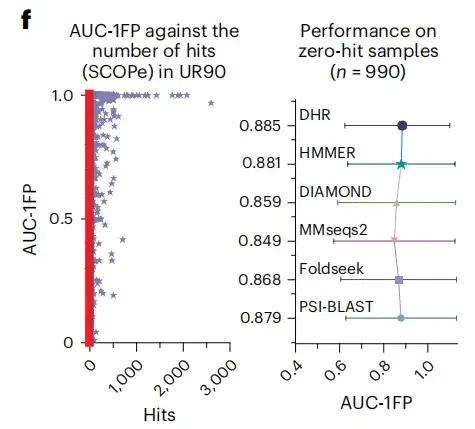
بعد الحصول على تضمينات البروتين الناتجة، قامت الدراسة بتقييم أداء DHR من خلال مقارنتها بالطرق الموجودة في مجموعة البيانات القياسية SCOPe (تصنيف بنية البروتينات).كما هو موضح في الشكل ج أدناه، فإن حساسية بيانات DHR أفضل من الطرق الأخرى.
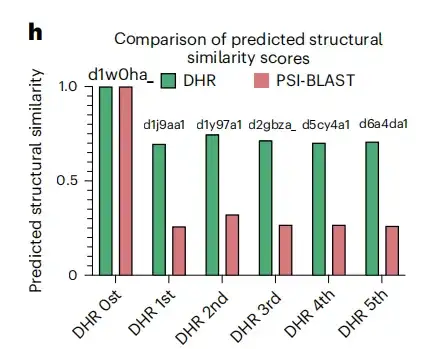
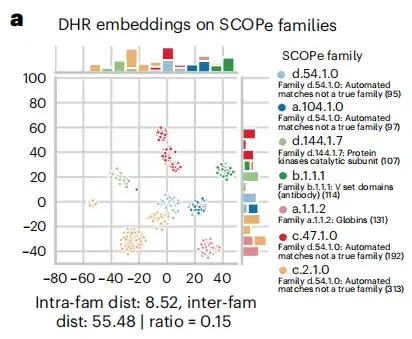
 أثناء عملية البحث عن التماثل، كما هو موضح في الشكل أ أدناه، وجدت الدراسة أن تضمين تسلسل DHR يحتوي على كمية كبيرة من المعلومات البنيوية، وأن دقة DHR في استرجاع المواد المتجانسة تتجاوز دقة طرق المحاذاة القائمة على البنية. وبناء على هذه النتيجة،وكشفت هذه الدراسة أيضًا عن الارتباط بين ترتيب التشابه التسلسلي والتشابه الهيكلي لـ DHR.
نتائج البحث: تتمتع DHR بدقة وفعالية أفضل، ويمكنها بناء MSA عالية الجودة على مجموعات بيانات واسعة النطاق
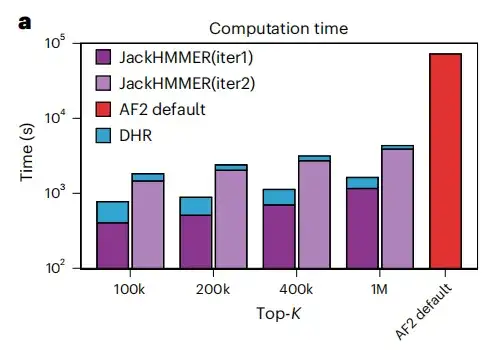
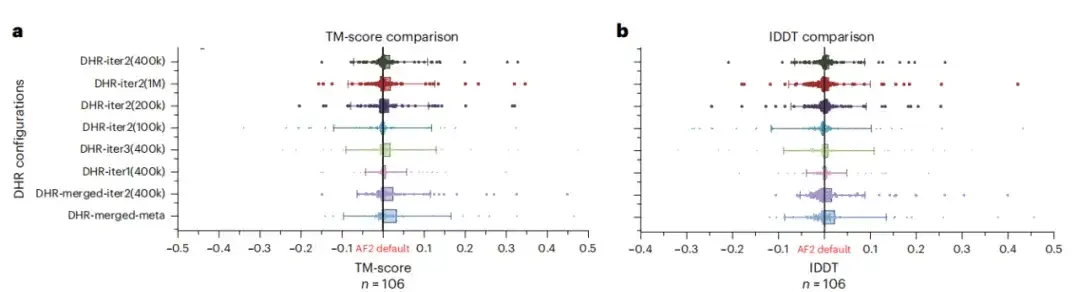
لقد قمنا بإنشاء MSAs من JackHMMER باستخدام نظائر مقدمة من DHR وقارناها بخط الأنابيب الافتراضي AF2. كما هو موضح في الشكل أ أدناه، فإن متوسط سرعة تشغيل جميع تكوينات DHR + JackHMMER أسرع من سرعة JackHMMER العادي من AF2. علاوة على ذلك، يتداخل DHR مع JackHMMER بحوالي 80% عند إنشاء MSA على UniRef90.ويشير هذا إلى أنه يمكن تنفيذ العديد من المهام اللاحقة المتعلقة بـ MSA باستخدام DHR، مما ينتج عنه نتائج مماثلة ولكن بشكل أسرع.
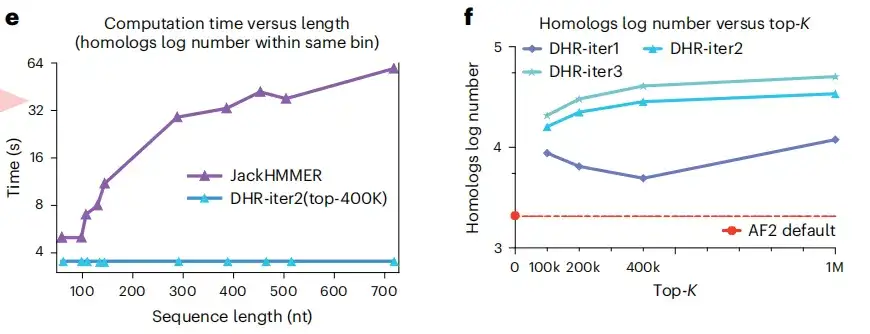
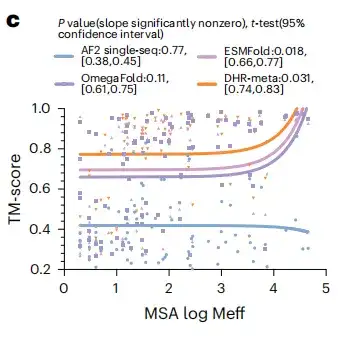
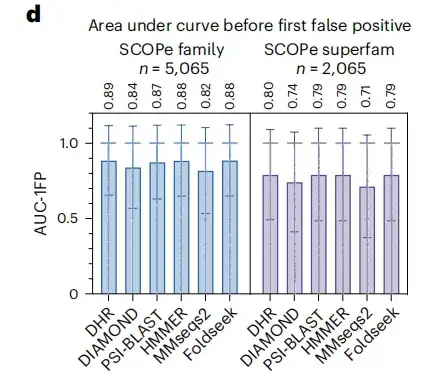
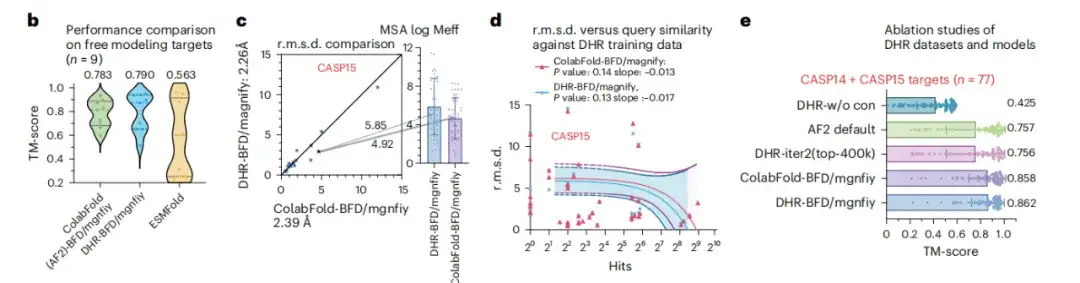
في الشكل 2ج، يظهر DHR تحسنًا طفيفًا في الأداء مقارنةً بـ ColabFold-MMseqs2. يوضح الشكل د أدناه أيضًا أنه بعد اختبار التشابه بين CASP14 وSCOPe، وجد أن DHR لم يتذكر نتائج الاستعلام أو الإصابة فحسب، بل أجرى تقييمًا شاملاً للتشابه بين جميع الأهداف. وتثبت هذه النتائج أنيتيح DHR إنشاء MSAs للبروتينات غير المنظمة على مجموعات بيانات البحث واسعة النطاق ذات التنوع العالي.
القوى الشابة في مجال التنبؤ ببنية البروتين
ليس هناك شك في أن التنبؤ ببنية البروتين يلعب دورًا مهمًا في التطبيقات مثل تطوير الأدوية وتصميم الأجسام المضادة. قد يصبح الذكاء الاصطناعي هو المفتاح لحل المشكلة التاريخية المتمثلة في الدقة المحدودة في التنبؤ ببنية البروتين. وفي هذا المجال الرئيسي، شكلت فرق البحث العلمي المحلية تدريجيا اتجاها يضم مائة مدرسة فكرية، وأصبح الباحثون الشباب الناشئون قوة لا يمكن تجاهلها. ويعد لي يو وسون سي تشي، اللذان قادا نتائج البحث المذكورة أعلاه، من بين الأفضل.
وفي ديسمبر من نفس العام، عاد إلى الصين وانضم إلى قسم علوم الكمبيوتر والهندسة في الجامعة الصينية في هونج كونج كأستاذ مساعد، وقاد مجموعة الذكاء الاصطناعي في الرعاية الصحية (AIH). أجرى أبحاثًا معمقة حول تقاطع التعلم الآلي والرعاية الصحية وعلم المعلومات الحيوية، وقاد الفريق لتطوير أساليب جديدة للتعلم الآلي لحل المشكلات الحسابية في علم الأحياء والرعاية الصحية، وخاصة مشكلات التعلم المنظم.
**وفيما يتعلق بمجالات علم الأحياء والرعاية الصحية التي شارك فيها بشكل عميق، قال لي يو: "هدفي على المدى الطويل هو تحسين نظام الرعاية الصحية وتحقيق الفائدة المباشرة للمجتمع من خلال تحسين صحة الناس ورفاهتهم".**ومن الجدير بالذكر أنه تم اختياره أيضًا ضمن قائمة "30 تحت 30" التي أعدتها مجلة فوربس آسيا لعام 2022 (الرعاية الصحية والعلوم).
وفيما يتعلق بالتنبؤ بالبروتين، يركز على التنبؤ ببنية وتسلسل البروتينات من خلال نماذج التعلم العميق، ونماذج التدريب لتحديد الأنماط والانتظامات في التسلسلات للتنبؤ بتسلسل البروتينات وطيها، وبالتالي تحسين دقة وكفاءة تسلسل البروتين الجديد والتنبؤ بالبنية، وخلق إمكانيات جديدة لتصميم الأدوية وعلاج الأمراض.
في مجال AI4S المحلي، ينشط عدد متزايد من القوى الشابة. ومن المتوقع أن تلعب تقنية الذكاء الاصطناعي دورًا أكثر أهمية في مجال التنبؤ ببنية البروتين، ولكن الطريق أمامها طويل وشاق. ومن دواعي السرور أن فريق البحث العلمي المحلي أظهر روحًا مثابرة في الاستكشاف والقدرة على الابتكار. ولم يعملوا بجد على تحسين الخوارزميات وبناء النماذج فحسب، بل أجروا أيضًا أبحاثًا متعمقة في معالجة البيانات والتحقق التجريبي وما إلى ذلك لضمان علمية وواقعية نتائج البحث. وتتحول هذه الجهود تدريجيا إلى تطبيقات عملية، مما يجلب حيوية جديدة وأملاً لمجالات مثل البحث والتطوير الطبي والتكنولوجيا الحيوية.
وأخيرًا، أوصي بنشاط المشاركة الأكاديمية!
تمت دعوة تشو زيي، باحث ما بعد الدكتوراه في معهد العلوم الطبيعية بجامعة شنغهاي جياو تونغ والمركز الوطني شنغهاي للرياضيات التطبيقية، إلى البث المباشر الثالث لـ Meet AI4S. انقر هنا لتحديد موعد لمشاهدة البث المباشر!
https://hdxu.cn/6Bjomhdxu.cn/6Bjom