HyperAI
Command Palette
Search for a command to run...
우수 학회 논문
CVPR, NeurIPS, ICML, ACL 등 최고 권위 학회의 수상 논문
개의 논문
CxMP: 언어 모델의 구성 이해 평가를 위한 언어학적 최소쌍 벤치마크
CIG: 의미론적 기억 동역학을 활용한 심의적 대화의 대화 정보 이득 측정
CAR-bench: 실제 세계의 불확실성 하에서 LLM 에이전트의 일관성 및 한계 인지에 대한 평가
대규모 언어 모델에서의 미완료 역설
문장 처리에서의 기억 효율성과 자원-합리적 부호화
트랜스포머에서 국소 주의의 표현력 규명
쓰레기를 보물로: 토큰 재활용을 통한 대규모 언어 모델 추론 가속화
언어 모델 증류에서의 용량 격차 법칙에 관한 연구
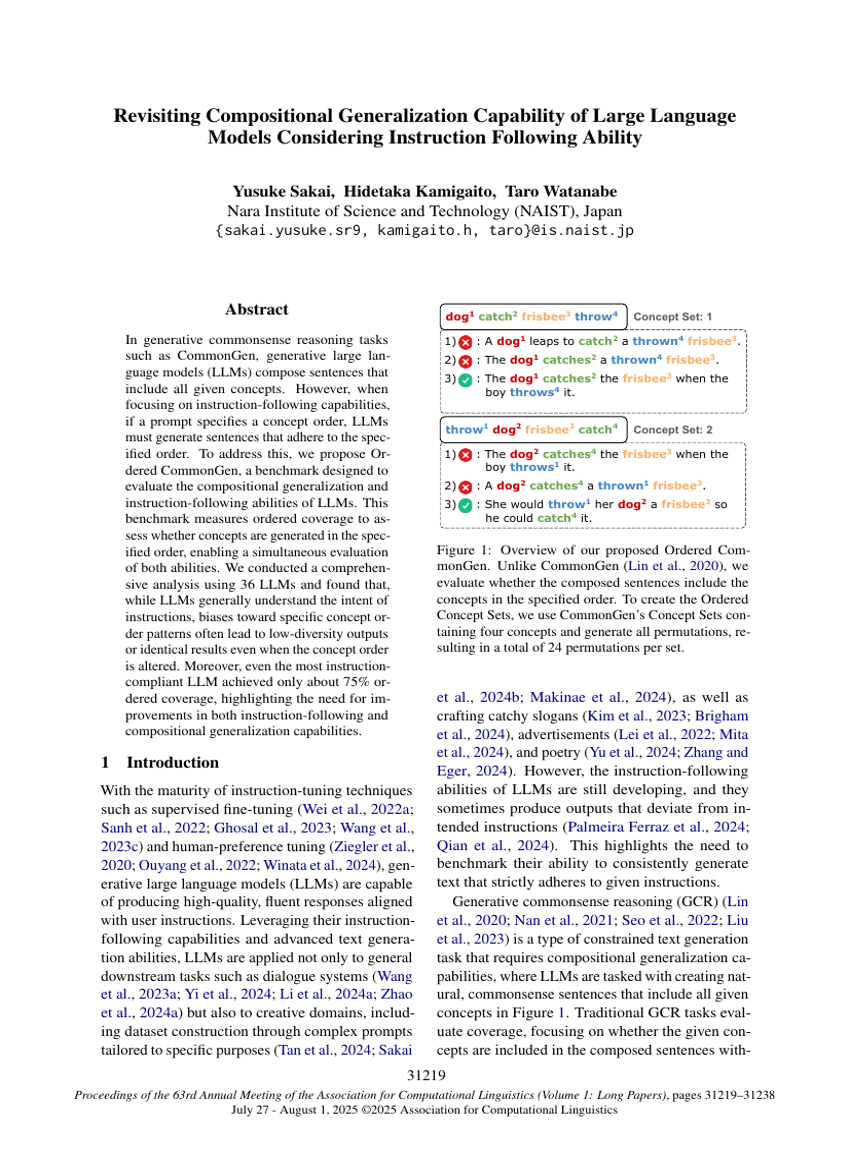
지시 수행 능력을 고려한 대규모 언어 모델의 구성적 일반화 능력 재고
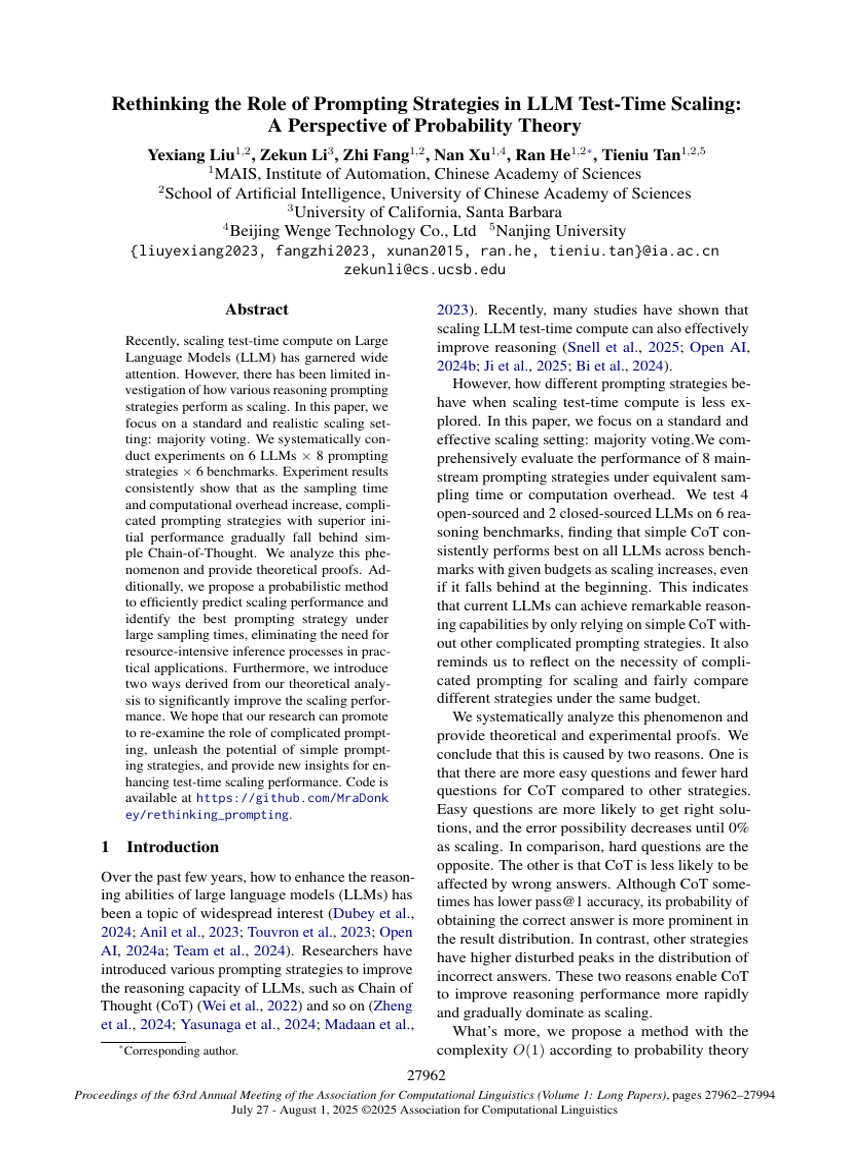
확률론적 관점에서 본 LLM 추론 시점 스케일링에서의 프롬프트 전략의 역할 재고
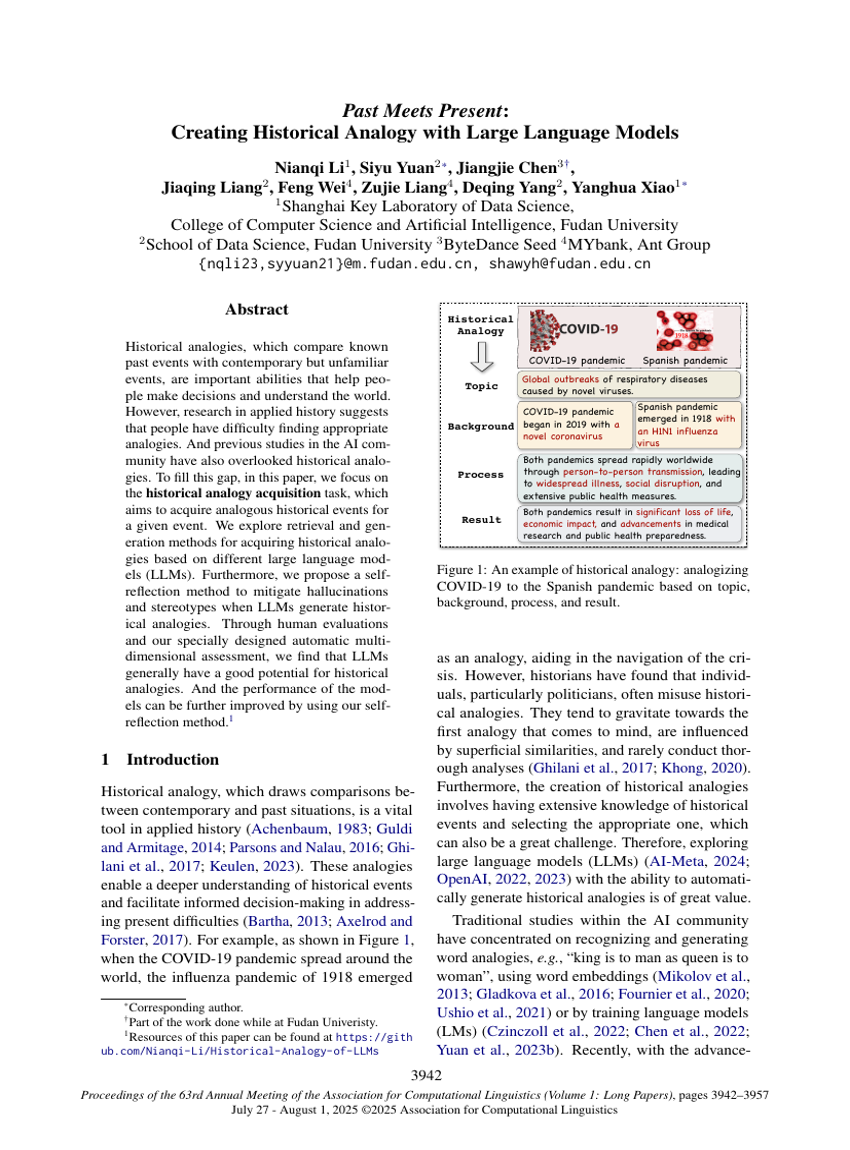
과거가 현재를 만나: 대형 언어 모델을 활용한 역사적 유추 생성
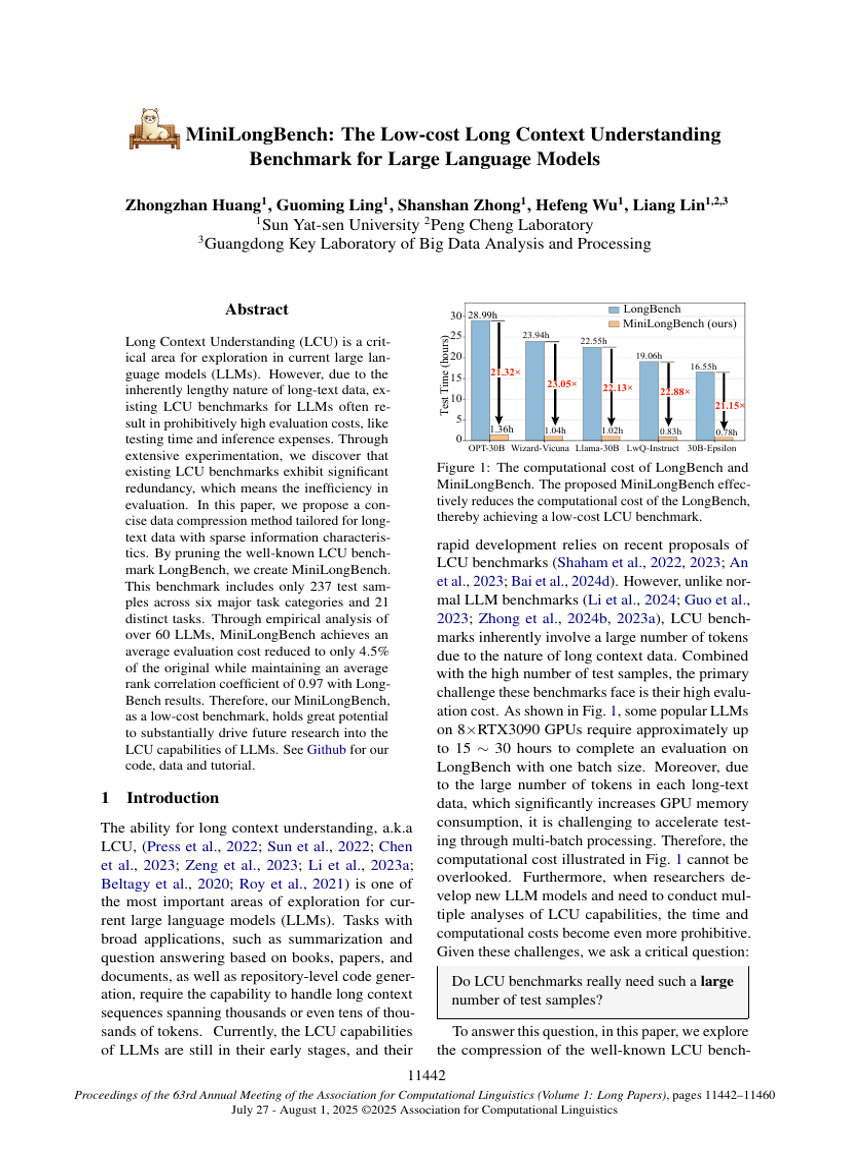
MiniLongBench: 대규모 언어 모델을 위한 저비용 긴 컨텍스트 이해 벤치마크
로그 우도 벡터를 이용한 1,000개 이상의 언어 모델 지도화
Llama 보면 Llama 한다: 대규모 언어모델의 문맥적 동조와 주의 분산에 대한 메커니즘 관점
LATIM: Mamba 모델에서 잠재적 토큰 간 상호작용 측정
IndicSynth: 저자원 인도 지역 언어 12개를 위한 대규모 다국어 합성 음성 데이터셋
HATEDAY: 트위터 하루의 대표성을 지닌 글로벌 혐오 발언 데이터셋에서 얻은 통찰
HALOGEN: 놀라운 LLM 환각과 그 발견
REAL에서 SYNTHETIC으로: Attributed Grounding을 활용한 수백만 개의 다양하고 복잡한 사용자 지시 합성
Capability Salience Vector: 다운스트림 작업 스케일링 법칙을 위한 손실과 역량의 세분화된 정렬
추론 시점 언어 간 개입을 통한 대규모 언어 모델의 언어 간 격차 해소
N-그램을 넘어서: 다국어 추상적 요약의 평가 지표 및 전략 재고
회로와 촘스키 사이: 형식 언어에 대한 사전 사전학습이 언어학적 편향을 부여한다
반짝이는 것 모두 새로운 것은 아니다: AI 생성 연구의 표절
문맥 다양성을 통한 지프의 의미-빈도 법칙에 대한 새로운 공식화
Native Sparse Attention: 하드웨어 정렬 및 네이티브 학습 가능한 희소 어텐션
언어 모델은 정렬에 저항한다: 데이터 압축으로부터의 증거
차이 인식을 통한 공정성: 대규모 언어 모델에서 바람직한 집단 차별 측정
LLM에서의 응답 표본 추출에 관한 이론: 서술적 요소와 처방적 요소의 결합
워드 임베딩은 언어 모델의 스티어(Steers)이다