Command Palette
Search for a command to run...
3600만 개의 세포를 하나의 공간에 담다, 스탠퍼드대학교가 범용 세포 임베딩 모델 UCE를 제안, 8개 종에 걸친 초대규모 세포 지도 구축

지난 수년간, 세포 생물학은 세포가 나타낼 수 있는 다양한 표현형, 서로 다른 상태 간의 상호 관계, 그리고 세포가 발생과 질병 과정에서 이러한 상태들 사이를 어떻게 전환하는지를 묘사하는 데 주력해 왔다.
단일 세포 RNA 염기서열 분석(scRNA-seq) 데이터 세트 규모의 대폭적인 증가는 이러한 문제를 재검토할 수 있는 새로운 기회를 제공했다. 그러나 기존의 계산 방법들은 이러한 고도로 다양한 데이터 세트를 공동 분석하는 데 여전히 어려움을 겪고 있는데, 이는 모델이 종 특이적 제한, 데이터 세트 특이적 인공물 또는 배치 효과의 영향을 받을 수 있기 때문이다. scRNA-seq 데이터를 위한 일부 계산 방법들은 일부 한계를 극복할 수 있었지만, 그 대가로 매 새로운 데이터 세트에 직면할 때마다 모델을 특별히 튜닝해야 한다는 비용이 따른다.
이러한 배경 속에서, 스탠포드 대학 연구팀은 범용 세포 임베딩(universal cell embedding, UCE) 기반 모델을 제안했다. UCE는 모델 미세 조정이나 재훈련 없이 새로운 단일 세포 유전자 발현 데이터 세트에 대한 표현을 생성하면서도, 데이터 세트 특이적 및 배치 특이적 인공물에 대한 견고성을 유지하는 독특한 능력을 가지고 있다. 또한 UCE는 세포 유형 주석이 필요하지 않으며, 입력 데이터 세트에 대한 유전자 스크리닝과 같은 전처리도 요구하지 않는다. UCE는 모델 훈련 과정에서 본 유전자와 상동 관계가 없는 유전자라 할지라도, 임의의 종에서 유래한 임의의 단백질 코딩 유전자 집합에 적용할 수 있다. 이러한 방식을 통해 UCE는 범용적이고 내재적으로 생물학적 의미를 지닌 세포 생물학 표현을 학습하여, 연구자들이 실험을 통해 직접 관측한 데이터를 넘어서는 생물학적 통찰력을 얻을 수 있게 한다.
관련 연구 성과는 「Universal cell embedding provides a foundation model for cell biology」라는 제목으로 Nature에 게재되었다.
연구 하이라이트:
-
새로운 세포 데이터에 대해 데이터 주석, 모델 재훈련 또는 미세 조정 없이도 UCE가 이를 이 통일된 표현 공간에 매핑할 수 있다.
-
UCE가 학습한 표현은 세포 유형과 세포 상태의 창발적 조직 구조를 나타내며, 알려진 생물학적 법칙과 일치한다.
-
UCE는 새로운 데이터를 주석이 달린 참조 세포 상태가 이미 존재하는 범용 임베딩 공간에 매핑할 수 있다.
논문 주소:
https://www.nature.com/articles/s41586-026-10689-z
3,600만 개 이상의 세포로 구성된 IMA 훈련 데이터 세트 구축
연구팀은 Integrated Mega-scale Atlas(IMA)라는 훈련 데이터 모음을 구축하여 다양한 공개 소스의 단일 세포 RNA 염기서열 분석 데이터를 통합했다. UCE의 핵심 훈련 데이터는 3,600만 개 이상의 세포를 포함하며, 그중 대부분의 데이터(총 3,390만 개 세포, 285개 데이터 세트)는 인간과 생쥐에서 유래했고, 나머지는 28개 데이터 세트의 230만 개 세포로 구성되어 있으며, 인간, 생쥐, 제브라피시, 붉은털원숭이, 사이노몰구스원숭이, 쥐여우원숭이, 개구리, 돼지 등 8개 서로 다른 종을 포함한다.
IMA를 시각화하고, 녹색원숭이 세포 유형을 예측하고, 새로운 종의 세포 유형 중심점을 매칭하고, Norn 유사 세포를 예측할 때, 연구자들은 전체 3,600만 개 세포를 사용하지 않고 IMA의 대표 표본을 사용했다. 이는 UMAP 계산과 같은 계산량이 많은 작업을 가속화하기 위한 것이었다. 이 대표 표본은 각 데이터 세트에서 무작위로 10,000개의 세포를 비복원 추출하여 구축되었다. 세포 수가 10,000개 미만인 데이터 세트의 경우 전체 데이터 세트가 직접 포함되었다. 최종적으로 얻어진 대표 표본은 총 2,969,114개의 세포를 포함하며, 표본 내 각 데이터 세트는 평균 9,486개의 세포를 포함한다.
모델이 진정으로 '낯선' 데이터에서 보여주는 성능을 평가하기 위해, 논문에서는 모델 훈련에 참여하지 않은 여러 데이터 세트도 사용했다. 예를 들어, Tabula Sapiens v.2는 581,430개의 세포, 27개 조직, 167개 배치 및 162개의 독특한 세포 유형을 포함하며, 논문의 중요한 제로샷 테스트 데이터 세트이다. 연구팀은 또한 녹색원숭이, 벌거숭이두더지쥐, 닭과 같은 훈련 단계에서 볼 수 없었던 종의 데이터를 준비하여 UCE가 진정으로 교차 종 일반화 능력을 갖추고 있는지 테스트했다. 이러한 데이터 외에도 논문은 생쥐 신장, 인간 폐 질환 등의 데이터를 추가로 분석하여 UCE가 이미 존재하는 세포 지도에서 새로운 생물학적 관계를 발견할 수 있는지 검증했다.
논문에서 분석된 모든 데이터 세트는 공개되어 있으며 다운로드할 수 있다:
-
녹색원숭이 폐 및 림프절 데이터 세트: 등록 번호 GSE156755
-
벌거숭이두더지쥐 데이터 세트: 등록 번호 GSE132642
-
닭 망막 데이터 세트: 등록 번호 GSE159107
-
닭 심장 데이터 세트: 등록 번호 GSE149457
-
생쥐 신장 데이터 세트: 등록 번호 GSE193321
-
인간 폐 질환 데이터 세트: 등록 번호 GSE136831
UCE: 생물학적 정보를 기반으로 한 세포 기반 모델
UCE는 세포를 'RNA 주머니(bags of RNA)'로 추상화함으로써 scRNA-seq 데이터 세트 통합의 문제를 극복한다.
UCE는 완전히 자기 지도 방식으로 훈련되며, 어떤 세포 유형 주석이나 데이터셋 기반 주석 정보도 사용하지 않습니다. 아래 그림과 같이 UCE는 먼저 단일 세포의 RNA 유전자 발현 데이터를 발현량 가중치가 적용된 유전자 샘플로 변환한 후, 단백질 언어 모델을 사용하여 이러한 유전자가 코딩하는 단백질을 기반으로 샘플 내 유전자를 표현합니다. 이를 통해 UCE는 단백질 서열만을 기반으로 임의의 종에서 유래한 임의의 단백질 코딩 유전자를 의미 있게 특성화할 수 있으며, 해당 종이 훈련 데이터에 포함되어 있는지 여부와 무관합니다. 유전자 염색체 위치와 같은 메타데이터를 추가로 통합한 후, 이 표현은 대형 Transformer 모델에 입력됩니다. 이를 통해 UCE는 추가 훈련 없이도 임의의 조직이나 종에서 유래한 세포를 공유된 범용 공간으로 매핑할 수 있습니다.
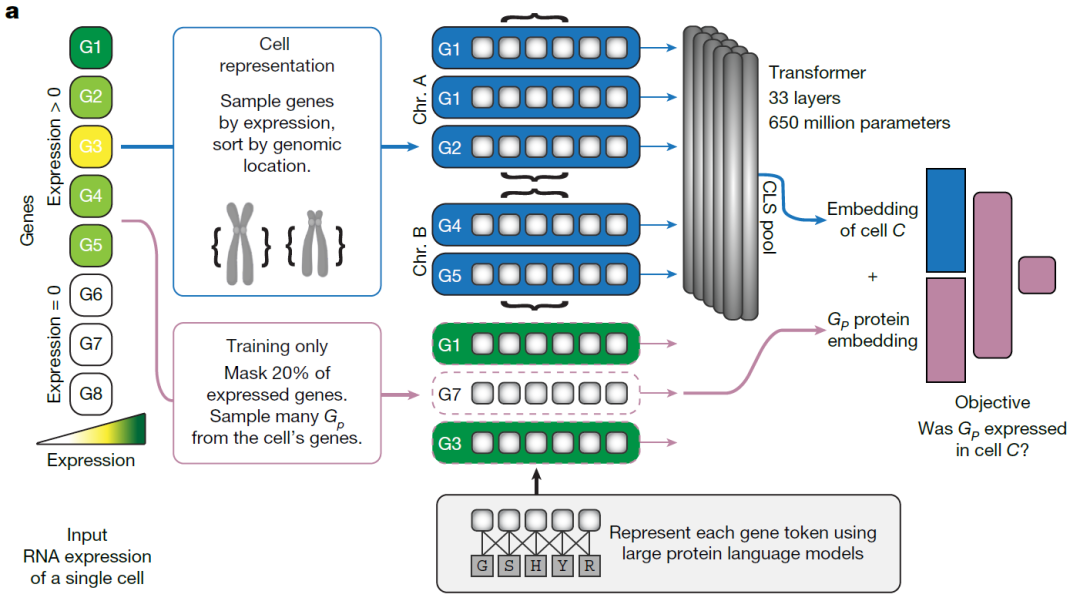
*UCE 모델 개요*
UCE의 입력은 두 부분으로 구성됩니다: (1) scRNA-seq 카운트 데이터; (2) 단백질 언어 모델 ESM2를 사용하여 생성된, 데이터셋 내 유전자에 해당하는 단백질 임베딩. ESM2 단백질 언어 모델은 아미노산 서열을 입력으로 받아 단백질 임베딩(protein embedding)이라고 불리는 수치적 표현을 출력합니다.
특정 세포의 유전자 발현 카운트 데이터에 대해 UCE는 발현량에 따라 가중치를 적용하고 정규화하여, 중복 추출을 허용하면서 해당 세포의 유전자를 샘플링합니다. 이 샘플은 0이 아닌 발현량을 가진 유전자만 포함할 수 있으며, 동일한 유전자가 샘플 내에서 여러 번 나타날 수 있습니다. 이후 이러한 유전자는 토큰화(tokenized)되어, 즉 코딩하는 단백질의 단백질 임베딩 표현으로 변환됩니다.
동일한 염색체에 속하는 유전자는 특수 마커를 배치하여 그룹화되고, 게놈 내 위치에 따라 정렬됩니다. 이후 전체 세포 표현의 가장 앞부분에 세포 전체를 나타내는 특수 마커인 CLS 토큰이 추가됩니다. 결합된 표현은 Transformer 신경망에 입력되며, 세포의 최종 임베딩은 Transformer의 마지막 계층에서 CLS 토큰에 해당하는 임베딩에서 추출됩니다.
성과: 실험을 통해 직접 관측된 데이터를 넘어서는 생물학적 통찰력 확보
UCE를 기반으로 연구진은 통합 초대규모 세포 지도(Integrated Mega-scale Atlas)를 추가로 구축하여 3,600만 개의 세포를 임베딩했으며, 여기에는 1,000종 이상의 고유한 명칭을 가진 세포 유형이 포함됩니다. 이 통합된 공간을 통해 서로 다른 세포 유형과 조직이 그 안에서 어떻게 구성되는지를 추가로 분석할 수 있게 되었습니다.
UCE의 임베딩 공간은 몇 가지 창발적 능력(emergent behaviour)을 보여줍니다
연구에 따르면 UCE 공간에서 세포는 세포 유형과 같은 생물학적 조건에 따라 자연스럽게 클러스터링되며, 동시에 서로 다른 실험 조건의 세포, 예를 들어 서로 다른 배치에서 유래한 세포는 서로 혼합될 수 있습니다(아래 그림 b). UCE는 훈련 과정에서 레이블이 없는 데이터만 사용했기 때문에, 이러한 조직 구조는 모델이 명시적으로 훈련된 결과가 아니라 모델 자체의 창발적 행동입니다.
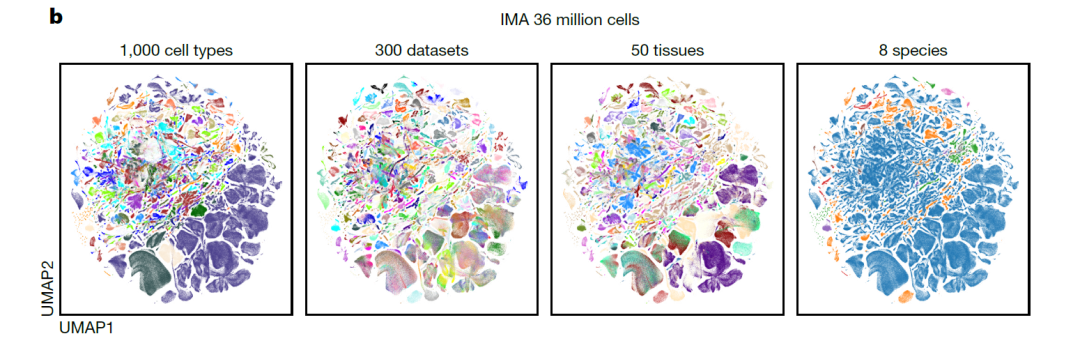
*UCE 공간의 통합 매니폴드 근사 및 투영(UMAP) 시각화*
연구팀은 조직 기원이 서로 다른 세포 유형의 상태에 어떻게 영향을 미치는지 추가로 조사했습니다. 서로 다른 조직에서 유래한 대식세포(macrophages)는 다양한 전사체 특징을 가지고 있음에도 불구하고 UCE 공간에서 여전히 높은 수준으로 정렬됩니다. 예를 들어, 인간 대식세포는 73개의 서로 다른 조직에 분포하며, 그중 72%(53개)의 조직 특이적 대식세포 중심점은 UCE 공간에서 가장 가까운 세포가 다른 조직에서 유래한 대식세포 중심점입니다.
유사한 조직 간 일관성은 내피 세포나 뉴런과 같은 다른 대량 존재 세포 유형에서도 관찰할 수 있습니다. 이는 UCE가 명시적 훈련이나 인공 레이블 없이도 대식세포가 서로 다른 조직 간에 공유하는 고유한 세포 정체성을 인식할 수 있음을 보여줍니다. 이것은 모델이 이 현상에 대해 특별히 훈련되지 않았음에도 불구하고 알려진 생물학적 법칙과 일치하는 UCE의 창발적 조직 구조입니다.
새로운 데이터셋에 대한 제로샷 임베딩
연구진은 아직 발표되지 않은 새로운 데이터셋인 Tabula Sapiens v.2에서 UCE의 제로샷 성능을 평가했습니다. 결과에 따르면 UCE의 전체 점수는 가장 우수한 성능을 보인 Geneformer보다 13.9% 높았으며, 생물학적 정보 보존 점수는 16.2%, 배치 효과 보정 점수는 10.1% 더 높았습니다. 다른 방법과 비교하여 UCE가 생성한 임베딩은 서로 다른 세포 유형을 더 명확하게 구분할 수 있었습니다(아래 그림).
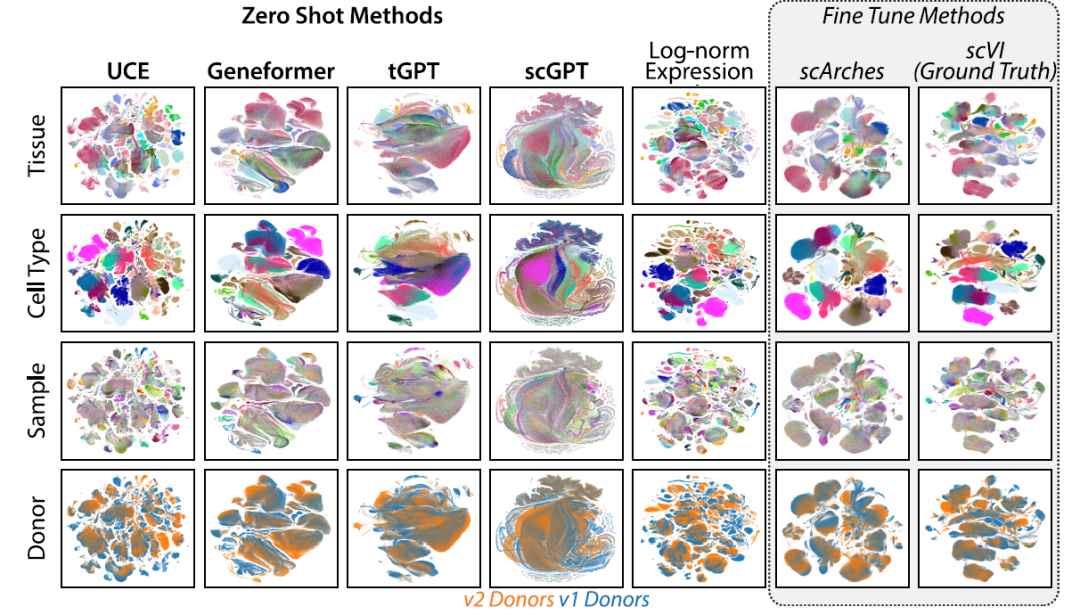
*UCE는 Tabula Sapiens v2 통합에서 기존 방법보다 우수합니다*
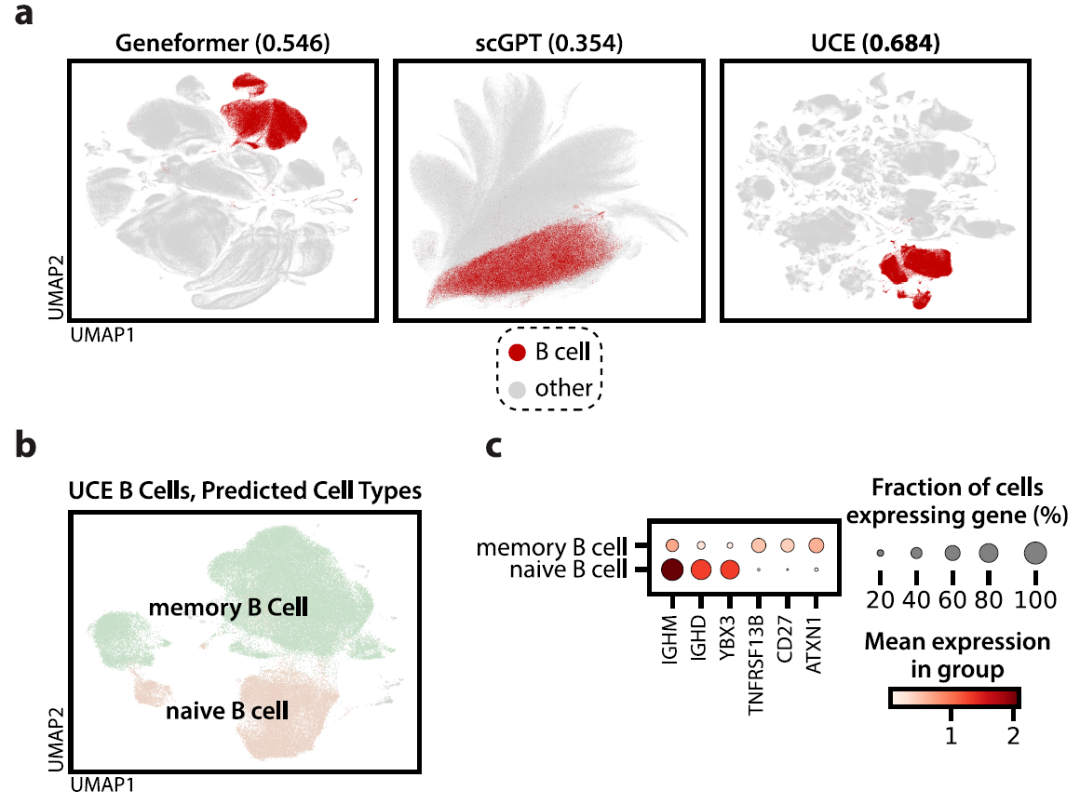
*UCE는 Tabula Sapiens v2에서 B 세포 정체성을 다시 포착할 수 있습니다*
새로운 종에 대한 제로샷 임베딩
연구진은 UCE의 성능을 현재 최첨단 교차 종 레이블 전이 지도 학습 방법인 SATURN 및 SAMap과 추가로 비교했다. 4개 데이터셋 중 3개에서 UCE는 인간과 새로운 종 간의 세포 유형 레이블 전이 시 여전히 SATURN 및 SAMap보다 우수한 성능을 보였다. UCE는 심지어 진화적으로 고도로 분화된 종, 예를 들어 초파리에 대해서도 일관된 제로샷 임베딩을 생성할 수 있었다.
새로운 데이터에서의 세포 유형 조직 구조
단일 세포 유형 클러스터링의 평가 지표에 주목하는 것 외에도, 연구팀은 전체적인 차원에서 범용 임베딩 공간의 구조, 즉 서로 다른 세포가 해당 공간에서 갖는 상대적 위치 관계를 분석했다. Tabula Sapiens v.2 폐 조직의 모든 세포를 임베딩한 결과, 명확한 생물학적 의미를 갖는 세포 유형 조직 구조를 관찰할 수 있었다(아래 그림 a). 서로 다른 세포 유형이 각각 클러스터링될 뿐만 아니라, 예를 들어 T 세포, 단핵구, 내피 세포가 뚜렷한 클러스터를 형성하며, 더 높은 수준의 세포 범주, 예를 들어 면역 세포와 상피 세포도 명확하게 구분될 수 있었다.
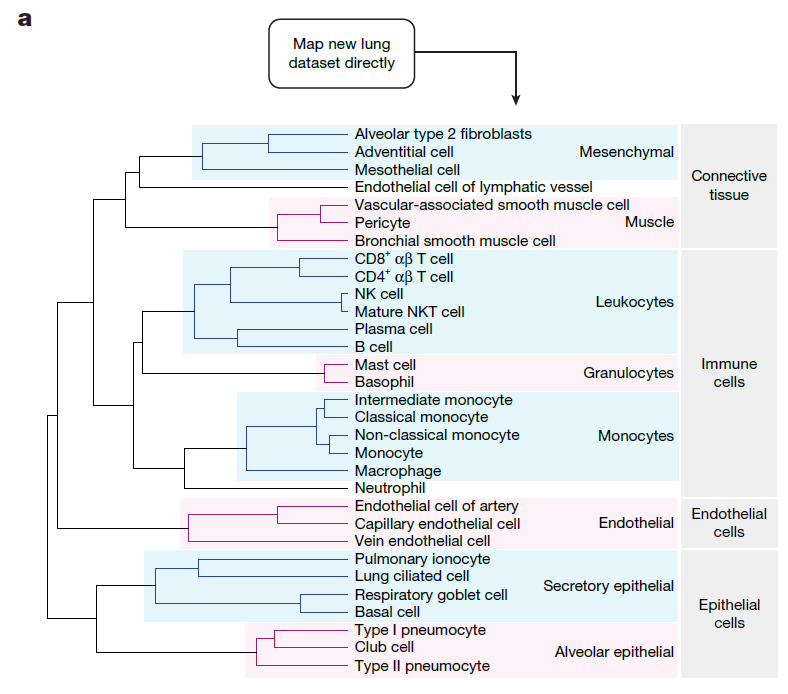
*새롭고 이전에 볼 수 없었던 데이터에 대해 생성된 UCE 공간은 생물학적 의미를 갖는 세포 유형 조직 구조를 나타낸다*
연구진은 이 결과를 세포 온톨로지 기반의 세포 계층 구조와 추가로 비교했다. 결과에 따르면, 다른 제로샷 임베딩 방법과 비교하여 UCE가 식별한 세포 클러스터는 Cell Ontology와 더 높은 유사성을 보였다.
추가 실험을 통해 UCE가 범용 세포 생물학 특성 표현을 효과적으로 학습할 수 있음이 밝혀졌다. 이러한 표현은 서로 다른 세포 유형을 구분할 수 있을 뿐만 아니라, 다양한 규모에서 세포 유형 간의 상대적 유사성을 포착할 수 있어, 세포 발달과 기능 이면의 더 깊은 생물학적 법칙을 추가로 규명할 수 있는 가능성을 제시한다.
UCE의 폐 질환 결과 분석
마지막으로, 연구진은 UCE와 이전에 구축된 Norn 세포 분류기를 활용하여 폐 질환에서의 Norn 유사 세포를 연구했다. 특발성 폐섬유증(idiopathic pulmonary fibrosis, IPF), 만성 폐쇄성 폐질환(chronic obstructive pulmonary disease, COPD) 환자 및 대조군 환자의 폐 세포를 샘플링하고 해당 세포 임베딩 공간을 생성했다. 세 환자군 모두에서 Norn 표지 유전자의 편향적 발현을 나타내는 Norn 유사 폐 세포가 식별되었으며(아래 그림 d), 추가 분석 결과 이러한 Norn 유사 폐 세포가 질환군 간에 발현 차이를 보이는 것으로 나타났다(아래 그림 e).
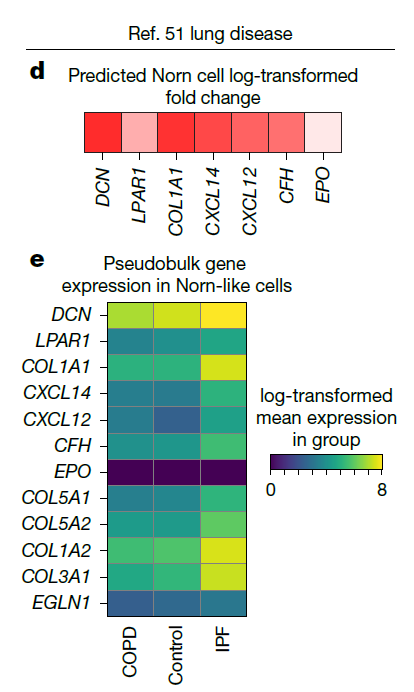
*Norn 세포 사례 연구는 UCE가 단일 세포 데이터셋의 추가 분석을 지원할 수 있음을 보여준다*
COPD와 IPF 모두 혈중 Epo 수치 상승과 관련이 있지만, COPD 환자의 Epo 수치는 IPF 환자보다 높다. 또한, IPF 환자는 COPD 환자와 비교하여 속발성 적혈구증가증(secondary erythrocytosis)이 뚜렷하지 않거나 발생 정도가 낮다. 연구에서 폐 조직에서 Norn 유사 세포가 발견되었고, Norn 세포가 Epo를 생성할 수 있다는 점을 고려할 때, 이 두 질환의 예후 차이는 질환 관련 Norn 유사 세포의 차이와 관련이 있을 수 있다.
종합적으로 볼 때, 이러한 결과는 신체의 다른 조직에서도 Norn 세포와 유사한 전사 상태를 갖는 세포가 발견될 수 있으며, 이러한 세포가 질환 과정에서 이전에 기술되지 않은 역할을 수행할 수 있음을 시사한다. UCE는 조직, 종 또는 질환 상태에 제한되지 않는 범용 모델이므로, 이처럼 대규모의 다양한 데이터 분석을 크게 촉진할 수 있다.
결론
UCE를 구축함으로써 연구진은 scRNA-seq 데이터 분석 능력을 추가로 확장했다. 이 모델이 범용 세포 임베딩을 향한 중요한 진전을 대표하지만, 여전히 몇 가지 제한점이 존재한다. 현재의 벤치마킹은 주로 UCE가 전문가가 주석을 단 세포 유형을 복원하는 능력을 평가하지만, 이러한 작업 자체는 기존 세포 레이블의 입자성과 주관성에 의해 제한된다. 따라서 이러한 평가는 세포의 교란에 대한 반응이나 서로 다른 모달리티 데이터 간의 통합과 같은 보다 미세한 생물학적 과정을 모델이 표현하는 능력을 충분히 반영하지 못할 수 있다. 또한, 다른 대규모 생물학 기반 모델과 마찬가지로 UCE는 상당 부분 여전히 블랙박스 모델이므로 특정 임베딩이 왜 그리고 어떻게 형성되는지 설명하기 어렵다. 이러한 불투명성을 해결하려면 모델이 학습한 표현을 생물학적 메커니즘 수준의 이해와 연결하는 해석 가능성 도구의 추가 개발이 필요하다. UCE의 훈련 데이터는 규모가 방대하지만 여전히 포유류 종, 특히 인간과 생쥐에 편향되어 있으며, 또한 뇌 조직과 같은 특정 조직에 편향되어 있어, 모델이 대표성이 부족한 종과 생물학적 시나리오로 일반화할 수 있는지에 대한 우려를 제기한다.
마지막으로 강조할 점은, UCE가 서로 다른 데이터셋 간에 공유되는 생물학적 신호를 포착하여 데이터 정렬을 개선할 수 있지만, 전통적인 배치 효과 보정 방법을 대체할 수는 없다는 것이다. 알려진 실험적 교란 요인을 처리하는 데 있어 전통적인 방법은 여전히 중요한 가치를 지닌다.
참고문헌: