Command Palette
Search for a command to run...
초억 개의 소분자에 대해 8억 장의 예측 질량 스펙트럼을 생성하는 AIMe 제안, 화학 규칙·파단 경로 추론 및 신경망 학습 융합
대사체학 연구에서 질량 분석법은 복잡한 생물학적 샘플로부터 수많은 소분자 신호를 포착할 수 있지만, 신호 감지는 첫 단계일 뿐 실제로 더 어려운 것은 이들이 어떤 분자에 해당하는지 규명하는 것입니다. 현재 비교에 사용할 수 있는 실험적 참조 스펙트럼 라이브러리는 알려진 화합물의 1% 미만만을 커버하고 있으므로, 전형적인 복잡한 생물학적 샘플에서는 대사체의 80% 이상이 여전히 동정되지 못합니다. 동시에 소분자의 구조 공간은 DNA와 단백질보다 훨씬 복잡하며, 동일한 분자식이 여러 다른 구조에 대응될 수 있어 표준품과 참조 스펙트럼 라이브러리만 지속적으로 확장해서는 이처럼 방대한 화학 공간을 모두 아우르기 어렵습니다.
이 문제를 해결하기 위해 코넬 대학교 연구진은 소분자 질량분석 해독을 위한 다중 에이전트 신경기호 AI 프레임워크인 AIMe(AI Molecule Explorer)를 개발했습니다. 핵심 모델인 DeepMS²Reasoner는 화학 규칙, 단편화 경로 추론 및 뉴럴 네트워크 학습을 결합하여 분자 구조부터 출발해 화학결절 끊어짐이나 수소 이동 같은 단편화 과정을 시뮉레이션하고 이에 상응하는 MS² 스펙트럼을 예측합니다. 이를 통해 AIMe는 전통적인 ‘실험 질량분석-참조 스펙트럼 라이브러리’ 직접 매칭의 한계를 넘어 알려지지 않은 질량분석 데이터를 보다 넓은 분자 구조 공간 속에서 관련 후보군을 찾아냅니다.
이 능력을 기존 소분자 공간으로까지 확대하고자 연구팀은 추가로 MS²KOSMOS를 구축했으며, 이는 PubChem 내 1억 개가 넘는 소분자에 대해 8억 장 이상의 예측된 MS² 스펙트럼을 생성함으로써, 검색 가능한 질량공간을 기존의 실험용 스펙트럼 라이브러리 대비 약 3개 로그(orders of magnitude) 이상 넓혔습니다. 하나의 미지의 질량데이터를 입력하면 AIMe는 단순히 후보 분자를 반환하는 데 그치지 않고 해당 단편화 경로를 제시하며 구체적인 질량피크들을 잠재적인 조각 분자식 및 구조와 연결시킵니다. 이어 연구팀들은 생쥐 장내 미생물 연관 대사와 GNPS 대규모 질량 데이터셋을 활용하여 이 시스템의 미소분자 해독 능력과 데이터베이스 수준의 주석 기능을 검증하였습니다.
관련 성과물은 「Charting the small-molecule universe from mass spectra with neuro-symbolic AI」라는 제목으로 사전 출판 플랫폼 bioRxiv에 게재되었습니다.
<figure>
<img src="https://api-rsrc.hyper.ai/post/ai-molecule-explorer/cn/805965b2-8ee4-4ac7-adf0-e4fe7519383d.png" />
</figure>
논문 확인:
https://www.biorxiv.org/content/10.64898/2026.08.05.743095v1
실험 질량분석에서 억 단위 소분자 공간으로
AIMe의 주요 데이터는 다음 세 가지 임무를 수행하도록 설계되었습니다: 질량예측모델 훈련, 검색 가능한 소분자 공간 구성, 그리고 실제 샘플에서의 해독 성능 평가.
DeepMS²Reasoner의 훈련 데이터는 NIST 2020 트로말리제이션(Tandem) 질량분석 DB에서 가져왔습니다. 연구진 양성화된 이온 [M+H]+ 와 탈양성자가 된 이온 [M−H]− 에 대한 MS² 스펙트럼을 유지하면서 금속 함유 화합물들과 완전하지 못한 구조 정보를 지닌 샘플들을 제외시키고 모든 피크와 분자구조를 통일 처리하였습니다. 전체 InChIKey 기준으로 80% 훈련집단/10% 검증집단/10% 테스트 집단을 나누었으며 최종적으로 Morgan fingerprint 기반 Tanimoto 유사도가 1.0 인 경우 중복 제거되어 평가결과 반영되도록 하였습니다.
외부 일반화능력은 CASMI 2022 과 MassSpecGym 두 독립 데이터 셋으로 검토했는데 둘다 학습과정에는 쓰이지 않았습니다 . 추가되는 구조검색 난이도증가를 위해서 각 실험값마다 진짜 정답 외에 최대 49 개의 유사한 질량을 가진 또다른 pubchem compound 들 도 섞어서 넣었습니다 . 특히 casmi 의 경우에는 동일한 molecular formula 를 갖는 모든 이성질체를 포함시키는 stricter test case 까지 만들어서 총 250 만여 건 정도 되는 candidate spectrum set 을 만들기도 했습니다 .
학습완료 후 연구범위를 pubchem 안의 existing compounds 로 넓혀갔습니다 . m/z < 1000 인 유기물질 중 무려 1.05 억종 이상 대상 삼아 positive/negative ion mode 각각 그리고 collision energy 네가지 조건별로 ms/ms prediction 진행해서 total 8 억장 넘게 계산했고 이것을 ms/kosmos 라는 searchable database 형태로 정리해 놓았습니다 . 이후 unknown sample query 때 쓸 수 있게 준비끝낸 상태죠 .
실제 적용사례로는 크게 두 종류 사례들이 소개됩니다 : 첫째 sterile mouse fecal metabolome vs specific pathogen free SPF mice gut microbiota dependent signals 중 abundance 높지만 conventional standard/library match 되지 않는 것들 선별해서拿来 쓴 경우입니다 . 둘째 gnps public library 에서 charge state filtering 등 거친 뒤에 남았던 consensus spectrum 들인데 여기서는 정확히 7,144,480 건 만큼 big scale search space 로 들어갔습니다 .
모델에게 “어떻게 깨져나가는가” 가르치기
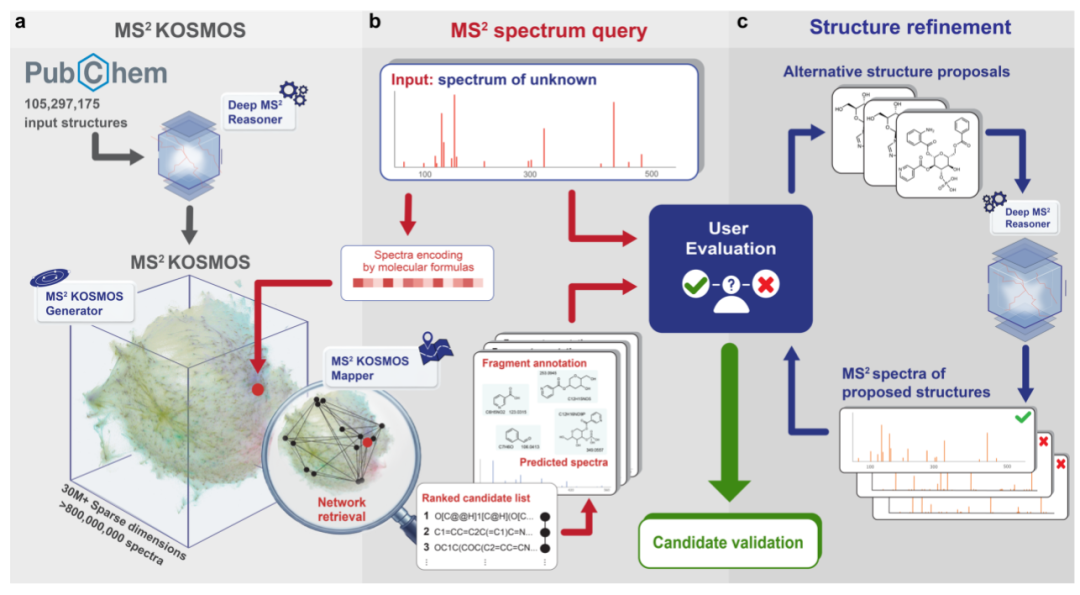
aime 는 서로 연동되는 세 모듈들로 이루어집니다 : deepms²reasoner 가 molecule graph input 으로서 ms/sp fragmentation pathway outputs 내놓고 , ms²kosmosgenerator 가 위 model 호출해서 huge chemical structures 대상으로 batch predict 돌리며 kosmos db 자체 build up 하고 마지막으로 mapper component 쪽에선 real world experiment data 들어오면 kosmos 안에서 matching 할 만한 neighborhood regions 탐색해주며 결과 리턴해주는 식입니다 . 이렇게 미리 offline stage 에서 heavy computation 끝내고 나면 online inference 때는 filtered candidates subset 에 대해서만 fine-grained calculation 하면 되므로 속도와 효율성이 극대화 됩니다 .
<figure>
<img src="https://api-rsrc.hyper.ai/post/ai-molecule-explorer/cn/a6e16a70-7f1d-4519-be37-97bfad5c320e.png"  />
</figure>
*AIME overall framework*
이중 DeepMS²Reasoner는 전체 시스템의 질량 스펙트럼 예측 능력을 결정합니다. 이는 「특정 분자가 어떤 피크를 가지며 그 강도는 어떠한가」를 직접 학습하는 것이 아니라, 전구체 분자에서 시작하여 파편화 과정을 단계별로 시뮬레이션하고 방향성 비순환 그래프(DAG)를 동적으로 구축합니다. 그래프 내 노드는 서로 다른 조각을 나타내고, 간선은 구체적인 절단 동작에 해당합니다. 모델은 선형 결합 단절, 고리 결합 단절 및 제거라는 세 가지 메커니즘을 고려하며 동시에 하전 상태 변화와 수소 이동도 기록합니다. 또한 사전에 절단 깊이를 제한하지 않으므로, 다단계 결합 끊기, 고리 열림 또는 재배열을 거쳐야 형성될 수 있는 복잡한 조각들을 표현할 수 있습니다.
어떤 파편화 경로를 선택할지는 신경망 컴포넌트인 ALEA(Action Likelihood Estimator Advisor)가 판단합니다. ALEA는 Graphormer 아키텍처를 사용하며, 현재 조건의 원자, 화학적 결합, 고리 구조 및 수소 상태를 비롯해 충돌 에너지, 기기 조건, 부가 이온 등의 실험 환경 정보를 바탕으로 다양한 절단 동작과 「파편화 중단」에 확률을 할당합니다. 이후 DeepMS²Reasoner는 이러한 확률 값을 파편화 경로로 전달하며, 각 조각에 최종 누적된 중단 확률을 통해 대응되는 질량 스펙트럼 피크의 강도를 산출합니다.
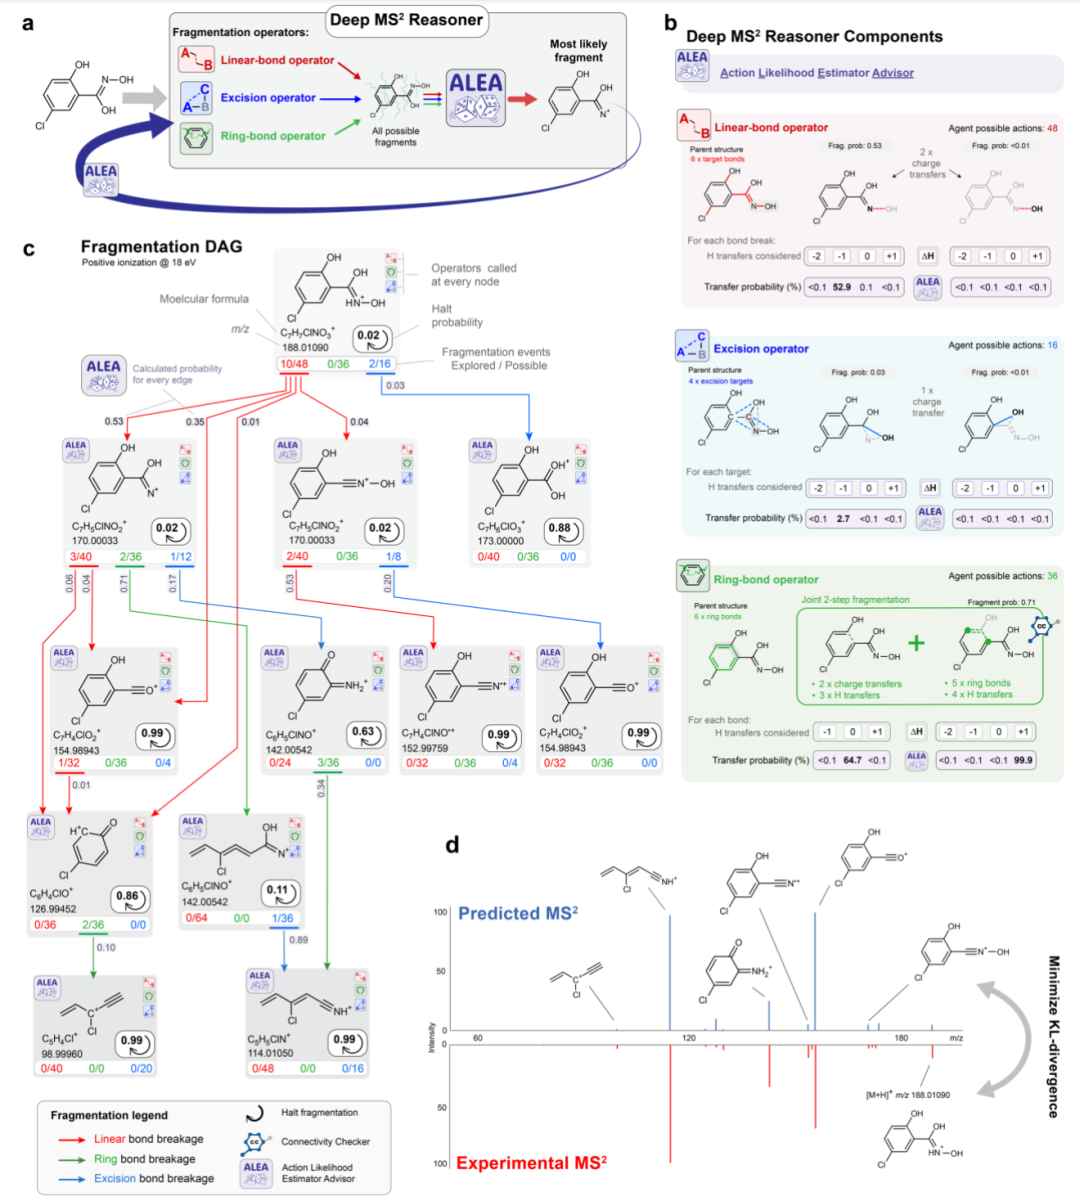
신경망은 어느 경로가 더 발생할 가능성이 높은지 판단하는 역할을 하고, 화학 규칙은 어떤 경로가 발생 가능한지를 제한하는 역할을 합니다. 매번 절단이 일어나면 시스템은 분자의 연결 관계나 수소 균형 등 화학적 제약을 점검하여, 합리적이지 않은 절단은 후속 계산으로 진행되지 않도록 합니다. 동일한 구조와 화학적 상태를 가진 조각들은 병합되어 중복 검색을 줄입니다. 또한 확률이 매우 낮은 가지(branch)는 계속 확장하지 않음으로써, 분자 복잡도가 증가함에 따라 기하급수적으로 늘어나는 모든 파편화 경로의 완전 탐색(complete enumeration)을 방지합니다.
학습 과정에서 파라미터를 주로 배우게 되는 것은 ALEA이며, 나머지 절단 연산들과 화학적 타당성 판단은 모두 확정적인 규칙(deterministic rules)에 의해 수행됩니다. 모델은 예측된 질량 스펙트럼과 실제 실험 데이터 간의 차이를 KL 발산을 사용하여 측정하며, 정규화 제약도 함께 적용했습니다. 이로써 여러 메커니즘이 하나의 질량 스펙트럼 피크를 설명할 수 있을 때 비교적 단순한 선형 결합 단절을 우선시하도록 유도하였습니다. 훈련에는 커리큘럼 러닝(curriculum learning) 방식도 채택되었는데, 작고 파편화 경로가 간단한 분자들부터 시작해 점차 크고 복잡한 화합물들로 넘어감으로써 먼저 이전 가능한 국소적 파편화 법칙을 습득하게 했습니다.
DeepMS²Reasoner가 해결하고자 한 문제는 「구조로부터 질량 스펙트럼을 예측한다」라면, MS²KOSMOS는 「억 단위 규모의 분자들 사이에서 어떻게 검색할 것인가」를 추가로 해결합니다. MS²KOSMOSGenerator는 예측된 스펙트럼 각각을 조각들의 분자로 구성된 희소 벡터(sparse vector) 형태로 변환하고 역색인(inverted index)을 구축합니다. 미지의 질량 스펙트럼이 주어졌을 때 시스템은 억 개의 분자들을 일일이 비교할 필요 없이, 쿼리 스펙트럼과 공유되는 조각 분자를 갖는 후보군들을 먼저 찾아낸 뒤, MS²KOSMOSMapper가 실제 충돌 에너지 등 실험 조건에 맞춰 다시 예측된 질량 스펙트럼을 정렬(sorting)함과 아울러 그에 해당하는 파편화 DAG를 반환합니다.
예측된 질량 스펙트럼으로부터 알려지지 않은 분자 해독하기
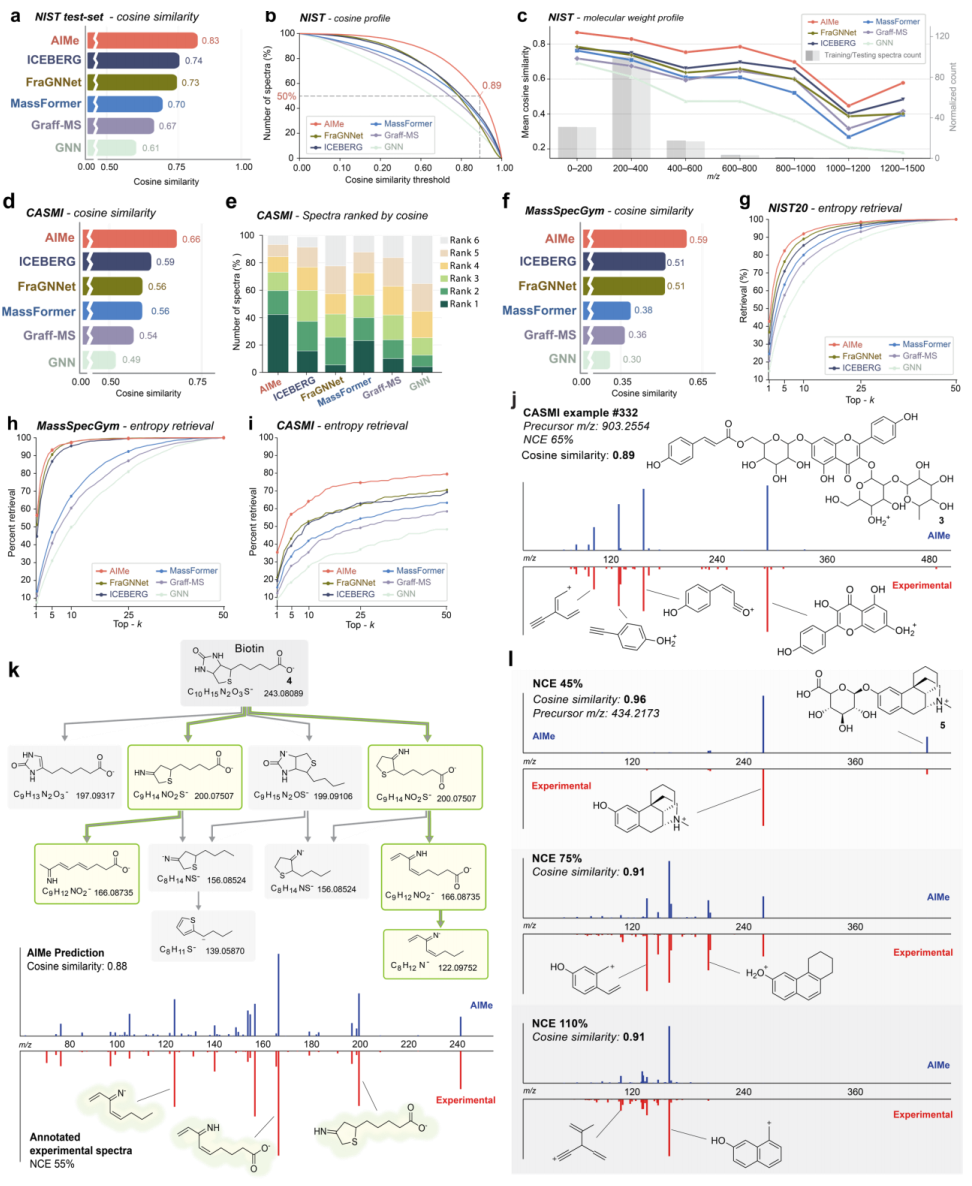
연구진은 가장 기초적인 질량 스펙트럼 예측 과제부터 시작하여 DeepMS²Reasoner를 검증했습니다. NIST 2020 독립 테스트셋에서는 예측 스펙트럼과 실험 스펙트럼 사이의 평균 코사인 유사성이 0.83에 달했으며 중앙값은 0.89였습니다. 반면 다른 대조 모델들의 평균치는 0.61~0.75 범위 내에 머물렀습니다. 완전히 분리된 CASMI 2022 및 MassSpecGym 데이터셋에서도 DeepMS²Reasoner의 평균 코사인 유사성은 각각 0.67과 0.59로 나왔으며, 참가한 모든 모델 중 최고치를 기록했습니다. 예를 들어 CASMI 기준으로는 표본의 40% 이상에서 DeepMS²Reasoner가 제시한 예측 스펙트럼이 다른 모든 대조 모델 대비 실험 결과와 가장 근접했음을 확인할 수 있었습니다.
단순히 질량 스펙트럼만 예측하는 것보다 훨씬 어려운 과제는 반대로 실험 스펙트럼을 토대로 올바른 분자를 찾는 것입니다. 연구진들은 실제 구조와 질량이 비슷하거나 구조가 유사한 수많은 후보 분자들을 함께 배치하여 검색 작업을 실시했습니다. CASMI 전체 이성질체(full-isomer) 평가에서 DeepMS²Reasoner의 Top-1, Top-10 그리고 Top-50 정확도는 각각 35.6%, 64.4%, 79.8%였으며, 이중 Top-1과 Top-10 지표는 두 번째 순위였던 FraGNNet 보다 무려 10%p 이상 높았습니다.
모델이 다단계 파편화를 처리하는 능력 역시 특정 분자들을 대상으로 확인되었습니다. 생소비오틴(biotin)을 예로 들면, DeepMS²Reasoner가 내놓은 예측 스펙트럼과 실험 스펙트럼 간 코사인 유사성이 0.88이었습니다. 일부 주요 조각들은 단일 결합 단결만으로 만들어지기 어렵지만, 작용기 이탈(group elimination), 고리 열림(open-ring), 추가적인 파편화와 같은 연속적인 과정을 겪어야만 생성됩니다. 본 모델은 이와 같은 조각들에 대한 다단계 경로를 제공하였으며, 충돌 에너지 변동에 따른 정도별 차이까지 반영하여 적절한 수준의 파편화를 예측했습니다.
DeepMS²Reasoner 의 질량 스펙트럼 예측 성능
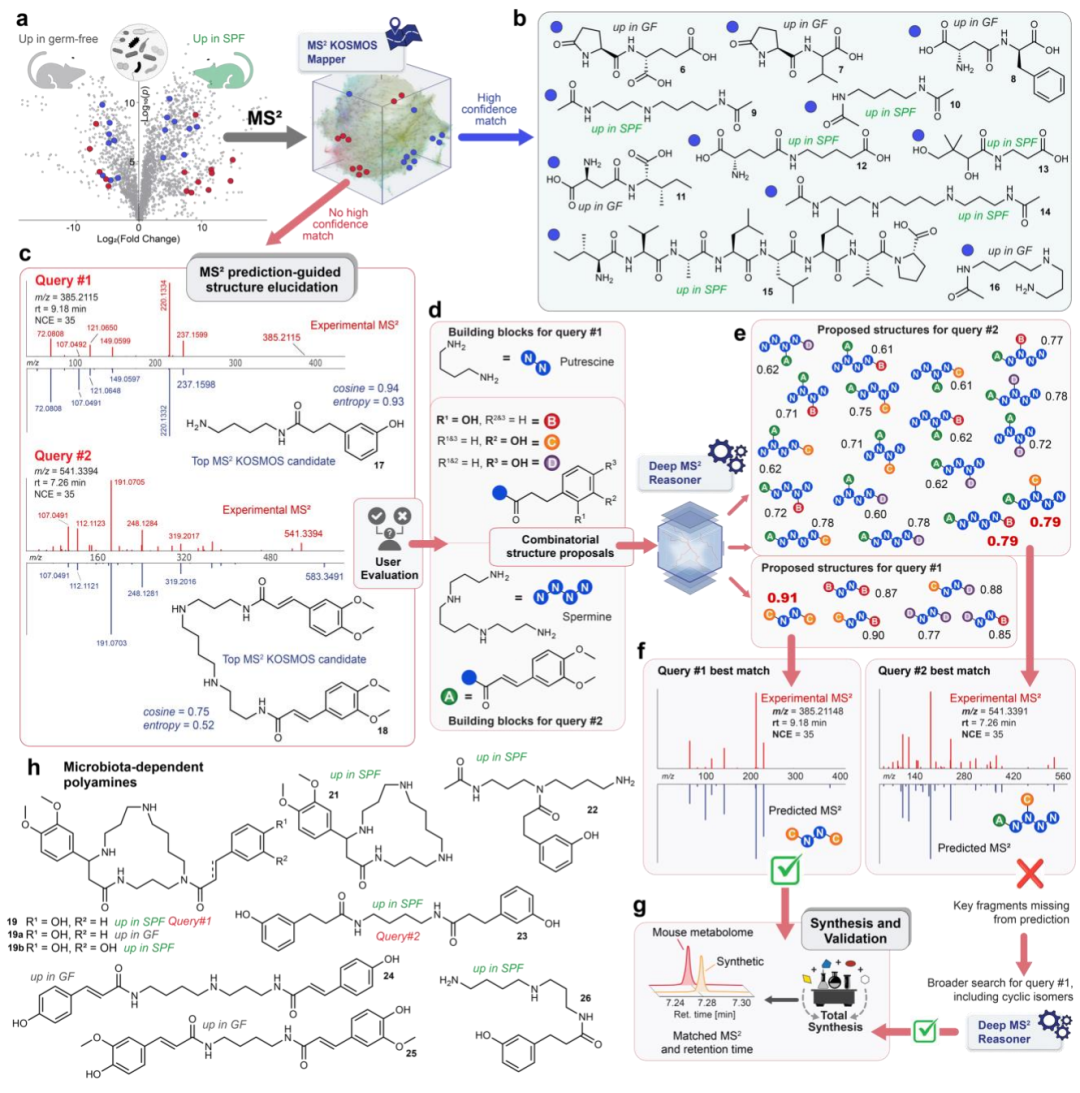
이후 연구팀은 AIMe 를 진짜 미지의 대사물질 해석 작업에 활용해보기도 했는데요. 쥐 대사체(metabolome) 에 속하는 111 개 식별 되지 않는 마이크로바이오타 의존 신호 중 약 3분의 1 은 MS²KOSMOS 안에서 알려진 화합물과 상당히 유사하게 일치하는 항목을 찾았고, 나머지는 아직 기술되지 않은 새로운 구조체에 해당할 가능성이 더 컸습니다.
연구진은 추가로 두 가지 미지 물질을 선택하여 구조를 해석했다. AIMe가 제공한 조각(fragment) 구조에 기반하여 그들은 다양한 후보 분자를 조합했고, 이러한 후보들의 MS² 스펙트럼을 예측한 뒤 실험 결과와 비교했다. 한 미지 물질의 최상위 초기 후보는 코사인 유사도가 이미 0.79에 달했지만, 여전히 실험에서 관찰된 몇몇 중요한 조각들이 누락되어 있었다. 이에 연구팀은 고리화(cyclization) 구조도 계속 고려하며 드물게 발견되는 거대 고리 폴리아민 유도체 하나를 특정했다. 화학 합성을 통해 유지 시간(retention time)과 MS² 스펙트럼을 비교함으로써 두 후보 구조 모두 최종적으로 검증되었으며, 여기서는 이전에 쥐나 인간에서 보고되지 않은 폴리아민 구조도 포함되었다. 추가 검색 결과 여러 관련 대사체들도 사람 시료中存在하는 것으로 나타났다.
마지막으로, 연구진은 AIMe를 GNPS 데이터베이스 내 714만여 개의 컨센서스 질량 스펙트럼으로 확장하였다. 코사인 유사도를 0.7로 설정했을 때 약 269만 개의 스펙트럼이 후보 주석을 얻어 전체 쿼리의 약 3분의 1을 차지했으며, 임계값을 0.8로 높였음에도 불구하고 여전히 약 127만 개 이상의 높은 유사도 주석이 새로 추가되었고 이는 기존 GNPS에서 주석 처리되지 않았던 원본 스펙트럼 2천 6백만 개 이상에 해당한다. 이를 통해 AIMe의 적용 범위는 단일 분자의 스펙트럼 예측으로부터 더 나아가 데이터베이스 규모의 미지 물질 주석 작업까지 확대되었다.
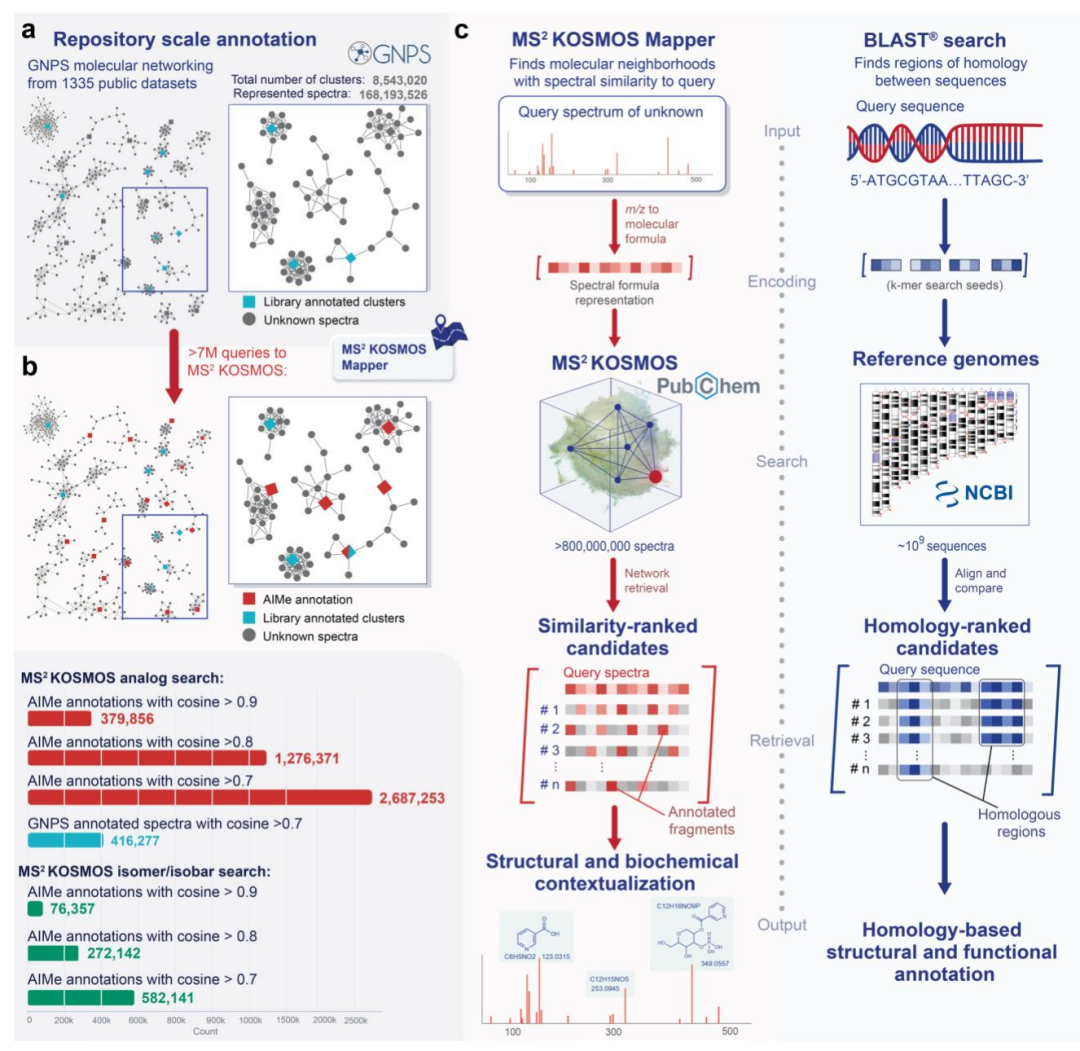 *GNPS 데이터베이스 상에서의 AIMe 대규모 주석 결과*
이러한 결과가 작은 분자 구조 규명이 완전히 자동화되었음을 의미하지는 않는다. 분자량이 증가함에 따라 가능한 단편화 경로가 현저히 늘어나며 훈련 데이터 내에서 대형 분자들의 커버리지는 상대적으로 부족하기 때문에 DeepMS²Reasoner의 예측 성능은 여전히 저하된다. 더욱重要的是, MS² 자체로는 일반적으로 최종 구조 확인을 수행하기에 충분하지 않다. 메타볼롬ics 표준에 따르면 보존 시간, NMR 또는 표준품 등 독립적인 증거가 없는 경우, AIMe가 제공하는 결과는 주로 레벨(Level) 3 주석에 속하며 그 역할은 주로 후보 범위 축소, 구조 가설 제안 및 단편화에 대한 근거 설명에 가까우며 최종 확인에는 반드시 실험적 검증이 필요하다.
마치면서
AIMe의 의의는 단순히 스펙트럼 예측 정확도를 조금 더 향상시키는 데 있는 것이 아니라,미소분자의 해독 방식을 바꾸려는 시도이다. 과거 연구자들은 알 수 없는 하나의 스펙트럼 앞에서 제한된 규모 실험 스펙트럼 라이브러리 안에서 직접 매칭을 찾는 것 외에는 별다른 방법이 없었지만, AIMe는 먼저 모델을 활용하여 알려진 소분자 공간을 탐색 가능한 예측 스펙트럼 공간으로 변환하고, 이어 조각 구조와 단편화 경로를 활용해 점차 후보 범위를 좁혀간다. 현재로서는 표준품이나 NMR 등의 실험적 검증을 대체할 수는 없지만, 이로 인해 「참조 스펙트럼 없음」이라는 이유로 더 이상 분석이 어려웠던 수많은 신호들을 추적할 가능성이 열리게 되었다.
메타볼롬ics 관점에서 볼 때 이것은 단순하게 스펙트럼 항목 목록을 늘리는 것보다 훨씬 중요하다: 이제 미지의 스펙트럼은 오직 「일치함(match)」 혹은 「불일치(mismatch)」라는 이진 결과를 넘어서서, 구조 가설을 제시하고 검증해 나가는 시작점이 될 수 있게 되었기 때문이다.