Command Palette
Search for a command to run...
Générer 800 Millions De Spectres De Masse Prédits Pour Plus D'un Milliard De Petites Molécules : AIMe, Proposé Par L'université Cornell, Fusionne Les Règles Chimiques, Le Raisonnement Sur Les Voies De Fragmentation Et L'apprentissage Des Réseaux Neuronaux
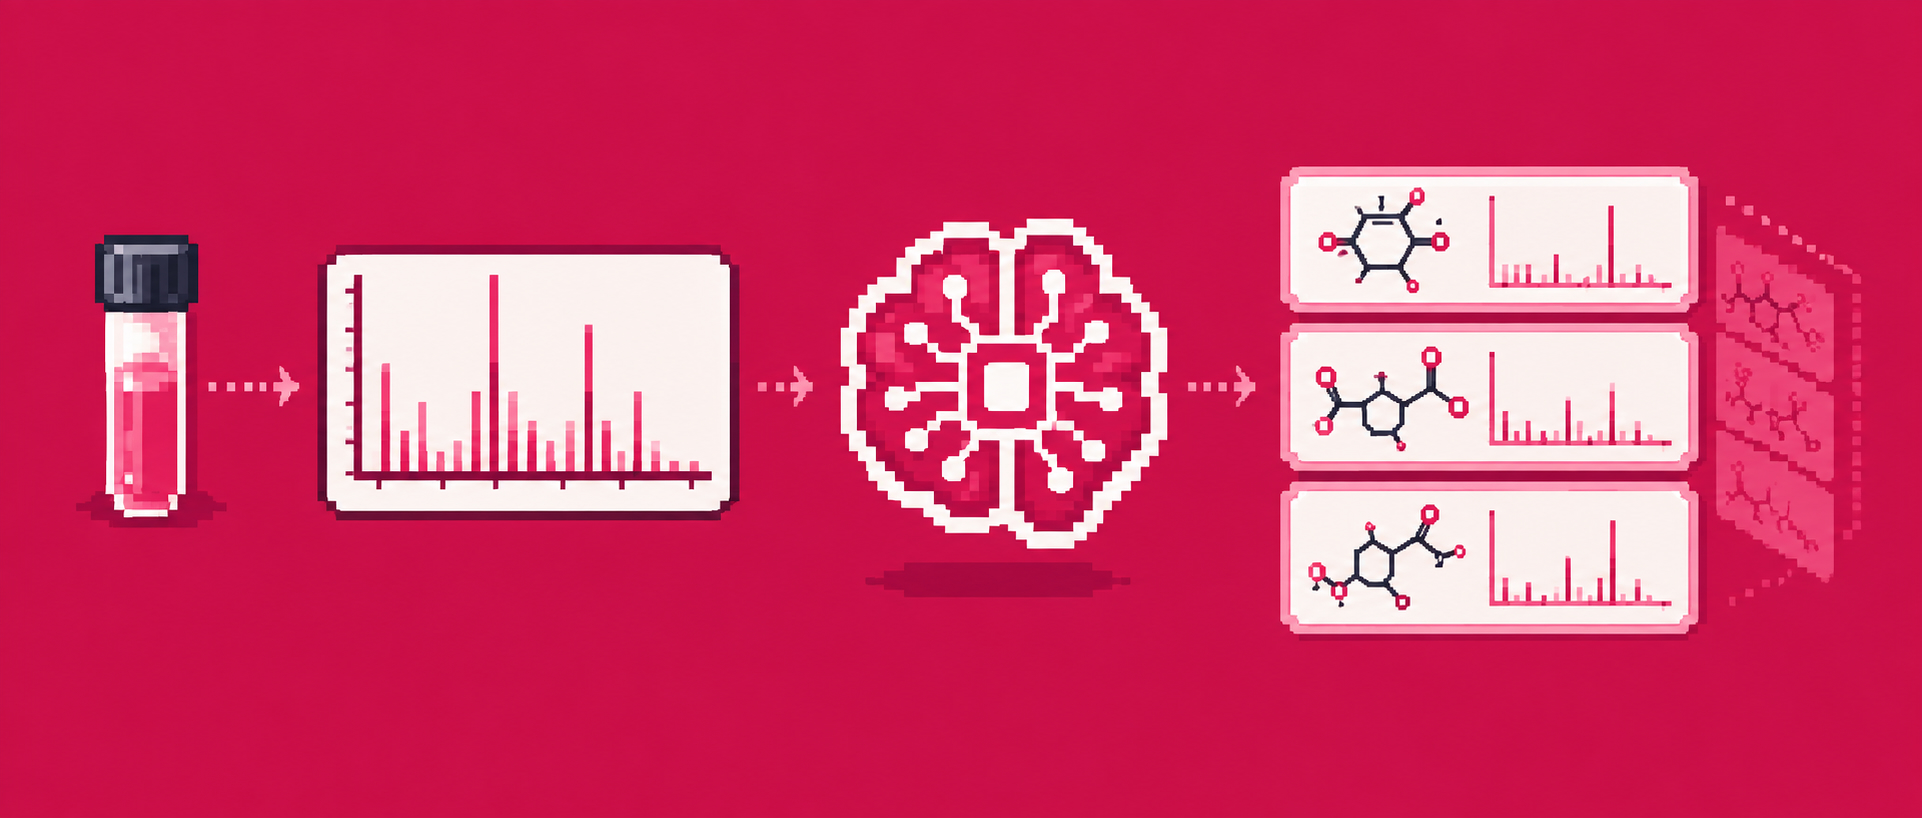
Dans les études de métabolomique, la spectrométrie de masse permet de capter d’innombrables signaux de petites molécules à partir d’échantillons biologiques complexes ; cependant, détecter ces signaux n’est que la première étape : le véritable défi réside dans l’identification des molécules correspondantes. Actuellement, les bibliothèques expérimentales de référence disponibles pour la comparaison couvrent moins de 1 % des composés connus, ce qui signifie que plus de 80 % des métabolites présents dans un échantillon biologique complexe typique restent généralement non identifiés. Parallèlement, l’espace structural des petites molécules est bien plus complexe que celui de l’ADN et des protéines. Une même formule moléculaire peut correspondre à une multitude de structures différentes ; il est donc difficile, en se limitant au simple enrichissement continue des produits standards et des bibliothèques de référence, de couvrir cet espace chimique aussi vaste.
Face à cette problématique, une équipe de recherche de l’université Cornell a développé AIMe (AI Molecule Explorer), un cadre d’intelligence artificielle neuro-symbolique multi-agents dédié à l’analyse par spectrométrie de masse des petites molécules. Le modèle central, DeepMS²Reasoner, intègre règles chimiques, raisonnement sur les voies de fragmentation et apprentissage neuronal afin de simuler, à partir de la structure moléculaire, des processus tels que la rupture des liaisons chimiques ou le transfert d’hydrogène, tout en prédisant le spectre MS² correspondant. Grâce à cela, AIMe dépasse la méthode traditionnelle consistant à effectuer une correspondance directe entre « spectres expérimentaux » et « bibliothèques de références », permettant ainsi de rechercher parmi un ensemble beaucoup plus large de structures moléculaires les candidats pertinents associés aux spectres inconnus.
Afin d’étendre cette capacité à l’espace connu des petites molécules, l’équipe a également construit MS²KOSMOS, générant plus de 800 millions de spectres MS² prédits pour plus de 100 millions de petites molécules présentes dans PubChem, augmentant ainsi l’espace spectral recherchable d’environ trois ordres de grandeur par rapport aux bibliothèques expérimentales actuelles. Pour un spectre MS² inconnu donné, AIMe ne se contente pas de retourner des molécules candidates, mais fournit également leurs chemins de fragmentation associés et relie chaque pic spécifique du spectre aux formules fragmentées possibles et à leur structure. L’équipe a ensuite validé ses capacités d’analyse de petites molécules inconnues et d’annotation au niveau de bases de données grâce à des métabolites dépendants du microbiote intestinal chez la souris ainsi qu’à des données de spectrométrie de masse à grande échelle issues de GNPS.
Les résultats connexes ont été publiés sous forme de prépublication sur bioRxiv, avec le titre « Charting the small-molecule universe from mass spectra with neuro-symbolic AI ».
Consulter l'article :
https://www.biorxiv.org/content/10.64898/2026.08.05.743095v1
Des spectres expérimentaux à l'espace des milliards de petites molécules
Les données utilisées par AIMe remplissent principalement trois fonctions :** entraîner le modèle de prédiction des spectres de masse, construire un espace de petites molécules interrogeable, et vérifier sa capacité d’analyse sur des échantillons réels.**
Les données d’entraînement de DeepMS²Reasoner proviennent de la base de données de spectrométrie de masse en tandem NIST 2020. Les chercheurs ont conservé les spectres MS² des ions protonés [M+H]⁺ et déprotonnés [M−H]⁻, exclu les composés métalliques ainsi que les échantillons dont les informations structurales étaient incomplètes, et harmonisé le traitement des pics spectraux et des structures moléculaires. Les données ont été divisées selon des clés InChI complètes en 80 % pour l’apprentissage, 10 % pour la validation et 10 % pour les tests. Afin de réduire l’influence des redondances structurelles, lors de l’évaluation finale, les molécules testées présentant une similarité Tanimoto de 1,0 avec celles du jeu d’apprentissage (basée sur les empreintes digitales Morgan) ont été exclues.
La capacité de généralisation externe du modèle a été évaluée via deux jeux de données indépendants, CASMI 2022 et MassSpecGym, aucun des deux ayant servi à l’entraînement. La tâche de recherche structurelle a encore été complexifiée : pour chaque spectre expérimental, en plus de la structure réelle, jusqu’à 49 molécules de PubChem proches en masse et similaires structuralement ont été ajoutées comme éléments perturbateurs. Dans le cas de CASMI, une évaluation encore plus stricte basée sur tous les isomères a été conçue, incluant tous les isomères de PubChem partageant la même formule brute parmi les candidats, soit près de 2,5 millions de spectres candidats au total.
Après avoir achevé l’entraînement du modèle, le champ d’application a été étendu aux petites molécules connues contenues dans PubChem. Parmi plus de 105 millions de composés organiques ayant un rapport charge/masse inférieur à 1000, AIMe a prédit les spectres MS² selon les modes ion positif et négatif, ainsi que sous quatre énergies de collision différentes, générant ainsi plus de 800 millions de spectres prédits organisés au sein de MS²KOSMOS, servant de fondement à la recherche ultérieure de spectres inconnus.
L’application concrète repose essentiellement sur deux groupes de données. Le premier concerne le métabolome fécal provenant de souris axéniques (germ-free, GF) et de souris sans pathogènes spécifiques (specific-pathogen free, SPF) dotées d’un microbiote intestinal complet ; parmi ceux-ci, 111 signaux dépendants du microbiote, relativement abondants mais non identifiables ni par les produits standards existants ni par les bibliothèques spectrales, ont été sélectionnés. Le second groupe provient de la base publique GNPS de spectrométrie de masse ; après filtrage selon divers critères tels que l’état de charge et la masse moléculaire, un total de 7 144 480 consensus MS² sont entrés dans la phase de recherche massive.
Apprendre comment les molécules se « cassent »
AIMe s’articule autour de trois modules interconnectés : DeepMS²Reasoner assure la prédiction des spectres MS² et des chemins de fragmentation à partir de la structure moléculaire ; MS²KOSMOSGenerator exploite ce modèle pour réaliser des prédictions à grande échelle sur des structures chimiques volumineuses et constitue la bibliothèque consultable MS²KOSMOS ; enfin, MS²KOSMOSMapper traite les spectres expérimentaux inconnus en recherchant dans MS²KOSMOS les molécules potentiellement associées et leurs voisinages structuraux. Une fois les grandes prédictions effectuées à l’avance, seule une analyse computationnelle fine doit être réalisée pendant la requête effective sur les structures candidates retenues.
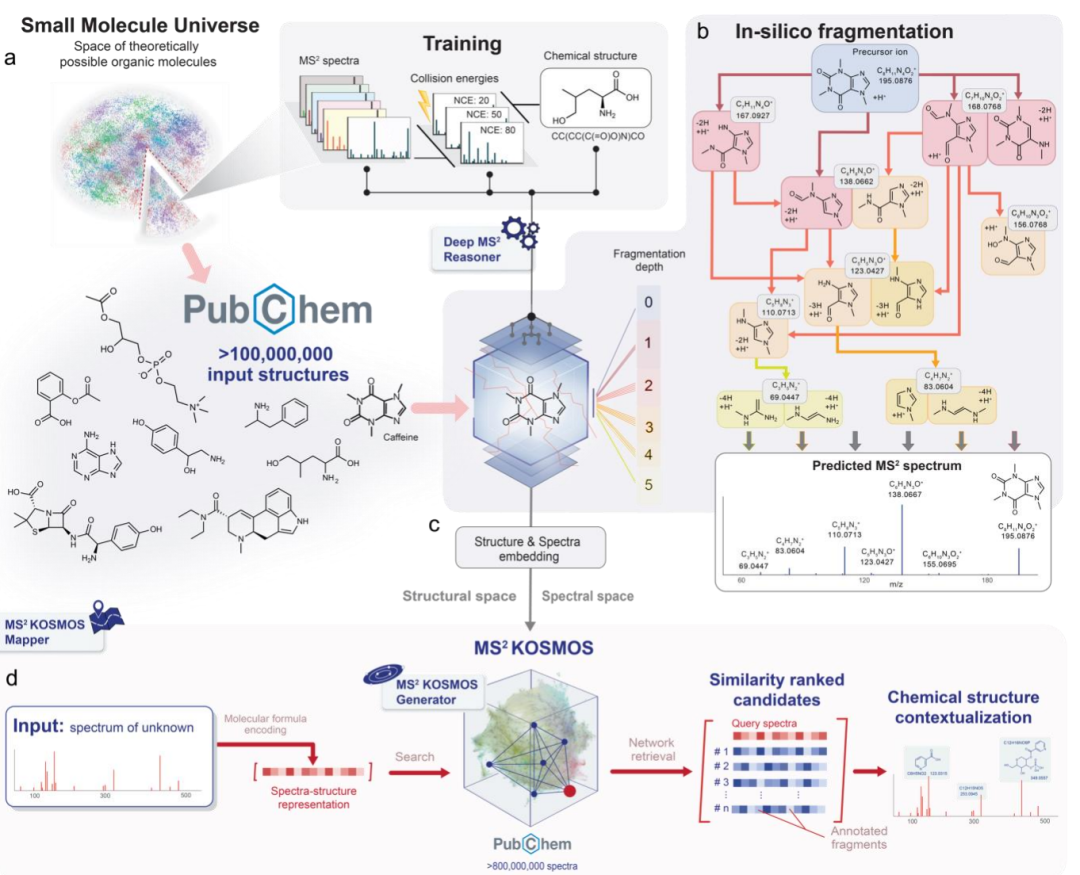
Parmi eux, DeepMS²Reasoner détermine la capacité de prédiction des spectres de masse du système entier. Il n’apprend pas directement « quels pics correspondent à une molécule donnée et quelle est leur intensité », mais simule étape par étape le processus de fragmentation en partant de la molécule précurseur, tout en construisant dynamiquement un graphe acyclique dirigé (DAG). Les nœuds du graphe représentent différents fragments, tandis que les arêtes correspondent aux actions spécifiques de rupture. Le modèle prend en compte trois mécanismes : la rupture de liaisons linéaires, la rupture de liaisons cycliques et l’élimination, tout en enregistrant les changements de charge et les transferts d’hydrogène. Comme il ne fixe pas à l’avance la profondeur maximale de fragmentation, il peut représenter des fragments complexes qui nécessitent plusieurs étapes de rupture de liaison, d’ouverture de cycle ou de réarrangement pour se former.
Le choix du chemin de fragmentation est assuré par le composant neuronal ALEA (Action Likelihood Estimator Advisor). ALEA utilise une architecture Graphormer et attribue des probabilités aux différentes actions de fragmentation ainsi qu’à l’arrêt de la fragmentation, sur la base de l’état atomique, des liaisons chimiques, de la structure cyclaire et de l’environnement hydrogéné du fragment actuel, ainsi que des conditions expérimentales telles que l’énergie de collision, l’instrument utilisé et les ions adduits. DeepMS²Reasoner propage ensuite ces probabilités le long des chemins de fragmentation ; les intensités des pics spectraux correspondants sont obtenues grâce aux probabilités cumulées finales d’arrêt associées à chaque fragment.
<figure>
<img src="https://api-rsrc.hyper.ai/post/ai-molecule-explorer/cn/3d943ef4-61bb-45d3-921b-e404b56141f9.png"  />
</figure>
Légende Figure 2 : Génération du chemin de fragmentation par DeepMS²Reasoner et processus de prédiction du spectre MS².
Les réseaux neuronaux déterminent quel chemin est le plus susceptible de se produire, tandis que les règles chimiques imposent quelles voies sont autorisées. Après chaque étape de fragmentation, le système vérifie les contraintes chimiques telles que la connectivité moléculaire et l’équilibre en hydrogènes ; toute fragmentation irréaliste est exclue des calculs ultérieurs. Les fragments ayant la même structure et le même état chimique sont fusionnés afin de réduire les recherches redondantes. Pour les branches dont la probabilité est très faible, le modèle arrête également leur développement, évitant ainsi l’exhaustivité exhaustive de tous les chemins possibles, dont le nombre croît exponentiellement avec la complexité moléculaire.
Lors de l’entraînement, ce sont principalement les paramètres d’ALEA qui doivent être appris, les autres opérations de fragmentation et les jugements de faisabilité chimique étant effectués via des règles déterministes. Le modèle mesure l’écart entre les spectres prédits et les spectres expérimentaux à l’aide de la divergence de Kullback-Leibler, tout en intégrant des contraintes de régularisation. Lorsque plusieurs mécanismes peuvent expliquer un même pic spectral, le modèle privilégie légèrement les ruptures simples de type linéaire. L’entraînement repose également sur l’apprentissage progressif (curriculum learning) : on commence par des petites molécules aux chemins de fragmentation simples, puis on introduit progressivement des composés plus grands et plus complexes, permettant au modèle d’acquérir d’abord des lois locales transférables concernant la fragmentation.
DeepMS²Reasoner résout le problème de la « prédiction de spectres de masse à partir de structures » ; MS²KOSMOS va plus loin en résolvant le problème de la recherche parmi des milliards de molécules. Le générateur MS²KOSMOS convertit chaque spectre prédit en un vecteur creux composé de formules brutes de fragments, et construit un index inversé face à cette représentation. Lorsqu’un spectre expérimental inconnu doit être analysé, le système n’a pas besoin de comparer exhaustivement les centaines de millions de molécules candidates. Au lieu de cela, il identifie d’abord les candidats partageant des formules brutes communes avec le spectre interrogé, puis fait appel à MS²KOSMOSMapper pour recalculer et classer selon leurs conditions expérimentales réelles (telles que l’énergie de collision), tout en renvoyant simultanément le DAG correspondant.
<figure>
<img src="https://api-rsrc.hyper.ai/post/ai-molecule-explorer/cn/a7f762fb-928e-43df-9641-ac28eb789cba.png"  />
</figure>
Flux de récupération dans MS²KOSMOS pour les spectres de masse inconnus.
De la prédiction de spectres de masse à l’élucidation de molécules inconnues
La recherche a commencé par évaluer DeepMS²Reasoner sur la tâche fondamentale de prédiction de spectres de masse. Sur l’ensemble test indépendant NIST 2020, la similarité cosinus moyenne entre les spectres prédits et les spectres expérimentaux atteint 0,83, avec une médiane de 0,89 ; les modèles concurrents affichent quant à eux des moyennes comprises entre 0,61 et 0,75. Sur les ensembles entièrement indépendants CASMI 2022 et MassSpecGym, DeepMS²Reasoner obtient respectivement des similarités cosinus moyennes de 0,67 et 0,59, constituant les meilleurs résultats parmi toutes les méthodes soumises à évaluation. Prenons l’exemple de CASMI : dans plus de 40 % des cas, DeepMS²Reasoner fournit la prédiction la plus proche des résultats expérimentaux comparée à celle produite par tous les autres modèles.
Par rapport à la simple prédiction de spectres de masse, une tâche encore plus difficile consiste à retrouver la bonne molécule à partir du spectre expérimental obtenu. La méthode place la véritable structure aux côtés d’une grande quantité de molécules candidates présentant des masses proches et des structures similaires lors de la phase de recherche. Lors du test complet des isomères de CASMI, les taux de précision Top-1, Top-10 et Top-50 atteints par DeepMS²Reasoner s’élèvent respectivement à 35,6 %, 64,4 % et 79,8 %. Notamment, ses scores Top-1 et Top-10 dépassent ceux du deuxième meilleur modèle, FraGNNet, de plus de dix points de pourcentage chacun.
La capacité du modèle à traiter les fragmentations multiétapes a également été validée sur des exemples concrets tels que la biotine. Dans ce cas précis, la similarité cosinus entre le spectre prédit par DeepMS²Reasoner et celui mesuré expérimentalement atteint 0,88. Certains principaux fragments ne peuvent pas être générés par une seule coupure de liaison, mais exigent plutôt une série continue incluant l’élimination de groupes fonctionnels, l’ouverture de cycles et davantage de fragmentations supplémentaires. Le modèle propose alors des itinéraires multietappes associés à ces fragments et prévoit divers degrés de fragmentation en tenant compte des variations énergétiques liées aux collisions.
<figure>
<img src="https://api-rsrc.hyper.ai/post/ai-molecule-explorer/cn/4fc8e662-778d-4bf4-a6d9-b93358e71ac2.png"  />
</figure>
Performance de prédiction des spectres de masse réalisée par DeepMS²Reasoner.
Après avoir démontré sa performance prédictive, nous avons appliqué AIMe à l’analyse réelle de métabolites inconnus. Concernant les cent onze signaux microbiens dépendants non identifiés détectés dans le métabolome murin, environ un tiers présente des correspondances hautement similaires connues trouvées via MS²KOSMOS, tandis que les autres semblent probablement appartenir à des structures encore décrites.
Les chercheurs ont ensuite sélectionné deux composés inconnus pour en résoudre la structure. Sur la base des fragments de structure fournis par AIMe, ils ont combiné plusieurs molécules candidates et prédit leurs spectres MS² correspondants afin de les comparer aux résultats expérimentaux. Pour l’un des composés inconnus, le meilleur candidat initial présentait déjà une similarité cosinus de 0,79, mais il manquait encore quelques fragments clés observés dans les expériences. L’équipe a donc envisagé davantage de structures cycliques et s’est arrêtée sur un dérivé rare d’agmatine macrocyclique. Grâce à une synthèse chimique et à la comparaison du temps de rétention ainsi que des spectres MS², les deux structures candidates ont finalement été validées ; cela incluait notamment une structure polyaminée jusqu’à lors non rapportée chez la souris ni chez l’humain. Des recherches complémentaires ont montré que divers métabolites apparentés étaient également présents dans des échantillons humains.
<figure>
<img src="https://api-rsrc.hyper.ai/post/ai-molecule-explorer/cn/3af26cea-3786-423c-bac0-a12f0224c041.png" />
</figure>
*Aide au déchiffrage des métabolites inconnus liés au microbiote intestinal de la souris grâce à AIMe*
Enfin, l’étude étend AIMe à plus de sept millions cent mille quatre-vingt-quatorze mille consensus spectraux de la base de données GNPS. En utilisant un seuil de similarité cosinus de 0,7, environ 2,69 millions de spectres ont obtenu des annotations candidates, soit près d’un tiers du total interrogé ; après avoir relevé ce seuil à 0,8, on a ajouté environ 1,27 million d’annotations à haute similarité supplémentaires, correspondant à plus de vingt-six millions de spectres bruts auparavant non annotés dans GNPS. Ainsi, le champ d’application d’AIMe passe de la prédiction de spectres MS² pour une seule molécule à l’annotation d’inconnues à l’échelle d’une base de données.
<img src="https://api-rsrc.hyper.ai/post/ai-molecule-explorer/cn/5a023d0b-0461-420d-9e6a-4eb294e8869e.png" />
*Résultats massifs d’annotation d’AIMe sur la base de données GNPS*
Ces résultats ne signifient pas que l’identification structurale des petites molécules est entièrement automatisée. À mesure que la masse moléculaire augmente, le nombre de voies possibles de fragmentation croît nettement, tandis que la couverture des grandes molécules dans les données d’apprentissage reste relativement insuffisante, entraînant une baisse des performances prédictives de DeepMS²Reasoner. Plus important encore, le MS² seul est généralement insuffisant pour confirmer définitivement une structure. Conformément aux standards de la métabolomique, en l’absence de preuves indépendantes telles qu’un temps de rétention, la RMN ou des produits de référence, les résultats proposés par AIMe relèvent principalement d’une annotation de niveau 3 ; leur rôle se rapproche alors de celui qui consiste à réduire l’espace des candidats, formuler des hypothèses structurales et justifier les voies de fragmentation, la confirmation finale nécessitant toujours une validation expérimentale.
Conclusion
La portée d’AIMe ne se limite pas à améliorer davantage la précision des prédictions de spectrométrie de masse ; elle vise aussi à modifier la façon dont sont analysées les petites molécules inconnues. Par le passé, face à un spectre de masse inconnu, les chercheurs devaient souvent chercher une correspondance directe dans des bibliothèques expérimentales de taille limitée ; AIMe utilise d’abord le modèle pour transformer l’espace des petites molécules connues en un espace de spectres de masse prédits et recherchables, puis réduit progressivement les candidats grâce aux structures fragmentaires et aux voies de fragmentation. S’il ne peut actuellement remplacer les validations expérimentales basées sur des produits de référence ou la RMN, il permet néanmoins de poursuivre l’analyse d’un grand nombre de signaux jusque-là difficiles à exploiter faute « de spectres de référence ».
Pour la métabolomique, cet apport pourrait être plus significatif que l’ajout simple d’une nouvelle série d’entrées dans les bibliothèques : les spectres de masses inconnus n’offrent plus seulement deux issues (« correspondance trouvée » ou « aucune correspondance »), mais peuvent désormais servir de point de départ pour formuler et tester des hypothèses structurales.