Command Palette
Search for a command to run...
95,4 % Genauigkeit Bei Zero-Shot-Erkennung: MIT Und Weitere Forschungseinrichtungen Stellen Das CLaC-Modell Vor, Das Eine Multimodale Ausrichtung Von Materialstrukturen Und Sprache Ermöglicht

Eine zentrale Aufgabe bei der Materialentdeckung ist die Filterung von Kandidatenmaterialien mit Ziel-eigenschaften aus dem enormen chemischen und strukturellen Raum. In den letzten Jahren haben Graph-Neuronale Netze (GNNs) durch das Lernen der dreidimensionalen Atomstruktur von Kristallen bemerkenswerte Fortschritte bei Aufgaben wie der Vorhersage von Materialeigenschaften und der Strukturgenerierung erzielt. Solche Modelle sind jedoch in der Regel auf vordefinierte Eigenschaftslabels oder numerische Bedingungen angewiesen und können natürliche Sprachbeschreibungen von Materialanforderungen nur schwer direkt verstehen; während große Sprachmodelle (LLMs) zwar im Umgang mit Texten stark sind, mangelt es ihnen an einer präzisen Repräsentation der räumlichen Struktur von Kristallen und deren physikalischen Eigenschaften.
Die Kombination aus Kristallstruktur und natürlicher Sprache bietet neue Ansätze für die Materialentdeckung. Allerdings sind die bestehenden Kristalldatenbanken begrenzt, und die akademische Literatur konzentriert sich auf wenige beliebte Materialien. Es fehlt eine ausreichende Entsprechung zwischen Textbeschreibungen und Materialeigenschaften, was die Trainingsleistung multimodaler Modelle einschränkt.
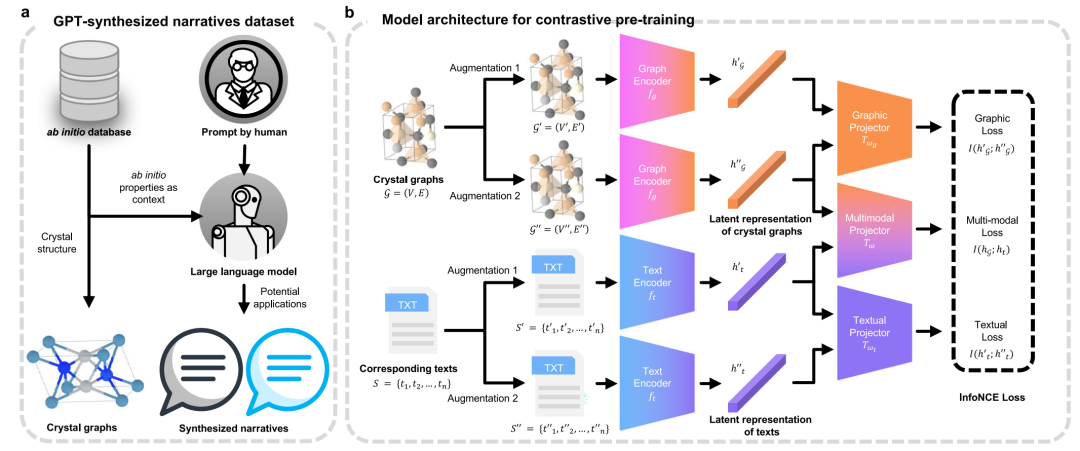
Um dieses Problem anzugehen, haben Forscher von Institutionen wie dem Massachusetts Institute of Technology (MIT), dem Korea Advanced Institute of Science and Technology (KAIST), der University of Illinois Urbana-Champaign und dem MIT-IBM Watson AI Lab das Contrastive Language-Crystals-Modell (CLaC) vorgeschlagen. Dieses Modell nutzt große Sprachmodelle, um synthetische Beschreibungen auf Basis von Materialeigenschaften zu generieren, und bildet Kristallstrukturen und natürliche Sprache durch kontrastives Lernen in einen gemeinsamen Repräsentationsraum ab. Experimente zeigen, dass CLaC im Vergleich zu Modellen, die direkt mit Texten aus der akademischen Literatur trainiert wurden, deutliche Vorteile bei Aufgaben zum Null-Shot-Materialverständnis und zur sprachgesteuerten Materialsuche aufweist.
Die Forschungsergebnisse wurden unter dem Titel „Scaling multimodal materials representation learning with synthetic narratives“ in Nature Communications veröffentlicht.
Link zur Publikation:
https://www.nature.com/articles/s41467-026-76378-7#Sec10
126.000 Kristall-Text-Paare erweitern die semantische Abdeckung von Materialien
Für das Training multimodaler Kristallmodelle muss zunächst eine Entsprechung zwischen Kristallstruktur und natürlicher Sprache hergestellt werden. Obwohl bestehende Materialdatenbanken eine große Anzahl von Kristallstrukturen und berechneten Eigenschaften enthalten, sind die zugehörigen Texte überwiegend in akademischen Artikeln verstreut und konzentrieren sich auf wenige gut untersuchte Materialien. Dies erschwert die Abdeckung vielfältiger Kristallstrukturen und gewährleistet nicht, dass die Texte vollständige Informationen zu den Materialeigenschaften enthalten.
Daher basierend auf der Materials Project-Datenbank sammelte die Studie etwa 126.000 Datensätze zu kristallinen Materialien und erstellte jeweils Kristallgraphstrukturen und natürliche Sprachbeschreibungen. Die Kristallstrukturen wurden mit dem Tool Jarvis-tools in Graphdaten umgewandelt, um die dreidimensionale Struktur durch Atome und deren Wechselwirkungen darzustellen. Für den Textteil wurde der von den Forschern zuvor entwickelte GPT-Synthese-Narrativ-Datensatz verwendet, bei dem große Sprachmodelle basierend auf den berechneten Eigenschaften aus der Materialdatenbank beschreibende Texte generieren.
Im Gegensatz zur einfachen Umwandlung von chemischen Formeln oder Elementzusammensetzungen in Text basieren die synthetischen Beschreibungen auf den berechneten Materialeigenschaften und umfassen Informationen zu Strukturmerkmalen, physikalischen Eigenschaften, funktionellem Verhalten und potenziellen Anwendungen. Beispielsweise werden basierend auf bekannten Daten wie Zusammensetzung, Bandlücke und Dichte eines Kristalls Beschreibungen generiert, die entsprechende physikalische Merkmale und Anwendungsinformationen enthalten, um eine reichhaltigere semantische Entsprechung zwischen Kristallstruktur und Material zu schaffen.
Um die Wirksamkeit der synthetischen Beschreibungen zu validieren, erstellten die Forscher auch einen Vergleichsdatensatz aus der akademischen Literatur. Unter Verwendung von chemischen Formeln als Suchkriterien extrahierten sie relevante Abschnitte aus dem Volltext von etwa 4 Millionen wissenschaftlichen Artikeln und erhielten schließlich etwa 400.000 Paare aus Material- und Natursprachensätzen, die jedoch nur etwa 400 anorganische Verbindungen abdeckten. Im Vergleich dazu deckt der GPT-Synthese-Narrativ-Datensatz etwa 300 Mal mehr verschiedene Kristallarten ab als die Daten aus der akademischen Literatur.
Die beiden Textdatensätze wurden verwendet, um CLaC-Synthetic (Version mit synthetischen Beschreibungen) und CLaC-Paper (Version mit akademischer Literatur) zu trainieren, um den Einfluss unterschiedlicher Datenquellen auf die Modellleistung zu vergleichen. Der Datensatz wurde im Verhältnis 8:1:1 in Trainings-, Validierungs- und Testdaten aufgeteilt.
Kombination aus Graph-Neuronalen Netzen und Sprachmodellen zur Ausrichtung von Kristallstruktur und natürlicher Sprache
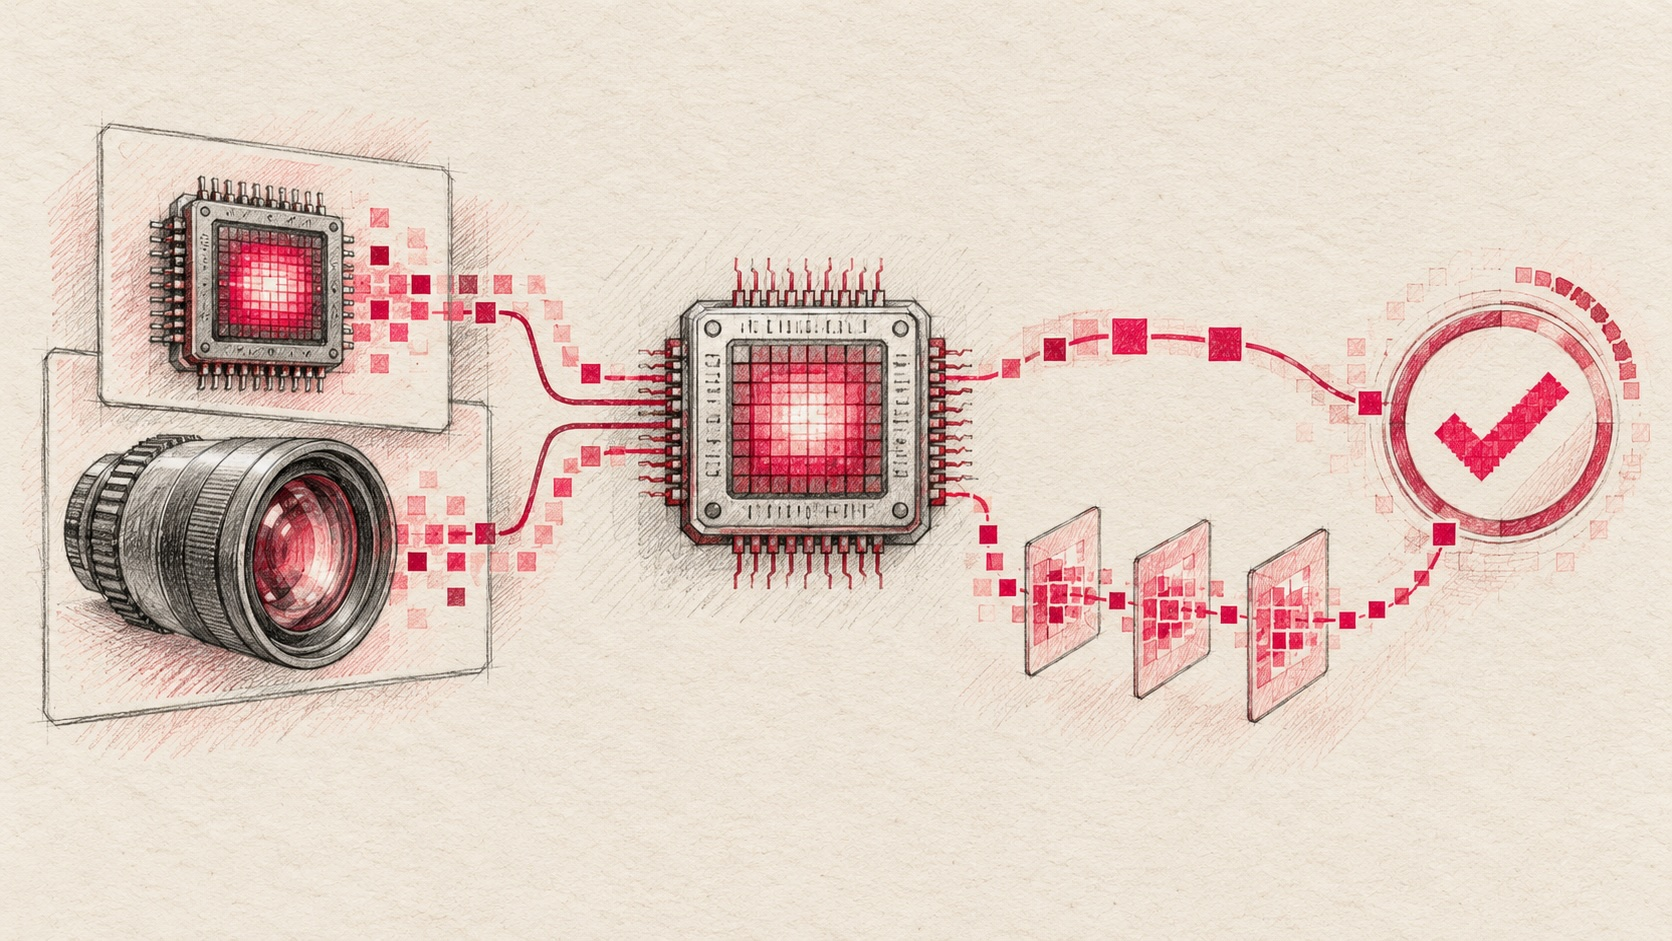
CLaC überträgt die Methode des kontrastiven Lernens aus CLIP im Bereich Vision-Language, indem Kristallstruktur und Textbeschreibung gemeinsam gelernt werden, um beide Informationsarten in einen gemeinsamen Repräsentationsraum abzubilden. Dies ermöglicht dem Modell, die semantische Ähnlichkeit zwischen Material und natürlicher Sprache zu berechnen.
CLaC verwendet eine Dual-Encoder-Architektur, die aus einem Kristallgraph-Encoder, einem Text-Encoder und einem multimodalen Projektionsmodul besteht. Der Kristallgraph-Encoder extrahiert Informationen wie Atomzusammensetzung, lokale Koordinationsumgebung und dreidimensionale Geometrie, während der Text-Encoder natürliche Sprachbeschreibungen zu Materialeigenschaften, Funktionsmerkmalen und Anwendungsanforderungen verarbeitet. Nach der Umwandlung in Vektoren werden beide Informationsarten über das Projektionsmodul in einen einheitlichen latenten Raum überführt, um die Entsprechung zwischen Kristallstruktur und Textsemantik herzustellen.
Für die Kodierung der Kristallstruktur verwendete die Studie das Graph-Neuronale Netz PaiNN (Polarizable Atom Interaction Neural Network), das räumliche Beziehungen zwischen Atomen durch einen äquivarianten Message-Passing-Mechanismus lernt. Dabei werden lokale Atomumgebungen erfasst und geometrische Informationen bewahrt. Als Vergleich wurden CGCNN und das vortrainierte interatomare Potentialmodell ORB herangezogen.
Als Text-Encoder wurden vortrainierte Sprachmodelle wie SciBERT, MatSciBERT, OPT-125M und Galactica-125M verglichen, die bidirektionale und autoregressive Architekturen abdecken. Basierend auf den nachfolgenden experimentellen Ergebnissen entschieden sich die Forscher schließlich für die Kombination von PaiNN und Galactica-125M als primäre Encoder.
Der Kern von CLaC ist das Cross-Modal Contrastive Learning. Während des Trainings werden Kristalldiagramme und Textbeschreibungen desselben Materials als positive Paare betrachtet, während Kombinationen aus Struktur und Text verschiedener Materialien negative Paare bilden. Das Modell nutzt die InfoNCE-Contrastive-Loss-Funktion, um die Vektorähnlichkeit korrekter Paare zu erhöhen und die Ähnlichkeit zwischen nicht übereinstimmenden Proben zu verringern, wodurch es schrittweise die Beziehungen zwischen Kristallstruktur, physikalischen Eigenschaften und natürlicher Sprache lernt.
Angesichts der begrenzten verfügbaren Paarungsdaten integrierte die Studie zusätzlich intra-modales Contrastive Learning, um dem Modell zu ermöglichen, unterschiedliche strukturelle Darstellungen desselben Kristalls sowie verschiedene Textbeschreibungen desselben Materials zu erkennen. Dabei wurden die Kristalldiagramme durch Störungen der Atompositionen und Gitterdehnungen von 0–5 % datenaugmentiert; die Texte wurden durch zufälliges Löschen und Umsortieren von Sätzen in verschiedenen Versionen erzeugt, wobei die Beibehaltungswahrscheinlichkeit für jeden Satz 50 % betrug. Diese Methoden erhöhen die Robustheit des Modells gegenüber geringfügigen strukturellen Änderungen und Unterschieden in der Textdarstellung. Die Forscher verzichteten auf den Ersatz durch Elemente derselben Gruppe, da dies die Koordinationsumgebung, die elektronische Struktur und die tatsächlichen Eigenschaften des Materials verändern könnte.
Während des Pre-Trainings wurde der Kristalldiagramm-Encoder von Grund auf trainiert, während der Text-Encoder mit vorab trainierten Gewichten initialisiert wurde. Das Modell verwendet einen 512-dimensionalen gemeinsamen Einbettungsraum, den AdamW-Optimizer mit einer Lernrate von 2×10⁻⁵, eine effektive Batch-Größe von 256 und wird für maximal 5 Epochen trainiert.
Nach Abschluss des Pre-Trainings kann CLaC natürliche Sprachabfragen in Vektoren umwandeln und diese mit vorab berechneten Kristallvektoren in einer Materialdatenbank vergleichen, um Kandidatenmaterialien mit Ziel-Eigenschaften zu identifizieren, ohne dass das Modell für jede Eigenschaft neu trainiert werden muss. CLaC generiert jedoch selbst keine Kristallstrukturen; seine Hauptaufgabe besteht darin, eine Verbindung zwischen Sprache und Kristallstruktur herzustellen, um die nachfolgende inverse Materialdesign-Unterstützung zu ermöglichen.
Von Zero-Shot-Materialverständnis bis zur Suche in natürlicher Sprache: Validierung der cross-modalen Lernleistung
Um die Leistung von CLaC zu bewerten, entwarfen die Forscher mehrere Zero-Shot-Experimente, die sich auf die Fähigkeiten des Modells zum Kristallverständnis, zur Suche in natürlicher Sprache und zur Darstellung physikalischer Eigenschaften konzentrierten, und verglichen es mit nicht trainierten Modellen sowie Baselines wie Gemma-3-1b-it und CLaC-Paper.
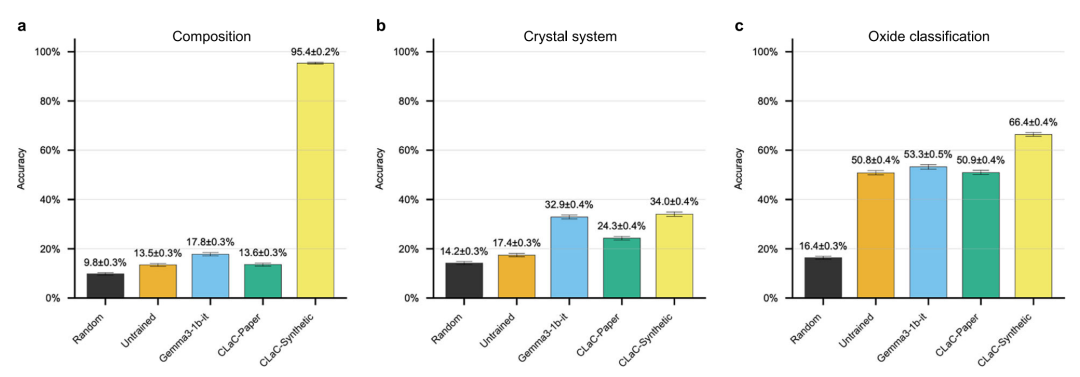
Erstens musste das Modell im Zero-Shot-Multimodal-Verständnis-Experiment basierend auf der Kristallstruktur die korrekte Beschreibung aus mehreren Kandidatentexten auswählen, wobei Aufgaben zur Elementzusammensetzung, zum Kristallsystem und zum Oxidtyp involviert waren. Die Ergebnisse zeigten, dass CLaC-Synthetic eine Genauigkeit von 95,4 % ± 0,2 % bei der Klassifikation der Elementzusammensetzung erreichte, was deutlich höher ist als die 17,8 % von Gemma-3-1b-it und die 13,6 % von CLaC-Paper; die Genauigkeit bei der Oxidklassifikation betrug 66,4 % ± 0,4 %, was ebenfalls andere Modelle übertraf.
Allerdings lag die Genauigkeit von CLaC-Synthetic bei der Klassifikation des Kristallsystems bei nur 34,0 % ± 0,4 %, was nahe an den 32,9 % von Gemma-3-1b-it liegt. Dies könnte mit der unausgewogenen Datenverteilung der Kristallsysteme und den kleinen Trainings-Batches zusammenhängen und zeigt, dass das Verständnis des Modells für feine geometrische Merkmale wie die Kristallsymmetrie weiterhin begrenzt ist.
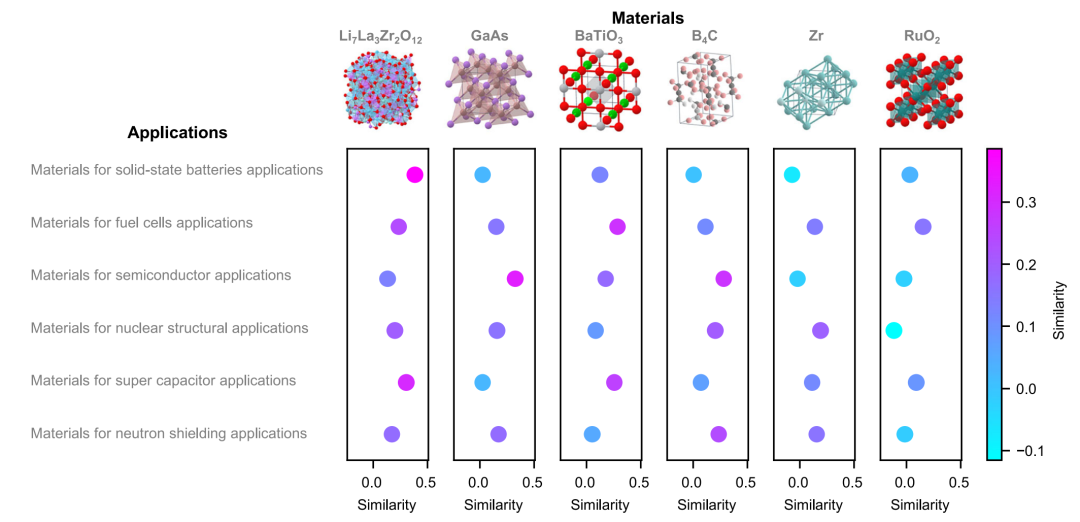
Die Forscher wählten zudem sechs typische Materialien wie Li₇La₃Zr₂O₁₂, GaAs und BaTiO₃ sowie sechs Anwendungsszenarien wie Festkörperbatterien, Halbleiter und Superkondensatoren aus, um die Ähnlichkeit zwischen Material- und Anwendungsbeschreibungen zu analysieren. Die Ergebnisse zeigten, dass das Modell typische Zusammenhänge wie zwischen Li₇La₃Zr₂O₁₂ und Festkörperbatterien, GaAs und Halbleitern sowie RuO₂ und Superkondensatoren erkennen konnte, was darauf hindeutet, dass die Darstellung bestimmte Kenntnisse über Materialfunktionen und Anwendungen enthält.
Im Zero-Shot-Inverse-Design-Experiment kehrten die Forscher die Richtung der traditionellen Eigenschaftsvorhersage um und suchten Kandidatenmaterialien basierend auf der natürlichen Sprachbeschreibung der Ziel-Leistung. Das Experiment umfasste fünf Eigenschaften: Bandlücke, Dichte, Convex-Hull-Energiedifferenz, Szintillations-Abklinglänge und gesamte Magnetisierung. Für jede Abfrage suchte das Modell die 30 ähnlichsten Materialien und bewertete die Differenz zwischen deren tatsächlichen Eigenschaften und den Zielwerten anhand des mittleren absoluten Fehlers (MAE).
Die Ergebnisse zeigten, dass CLaC-Synthetic bei der Suche nach allen fünf Eigenschaften besser als die Zufalls-Baseline abschnitt. Dabei betrug der mittlere absolute Fehler für die Bandlückensuche 0,641 eV, niedriger als die 1,185 eV bei der Zufallssuche; für die Dichtesuche betrugen sie 0,799 g/cm³ bzw. 2,148 g/cm³; für die Suche nach der Szintillations-Abklinglänge 1,033 cm bzw. 2,697 cm. Die Gesamtleistung von CLaC-Paper kam hingegen einer zufälligen Auswahl nahe, was darauf hindeutet, dass synthetische Erzählungen, die auf berechneten Eigenschaften basieren, besser geeignet sind, eine Entsprechung zwischen Sprache und Materialeigenschaften herzustellen, als direkt extrahierte akademische Literaturtexte.
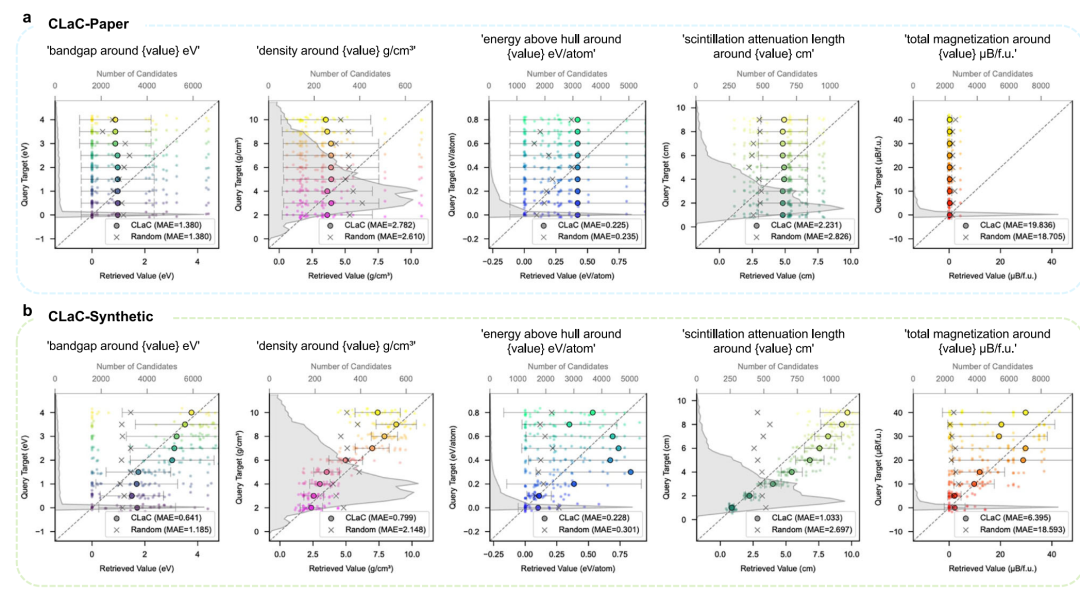
Neben genauen numerischen Werten testete die Studie auch qualitative Beschreibungen wie „große Bandlücke, geringe Dichte, starke Magnetisierung“. Das Ergebnis zeigte, dass die Verteilung der Materialeigenschaften, die von CLaC-Synthetic abgerufen werden, sich entsprechend der Semantik der Abfrage ändert. Beispielsweise nimmt die Bandlücke der Kandidatenmaterialien zu, wenn sich die Abfrage von einer geringen zu einer großen Bandlücke verschiebt; CLaC-Paper kann diese Unterscheidung nur schwer bilden, was darauf hindeutet, dass synthetische Erzählungen dem Modell helfen, den Zusammenhang zwischen qualitativen Beschreibungen und tatsächlichen physikalischen Eigenschaften zu verstehen.
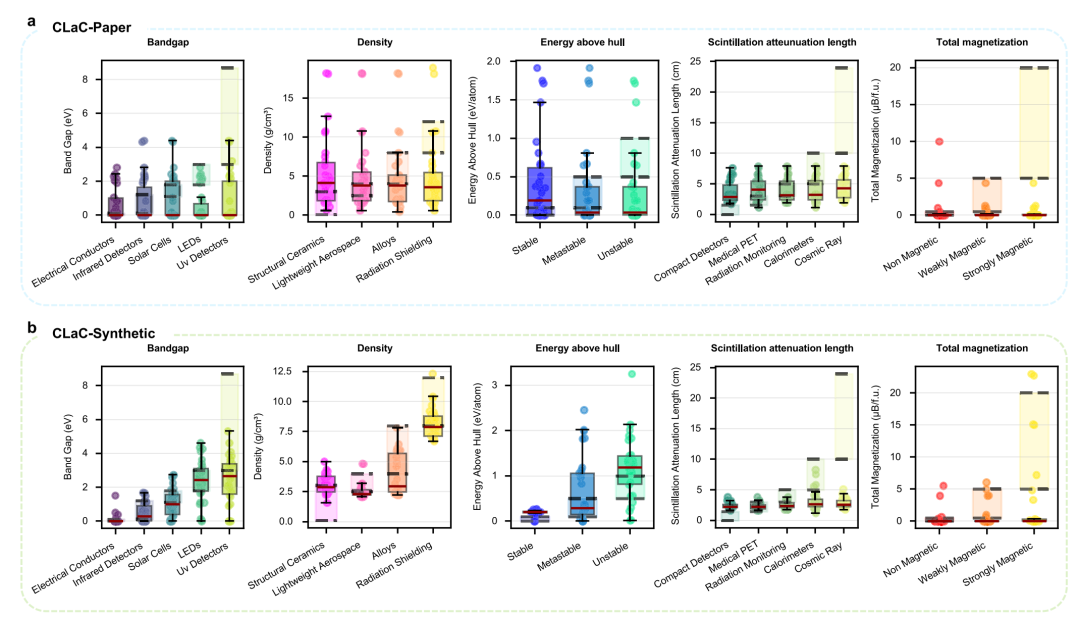
Bei der Anwendungsvalidierung nutzten die Forscher die Suche nach Festkörperelektrolyten für Batterien als Beispiel und führten eine Suche basierend auf lithiumhaltigen Materialien und der Bedingung einer großen Bandlücke durch. Alle 30 besten Kandidatenmaterialien enthielten Lithium, und die durchschnittliche Bandlücke betrug 3,23 eV. Dabei wurde Li₆PClO₅, das an vierter Stelle rangiert, in anderen Studien bereits als potenzielles Kandidatenmaterial identifiziert, und Li₄SiO₄, das an neunter Stelle rangiert, wurde zuvor als Festkörperelektrolyt-Film hergestellt. Da die Trainingsdaten jedoch keine Informationen zur Ionenleitfähigkeit enthalten, können die bestehenden Ergebnisse noch nicht belegen, dass diese Materialien alle Leistungsanforderungen für Festkörperelektrolyte erfüllen.
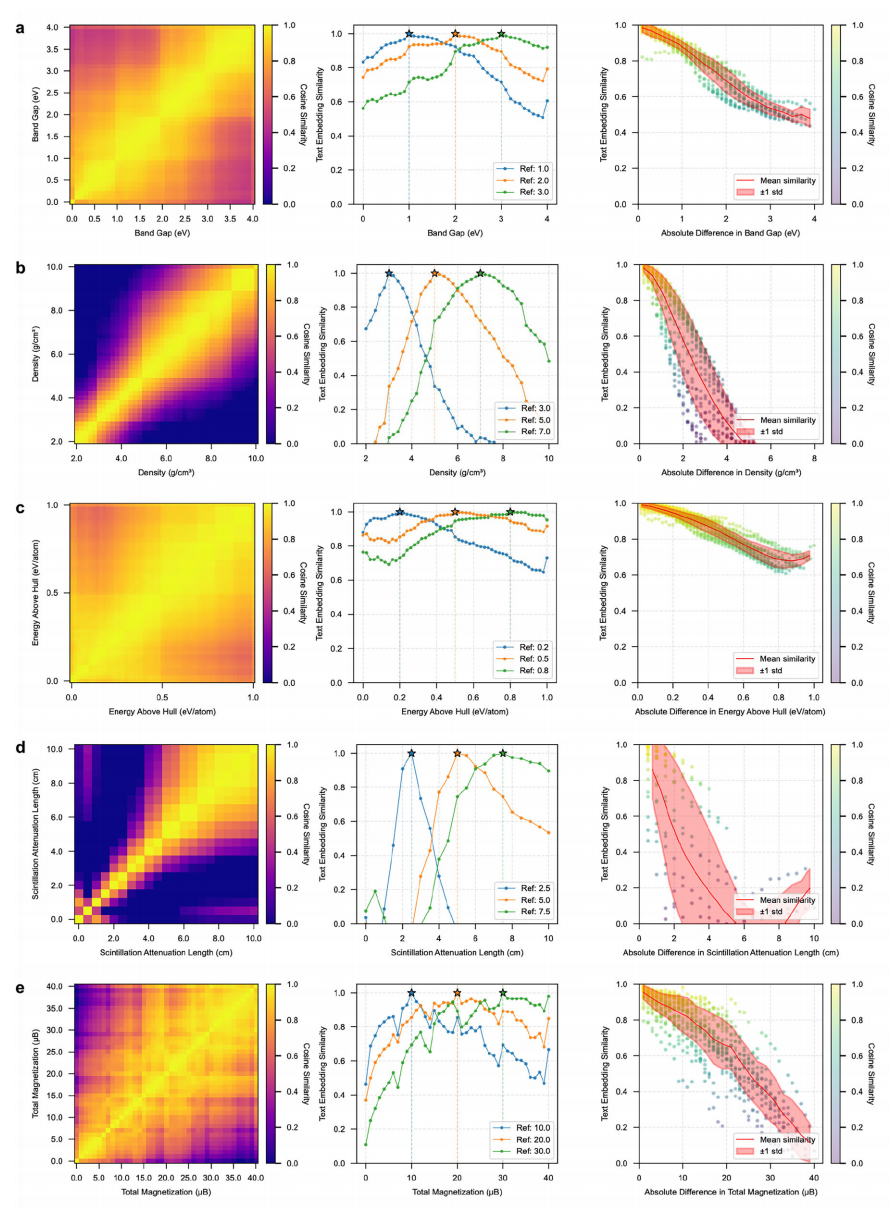
Um zu analysieren, wie das Modell numerische Informationen versteht, untersuchte die Studie weiter die Kontinuität der Eigenschaften im Text-Einbettungsraum. Die Ergebnisse zeigten, dass die Vektorähnlichkeit von CLaC-Synthetic allmählich abnimmt, wenn die numerischen Differenzen der Eigenschaften zunehmen. Beispielsweise sinkt bei einem Referenzwert der Bandlücke von 2,0 eV die Kosinus-Ähnlichkeit von 1,0 auf etwa 0,65, wenn der Abfragewert auf 4,0 eV erhöht wird, was darauf hindeutet, dass das Modell die Größenverhältnisse physikalischer Größen ausdrücken kann. Dabei nimmt die Ähnlichkeit bei Dichte und Szintillationsabklinglänge schneller ab, was mit einer höheren Suchgenauigkeit korrespondiert; die Änderung der konvexen Hüllen-Energiedifferenz ist relativ flach, und der Suchfehler ist ebenfalls größer. Im Gegensatz dazu zeigten weder CLaC-Paper noch das nicht über Modalitäten hinweg ausgerichtete Galactica-125M eine klare kontinuierliche numerische Beziehung.
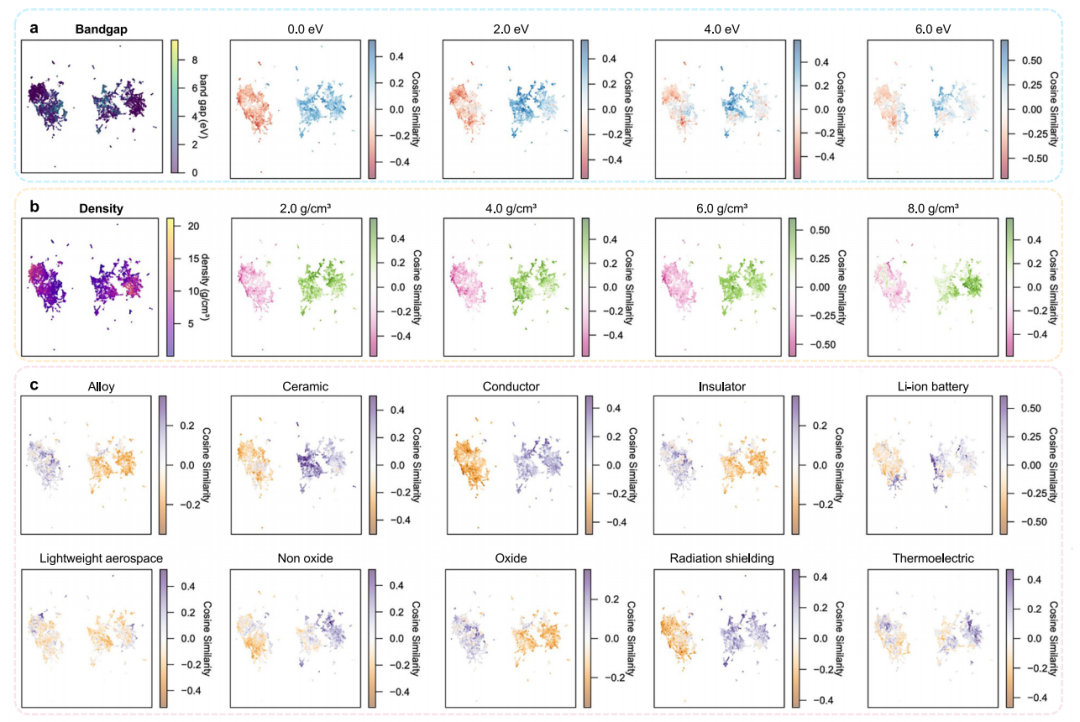
Abschließend visualisierten die Forscher den latenten Raum der Kristallstruktur und der Textdarstellung mittels UMAP. Obwohl die beiden Modalitäten relativ unabhängige Cluster bilden, sind ihre Nachbarschaftsbeziehungen der Materialien hochgradig konsistent: Von den 50 nächsten Nachbarn im Kristallgraphenraum erscheinen durchschnittlich 57 % auch unter den entsprechenden 50 nächsten Nachbarn im Text-Raum, was deutlich über dem Zufallsniveau von 0,4 % liegt. Darüber hinaus zeigen physikalische Eigenschaften wie Bandlücke und Dichte eine regelmäßige Verteilung, und Beschreibungen wie „Keramik“, „Leiter“ und „Lithium-Ionen-Batterie“ entsprechen unterschiedlichen Kristallbereichen, was die übermodalen Darstellungsfähigkeiten des Modells für Materialeigenschaften und Funktionskategorien weiter bestätigt.
Abschließende Bemerkungen
Die CLaC-Studie zeigt, dass der Schlüssel zum multimodalen Lernen von Kristallmaterialien nicht nur in der Datengröße liegt, sondern auch darin, ob eine genaue Entsprechung zwischen Materialeigenschaften und natürlicher Sprache hergestellt werden kann. Durch die Generierung synthetischer Erzählungen auf Basis berechneter Eigenschaften erzielte CLaC in der nullproben-basierten Materialverständnis und sprachgesteuerten Suche bessere Ergebnisse als Modelle, die mit Literaturtexten trainiert wurden. Allerdings weist das Modell bei fein strukturellen Aufgaben wie der Identifizierung von Kristallsystemen noch Defizite auf und kann derzeit komplexe Systeme wie polykristalline Strukturen, Defektstrukturen und metallorganische Gerüste (MOFs) nur schwer verarbeiten; zudem ist es nicht in der Lage, neue Kristallstrukturen direkt zu generieren. In Zukunft bleibt es eine Herausforderung, die Genauigkeit synthetischer Daten zu verbessern, die Anwendbarkeit des Modells auf komplexe Materialien zu erweitern und die sprachgesteuerte Suche mit Kristallgenerierung und physikalischer Validierung zu kombinieren, um solche Modelle für praktische Materialdesign-Aufgaben nutzbar zu machen.