Command Palette
Search for a command to run...
SLMREC:将大语言模型蒸馏为小模型用于序列推荐
SLMREC:将大语言模型蒸馏为小模型用于序列推荐
Wujiang Xu Qitian Wu Zujie Liang Jiaojiao Han Xuying Ning Yunxiao Shi Wenfang Lin Yongfeng Zhang
摘要
序列推荐(SR)任务涉及根据用户过去的行为预测其可能交互的下一项。SR 模型通过分析用户行为的序列来识别更复杂的行为模式和时间动态。近期研究表明,LLM 对序列推荐系统产生了重大影响,无论是将序列推荐视为语言建模,还是作为用户表示的主干网络。尽管这些方法表现出色,但鲜有证据表明大语言模型的必要性及其规模需求,尤其是在序列推荐场景中。同时,由于 LLM 的庞大体积,在需处理每日数十亿流量日志的现实平台中,基于 LLM 的模型效率低下且不切实际。本文通过在大规模工业数据集上进行广泛实验,探讨了 LLM 深度的影响。令人惊讶的是,我们的动机实验表明,LLM 的大多数中间层是冗余的,这表明剪除剩余层次仍可保持强劲性能。受此启发,我们为 SR 设计了小语言模型 SLMREC,其采用了一种简单有效的知识蒸馏方法。此外,SLMREC 与其他后训练效率技术(如量化和剪枝)正交,可结合使用。综合实验结果表明,所提出的 SLMREC 模型仅使用 LLM 基推荐模型参数量的 13% 即达到最佳性能,同时训练和推理时间成本分别实现了最高 6.6 倍和 8.0 倍的加速。此外,我们从理论上论证了为何小语言模型在 SR 中能与大语言模型表现相当。源代码和数据集可在指定 URL 获取。
一句话总结
罗格斯大学、蚂蚁集团及其合作者提出了SLMREC,一种通过剪枝冗余的LLM中间层来增强小语言模型进行序列推荐的知识蒸馏方法,仅使用LLM模型参数量的13%即取得了最先进的性能,同时实现了高达6.6×的训练加速和8.0×的推理加速,并且该研究为小语言模型在此场景下能够取得与大语言模型相当的表现提供了理论依据。
核心贡献
- 本文通过大规模工业实验实证分析了LLM在序列推荐中的深度,结果表明大多数中间层是冗余的,仅保留剩余层的模型仍然能够表现出强大的性能。
- 本文提出了SLMREC,一种将深层LLM的特征提取行为压缩到紧凑的小语言模型中的知识蒸馏框架,该方法与其他训练后效率优化技术(如量化和剪枝)兼容。
- 结果表明,SLMREC仅使用LLM序列推荐模型参数量的13%即达到了最佳性能,训练加速最高达6.6倍,推理加速最高达8.0倍,同时本文还为小语言模型在该任务中能够匹配大语言模型的表现提供了理论解释。
引言
序列推荐系统旨在从历史交互数据中建模用户不断变化的兴趣。从LSTM和GRU到基于Transformer的编码器等传统方法已经遇到了性能瓶颈,模型规模通常低于1亿参数。基于大语言模型(LLM)的推荐器,无论是生成式还是嵌入式的,近年来都取得了显著的性能提升,相比传统方法将基准提升了近20%。然而,这些提升伴随着高昂的代价:LLMRec模型通常超过70亿参数,大约是传统模型的70倍,这带来了严重的硬件需求,并使现实世界中的部署效率低下,尤其是在处理数十亿的日常流量日志和新物品时。
先前工作的一个关键局限在于,推荐领域的扩展规律仅在低于10亿参数的模型上进行了测试,远小于GPT-3(1750亿参数)等前沿LLM。此外,这些研究关注的是测试损失而非基于排序的指标,限制了实际相关性。作者还指出,ID型物品信息在LLM预训练期间并未被显式学习,这引发了关于更大的模型规模是否真正有利于序列推荐的疑问。
在本工作中,作者初步尝试重新评估LLM用于序列推荐的必要性。通过在大规模工业数据集上的实验,他们发现增加模型参数所带来的性能提升并不一致,并且LLM中许多中间层在该任务中是冗余的,这与NLP领域的发现相似。基于这些洞察,他们提出了SLMREC,一个利用标准知识蒸馏来增强小语言模型(低于10亿参数)的框架,通过对齐表示知识和多个监督信号来引导学生模型获得任务感知的隐藏表示。SLMREC不需要额外的模型设计元素,并且可以与现有的量化和剪枝技术配合使用。大量实验表明,SLMREC在实现最高6.6倍训练加速和8.0倍推理加速的同时,取得了与70亿以上参数基线相当的性能。作者还提供了较小的模型在该场景下能够匹配较大模型的理论依据,并展示了使用在线知识蒸馏的结果。
数据集
-
数据集构成与来源:
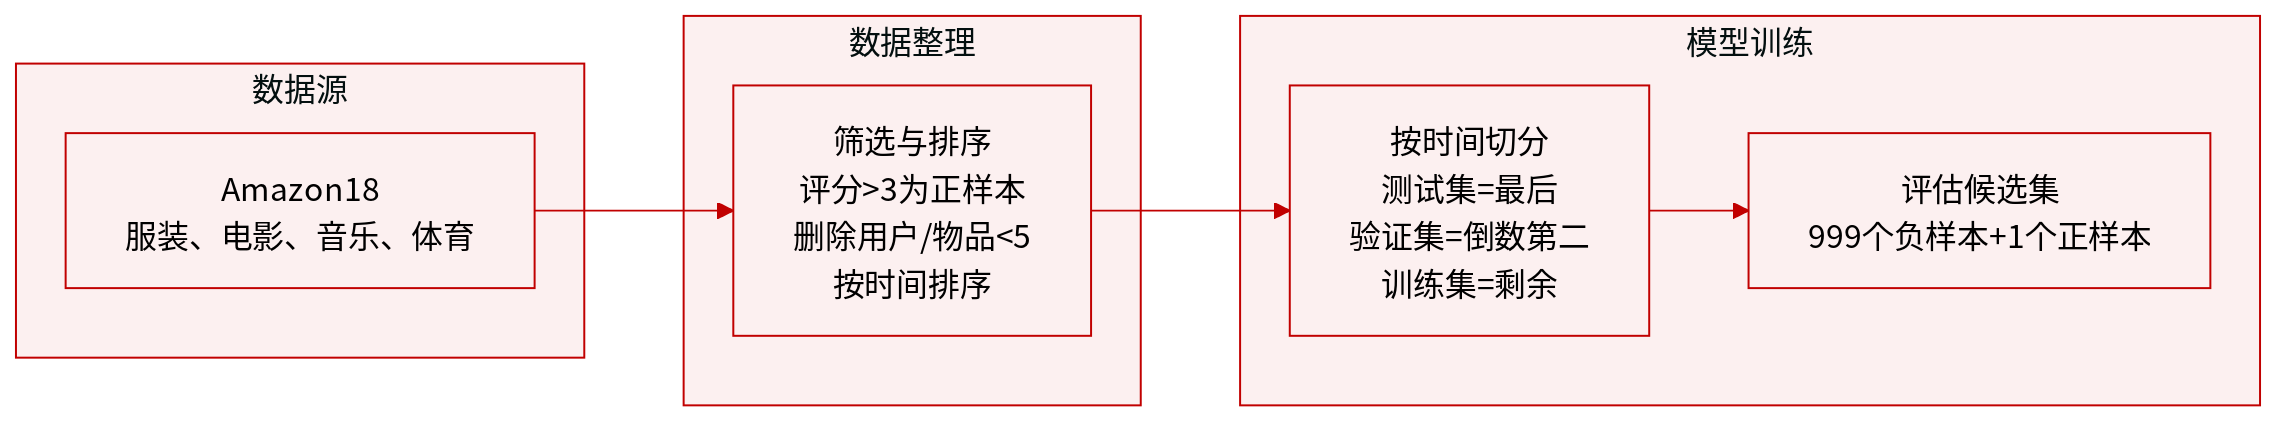
- 作者使用了Amazon18数据集,这是一个工业规模的数据集。
- 他们专门使用了四个类别的数据:服装、电影、音乐和体育。
-
每个子集的关键细节:
- 交互数据来源于用户评分和评论。
- 任何高于3的评分都被视为正向反馈,表示用户与物品存在交互。
- 使用时间戳来确定行为的先后顺序。
- 删除关联行为少于5个的用户和物品,以确保数据密度。
-
论文如何使用数据:
- 每个用户的历史交互序列被分为训练、验证和测试三个部分。
- 最近的一次交互保留用于测试,第二近的用于验证,之前的所有交互用于训练。
- 在评估时,作者随机选择999个负样本物品,与1个正样本物品组合形成排序候选集。
- 使用的指标包括命中率(HR@{1, 5, 10})、归一化折损累积增益(NDCG@{5,10})和平均倒数排名(MRR)。
-
其他处理细节:
- 没有提及具体的裁剪策略。
- 数据处理通过基于交互频率进行过滤,并使用时间戳创建用户行为的时序序列。
方法
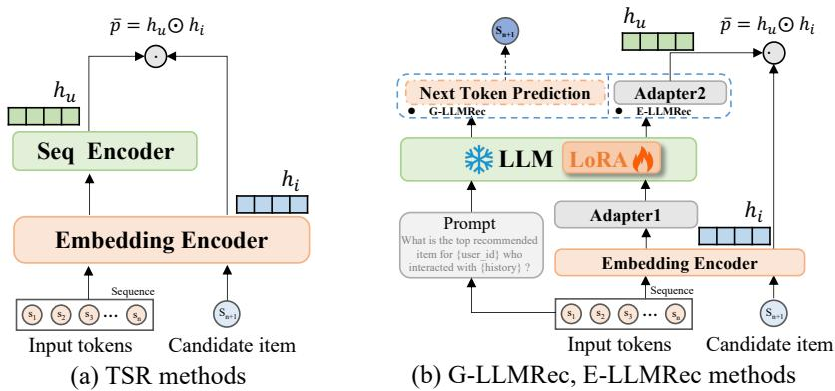
所提出的SLMREC框架旨在将大语言模型(LLM)教师的知识蒸馏到更浅的LLM学生模型中。两种模型都遵循通用的E-LLMRec架构:预训练的ID嵌入层(来自BERT4Rec、SASRec或GRU4Rec等模型)将固定长度的动作序列S∈RT映射为低维序列表示S∈RT×d0。随后通过线性投影将其上采样到LLM隐藏维度d1。LLM解码器处理ID序列与提示文本的组合嵌入,最终的时间步隐藏状态hM被用作用户表示。线性层将其维度降低回d0,通过与物品表示的点积获得预测的交互概率,并使用交叉熵损失进行训练。与典型的基于logits的知识蒸馏不同,SLMREC专注于在多层之间对齐教师和学生之间的隐藏表示。
教师模型由M个堆叠的解码器层组成,而学生模型有N层,两者共享相同的隐藏维度d。为了实现逐层特征对齐,作者将两个模型的层划分为块:每m个教师层和每n个学生层分别分组,产生B=⌊M/m⌋=⌊N/n⌋个块。对于每个块k∈{1,…,B},从第km个教师层和第kn个学生层提取最终的时间步隐藏表示,分别记为ht(km)和hs(kn),所有向量均在Rd中。
为了迁移特征编码能力,引入了三个互补的正则化项。首先,余弦相似度损失对齐隐藏向量的方向:
Dcos(Θt,Θs)=B1k=1∑B∥ht(km)∥2∥hs(kn)∥2ht(km)⋅hs(kn).其次,特征范数正则化最小化对应表示之间的L2距离:
Dnorm(Θt,Θs)=B1k=1∑B∥ht(km)−hs(kn)∥22.这两个损失引导学生模型同时模仿教师内部特征的方向和幅度。
此外,作者采用了多重监督策略,鼓励学生模型在中间层吸收推荐特定知识。对于除最终表示之外的每个表示,他们附加一个轻量级适配器Wa,将隐藏向量映射到物品嵌入维度,然后针对真实交互标签计算交叉熵损失:
Lms(Θs,Wa)=B−11k=1∑B−1Lce(y,p^t(km)),其中p^t(km)是通过对第km个教师层表示应用适配器获得的预测。这种辅助监督在多个深度提供了直接的学习信号,而不仅仅是在最终层。
学生模型的总体训练目标将最终预测上的主要交叉熵损失与三个蒸馏项整合在一起:
Θs,Wamin[Lce(Θs)+λ1(1−Dcos)+λ2Dnorm+λ3Lms],其中λ1,λ2,λ3是平衡各项贡献的超参数。这种复合损失在离线蒸馏设置中进行优化:教师模型经过预训练并保持固定,而学生模型和适配器通过最小化该目标进行训练。
该设计有理论依据作为支撑。作者将每个Transformer层分析为对去噪目标的一次梯度下降步骤,并证明了任何K层注意力模型都可以等价地表示为从初始嵌入执行一次梯度步骤的单层模型。这意味着更浅的模型在适当引导下可以获得与更深模型相同的特征提取能力。特征蒸馏损失提供了这种引导,使学生模型能够将多层推理过程压缩到更少的层中而不牺牲表示质量。
实验
实验首先验证了SLMREC的设计动机,表明基于LLM的推荐器随着层数增加而性能提升,但即使是浅层的8层模型也能接近24层模型的性能,这表明存在冗余容量并启发了知识蒸馏。SLMREC是一个通过从更大的教师模型进行隐藏层蒸馏训练的小模型,其性能超过了教师模型,可与完整的32层模型相媲美,同时将训练和推理时间分别缩短至教师模型参数量的约13%至14%,运行速度分别提升6.6倍和8.0倍。消融实验确认了三个知识正则化项的贡献,该方法也适用于在线蒸馏(教师和学生同时训练)的场景。在测试的配置中,所提出的块数量4取得了最佳性能。
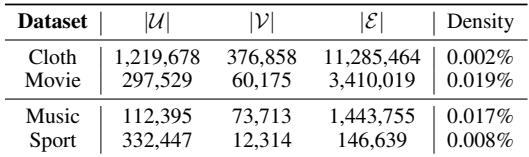
Amazon数据集在规模上差异很大,其中服装类别在用户、物品和评分数量上都是最大的,而体育类别在物品数量和整体交互量上是最小的。所有类别的数据密度都非常低,从0.002%到0.019%不等,表明用户与物品之间的交互非常稀疏。数据集的预处理包括过滤行为少于5个的用户和物品,并将每个用户的历史划分为训练、验证和测试段。服装拥有最多的用户、物品和评分,而体育拥有的物品和评分最少。所有数据集都极为稀疏,密度低于0.02%。音乐和电影类别的密度相似,都高于服装和体育。
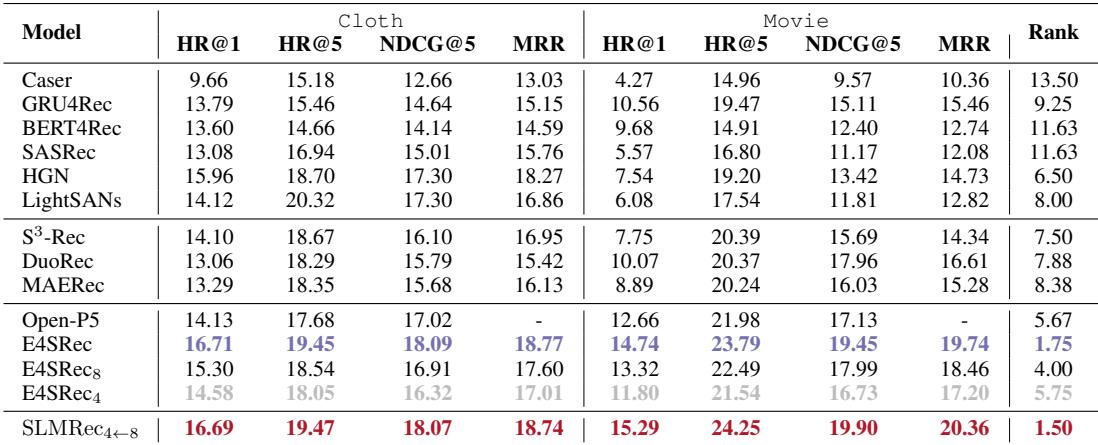
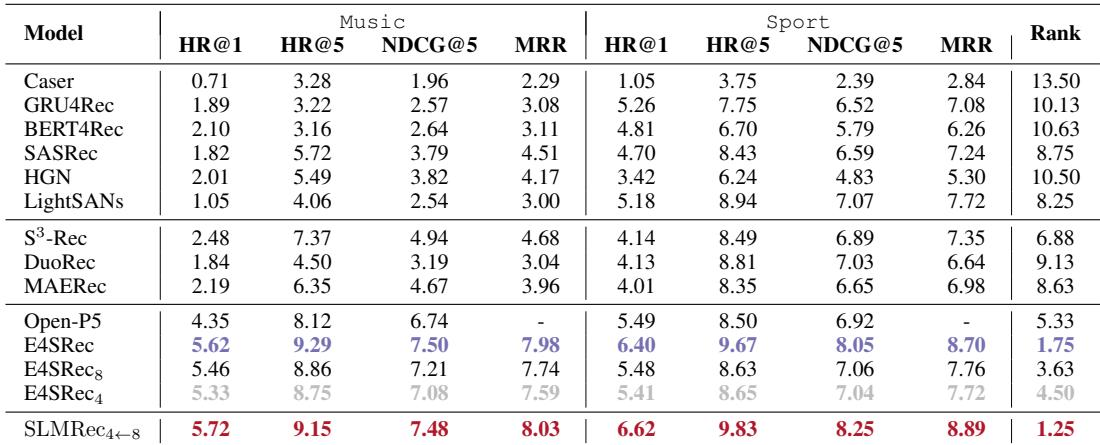
该表比较了多个模型在Cloth和Movie数据集上的推荐准确率。分析表明,基于LLM的方法优于传统基线,而所提出的SLMREC尽管层数较少,但通过知识蒸馏取得了比其更大的教师模型更好的性能。SLMREC通过隐藏层知识蒸馏比教师模型E4SRec提升了约8%。经过有效训练的较小学生模型在序列推荐中可以媲美或超越较大的语言模型。基于LLM的方法相比传统序列推荐方法表现出显著的性能提升。
在Music和Sport数据集上,不同传统序列推荐模型的性能存在明显差异,但整体指标偏低,表明推荐任务具有挑战性。各模型在HR@5和NDCG@5上的表现远优于HR@1,说明排序能力有所提升。在Music上,BERT4Rec取得最高的HR@1,而Caser表现最差。在Sport上,GRU4Rec和LightSANs的HR@1相对较高,Caser仍然最低。所有模型在HR@5和NDCG@5上的数值显著高于HR@1,体现出更好的排序效果。
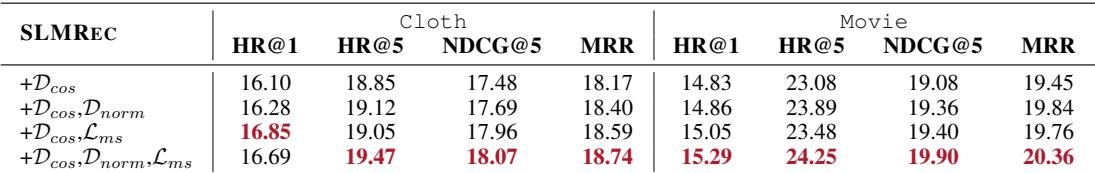
消融研究表明,在SLMREC中添加知识正则化项在Cloth和Movie两个领域均持续提升性能。余弦、范数和掩码语言建模正则化项的完整组合取得了最佳的整体指标,尤其是在排序质量方面。每个正则化项都通过对齐中间表示和融入领域知识来发挥作用。将所有三个正则化项组合在一起,在Cloth和Movie领域均取得了最高的NDCG@5和MRR。在余弦正则化基础上添加范数对齐提升了HR@5和NDCG@5,而掩码语言建模正则化项在Cloth领域提升了HR@1。
效率对比表明,SLMREC比其他基于LLM的方法显著更高效,训练和推理时间大幅缩短,参数量也远少。Open-P5的训练时间合理,但由于其生成式方法导致推理时间极长,而E4SRec在时间上处于中间水平,但仍比SLMREC重得多。总体而言,SLMREC在保持竞争力性能的同时,相比E4SRec实现了主要的效率提升。SLMREC的训练速度约为E4SRec的6.6倍,推理速度约为8倍。SLMREC仅使用E4SRec约13%的训练参数和14%的推理参数。Open-P5的推理时间极高,需要数千小时,因为它在排序过程中生成了大量候选集。
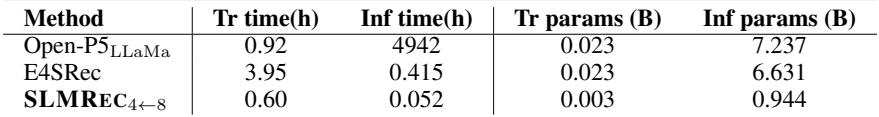
在稀疏的Amazon数据集上的评估表明,基于LLM的方法持续优于传统序列推荐基线,而所提出的SLMREC作为一个轻量级学生模型,通过知识蒸馏超越了其更大的教师模型E4SRec。消融研究证实,将余弦、范数和掩码语言建模正则化项相结合可以在各领域取得最佳的排序质量。此外,SLMREC比其他基于LLM的方法显著更高效,需要的参数更少,训练和推理时间大幅缩短,同时保持具有竞争力的准确率。总体而言,这些发现强调了具有有效蒸馏和正则化的紧凑学生模型可以在稀疏的真实推荐场景中取得最先进的性能。