Command Palette
Search for a command to run...
字节潜在 Transformer:补丁比词元更优的扩展方式
字节潜在 Transformer:补丁比词元更优的扩展方式
摘要
我们引入了字节潜在 Transformer(BLT),这是一种新的字节级 LLM 架构,首次在大规模下与基于词元化的 LLM 性能相匹配,同时在推理效率和鲁棒性方面有显著提升。BLT 将字节编码为动态大小的补丁,这些补丁作为主要的计算单元。补丁根据下一个字节的熵进行分割,在数据复杂度增加时分配更多的计算和模型容量。我们首次展示了字节级模型的 FLOP 控制扩展研究——最高达 8B 参数和 4T 训练字节——证明了在没有固定词汇表的情况下训练原始字节模型的可行性。由于在数据可预测时动态选择长补丁,训练和推理效率均得到提升,同时在推理和长尾泛化方面也有定性的改进。对于固定的推理成本,BLT 显示出比基于词元化的模型显著更好的扩展性,通过同时增大补丁和模型大小来实现。
一句话总结
Meta FAIR、华盛顿大学和芝加哥大学的研究人员引入了字节潜在变换器(Byte Latent Transformer, BLT),这是一种字节级LLM架构,将字节编码为通过下一字节熵分割的动态大小补丁,并证明其在高达8B参数和4T训练字节的规模下匹配基于tokenization的LLM性能,同时显著提升推理效率和鲁棒性。
核心贡献
- 本文引入了字节潜在变换器(BLT),一种字节级LLM架构,用通过下一字节熵分割的动态大小补丁取代固定词表tokenization,根据数据复杂度分配计算和模型容量。
- 本文呈现了首个FLOP受控的字节级模型扩展研究,规模达8B参数和4T训练字节,并表明BLT在此规模下匹配基于tokenization的LLM性能。
- 结果表明,BLT以微小评估权衡将推理FLOPs减少至多50%,提升了对噪声输入和子词处理的鲁棒性,并实现了在固定推理预算内模型和补丁大小的联合扩展。
引言
现有大型语言模型依赖tokenization,这是一种将字节分组为固定token的启发式预处理步骤。此方法引入偏差,导致对输入噪声敏感、正字法知识薄弱以及跨语言性能不均。直接对原始字节进行训练因序列长度过长而不可行,先前使用高效注意力或无注意力架构的工作未能解决前馈层在每个字节上运行所产生的主要计算成本。
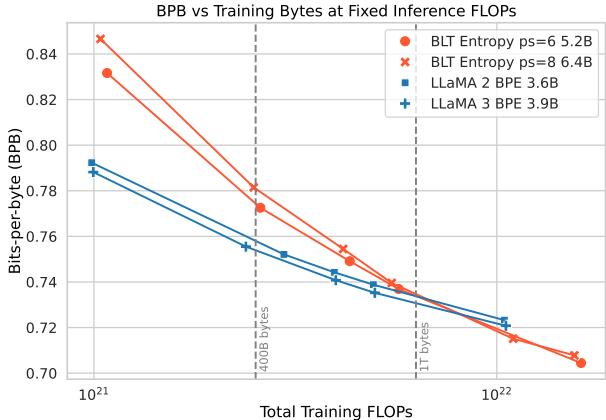
作者引入了字节潜在变换器(BLT),一种无需分词器的架构,可直接从原始字节学习。BLT使用可学习方法将字节动态分组为补丁,轻量级编码器和解码器模块将任意字节组映射为潜在表示。在一项高达8B参数和4T训练字节的FLOP受控扩展研究中,BLT匹配了Llama 3等基于tokenization的模型性能,同时推理FLOPs减少至多50%。它还在噪声输入鲁棒性和字符级理解方面展现出改进,并解锁了一个新的扩展维度,即在固定推理预算内可以同时增大模型和补丁大小。
数据集
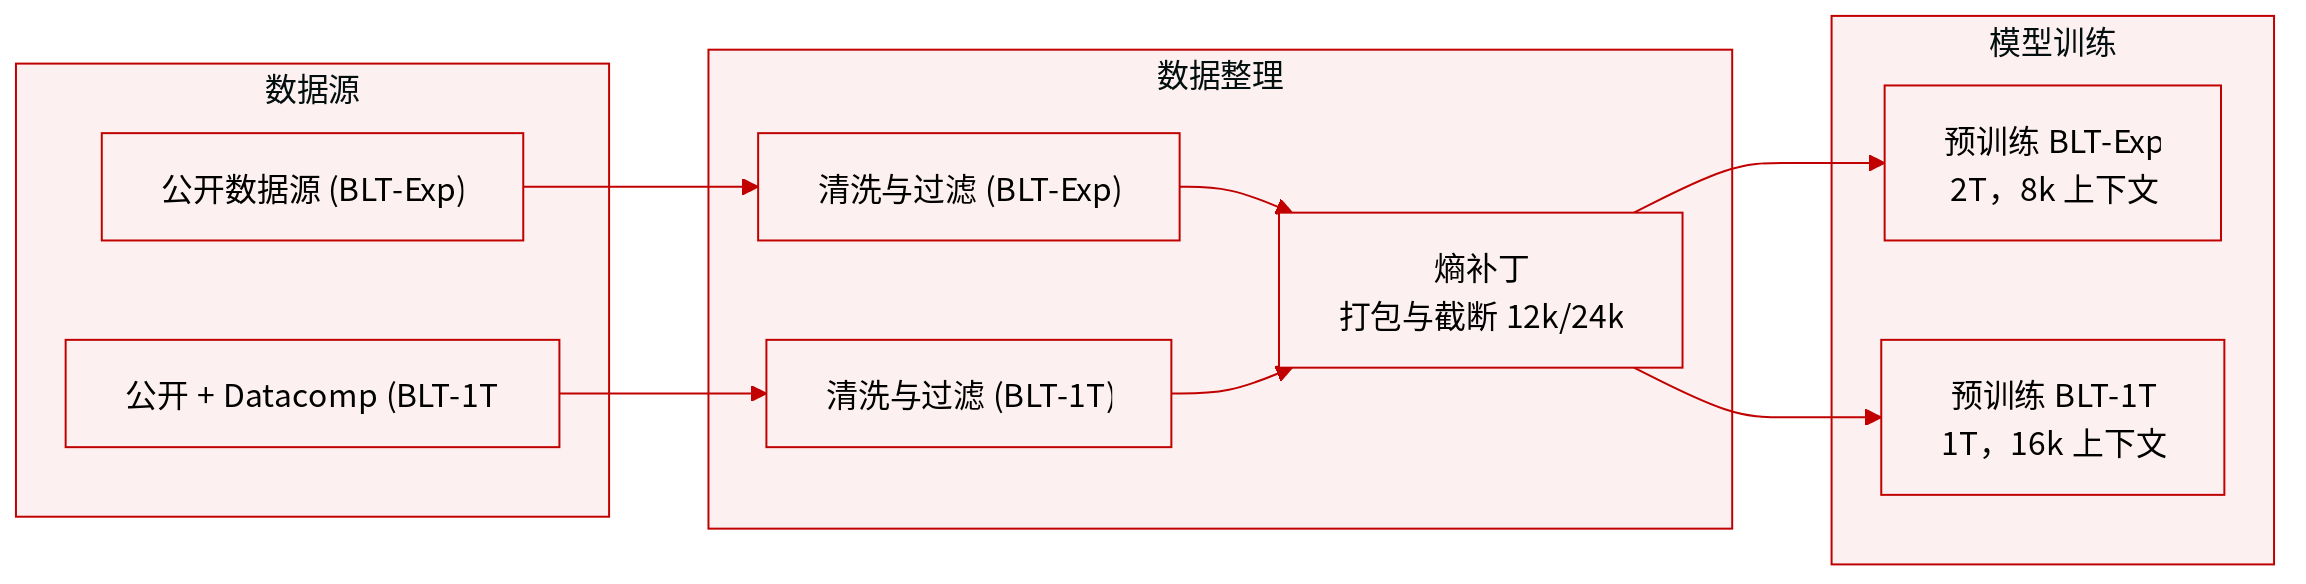
作者使用受控实验设置将BLT与基于tokenization的模型进行比较,确保BLT不获得任何优势,尤其是在序列上下文长度方面。数据集构建和使用方式如下所述。
预训练数据集
- BLT-Exp:包含2万亿token的数据集,来源为多种经清洗和过滤的公开来源。用于消融研究和扩展趋势实验,以确定BLT的最优架构选择。
- BLT-1T:从公开来源收集的高质量1万亿token数据集,还包含Datacomp-LM发布的预训练数据子集。此数据集用于完整预训练运行,以在下游任务上将BLT与Llama 3架构进行比较。
熵模型与阈值
- 对于使用熵补丁的模型,作者估计补丁阈值以在预训练数据混合上实现期望的平均补丁大小。未指定时默认使用全局熵阈值。
- 熵模型是一个具有100M参数、14层和512隐藏维度的变换器。它使用512字节的滑动窗口注意力,并在与BLT相同的数据分布上训练。
- 如果熵模型的感受野足够小,它可以被编码为高效的查找表。
补丁上的高效训练
- 动态补丁方法在加载批次时会导致不同的字节到补丁比率。该实现将补丁批次打包而非字节批次,以保持每批补丁数量恒定,并避免潜在变换器中的填充步骤。
- 字节序列被填充或截断至BLT-Exp的12k和BLT-1T的24k,以防止异常大补丁引起的内存峰值。
均衡上下文长度
- 为确保没有模型因更大上下文而获得优势,每个批次中的字节数在平均上保持恒定。潜在变换器的序列长度被调整为分别实现BLT-Exp和BLT-1T的8k和16k字节上下文。
方法
作者引入了一种方法,将字节序列分割为可变大小补丁,以根据上下文动态分配计算资源。此方法与固定大小tokenization形成对比,根据信息密度对字节进行分组。分割由补丁函数控制,该函数识别模型不确定性最高的边界。具体而言,该方法采用基于熵的策略,计算下一字节熵以确定序列的分割位置。熵计算如下:
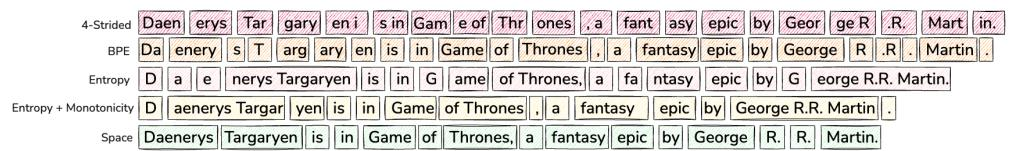
H(xi)=−v∈V∑pe(xi=v∣x<i)logpe(xi=v∣x<i)边界通过全局熵阈值或检测熵近似单调性被破坏的点来识别。如下图所示,各种分割启发式方法(包括跨步、基于空格和基于熵的方法)产生不同的补丁结构,影响计算成本。
整体系统架构包含三个主要模块:轻量级局部编码器、大型潜在全局变换器和轻量级局部解码器。有关这些组件之间的数据流,请参考框架图。局部编码器将原始输入字节序列映射为表达性补丁表示。这些补丁表示随后由潜在全局变换器处理,该变换器执行自回归预测并消耗大部分浮点运算。最后,局部解码器将全局补丁表示映射回原始字节序列。此设计允许模型对输入序列的不同部分改变计算量。
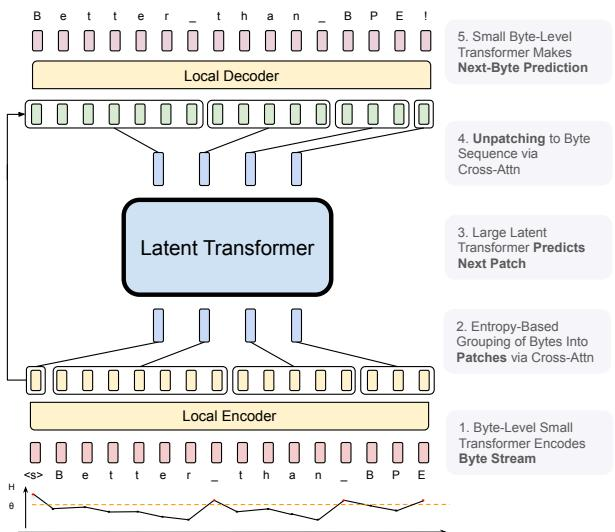
局部编码器旨在将字节级信息高效聚合为补丁级表示。输入字节被嵌入,并通过哈希n-gram嵌入增强以捕获来自前序字节的上下文。核心聚合机制利用一系列交替的变换器层和交叉注意力模块。在编码器交叉注意力中,查询向量对应补丁表示,而键和值来自字节隐藏状态。这允许模型汇聚与每个补丁边界特别相关的字节信息。查询通过汇聚每个补丁对应的字节表示并通过线性投影来初始化。交叉注意力层的更新规则定义如下:
Pl=Pl−1+Wo(softmax(dkQKT)V)其中Q表示补丁查询,K,V表示字节键和值。掩码策略确保每个补丁查询仅关注属于该特定补丁的字节的键和值。
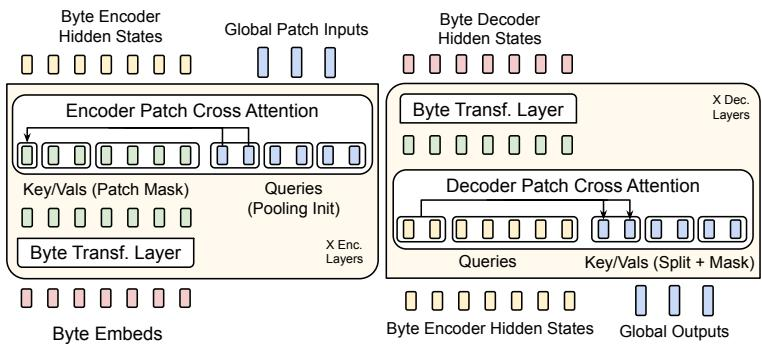
局部解码器镜像编码器的架构,但反转信息流以从补丁重建字节。它接受全局补丁表示作为输入,并预测底层字节序列。解码器利用交叉注意力机制,其中查询与键值的作用互换。字节表示作为查询,补丁表示作为键和值。这允许解码器将全局表示解码回细粒度字节预测。解码器在生成最终输出前应用交替的交叉注意力和变换器层来细化字节表示,有效将潜在补丁空间映射回字节词表。
实验
实验在受控、FLOP匹配且上下文长度均衡的条件下,将BLT与基于BPE分词器的模型进行比较,以避免给BLT任何优势。BLT在计算最优扩展趋势中匹配或超过BPE基线,在超出计算最优和更大补丁大小下获得更好的下游任务性能,并在鲁棒性基准上展现出显著优势,包括噪声数据、字符理解和低资源机器翻译。消融实验确定解码器交叉注意力和n-gram哈希嵌入是性能的关键贡献者,哈希收益在30万哈希后递减。
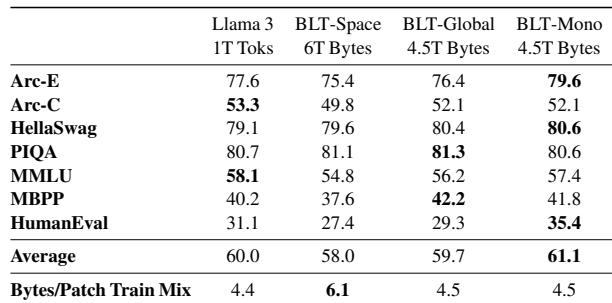
FLOP匹配的8B模型表明,采用单调熵补丁的BLT在大多数任务上优于基于Llama 3分词器的模型,而空格补丁则以准确性换取显著的推理FLOP节省。全局熵补丁整体匹配基线,但在MMLU等结构化任务上落后。单调熵补丁在7项任务中的4项上超过Llama 3基线,包括ARC-E和HumanEval上的大幅提升。空格补丁在大多数任务上表现不佳,但通过6字节对4.5字节的更大平均补丁大小减少了推理FLOPs。全局熵补丁在MMLU上稍逊基线,但在HellaSwag和MBPP等其他任务上匹配或超过基线。
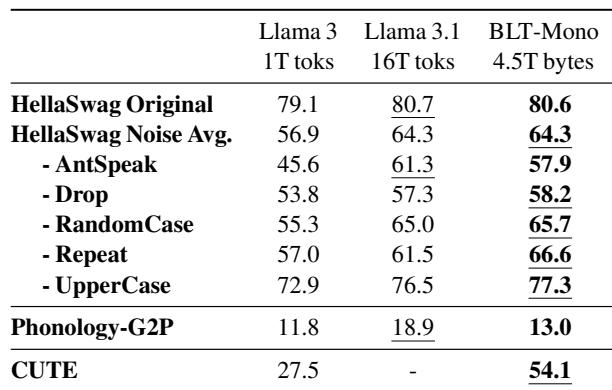
BLT展现出对字节级噪声的强大鲁棒性,在使用更少训练字节的情况下,在噪声HellaSwag变体上平均匹配或超过更大的Llama 3.1模型。它还在字符级和音韵学任务上展现出对基于分词器模型的明显优势。在噪声HellaSwag上,BLT平均与Llama 3.1持平,并在重复、随机大小写和大写破坏上表现更优。BLT在字素到音素转换和字符理解基准上超过BPE Llama 3基线。
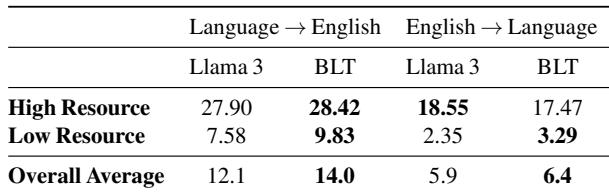
BLT在FLORES-101翻译任务的双向上均优于Llama 3 BPE模型,在翻译为英语时优势更大。增益在低资源语言中尤为显著,凸显了字节级建模对长尾语系的有效性。BLT在语言到英语和英语到语言两个翻译方向上均取得比Llama 3更高的BLEU分数。相较于BPE基线最大的相对改进出现在低资源语言设置中。BLT翻译为英语的整体平均优势约为2个BLEU点,从英语翻译时约为0.5个点。
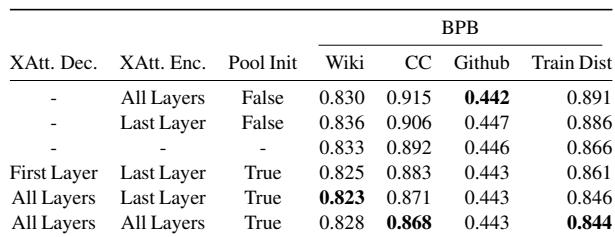
解码器中的交叉注意力是语言建模性能提升的主要贡献者,在所有层上应用时效果最佳。编码器交叉注意力仅在查询通过汇聚编码器隐藏状态初始化时带来小幅改进。增益在Common-Crawl数据上最为显著,表明交叉注意力有助于多样化或噪声领域。解码器交叉注意力持续降低每字节比特数,尤其是在所有层上应用时。编码器交叉注意力仅在结合查询的汇聚初始化时改进性能。交叉注意力在Common-Crawl上带来最大收益,在Wikipedia和GitHub上增益较小。
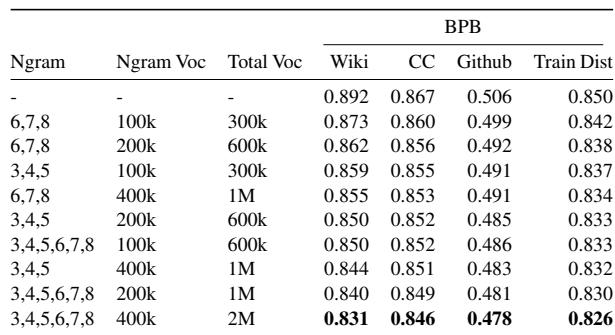
消融实验表明,添加n-gram哈希嵌入在所有领域上显著改善每字节比特数,在Wikipedia和GitHub上增益最强。较小的n-gram大小(3,4,5)比较大的更有效,使用较小每n-gram词表且n-gram大小多样化的方案优于相同总大小的较大词表。哈希n-gram嵌入相对于无嵌入带来较大的BPB改进,尤其是在Wikipedia和GitHub上。n-gram大小3,4,5优于更大的6,7,8,表明较短上下文的n-gram影响更大。对于固定总词表,使用较小每n-gram词表且n-gram大小不同的方案优于较大的统一词表。
评估表明,采用单调熵补丁的字节级模型在大多数任务上优于基于Llama 3分词器的基线,而空格补丁以准确性换取推理FLOP节省。BLT还展现出对字节级噪声的强大鲁棒性,在噪声基准上匹配或超过更大的Llama 3.1模型,并在字符级任务和低资源语言翻译上取得对BPE模型的明显增益。消融实验揭示解码器交叉注意力是语言建模改进的主要驱动因素,添加较小n-gram大小的哈希嵌入可跨领域带来显著的每字节比特数增益,尤其是在Wikipedia和GitHub上。