Command Palette
Search for a command to run...
LLM MapReduce:利用大语言模型简化长序列处理
LLM MapReduce:利用大语言模型简化长序列处理
摘要
我们提出了一个无需训练的框架,使大语言模型(LLM)能够有效处理长文本,采用分而治之的策略进行全面的文档理解。所提出的 LLM MapReduce 框架将整个文档分割成多个块供 LLM 阅读,然后聚合中间输出以生成最终响应。分而治之的长文本处理框架面临的主要挑战在于,文档分割可能导致关键的长距离信息丢失,这会使模型基于分段文本产生不完整或错误的答案。被破坏的长距离信息可分为两类:块间依赖和块间冲突。我们设计了一种结构化信息协议,以更好地应对块间依赖,并引入了一种上下文内的置信度校准机制来解决块间冲突。实验表明,LLM MapReduce 在性能上优于具有代表性的开源和商业长上下文 LLM,并且与多种模型兼容。我们的框架还可以作为数据合成引擎,仅使用短上下文 LLM 即可生成高质量的长对齐数据。
一句话总结
来自厦门大学、清华大学等中国机构的研究人员提出了 LLM MapReduce,这是一种无需训练的分治框架,用于长文本处理。该框架将文档分块、聚合中间输出,并引入结构化信息协议和上下文内置信度校准机制,以解决块间依赖和冲突问题,性能优于具有代表性的长上下文 LLM,同时仅使用短上下文模型即可实现高质量数据合成。
核心贡献
- 提出了 LLM MapReduce,这是一种无需训练的分治框架,将长文档分割成块供 LLM 阅读,然后聚合中间输出,从而能够处理远超模型有效上下文窗口的文本。
- 通过针对块间依赖的结构化信息协议和针对块间冲突的上下文内置信度校准机制,解决了分块导致的长距离信息丢失问题,克服了 LongAgent、Chain-of-Agents 和 LC-Boost 的局限性。
- 性能优于具有代表性的开源和商业长上下文 LLM,可与多种模型兼容,同时还可作为数据合成引擎,仅使用短上下文 LLM 生成 Pyramid-Align 数据集。
引言
大语言模型受限于固定的上下文窗口,这一约束源于二次方计算成本和高品质长训练样本的稀缺,限制了其在长文档理解等任务中的应用。以往扩展上下文的工作分为两类:基于训练的方法需要大量计算资源和长数据;无需训练的分治方法将文本分割成块,但可能破坏长距离信息,具体表现为证据跨越多个块时产生的块间依赖,以及证据相互矛盾时产生的块间冲突。作者提出了 LLM MapReduce,这是一种无需训练的框架,通过结构化信息协议聚合各块的输出,并通过上下文内置信度校准机制解决矛盾。此外,作者将该框架扩展为数据合成引擎,创建了 Pyramid-Align 数据集,使 8B 模型在长序列基准测试中超越 GPT-4,展示了性能和效率的双重提升。
数据集
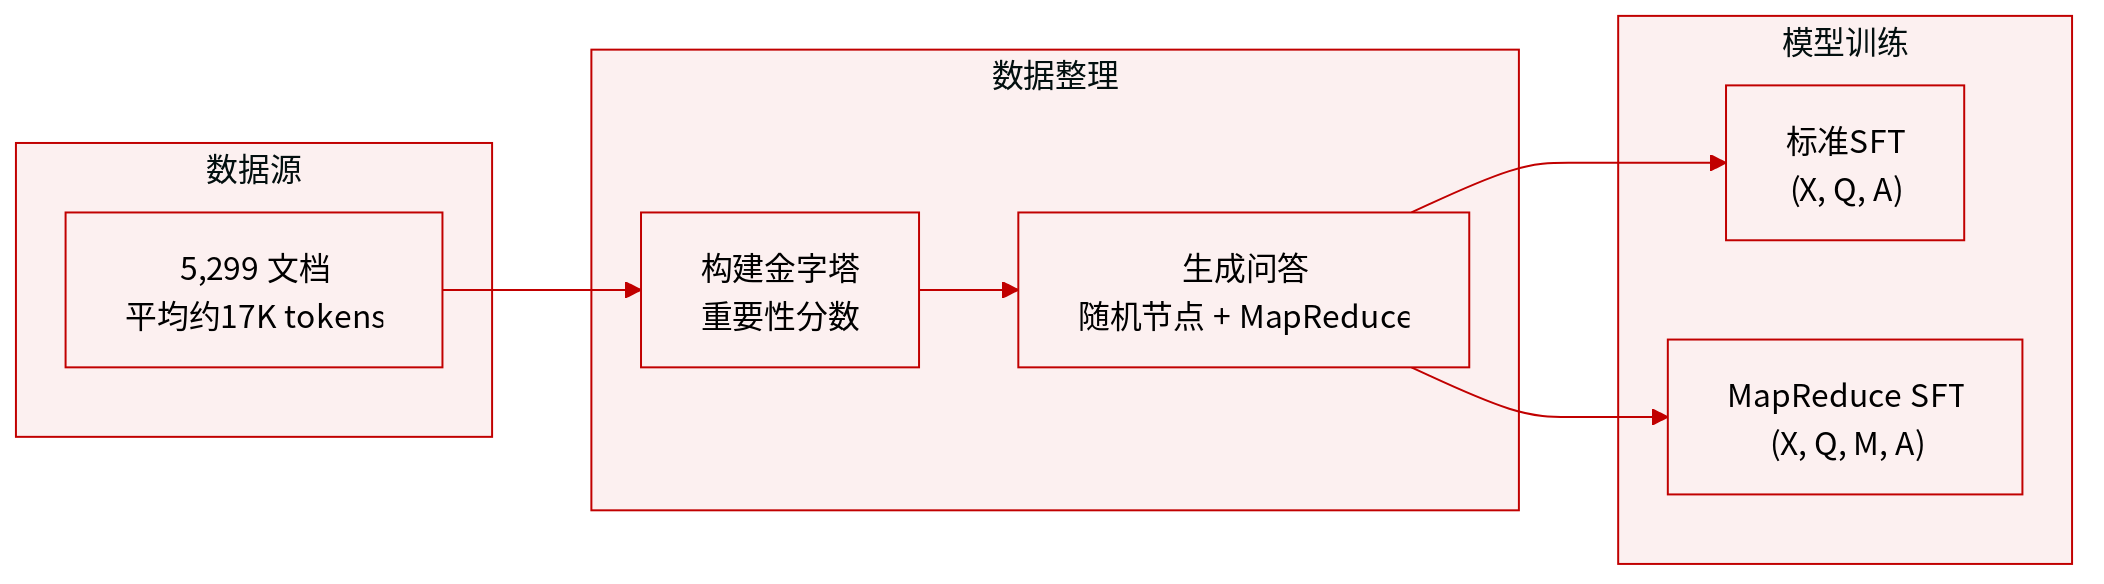
作者介绍了 Pyramid-Align,这是一个长上下文监督微调(SFT)数据集,通过分治方法将短上下文 LLM 的能力蒸馏到长上下文 LLM 中。
数据集来源与构成
- 该数据集基于 LongAlign 数据集所用的相同 5,299 份英文文档构建,确保数据构建方法之间的公平比较。
- 平均文档长度约为 17K tokens,最长可达 74K tokens。
- 最终数据集包含 4,927 条问答条目。
金字塔构建
- 使用 LLM 将文档抽象为分层节点。每个叶节点代表一个单独的块,而高层节点压缩多个块的信息。
- 为形成上层节点,通常将三个下层节点合并,如有需要可向下调整组大小以适配上下文窗口 L。
- 层级数量由文档长度动态决定,范围为 1 到 3,平均为 1.99。
- 为保留上层节点中的关键内容,作者实现了自底向上的重要性传播机制。计算句子级重要性分数并向上传递,提示 LLM 在摘要时优先考虑重要句子。
问答生成
- 从随机选择的节点生成问题:选择叶节点模拟 IN2 方法,而选择根节点则与 LongAlign 一致。
- 引导 LLM 在生成问题时优先考虑重要句子,确保关键信息被纳入。
- 答案通过将 LLM MapReduce 框架应用于长文档和问题来生成。
- 每个数据集示例表示为 (X,Q,M,A),其中 X 是长文档,Q 是问题,M 包含中间 MapReduce 输出(映射和折叠结果),A 是最终答案。
数据的使用方式
- 对于标准长上下文训练,作者在 LongAlign 和 Pyramid-Align 上训练 Llama3.1-8B,使用标准解码而不使用 LLM MapReduce。在 Pyramid-Align 上训练的模型优于在 LongAlign 上训练的模型。
- 中间输出 M 支持第二种训练模式:在 (X,Q,M,A) 上训练模型,使其与 LLM MapReduce 框架对齐。训练后的 8B 模型在评估任务上优于 GPT-4。
- 由于训练中仅使用英文文档,评估在 InfiniteBench 的四个英文任务上进行。
方法
作者提出了 LLM MapReduce 框架,旨在处理远超模型有效上下文窗口的文档。该工作流基于分治原则运行,包含三个顺序阶段:映射(map)、折叠(collapse)和归约(reduce)。参见框架图。
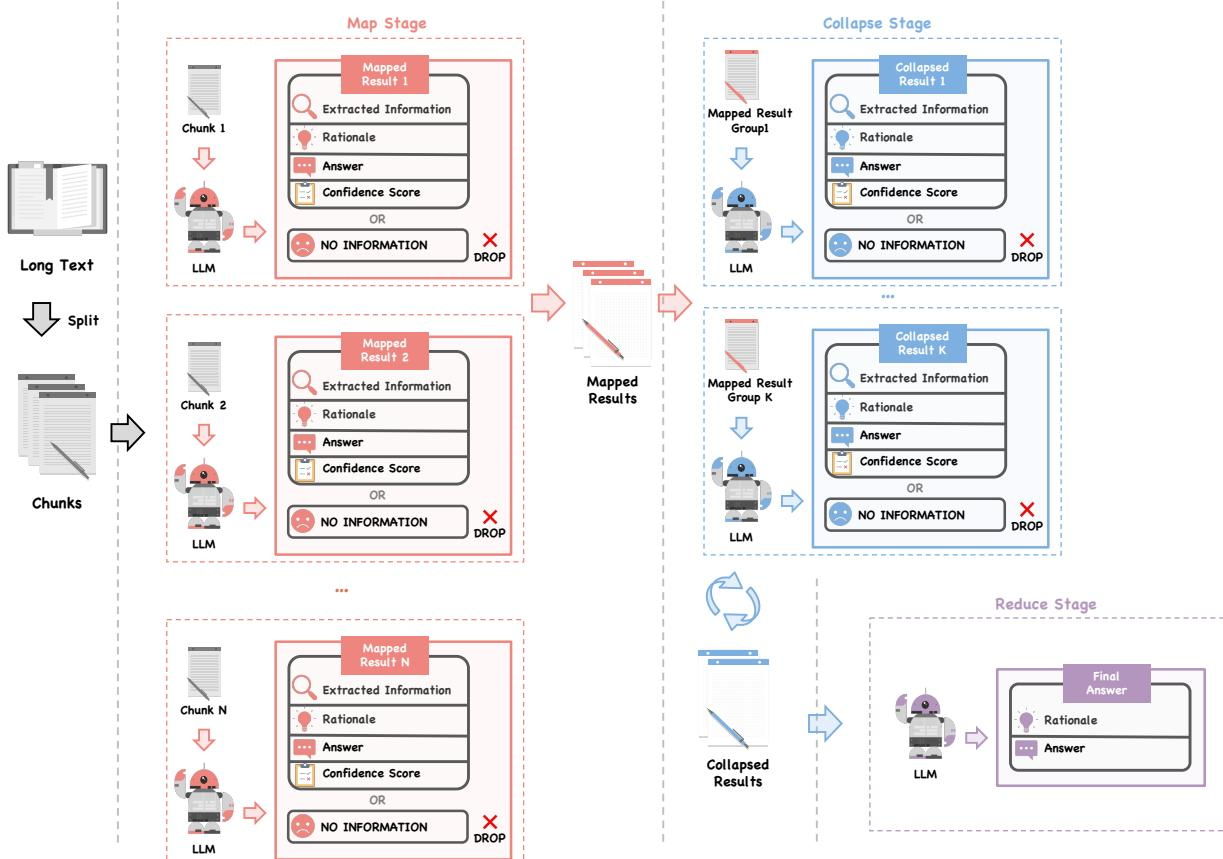
在映射阶段,输入文本 X 根据 token 长度和自然语义边界被划分为块 {x1,x2,…,xN}。由参数 θ 定义的 LLM 处理每个块,提取由映射函数定义的中间输出:si=fmap(xi,Q;θ),其中 Q 表示用户查询。为确保各阶段之间的高效通信,框架采用结构化信息协议而非原始文本摘要。
为解决块间依赖和冲突问题,映射结果由四个具体组件构成。提取信息捕获与查询相关的关键事实。推理过程提供推断过程,降低聚合过程中的幻觉风险。答案包含中间响应,若块与查询无关则标记为"无信息"(NO INFORMATION)。最后,置信度分数范围为 0 到 5,用于评估提取信息的完整性和可靠性。该分数对于解决后续阶段的差异至关重要。
当映射结果量超过上下文限制 L 时,框架进入折叠阶段。N 个映射结果被分组为 K 个集合,折叠函数 cj=fcollapse(gj,Q;θ) 迭代压缩这些组,直到输出适配上下文窗口。折叠结果的结构与映射结果相同。为确保不同块之间的置信度分数具有可比性,作者实现了上下文内置信度校准机制。该系统不微调模型参数,而是为不同置信度级别提供评估原则和典型示例。参见校准提示词。
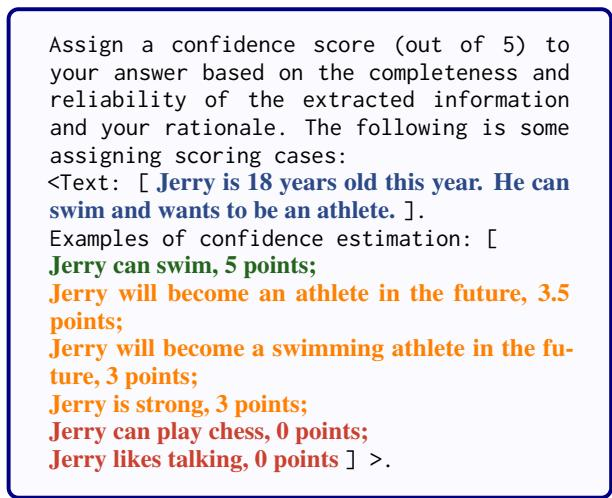
这种方法引导模型对文本完全支持的陈述赋予高置信度,对推断得出的陈述赋予中等置信度,对无关信息赋予低置信度,从而建立了一致的冲突解决标准。
除推理外,分治架构还通过名为 Pyramid-Align 的数据集促进将长上下文能力蒸馏到短上下文模型中。构建过程首先将块抽象为层次化金字塔结构。参见金字塔示意图。
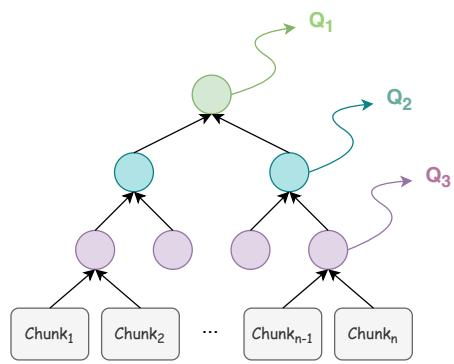
叶节点代表单独的块,而高层节点综合多个低层节点的内容。为防止信息随层级上升而丢失,采用了自底向上的重要性传播机制。参见传播过程。
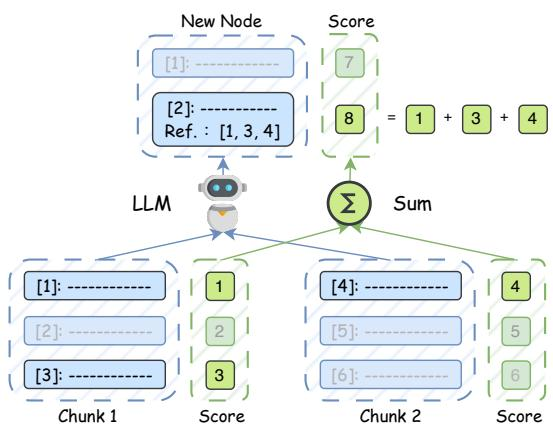
在叶节点层计算句子级重要性分数并向上传播。生成上层节点时,提示 LLM 优先考虑重要性分数较高的句子,从而提高信息覆盖率。随后通过随机选择不同层级的节点来生成问题,确保模型学习理解不同跨度的文本。答案使用 LLM MapReduce 框架生成,产生格式为 (X,Q,M,A) 的训练样本,其中 M 表示中间映射和折叠结果。这种格式使得监督微调能够使模型行为与 MapReduce 流程紧密对齐。
实验
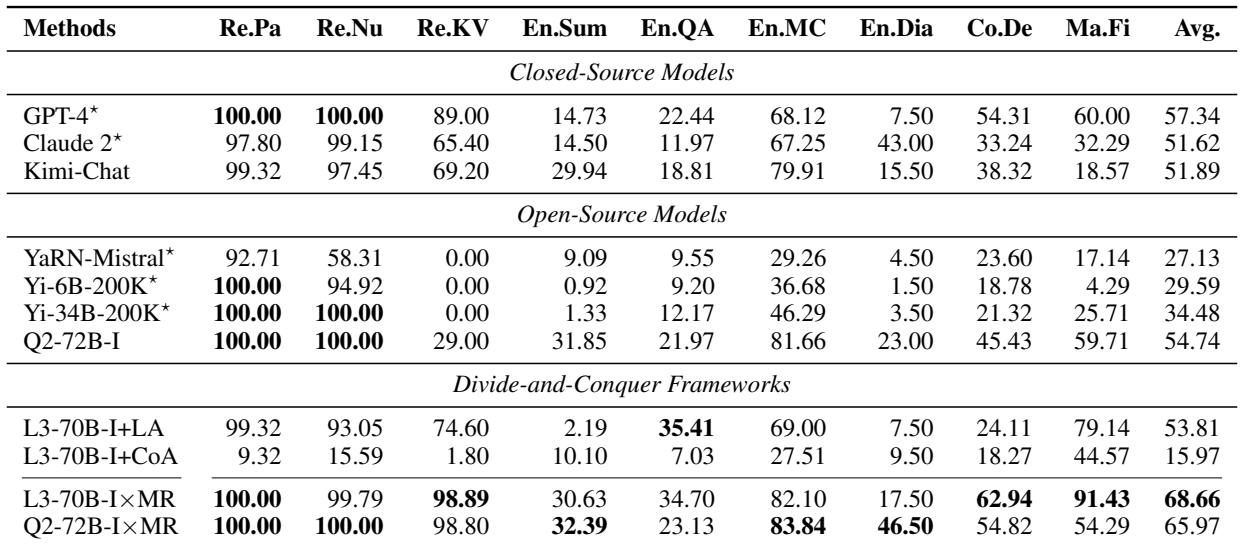
评估在 InfiniteBench 上使用 Llama3-70B-Instruct 和 Qwen2-72B-Instruct 进行,排除了两个性能较低的子集,并与闭源模型以及 LongAgent 和 Chain-of-Agents 等分治基线进行了比较。所提出的 LLM MapReduce 框架在各子任务上取得了最高的平均准确率,优于所有基线,并适用于两种骨干模型。消融研究表明,结构化信息协议和上下文内置信度校准对于保持性能至关重要,移除任一机制都会导致性能下降。在长达 1280K tokens 的 NIAH 测试中,该框架使 8K 上下文的模型能够有效处理序列,同时在 GPU 需求更少的情况下比标准解码和其他分治方法更快。
所提出的 LLM MapReduce 方法在 InfiniteBench 上取得了最高平均分,超越了闭源模型和分治基线。该方法兼容多种骨干模型,包括 Llama3-70B-Instruct 和 Qwen2-72B-Instruct,并在所有子任务上表现良好。在分治基线中,LongAgent 几乎在每项子任务上都优于 Chain-of-Agents。所提出的方法在平均分上优于所有基线和闭源模型。LongAgent 在几乎所有子任务上都取得了优于 Chain-of-Agents 的结果。该方法可推广到不同的骨干模型,在 Llama3-70B 和 Qwen2-72B 上均表现出强大性能。
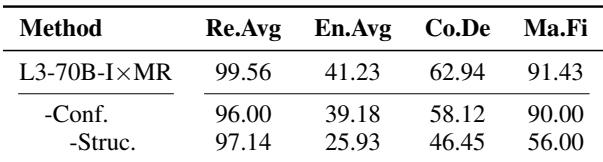
消融研究表明,结构化信息协议和上下文内置信度校准对 LLM MapReduce 框架的性能至关重要。移除置信度校准会导致所有任务性能下降,尤其在英语理解方面;而禁用结构化协议会导致更显著的性能下降。与消融变体相比,包含两种机制的完整框架在检索和英语理解任务上取得了最高的平均分。移除置信度校准会降低所有任务的性能,其中英语理解的下降最为明显。禁用结构化协议会导致更大的性能退化,尤其是在英语理解以及事实性或数学任务中。
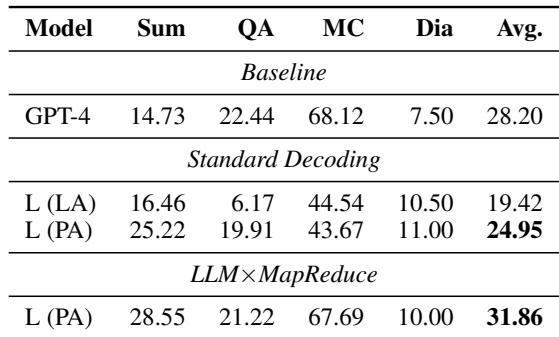
Pyramid-Align 训练在 InfiniteBench 的英文任务上持续优于 LongAlign,尤其在摘要和问答任务中。应用 LLM MapReduce 解码进一步提升了 Pyramid-Align 的性能,平均分超过 GPT-4 基线。结果表明,从不同上下文长度生成 SFT 数据能够产生更强的长上下文模型。在标准解码下,Pyramid-Align 将 LongAlign 的平均分从 19.42 提升至 24.95。LLM MapReduce 结合 Pyramid-Align 达到平均分 31.86,超过 GPT-4 基线的 28.20。Pyramid-Align 的最大增益出现在摘要和 QA 任务中,而在多选题和对话任务中变化较小。
对 LLM MapReduce 方法在 InfiniteBench 上的评估显示,该方法优于闭源模型和分治基线,并可推广到 Llama3-70B 和 Qwen2-72B 等骨干模型。消融研究证实,结构化信息协议和上下文内置信度校准均至关重要,移除任一机制都会导致性能下降,尤其在英语理解和事实性任务中。此外,Pyramid-Align 训练在长上下文英文任务上持续优于 LongAlign,将其与 LLM MapReduce 解码相结合可超过 GPT-4 基线,凸显了使用不同上下文长度生成 SFT 数据的优势。