Command Palette
Search for a command to run...
一次令牌化,处处推荐:面向多领域基于大语言模型推荐系统的统一项目令牌化
一次令牌化,处处推荐:面向多领域基于大语言模型推荐系统的统一项目令牌化
Yu Hou Won-Yong Shin
摘要
基于大语言模型(LLM)的推荐系统通过项目令牌化弥合了项目空间与语言空间之间的差异,从而实现了高质量的性能。然而,现有的项目令牌化方法通常需要为每个项目领域训练单独的模型,限制了泛化能力。此外,不同项目领域之间的多样分布和语义使得构建保留领域特定信息的统一令牌化变得困难。为应对这些挑战,我们提出了UniTok,一个统一的项目令牌化框架,该框架集成了我们自己的混合专家(MoE)架构与一系列码本,将项目转换为离散令牌,从而在多个项目领域中实现可扩展的令牌化,同时保留语义信息。具体来说,来自不同领域的项目首先通过共享编码器投影到一个统一的潜在空间。然后,它们被路由到领域特定的专家以捕获独特语义,而一个始终激活的共享专家则编码可跨领域迁移的通用知识。此外,为缓解跨领域的语义不平衡,我们提出了一种互信息校准机制,引导模型为每个领域保留相似水平的语义信息。在广泛的真实世界数据集上的全面实验表明,所提出的UniTok框架(a)高度有效:相较于强基准实现了高达51.89%的提升;(b)理论健全:展示了我们架构设计和优化的分析有效性;(c)高度可泛化:在无需每个领域重新训练的情况下,展现了跨多样领域的鲁棒性能,而现有基线不支持这种能力。
一句话总结
延世大学的研究人员提出UniTok,一个统一的物品分词框架,采用混合专家架构和一系列码本,通过共享编码器和领域专属专家将多领域物品转换为离散token,并辅以互信息校准机制来平衡各领域间的语义信息,在无需针对每个领域重新训练的情况下,相比强基准实现了高达51.89%的提升。
核心贡献
-
提出UniTok,一个统一的物品分词框架,结合了定制的混合专家架构和基于码本的token提取,将来自多个领域的物品映射为离散语义token。该设计通过领域专属专家和一个始终激活的共享专家路由输入,同时互信息校准机制减少跨领域的语义不平衡。
-
在多个真实世界数据集上的实验表明,UniTok在NDCG@10上相比强基线实现了高达51.89%的提升,将可训练参数减少了9.63倍,并在无需领域重新训练的情况下保持了稳健的零样本性能。
-
理论分析表明,UniTok能诱导出更高熵的token空间,实现更低的量化误差,并降低跨领域的互信息方差,确保语义一致性和稳定性能。
引言
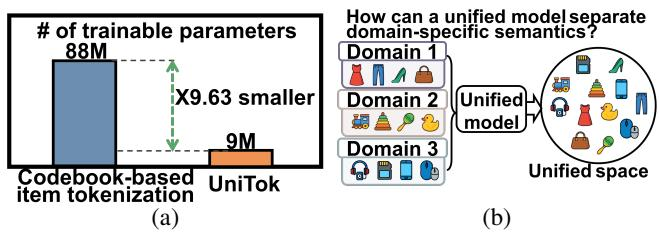
大型语言模型(LLM)越来越多地用于生成式推荐,但它们需要物品分词来将物品转换为连接物品空间和语言空间的离散标识符。现有分词方法针对单领域设置定制,需要为每个物品领域单独训练分词器。当推荐任务跨越多个领域时,这种孤立的方法导致训练、部署和维护效率低下,阻碍了可扩展性。出现两个关键挑战:(C1)重复学习领域专属分词器带来的训练开销,以及(C2)语义对齐,即跨领域共享token空间可能导致语义混淆和token分配偏差。
作者引入了UniTok,这是首个面向多领域基于LLM的推荐系统的统一物品分词框架。为解决C1并部分解决C2,他们提出了Token-MoE,一种混合专家架构,将领域专属专家与共享专家分离,使模型能够在跨领域共享通用知识的同时保留领域特异性。为彻底解决C2,他们添加了互信息校准机制,鼓励来自每个领域的潜在嵌入保持语义信息性和一致性,减少跨领域性能差异。在实验中,UniTok在NDCG@10上实现了高达51.89%的提升,与基于码本的基线相比减少了9.63倍的可训练参数,且无需重新训练即可展现强大的零样本泛化能力。作者还提供了关于更高熵token空间、更低量化误差以及通过降低MI方差实现语义一致性的理论保证。
方法
作者提出了UniTok,一个统一框架,旨在解决基于大型语言模型的推荐系统中的多领域物品分词挑战。如框架图所示,该架构包含四个核心组件:共享自编码器、名为TokenMoE的混合专家(MoE)模块、基于码本的标识符,以及互信息(MI)校准机制。这种设计使模型能够将异质物品领域投影到一致的潜在空间,同时保留领域特有细节。
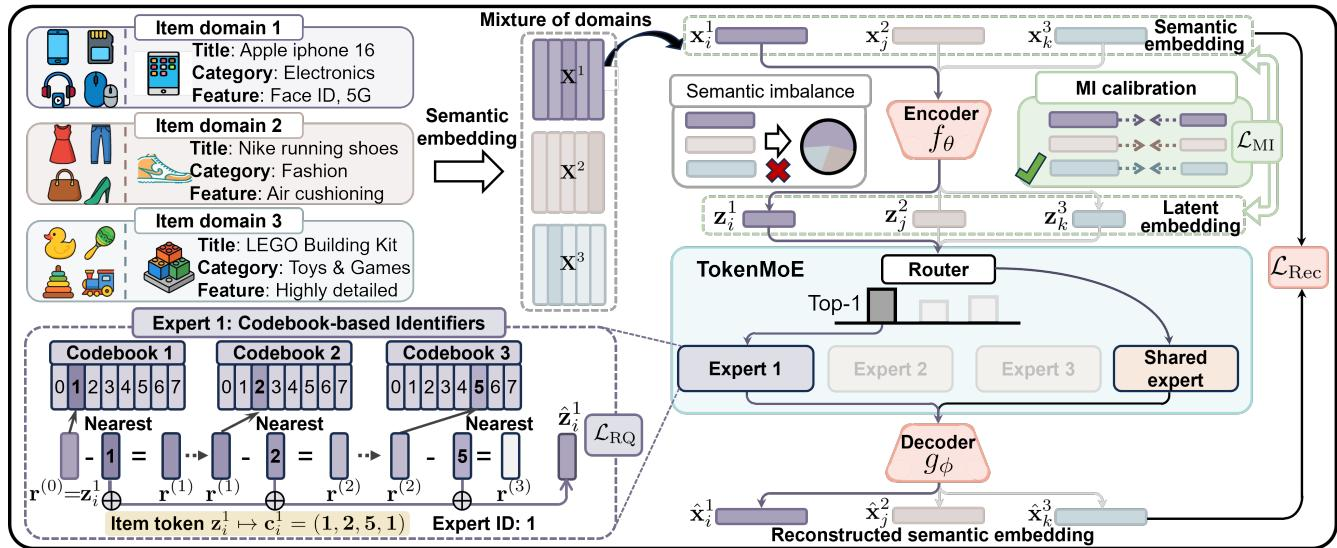
流程始于一个共享自编码器,将来自不同物品领域的连续语义嵌入映射到统一潜在空间。给定来自领域k的输入物品嵌入xik,编码器fθ产生潜在表示zik。解码器gϕ随后从处理后的潜在表示中重建原始嵌入。该组件建立了跨领域的共同结构基础,通过最小化原始嵌入与重建嵌入之间的L2距离的重建损失进行优化。
为了在不混淆领域语义的情况下捕捉领域特定语义,该框架采用了TokenMoE。该模块通过一个可学习的路由器在每个潜在嵌入zik上计算一个在K个领域专属专家上的softmax分布。路由器根据最高激活分数选择top-N个专家。同时,一个共享专家被确定性激活以促进跨领域知识迁移。最终处理后的潜在表示z^ik由所选领域专家和共享专家的输出的加权组合计算得出。每个专家模块用其对应领域的均值特征初始化,以提供专业化的归纳偏置。
在每个专家内部,模型利用基于码本的标识符将连续潜在嵌入离散化为紧凑的token序列。这是通过残差量化(RQ)实现的,它递归地应用一系列码本来量化输入残差向量。在每个量化阶段,从相应码本中选择最近的码向量,并更新残差。这种分层量化过程生成一个离散码字序列,有效表示物品。量化模块使用RQ损失训练,该损失在强制执行编码器和路由器承诺的同时,将码向量与目标残差对齐。
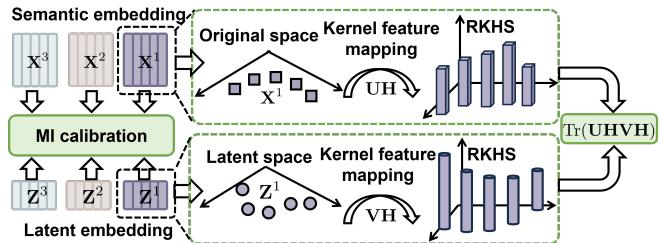
多领域设置中的一个关键挑战是语义不平衡,即各领域潜在嵌入的质量差异显著。为缓解这一问题,作者引入了MI校准机制。该组件使用希尔伯特-施密特独立性准则(HSIC)作为互信息的代理,测量原始语义嵌入与学习到的潜在嵌入之间的统计依赖性。通过将输入和潜在空间映射到再生核希尔伯特空间(RKHS),模型计算两个空间之间的互协方差。MI校准损失旨在惩罚不同领域间互信息估计的方差,从而强制语义平衡。此外,它还鼓励每个领域保留足够的领域特有信息。
整体训练过程通过最小化一个组合目标函数来端到端地优化模型。该总损失聚合了重建损失、RQ损失和MI校准损失,由各自的超参数加权。训练完成后,UniTok将每个物品分词为离散语义token,随后下游基于LLM的推荐器利用这些token序列预测用户交互。
实验
实验在十个推荐领域验证了UniTok的统一分词框架,显示了相比协同过滤和分词辅助方法的持续准确率提升,在语义捕捉和泛化方面尤为显著。效率实验显示,与传统逐领域码本分词器相比,可训练参数大幅减少,即使在共享训练预算下也能保持优越性能。在未见领域上的零样本测试证实了无需重新训练的鲁棒迁移能力。消融研究表明,TokenMoE模块和互信息校准都至关重要,移除任一都会降低推荐质量。
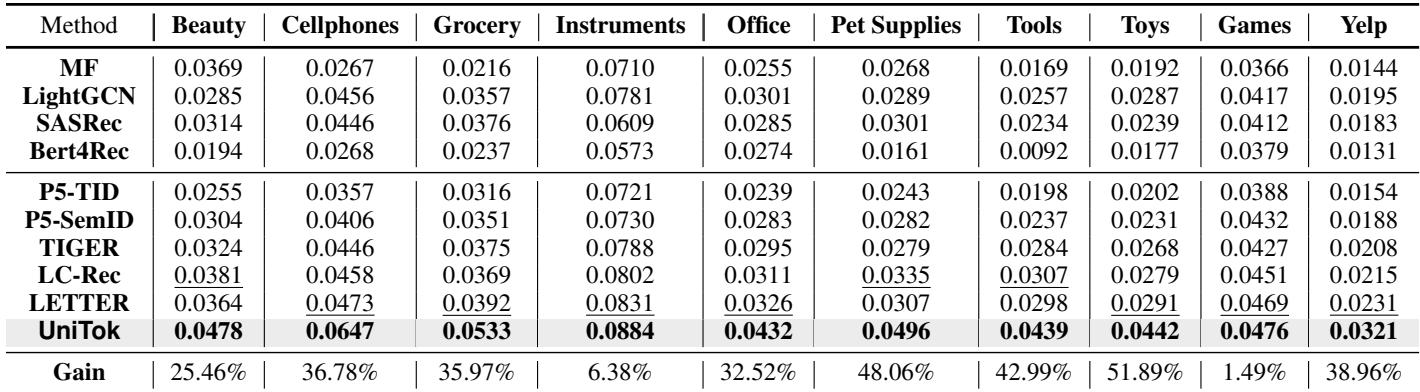
UniTok在十个多样化的基准数据集上的NDCG@10中持续优于所有竞争方法,在Tools数据集上最大提升达51.89%。结果证实,具有共享语义的统一分词比数据集特定分词器更有效,而基于LLM的推荐系统通常超越传统协同过滤基线。UniTok在每个数据集上均取得最高NDCG@10,其中在Tools上最大增益为51.89%。基于LLM的分词方法(TIGER、LC-Rec、LETTER、UniTok)优于MF和LightGCN等传统协同过滤模型。统一分词保持了跨领域的强准确性,而联合训练的竞争方法则表现出显著退化。
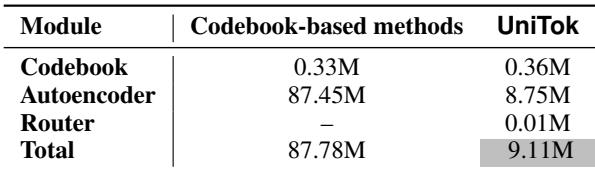
UniTok通过与基于码本的方法相比减少约一个数量级的可训练参数,这是通过在数据集间使用单个共享模型实现的,而竞争方法则每个数据集累积参数。节省几乎完全来自更小的自编码器,码本和路由器参数非常少。UniTok的总可训练参数约为基于码本竞争对手的十分之一(9.11M对87.78M),这是通过在所有十个数据集上共享参数实现的。自编码器几乎占了全部参数减少(8.75M对87.45M),而码本大小相近(0.36M对0.33M),路由器仅增加0.01M。
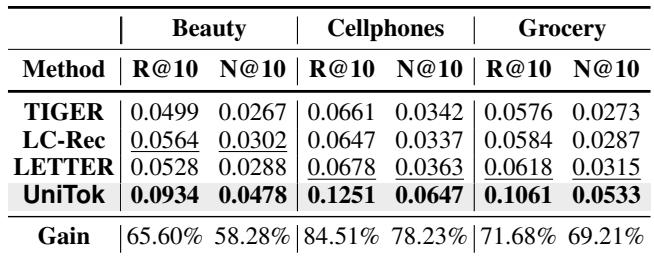
在具有相当参数预算的统一训练设置下,UniTok在所有评估领域上都持续优于传统的基于码本的分词器,而竞争对手则遭受显著的性能退化。增益在Cellphones上尤为明显,UniTok将Recall@10提升了高达84.51%。UniTok相对于所有竞争对手都取得了较大的相对增益,Recall@10提升范围从Beauty上的65.60%到Cellphones上的84.51%。竞争方法在统一多领域设置下显著退化,可能由于难以区分不同领域的物品并共享分词。UniTok的模块化TokenMoE架构使领域专属专家能够独立学习,同时共享统一的token空间,保持了性能。
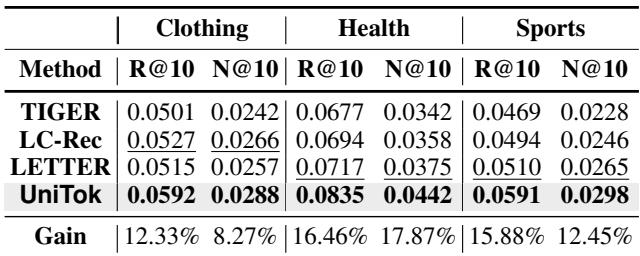
在三个未见领域(Clothing、Health、Sports)的零样本泛化测试中,UniTok在Recall@10和NDCG@10上相比于现有物品分词方法持续取得最佳结果,相对增益约在8%到近18%之间。提升在Health领域最为显著,NDCG@10相比最强基线提升了17.87%。UniTok在所有三个未见数据集上均取得最高Recall@10和NDCG@10。最大相对增益是Health领域的NDCG@10提升17.87%。TIGER、LC-Rec和LETTER等基线在所有指标上表现较低,而UniTok在Sports上Recall@10的提升高达15.88%。
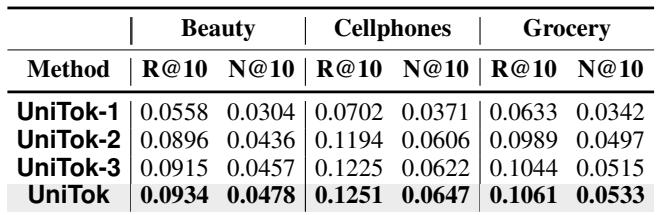
一项逐步移除TokenMoE模块、共享专家和MI校准的消融研究表明,每个组件都对推荐准确性有贡献。最大性能下降出现在移除TokenMoE时,而MI校准在所有数据集上提供了额外的持续增益。完整模型在每个数据集上都取得了最佳结果。移除TokenMoE在所有数据集上导致最显著的性能下降。添加共享专家相比仅使用TokenMoE无共享专家时提高了准确性。MI校准在TokenMoE和共享专家的基础上进一步提升了性能。完整的UniTok模型持续优于所有消融变体。
评估表明,UniTok在十个基准数据集上持续优于所有基线,在NDCG@10和Recall@10上取得了大幅提升,并在未见领域上具有优越的零样本泛化能力。通过共享分词和模块化架构,它在实现这些结果的同时将可训练参数减少了近一个数量级。消融研究证实,TokenMoE模块、共享专家和MI校准各自对准确性有实质性贡献,完整模型在所有设置下均取得最佳性能。