Command Palette
Search for a command to run...
DeepSeek-V4.1-Flash:突破 KV 缓存压缩的极限
DeepSeek-V4.1-Flash:突破 KV 缓存压缩的极限
摘要
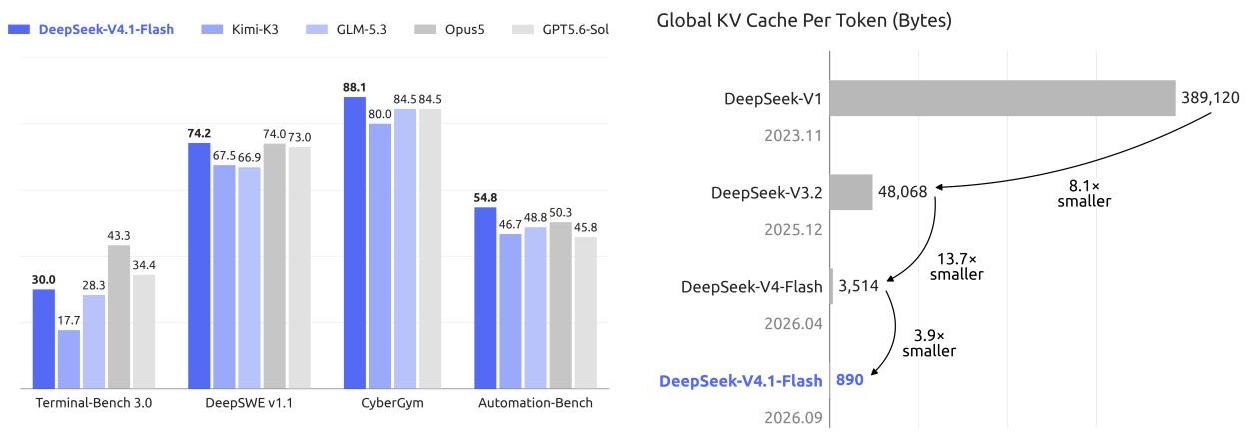
长时程智能体的广泛采用使得模型工作负载日益以输入密集型为主。尽管先前的工作已大幅降低了长上下文计算成本,但预填充阶段的计算开销仍然高昂,且大型 KV 缓存持续对 HBM 和 SSD 的容量及数据传输带宽造成压力。这些计算、存储和带宽需求共同构成了进一步降低部署成本的主要瓶颈。为应对这一挑战,我们推出了 DeepSeek-V4.1-Flash,这是一个具有 552B 主干参数并支持多达一百万 token 上下文的多模态混合专家(MoE)模型。凭借其因果编码器-解码器(CED)架构,该模型在解码阶段每 token 激活 16B 参数,而在预填充阶段仅激活 8B 参数,从而显著提升了智能体工作负载的成本效率。为突破 KV 缓存压缩的极限,DeepSeek-V4.1-Flash 在压缩稀疏注意力 2(CSA2)中结合了跨层 KV 缓存重用与 FP4 KV 缓存技术。这些设计将其全局 KV 缓存占用(始终驻留于 HBM)降至每 token 890 字节,约为 DeepSeek-V4-Flash 相应占用的 1/4。此外,通过一项名为 SWA Bounded Replay 的专用部署优化,DeepSeek-V4.1-Flash 将其持久 KV 缓存占用(始终驻留于 SSD 或主机内存)降至约为 DeepSeek-V4-Flash 的 1/8。尽管 KV 缓存占用大幅减小,该模型仍提供了显著优于基线的性能。此外,我们对 DeepSeek-V4 架构进行了精简,并引入了若干高效的架构扩展。我们在包含 45T token 的多模态语料库上预训练了 DeepSeek-V4.1-Flash,并进行了全面的后训练,使其在多样化的基于文本和多模态智能体场景中展现出强劲性能。模型检查点可在 https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash 获取。
一句话总结
DeepSeek-AI 推出 DeepSeek-V4.1-Flash,一个拥有 552B 参数的多模态混合专家模型,支持百万 token 上下文。其因果编码器-解码器架构在解码阶段每 token 激活 16B 参数,但在预填充阶段仅激活 8B 参数。该模型将压缩稀疏注意力 2 中的跨层 KV 缓存复用与 FP4 KV 缓存相结合,将全局 HBM KV 缓存占用降至每 token 890 字节(约为 DeepSeek-V4-Flash 的四分之一),并借助 SWA 有界回放将持久化 SSD/主机 KV 占用降至约八分之一,在文本和多模态 agentic 工作负载上实现了显著更优的性能。
核心贡献
- 推出 DeepSeek-V4.1-Flash,一个拥有 552B 主干参数和百万 token 上下文支持的多模态混合专家模型,其因果编码器-解码器(CED)架构在预填充阶段每 token 激活 8B 参数,而解码阶段激活 16B 参数,提升了输入密集型 agentic 工作负载的成本效率。
- 将压缩稀疏注意力 2(CSA2)中的跨层 KV 缓存复用与 FP4 KV 缓存相结合,将全局 KV 缓存占用(始终位于 HBM)降至每 token 890 字节,约为 DeepSeek-V4-Flash 的四分之一,并引入 SWA 有界回放,将持久化 KV 缓存占用(位于 SSD 或主机内存)降至基线的约八分之一。
- 在 45T token 的多模态语料上进行预训练,并在多样化的文本和多模态 agentic 任务上进行后训练,DeepSeek-V4.1-Flash 在整体性能上显著优于 DeepSeek-V4-Flash,并在关键基准测试中达到或超过 GLM-5.3 和 Kimi-K3 等更大的开源模型,尽管其参数规模更小。
引言
长时程 AI agent 需要处理极长的上下文,这对承载键值(KV)缓存的内存和存储系统提出了很高的要求。此前的稀疏注意力方法降低了计算成本,但这些缓存的持久化存储和数据移动成为主要瓶颈,限制了吞吐量并推高了部署成本。作者推出 DeepSeek-V4.1-Flash,一个多模态混合专家模型,通过联合优化架构、缓存精度和部署策略来积极压缩 KV 缓存。借助因果编码器-解码器设计和新的压缩稀疏注意力 2 机制,该模型在层间共享全局 KV 缓存,并使用 FP4 精度将运行时缓存存储降至其前代产品的约四分之一,而称为 SWA 有界回放的技术将持久化磁盘存储降至约八分之一。这使得模型能够以低推理延迟和成本支持百万 token 上下文,在显著提升部署效率的同时达到与前沿模型相当的性能。
数据集
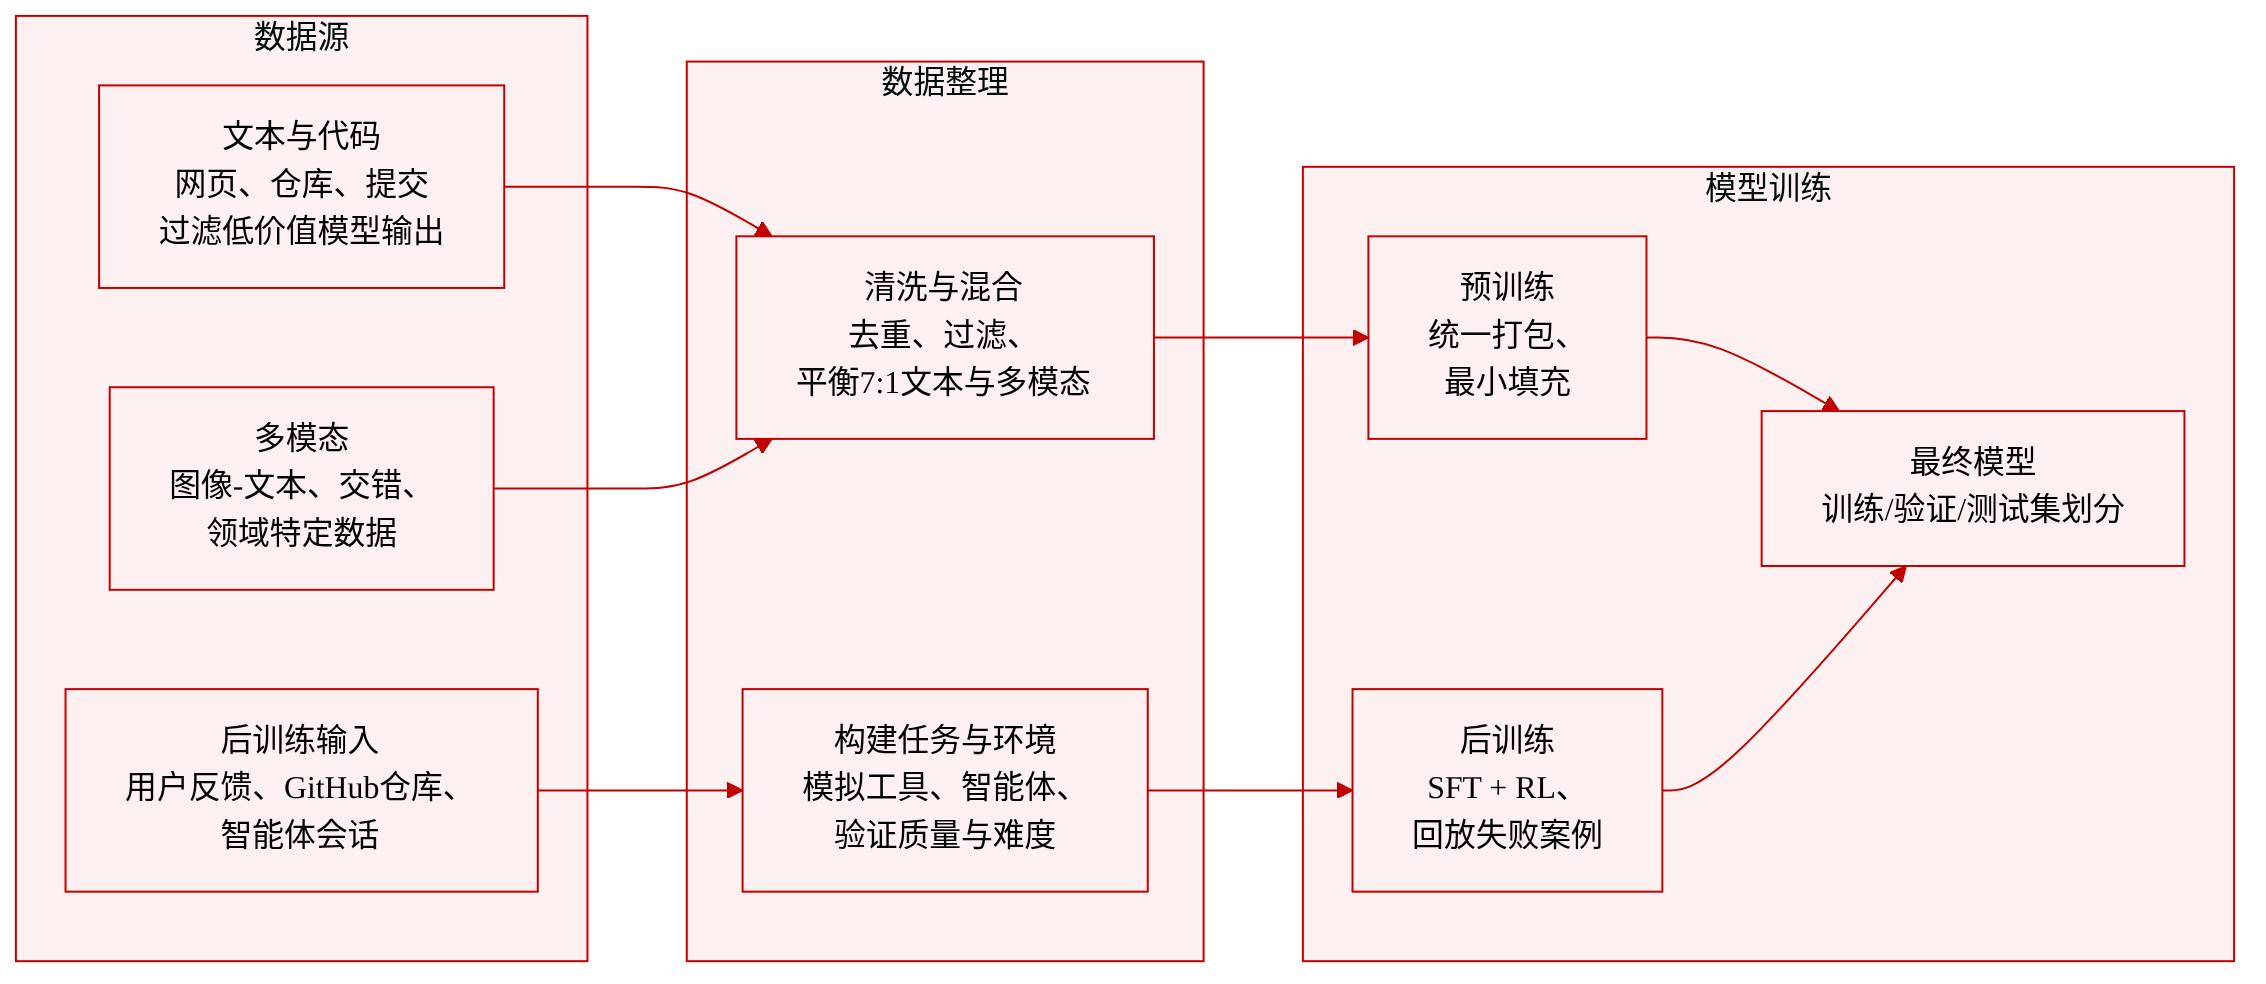
作者描述了用于预训练和后训练的两阶段数据策略,每个阶段通过各自专门的流水线进行策划。
预训练数据构建
- 文本数据策展: 作者关注多样化语料之间的整体交互,以最大化信息增益。他们使用一个系统构建的流水线,该流水线以模型参数和训练数据上的缩放阶梯为指导。为提高质量,他们过滤掉信息增益有限的模型生成内容,例如能力较弱的模型输出和低质量的机器翻译文本,并将这些内容视为隐式重复。语料库通过来自新仓库、提交、库和框架的最新开源代码进行扩充,以覆盖更多编程语言并反映当前的软件工程场景。
- 多模态数据策展: 多模态数据集包含三种类型:图像-文本对、交错图像-文本数据和领域特定数据。作者优先对原始网页数据进行清洗,而非大规模合成。他们从 Common Crawl 重新引导了爬虫,以提高多模态来源的覆盖率。对于图像-文本对,他们提取带有相关替代文本的图像,应用图像-文本相关性阈值,并基于图像语义进行去重。交错数据由网页和 PDF 通过逐步昂贵的阶段构建:首先应用启发式和统计过滤、去重和质量模型;然后将幸存文档组装成交错序列,并进行图像感知过滤和去重;最后使用 SmolVLM 进行严格的质量评分。被过滤掉的文档部分回收为图像-文本对。添加领域特定数据集以改善细粒度视觉感知、OCR 和长尾知识,以及用于 agentic 理解的图像-代码对和计算机使用轨迹。
- 数据整合与去重: 最终训练语料是纯文本和处理后多模态数据的并集。对于重叠样本,作者用多模态版本替换纯文本版本,并使用较大的 epoch 数。替换后,语料库使用 7:1 的纯文本与多模态数据 token 比例。超长文档在混合前预先拆分以保证 token 分布均匀,最佳适配打包算法将填充率控制在至多 10⁻⁴。
后训练数据与环境构建
- 后训练流水线完全聚焦于模型训练所用的数据,而非优化算法。它合成多样化的、可验证的训练任务,并附带参考解和奖励信号,程序化构建交互式 agent 环境,并应用严格的过滤、去重和难度校准。
- 任务形式化: 每个任务是一个三元组(问题、环境、验证系统),并根据难度和正确性进行评估。这些信号用于迭代训练模型以构建更好的任务。强化学习任务生命周期受到监控,新强化学习运行中的轨迹为质量重新审计提供新的证据。
- 通用 Agent 环境: 由内部员工和外部合作伙伴使用最新模型自愿返回的交互数据构建。作者构建了模拟真实世界接口、API 模式和约束行为的模拟工具。负面反馈和失败案例被大规模收集并整合,以生成单轮和多轮 agent 环境,用于重放失败并使强化学习具有针对性。
- 编码 Agent 环境: 由两个来源构建:编码 agent 会话(过滤出复杂任务或表现不佳的会话,并按轨迹去重)以及满足星标数量阈值的公共 GitHub 仓库。环境构建涉及多个专门 agent:一个 agent 确定可构建性和可验证性,选择任务起点并设计评估点;另一个 agent 在隔离容器中设置依赖、测试代码和任务描述,并移除解泄漏;多个 agent 尝试完成任务,质量检查 agent 审查环境和轨迹以发现問題。修复 agent 在重新验证前修复错误并调整评估点。
- 使用方式: 通用和编码 agent 环境都输入统一训练系统,生成正确、有区分度且长度和难度可控的强化学习训练数据,在持续质量监控下推动模型的迭代改进。
方法
DeepSeek-V4.1-Flash 是一个多模态混合专家(MoE)Transformer,处理图像和文本并自回归生成文本。语言主干由 40 个因果 Transformer 层组成,结构为 20 层因果编码器后接 20 层解码器。多模态输入通路使用自定义视觉编码器 DeepSeek-ViT,以不同分辨率处理图像,采用 2D-RoPE 和 3x3 像素重排操作减少视觉 token 数量,再通过 MLP 投影器映射到语言主干的隐藏维度。该模型包含 552B 主干参数和 196B Engram 参数,预填充阶段每 token 激活 8B 参数,解码阶段激活 16B 参数。
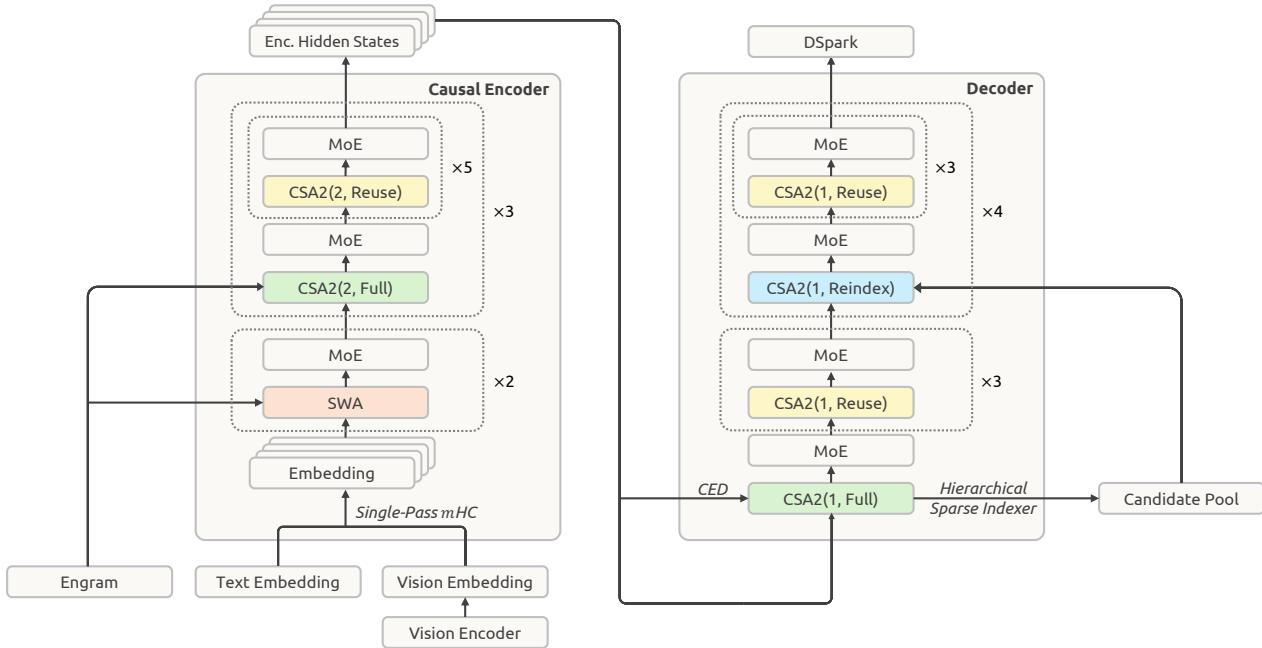
为解决长上下文推理的计算成本,作者引入了因果编码器-解码器(CED)架构和压缩稀疏注意力 2(CSA2)。CED 将底部 20 层视为因果编码器。对于解码器层(l>L/2),全局键值(KV)条目直接由最终编码器层的隐藏状态(HL/2)使用层相关的投影权重进行投影:
Cl=HL/2WlKV,Zl=HL/2WlZ,l>2L该设计有效将预填充计算减半。滑动窗口注意力(SWA)在所有层中逐层保留,以维护局部上下文。
CSA2 联合利用条目维度、序列维度和层维度来控制 KV 缓存存储和注意力计算。每个 CSA2 层被静态分配三种操作模式之一:Full、Reindex 或 Reuse。
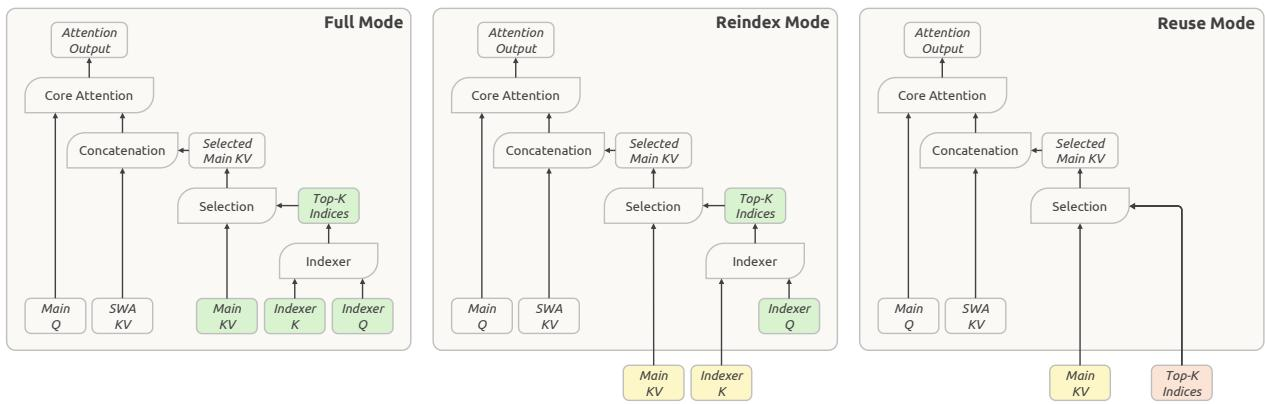
在 Full 模式下,该层计算自己的主 KV、索引器 Q 和索引器 K,运行索引器生成全新的 Top-K 索引。Reindex 模式复用最近 Full 模式层的主 KV 和索引器 K,使得稀疏选择可以跨层变化,同时共享缓存。Reuse 模式复用来自前一层的主 KV 和 Top-K 索引,执行注意力时无需计算新的索引器查询或评估索引分数。这种跨层复用显著减少了缓存存储和索引器计算。
为进一步降低极长上下文中索引的计算瓶颈,作者引入了层次化稀疏索引器,该索引器仅在解码器中运行。
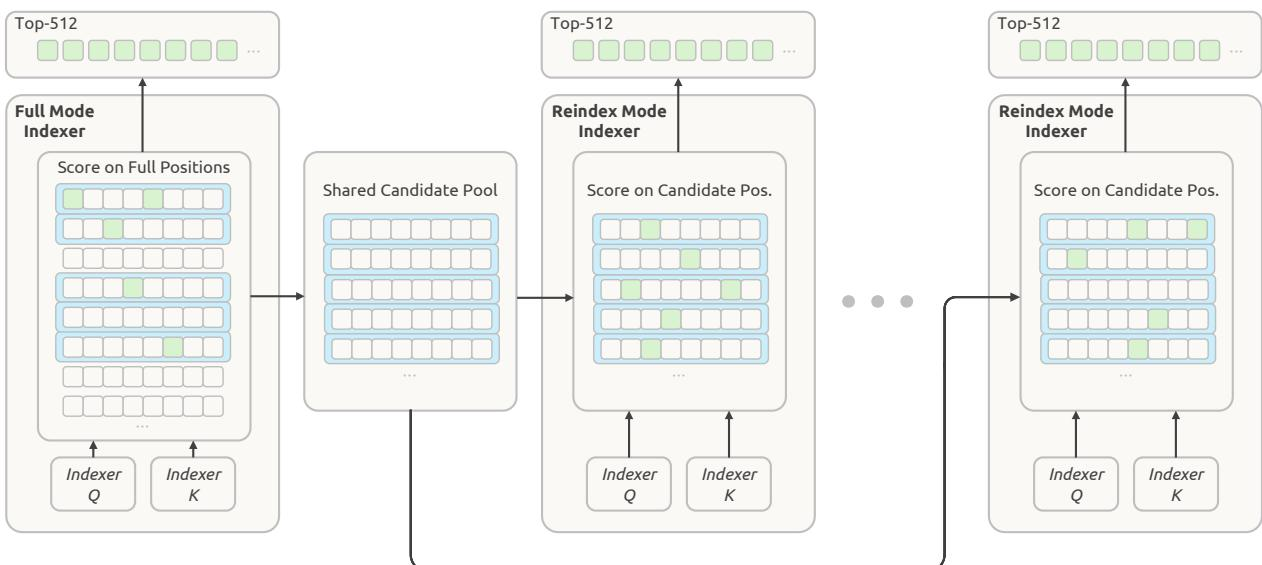
第一个被分配为 Full 模式的层对所有因果可见的主 KV 位置进行评分,并执行分块候选选择。它将所选块覆盖的位置收集到共享候选池中。后续处于 Reindex 模式的层仅对候选池内的候选位置进行评分,而非整个上下文,从而使更深索引器的每查询成本从上下文长度的线性关系变为常数。
作者实现了多项优化以提升效率。Single-Pass mHC 将输入混合系数移动一个块,使残差更新、输入混合和系数预测能够融合到单个内核中,将激活内存流量减半。Engram 添加了稀疏访问的条件记忆,将记忆与计算解耦,利用 n-gram 阶数和多哈希 FP8 精度。DSpark 作为投机解码模块,将半自回归草拟与置信度调度验证相结合,并在主干预训练后的专门阶段进行训练。此外,主 KV 缓存在后训练期间通过量化感知训练压缩为 FP4,将存储占用减少近一半,且无需该格式的原生矩阵乘法支持。
训练过程利用逐头 Muon 优化 Query 和 Key 权重,为不同注意力头提供不同的预条件器,以应对异质性。为减少大型 Engram 嵌入表的优化器状态内存占用,作者采用基于动量的更新后接 Sinkhorn 平衡,该平衡使更新矩阵的行方向和列方向 RMS 均等化。
后训练流水线遵循监督微调后接强化学习(RL)和同策略蒸馏的标准范式。作者专注于用于数据合成和环境构建的大规模自动化流水线。他们将任务形式化为问题、环境和验证系统的三元组,并使用难度和正确性作为奖励信号,迭代训练模型为通用和编码 agent 构建更好的任务。
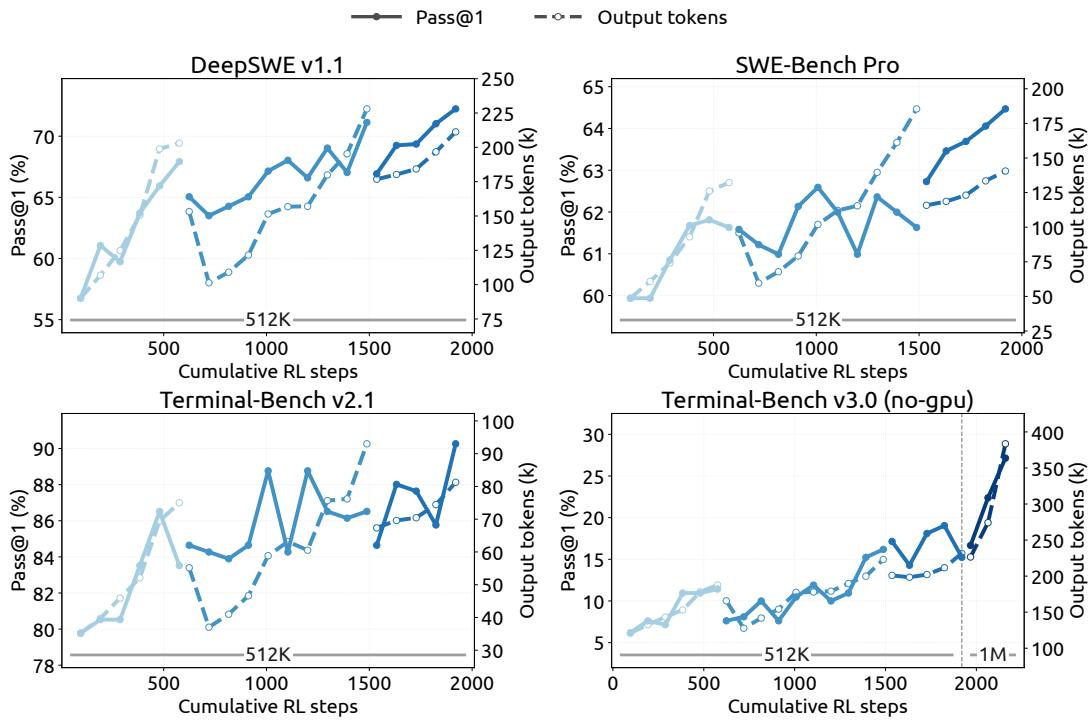
为提升模型在复杂场景中的性能,作者在合成任务中采用大规模异步强化学习。他们将 agent rollout 执行解耦为 agent 沙箱和工作容器,由 DeepSeek 弹性计算(DSec)平台管理,该平台利用分片和宽松一致性调度可扩展到数百万个并发沙箱实例。
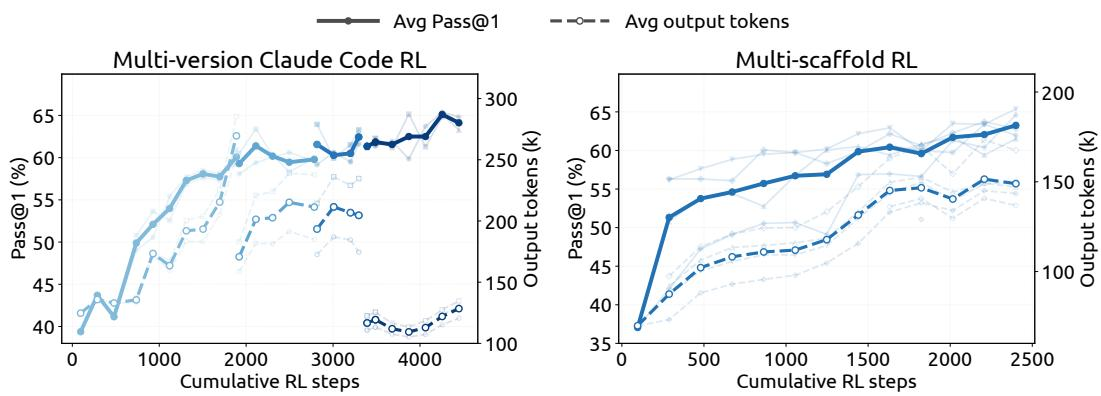
随着累积强化学习步数的计算规模扩大,性能持续提升,无论是在单一脚手架内、同一脚手架的不同变体之间,还是在异构脚手架之间。为将有效强化学习计算扩展到单次运行之外,作者使用模型合并来重新初始化连续的强化学习运行,结合来自不同优化路径的改进。此外,在强化学习期间引入标量努力水平作为显式条件信号,使模型能够在部署时动态调整推理强度和 token 预算。异步后训练基础设施通过样本级调度维持高 rollout 并发性,并通过每数据集并发限制和过期 token 的损失掩码来缓解长度偏差和离策略效应。
实验
评估涵盖预训练、后训练和基础设施实验。跨世界知识、推理、编码、长上下文和多模态任务的预训练基准测试表明,DeepSeek-V4.1-Flash 尽管比 DeepSeek-V4-Pro 激活更少的参数并使用更少的 KV 缓存,但在大多数维度上表现相当或更好。后训练评估侧重于推理和 agentic 能力,DeepSeek-V4.1-Flash 在代码、网络安全、通用和视觉 agent 任务上显著优于其前代产品,达到或超过顶级开源和专有模型。推理努力控制允许平滑的精度-延迟权衡,大多数增益集中在较低预算下。跨多种 agent 脚手架的鲁棒性测试表明性能迁移良好,初步的多 agent 协作实验在时间截止条件下展示了对单 agent 基线的持续优势。
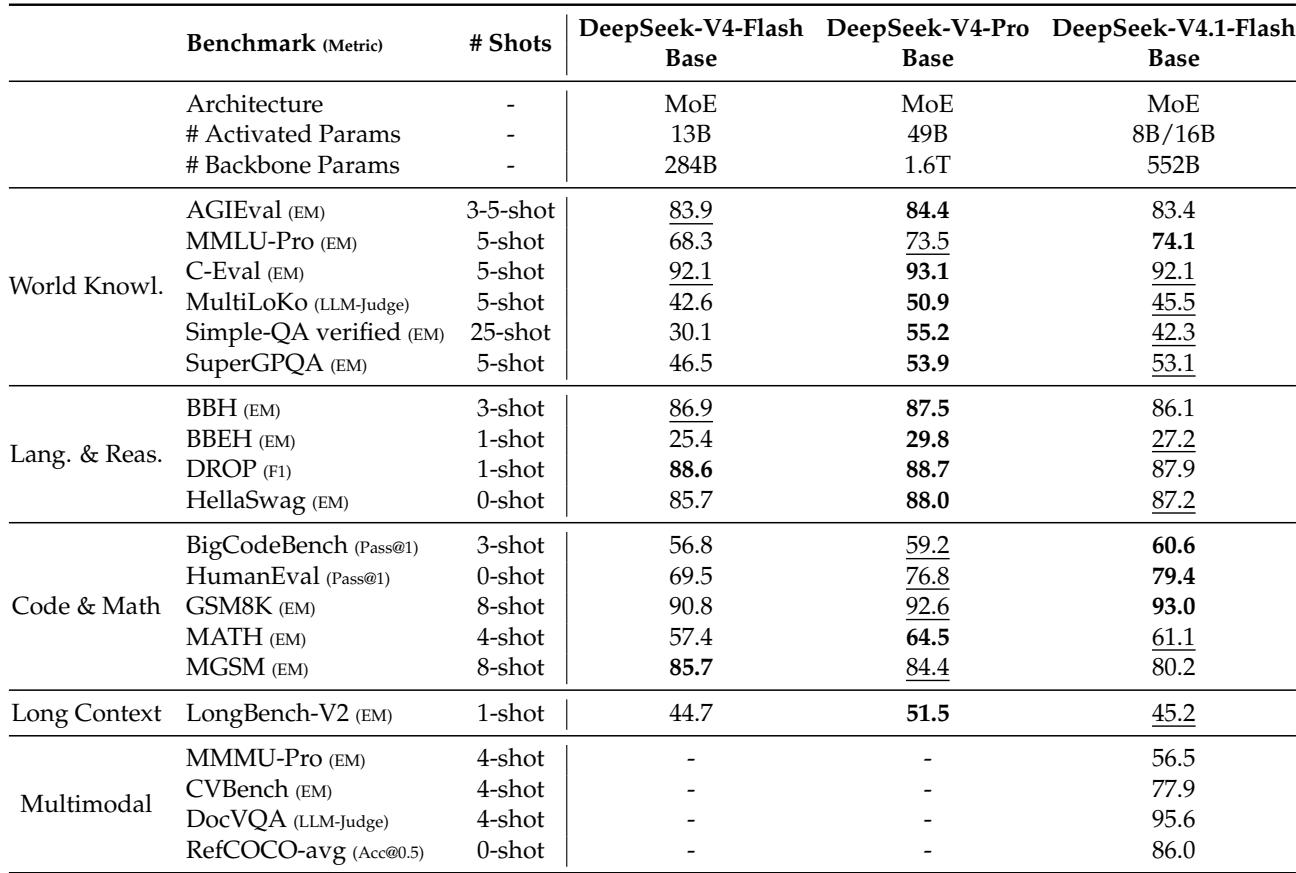
DeepSeek-V4.1-Flash-Base 在大多数世界知识基准测试上匹配或超过更大的 DeepSeek-V4-Pro-Base,同时激活的参数更少且 KV 缓存更小。尽管两者都是 MoE 架构,新模型相比旧版 Flash 变体也显示出显著的效率优势。DeepSeek-V4.1-Flash-Base 激活 8B/16B 参数,而 DeepSeek-V4-Pro-Base 激活 49B 参数,但前者在 MMLU-Pro 上得分更高。在 MMLU-Pro 上,DeepSeek-V4.1-Flash-Base 以 74.1 领先,超过 DeepSeek-V4-Pro-Base 的 73.5。DeepSeek-V4.1-Flash-Base 在 AGIEval 和 C-Eval 上持平或略有落后,但差距在视为相等的 0.3 阈值之内。DeepSeek-V4.1-Flash-Base 在 MMLU-Pro 和 MultiLoKo 上优于 DeepSeek-V4-Flash-Base,表明尽管激活量相似或更低,世界知识有所改善。
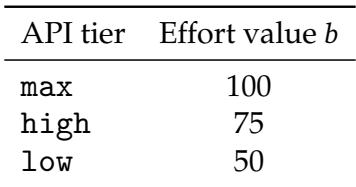
该表定义了公共 API 推理努力层如何映射到标量努力值,最大层设为 100,高层设为 75,低层设为 50。该映射为用户提供了直接控制模型推理程度的接口。底层努力水平在强化学习期间用作条件信号,影响单轮和多轮任务。最大 API 层对应努力值 100,代表最高水平的推理彻底性。高层和低层分别映射到努力值 75 和 50,提供清晰的推理强度阶梯下降。努力水平通过系统提示显式输入到模型中,允许用户调整成本-质量权衡。
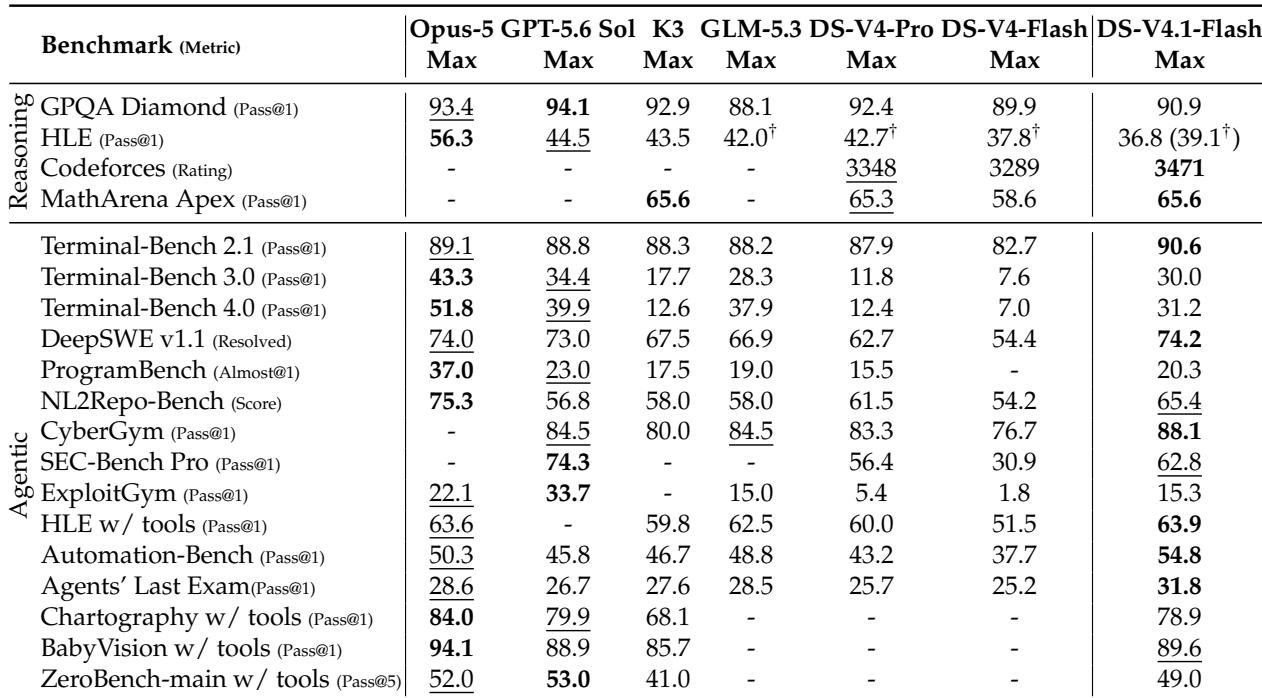
DeepSeek-V4.1-Flash 相对其前代产品显示出持续增益,并在推理和 agentic 基准测试上匹配或超越顶级开源和闭源模型。其最引人注目的改进出现在 agentic 任务中,在多项指标上超越领先的专有系统。在视觉 agent 任务中,它领先开源模型,但仍落后于最佳闭源替代方案。Codeforces 评分从 DeepSeek-V4-Flash 的 3289 提升至 3471,但未提供任何模型的比较值。在 MathArena Apex 上匹配最佳开源得分(65.6%),并略微超越 DeepSeek-V4-Pro(65.3%)。Agentic 增益显著:Deep-SWE v1.1 从 54.4% 跃升至 74.2%,超过 Opus-5 和 GPT-5.6 Sol。Terminal-Bench 2.1 达到 90.6%,领先 Opus-5(89.1%)和 GLM-5.3(88.2%)。在网络安全任务中,它开创了开源模型中的新最优水平。视觉 agent 性能超越领先的开源 Kimi-K3,但仍低于顶级闭源系统。
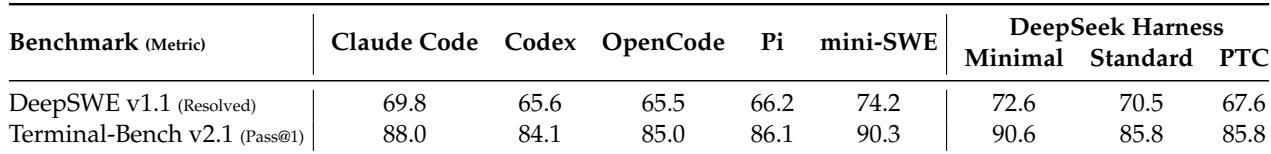
跨八种 agent 脚手架,DeepSWE v1.1 和 Terminal-Bench v2.1 的性能保持高位,最佳结果由 mini-SWE 和 DeepSeek Harness Standard 模式在 DeepSWE 上取得,以及 DeepSeek Harness Minimal 和 mini-SWE 在 Terminal-Bench 上取得。各脚手架之间的差异适中,表明 agentic 能力在不同 harness 设计间的稳健迁移。mini-SWE 在 DeepSWE 上实现最高解析率 74.2%,紧随其后的是 DeepSeek Harness Minimal 的 72.6%。在 Terminal-Bench 上,DeepSeek Harness Minimal 和 mini-SWE 以约 90% 的 Pass@1 持平最佳成绩,而 Claude Code 以 88.0% 落后。不同脚手架间的性能差异在 DeepSWE 上约为 9 个百分点,在 Terminal-Bench 上约为 7 个百分点,表明对脚手架选择的敏感性有限。
DeepSeek-V4.1-Flash-Base 提供与更大的 DeepSeek-V4-Pro-Base 相当或更优的世界知识性能,同时使用更少的激活参数和更小的 KV 缓存,在 MMLU-Pro 上增益显著,在其他方面接近持平。完整的 Flash 模型相对其前代产品表现出强劲改进,尤其在 agentic 任务中,在软件工程和终端基准上超越领先的专有系统,但在视觉 agent 任务中仍落后于闭源模型。跨多种 agent 脚手架,性能保持高位且差异适中,表明 agentic 能力的稳健泛化。