Command Palette
Search for a command to run...
AI 在科学中的应用:早期见解
AI 在科学中的应用:早期见解
摘要
科学进步是经济增长与繁荣的关键驱动力。关于人工智能对科学的影响,人们充满期待,但也存在担忧,然而迄今为止相关数据甚少。我们基于三个数据来源提供早期见解:1500 万次 Gemini 交互的样本、跨学科 2600 多个专用 AI 模型的清单,以及 600 多名科学家的调查。我们将这些数据映射到一个新的科学任务分类体系,以研究科学家如何使用 AI。主要发现有四方面。第一,我们发现广泛的采用和覆盖:科学家使用 AI 的频率高于大多数其他职业。专用 AI 模型具有广泛的学科覆盖且被高度引用。近一半受访科学家报告每天使用某种形式的 AI。第二,我们记录了证据表明 LLM(以 Gemini 使用为代表)和专用模型互为补充——LLM 用于一般分析、编码和手稿准备,而专用模型提供领域特定的预测、数据生成和分类。第三,科学家报告了使用 AI 带来的显著生产力提升:每周节省近 7 小时,这些时间主要再投资于更多研究。最后,我们表明 AI 已经在改变科学过程。随着科学研究的某些阶段变得更容易,瓶颈向下游转移。科学家报告未测试假设的积压增加,以及对输出验证的大量需求。我们的发现表明,AI 在提高科学生产力方面具有巨大潜力。然而,与其他部门一样,其最终影响将受制于复杂的任务相互依赖关系以及对消除新兴瓶颈的投资。
一句话总结
来自谷歌、谷歌DeepMind、芝加哥大学、CUNEF Universidad、MIT FutureTech、牛津大学、卡内基梅隆大学和宾夕法尼亚大学的研究人员分析了15×106次Gemini交互、超过2600个专用AI模型以及600名科学家的调查数据,揭示了AI在各学科中的广泛采用、LLM与专用模型之间的互补性、每周近7小时的生产力节省被重新投入研究,以及下游瓶颈,如未经检验的假设和输出验证需求。
核心贡献
- 利用三个互补数据源,对科学领域AI采用情况进行了早期实证分析:150万次Gemini交互、超过2600个专用AI模型的清单,以及600多名科学家的调查,所有数据均映射到一个新的科学任务分类体系。
- 记录了通用LLM与专用模型之间互补的分工模式,表明LLM处理通用分析、编码和稿件准备,而专用模型提供领域特定的预测、数据生成和分类。
- 量化了生产力提升和新兴瓶颈:科学家报告每周节省近7小时,并将大部分时间重新投入研究,但近90%的用户将节省时间中的相当一部分用于验证AI输出,且未经检验的假设积压日益增多,表明下游工作流程存在约束。
引言
科学进步长期以来一直是经济增长的驱动力,但近期对研究生产力下降的担忧引发了人们对AI能否扭转这一趋势的兴趣。尽管AlphaFold等专用模型已展现出诺贝尔奖级别的潜力,但关于AI对科学影响的争论主要依赖论文和专利等滞后指标,缺乏研究人员实际如何使用这些工具的实时证据。
作者通过结合三个互补数据源来填补这一空白:1500万次Gemini交互、来自超过2600个专用AI模型的文献计量数据,以及600多名科学家的调查。他们将所有数据映射到MIT FutureTech开发的新科学任务分类体系,从而能够在各学科之间进行任务级分析。先前的工作缺乏这种粒度,因为O*NET等现有分类体系将定义研究活动的领域特定任务扁平化,而前沿AI实验室的遥测数据此前也未聚焦于科学工作流程。
主要贡献是对科学领域AI采用情况的多源实证快照。分析表明,科学家在AI使用方面领先于其他职业,LLM与专用模型作为互补品存在明确分工,且尽管研究人员报告了可观的时间节省,但在物理实验和验证方面仍存在瓶颈。作者还记录了一个令人担忧的趋势:近一半受访科学家表示AI促使他们转向更安全、渐进式的项目,而非高风险发现,这凸显了一种潜在的“路灯效应”,即AI降低了渐进式工作的成本,却未推进科学前沿。
数据集
数据集构成与来源
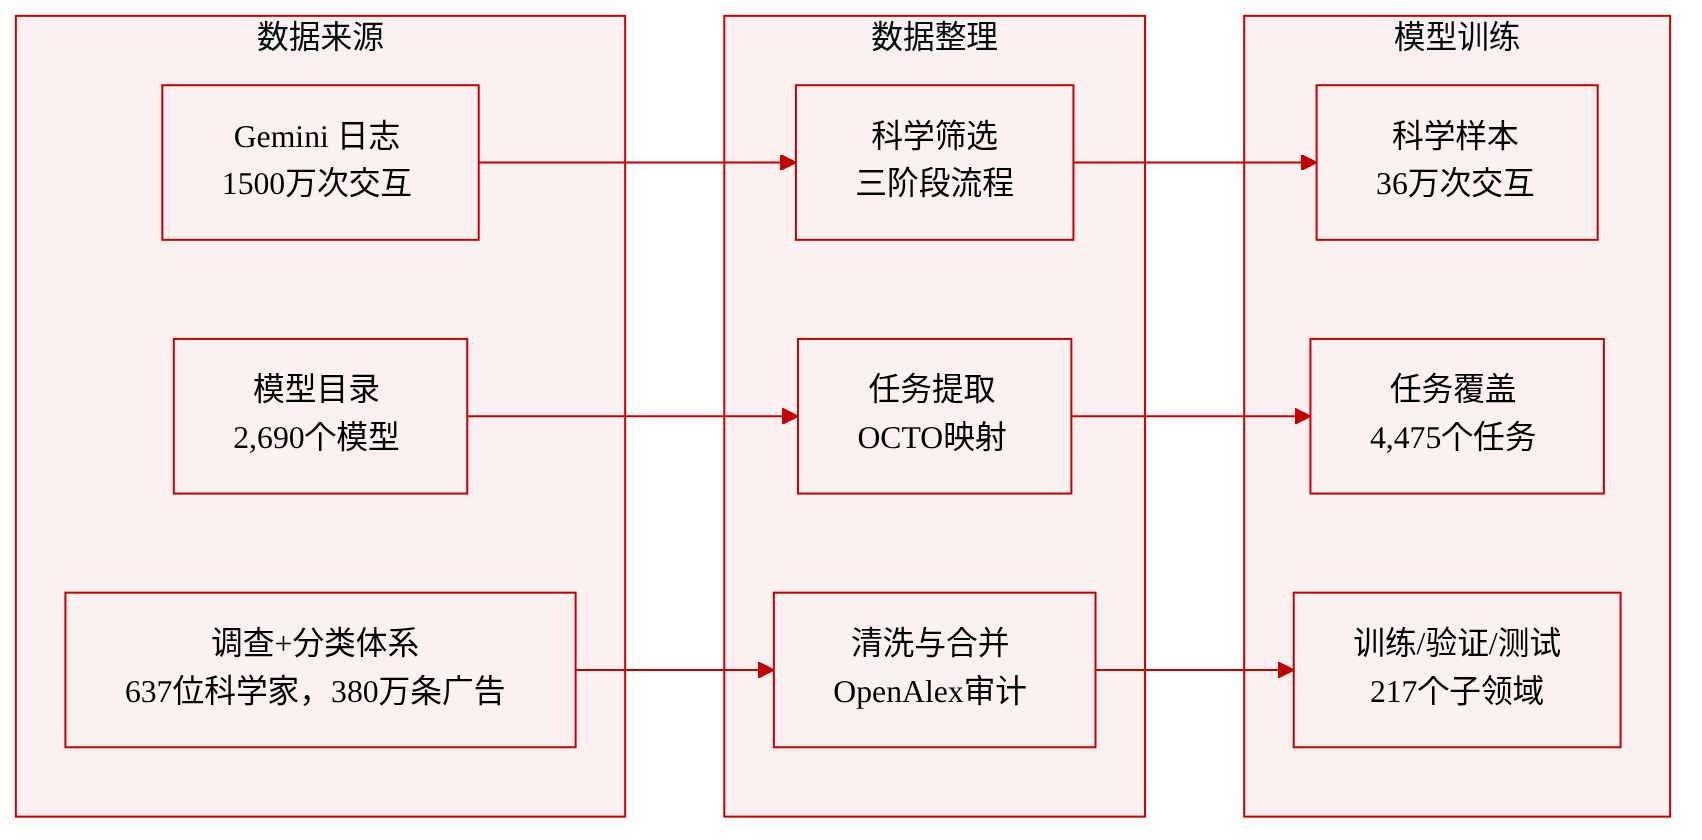
作者结合五个互补数据源来评估科学领域的AI应用:
- Google ATLAS 1.0语料库:来自Gemini App、Google AI Mode和API接口的约1500万次匿名用户交互,采样于2026年4月初。
- 科学专用AI模型清单:通过跨科学数据库和文献的智能搜索,整理出2690个值得关注的科学AI模型,并由Epoch AI基础模型数据库补充,同时利用OpenAlex的论文、引用和机构元数据进行丰富。
- 科学家调查:由第三方供应商通过More in Common在线面板于2026年7月27日至8月11日开展,覆盖美国和英国637名在职科学家。
- MIT FutureTech科学任务分类体系:基于2010年后发布的约380万条Lightcast(2026)科学研究岗位招聘广告构建。
- OpenAlex论文数据库:提供科学作品文献计量记录的元数据,包括发表日期、作者单位、资助来源、引用和概念分类。
各子集的关键细节
- Gemini交互日志:作者通过三阶段过滤流程来识别科学用例。首先,利用ATLAS的工作与非工作分类器剔除非工作交互。其次,应用ATLAS的职业预测,将样本限制在涵盖物理、生命、社会、计算机、工程和健康学科的六个两位标准职业分类(SOC)类别中。第三,应用自定义的“科学”分类器,该分类器操作化了对科学的定义。最终从初始1500万次交互中筛选出约36万次科学交互。
- 专用模型清单:清单包括领域特定AI模型(蛋白质结构预测、基因组模型、神经气候模型)和深度学习模型(神经网络、扩散模型、视觉Transformer),这些模型可能有助于科学发现。作者排除了通用统计机器学习(正则化回归、随机森林)和通用软件或机器学习框架(PyTorch、TensorFlow)。模型发布于2012年之后并关联到代码仓库。该清单覆盖OpenAlex分类体系中全部26个科学领域和83%的子领域。
- 科学家调查:参与者根据四项标准被认定为科学家,包括其主要工作直接涉及科学与技术、临床或健康研究、生命科学或社会科学研究。调查收集了人口统计信息、研究领域、AI采用强度、研究任务时间分配、AI预期节省时间,以及对跨学科性和瓶颈的感知影响。
- MIT FutureTech科学任务分类体系:流程从科学岗位招聘广告中提取超过6400万个任务实例,将语义等价实例整合为约21万个代表性任务,并组织到包含12个一级领域、114个二级领域和2433个三级组别的全局分类体系中。该层级结构通过高维任务嵌入的层次聚类和LLM分析构建。
- OpenAlex:作者对元数据进行审计和清理,以解决OpenAlex分类中的已知问题,例如其倾向于将计算和数据驱动型论文过度归类到计算机科学下。
论文如何使用数据
- 分类与映射:作者使用OCTO流程,该流程整合向量嵌入、聚类算法和前沿Gemini LLM,将非结构化文本映射为结构化表示。OCTO将Gemini交互日志和论文摘要同时映射到MIT FutureTech科学任务分类体系和OpenAlex学科层级。
- 分类体系过滤:作者将分析聚焦于217个在商业和非商业部门均存在研究活动的科学子领域,覆盖92%的OpenAlex作品和96.5%的引用。他们排除了非研发子领域,并对领域边界不清晰的其他子领域进行聚合。
- 任务提取:对于专用模型,作者使用OCTO从论文摘要中提取4475个任务,采用与MIT FutureTech科学任务分类体系相同的动词/对象/上下文结构进行格式化。他们将这些任务映射到分类体系,以了解哪些任务和领域可能受益于专用模型的输出。
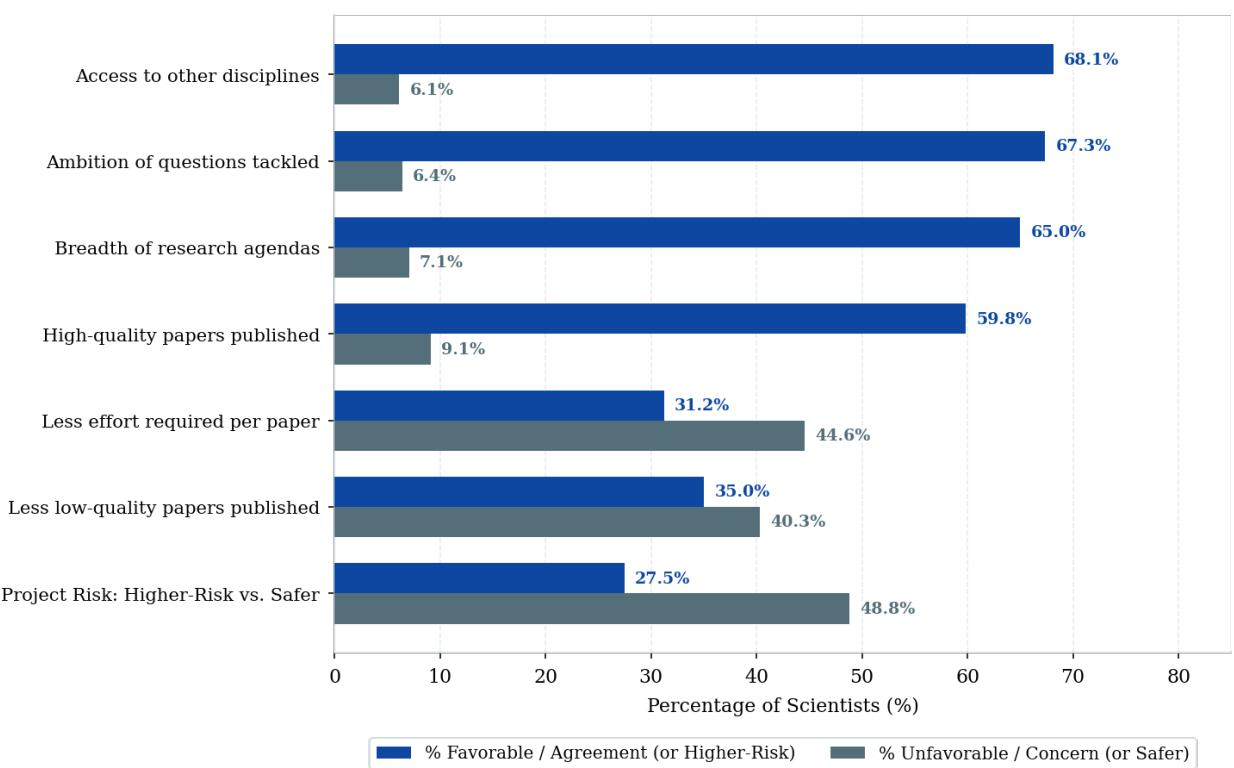
- 调查分析:调查数据用于评估AI更广泛的经济和组织影响,包括研究过程中的瓶颈、验证成本,以及对研究问题雄心和质量的感知影响。
处理细节
- 科学定义:作者采用广泛的科学定义,涵盖学术、产业、非营利和政府角色,并将科学定义为任何通过调查、计算、实验或理论工作可能产生新知识的活动。
- 职业过度代表性:作者计算了职业过度代表性比率,将某职业群体在Gemini对话量中的占比与其在美国就业中的基线占比进行比较。研究密集型职业群体的Gemini交互量比其劳动力占比高出约1.8倍。
- 科学交互特征:与平均工作对话相比,科学交互的多模态程度高出约7%,token使用量高出19%,对话轮数高出11%,领域专业度得分高出26%。
- 任务覆盖率:作者发现分类体系中17.6%的三级任务被清单中的模型覆盖,排除不太可能出现在论文摘要中的运营和教学任务后,覆盖率升至24.3%。
方法
作者利用一套综合方法论来量化科学领域的AI参与度,采用两条不同的数据流和统一的分类框架。
Gemini交互日志过滤流程 为从包含约1500万次匿名用户交互的Google ATLAS 1.0语料库中识别科学用例,研究人员实施了三阶段过滤流程。第一阶段使用工作与非工作分类器,剔除与个人、休闲或教育相关的交互。第二阶段将样本框架限制在六个研究活动集中的标准职业分类类别中,包括物理、生命、社会、计算机、工程和健康学科。最后阶段对交互内容和上下文应用自定义科学分类器,识别可能代表科学工作流程的交互。该流程最终产出约36万次科学特定交互的语料。
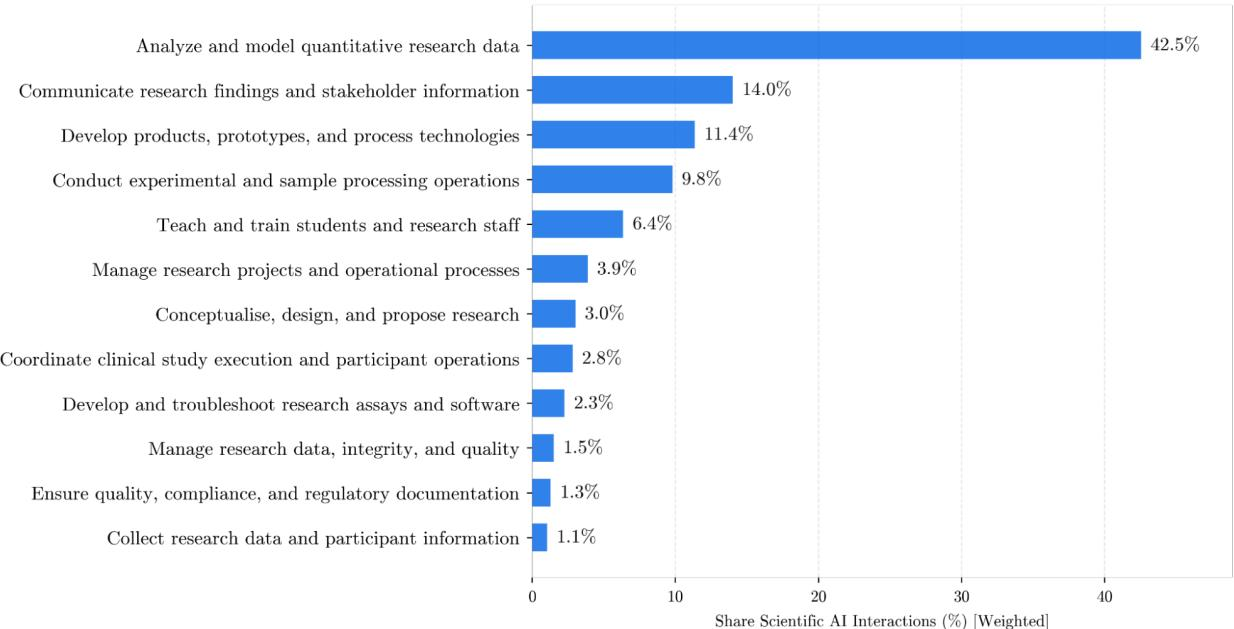
随后,作者使用OCTO分类框架将该语料映射到OpenAlex学科层级和MIT FutureTech科学任务分类体系。如下方图所示,这些交互在高层任务类别中的分布表明,定量数据分析和建模占据高度集中。
科学专用AI模型清单构建 除通用LLM外,作者还构建了一个包含2690个科学专用AI模型的精选清单。该清单通过跨科学数据库和文献的智能搜索整理而成,由Epoch AI基础模型数据库补充,并利用OpenAlex的论文和引用元数据进行丰富。选择范围包括领域特定模型和深度学习架构,同时排除通用统计机器学习和软件框架。
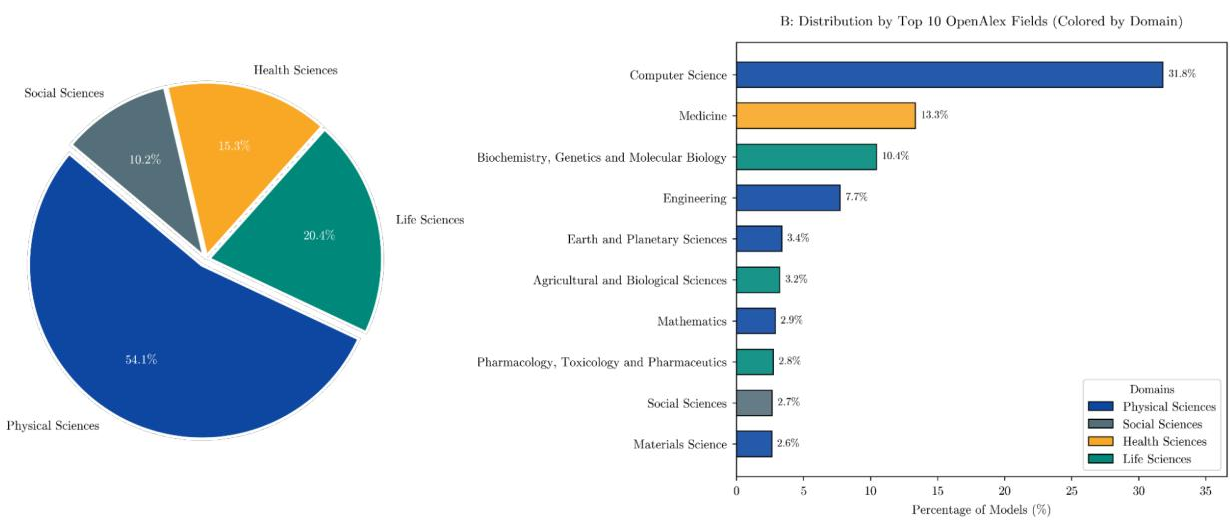
这些模型在科学领域中的分布十分广泛。如框架图所示,物理科学和计算机科学在清单中占主导地位,但生命与健康科学也占据显著份额,特别是在生物化学、遗传学和分子生物学等领域。
任务提取与分类体系映射 为评估专用模型的下游能力,作者利用OCTO语义分类工具从代表性论文的摘要中提取任务。这些任务采用动词、对象和上下文的结构进行格式化,并映射到MIT FutureTech科学任务分类体系。提取过程识别出超过4475个任务,关联到200多个独特动作。
动作动词的分析揭示了不同科学领域中不同的使用模式。专用模型主要用于预测、生成和分类,但领域异质性反映了特定用例,如医学中的分割或数学中的数学证明求解。
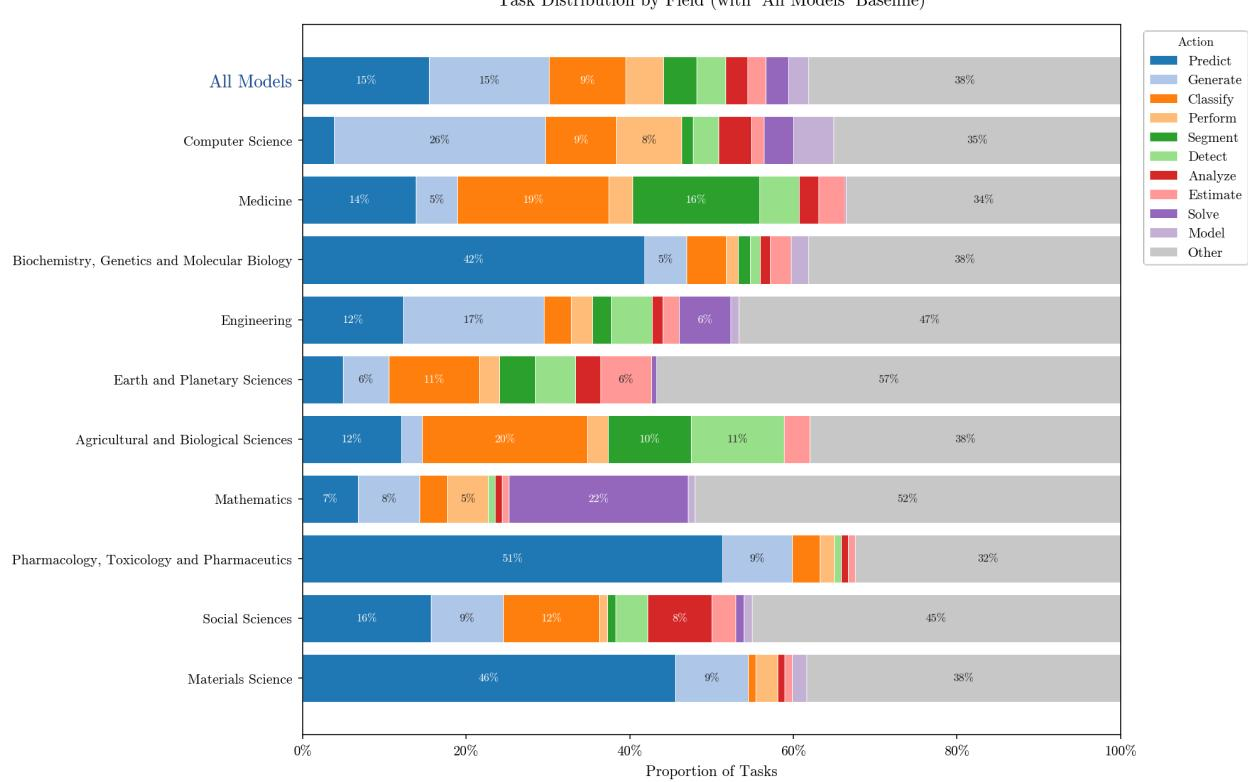
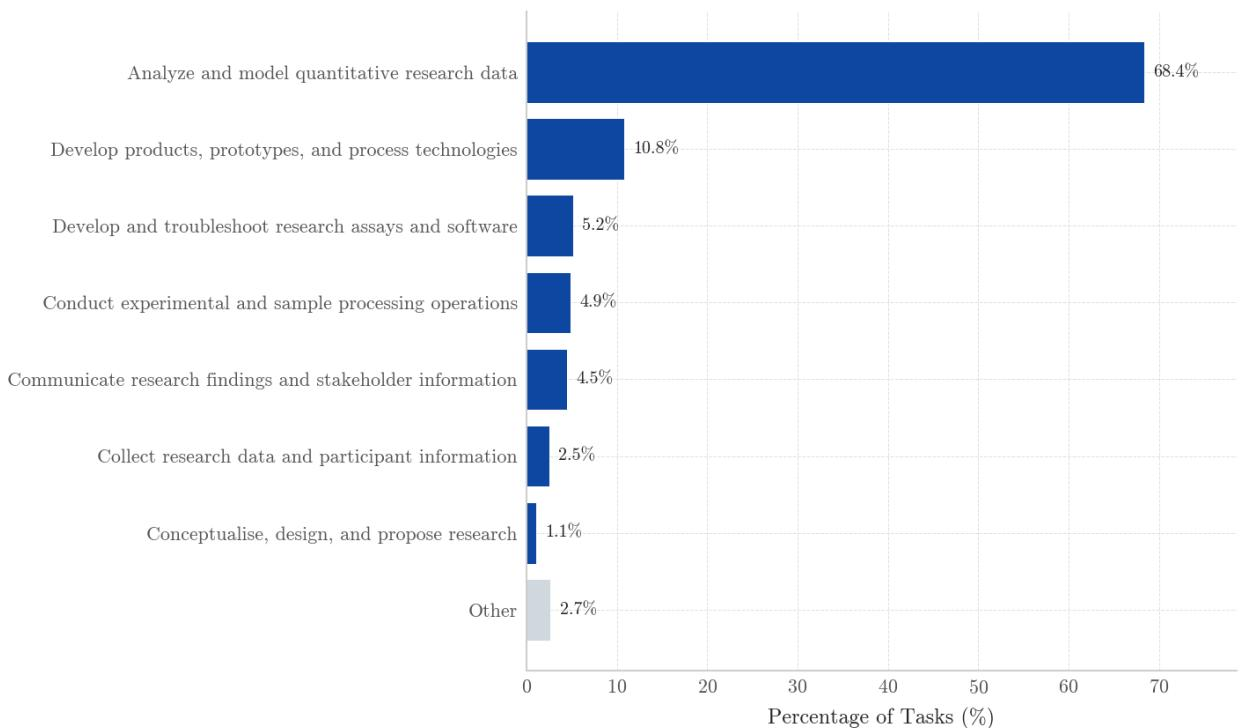
在将这些提取的任务映射到MIT FutureTech科学任务分类体系时,作者发现清单中的能力覆盖了近四分之一的实际研究任务。分类体系最高层最常见的任务类别是定量数据的分析和建模,这与专用模型在预测和模拟数据以供下游分析中的主要角色一致。
实验
实验通过结合Gemini交互日志、专用模型清单和调查数据来分析科学领域的AI采用情况。结果表明,LLM的使用几乎覆盖所有科学子领域,其中物理科学和计算机科学领先,使用规模与研究人群规模成比例。任务分析显示,尽管通用LLM和专用模型都集中于数据分析,但它们在细粒度层面作为互补品运作,专用模型处理领域特定的预测和模拟。调查数据印证了这一图景,显示大多数研究人员每周使用AI,并报告净时间节省被重新投入更高产出,但AI输出的验证和任务瓶颈在一定程度上抵消了生产力提升。
LLM在科学领域的采用因学科而异,每个领域相对于平均研究人员活动都表现出不同的过度代表和不足代表的任务类型。健康与生命科学偏向临床和实验任务,而计算机科学和物理科学偏向软件、数据分析和原型制作任务。健康科学在临床研究协调方面的相对使用量高出近五倍,合规和监管文档也过度代表。生命科学在实验和样本处理任务方面的相对使用量高出三倍以上。计算机科学在软件故障排除和定量数据分析方面过度代表,而物理科学在原型和工艺技术方面过度代表。社会科学在数据收集、教学和项目管理方面过度代表,但在实验和产品开发任务方面不足代表。临床研究协调在计算机科学、物理科学和生命科学中持续不足代表,而实验操作在计算机科学和社会科学中不足代表。
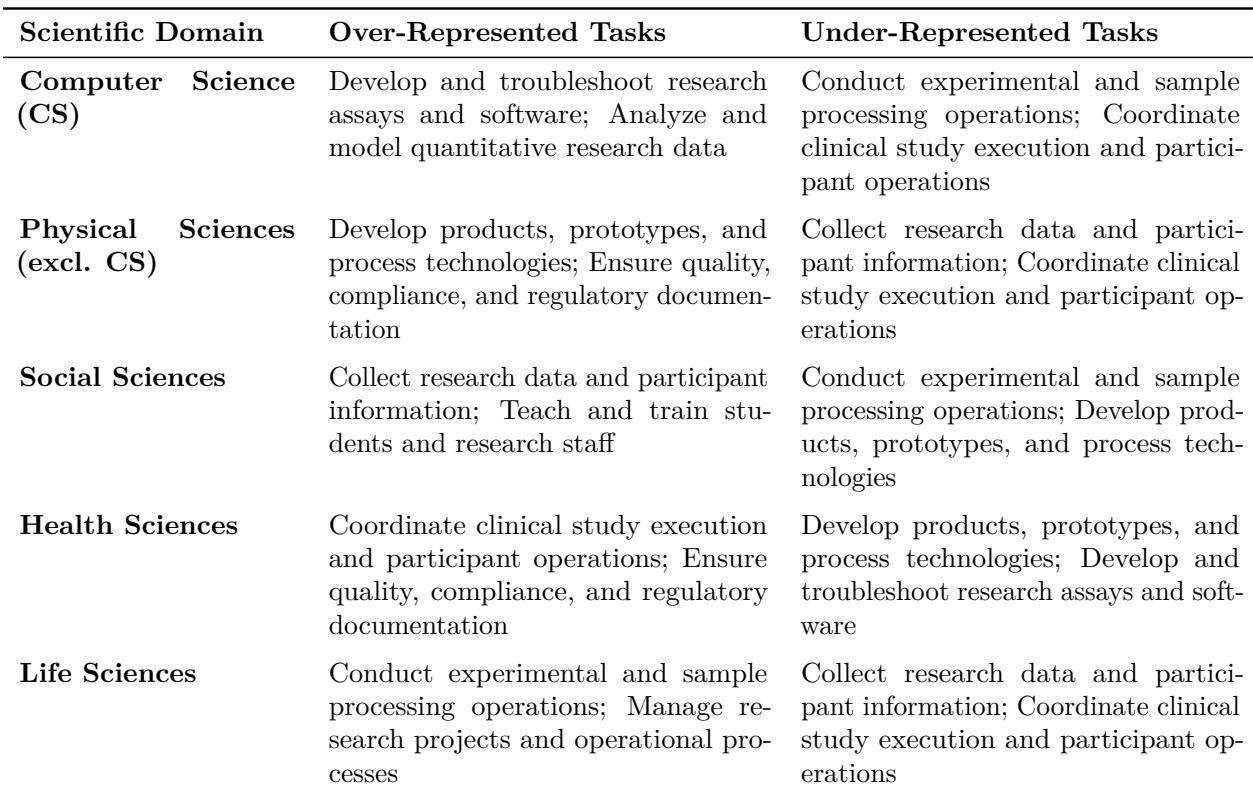
对LLM跨学科采用情况的分析揭示了不同的任务级专业化模式。健康与生命科学在临床、实验和合规相关任务中表现出强烈的过度代表,而计算机科学和物理科学偏向软件、数据分析和原型制作。社会科学在数据收集、教学和项目管理方面过度代表,但在实验工作方面不足代表。值得注意的是,临床研究协调在计算机科学、物理科学和生命科学中持续不足代表,而实验操作在计算机科学和社会科学中不足代表。