Command Palette
Search for a command to run...
Sage-A1.5:从长程执行到基于能力组合的科学探索
Sage-A1.5:从长程执行到基于能力组合的科学探索
摘要
在本报告中,我们介绍了 Sage-A1.5,一个 35B 专家混合(MoE)智能体模型,该模型在 A1 的基础上通过自适应能力组合推进长程问题求解。与 A1 相比,Sage-A1.5 不仅学会解决单个任务,还学会在执行过程中组织工作并修正其方法。Sage-A1.5 凸显了三项改进:智能体编排、验证和开放科学发现。首先,智能体编排通过任务委派以及具有隔离上下文的子智能体之间的并行协作来扩展单智能体执行,使复杂任务能够被分解并同时处理,在降低并发子智能体之间干扰的同时支持高效执行。其次,智能体验证通过进度检查、证据验证和反思性策略修正来增强长程可靠性,使智能体能够识别无效的搜索路径并寻求替代方法。第三,开放科学发现将智能体能力从回答预定义问题扩展到开展探索性研究,将科学探究与交互式分析和可检查的研究产物连接起来。我们通过复杂的智能体任务和多学科科学应用展示了这些能力。此外,我们希望 Sage-A1.5 为社区提供一个可访问的开放科学发现基础,提供一条从长程任务执行到协作式、可验证且可检查的科学探索的实用路径。
一句话总结
上海人工智能实验室 Sage-A1.5 团队推出 Sage-A1.5,一个 35B 混合专家(Mixture-of-Experts)agentic 模型,通过自适应能力组合扩展 A1,借助 agentic 编排、验证和开放科学发现推进长程执行,以实现可验证、可检查、多学科探索。
核心贡献
- 自适应 Agentic 执行将 Agentic 编排和 Agentic 验证集成到 Sage-A1.5 的执行策略中,使 subagent 在隔离上下文下进行任务委派和并行协作,并在长程问题求解过程中进行证据驱动的自我纠正。
- 统一的后训练流程将多领域监督微调与混合奖励强化学习相结合,把跨领域、跨推理模式和跨 agent 工具框架的能力融合到一个 35B 混合专家 agentic 模型中。
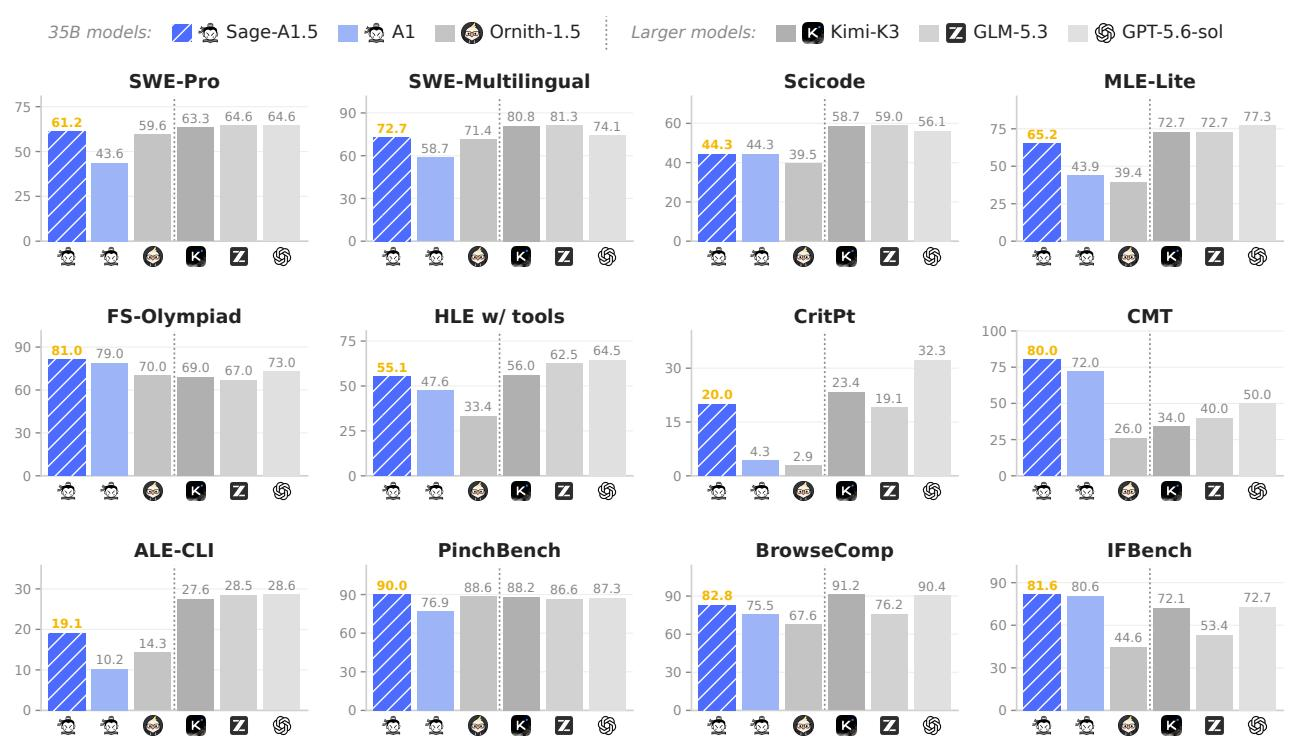
- 基准评测和科学案例研究表明了 Sage-A1.5 的开放科学发现能力。在 FrontierScience-Olympiad、CMT、PinchBench 和 IFBench 上,Sage-A1.5 超过 Kimi-K3、GLM-5.3 和 GPT-5.6-sol 等更大模型;在 SWE-Bench Pro 和 BrowseComp 上保持竞争力;并在全部十二项基准上达到或超过同等规模的 Agents-A1 和 Ornith-1.5。
引言
作者关注软件工程、机器学习优化和科学研究等长程 agentic 任务,这些任务的成功取决于管理相关子任务、比较不同方法,并在出现新证据时修正决策。早期的 agent 模型,包括作者早期的 Agents-A1 35B MoE 系统,通过扩增上下文长度改善了长程表现,但逐步工作的单一 agent 仍面临上下文不断增长、探索缓慢以及错误影响后续决策的问题。此外,更长的执行并不一定可靠地改善结果,因为多个 agent 可能重复无效搜索、基于未经证实的假设继续推理,或过早接受结论。为解决这一问题,作者提出了 Sage-A1.5,一个基于 Agents-A1 构建的 35B MoE agent 模型,该模型学习 Agentic 编排以拆分和委派并行子任务,并学习 Agentic 验证以在没有外部监督者的情况下审查证据并调整动作。贡献包括自适应 Agentic 执行策略、统一的监督微调与混合奖励强化学习流程,以及基准评测;评测表明 Sage-A1.5 在多个 agentic 和科学推理基准上优于大得多的模型。
数据集
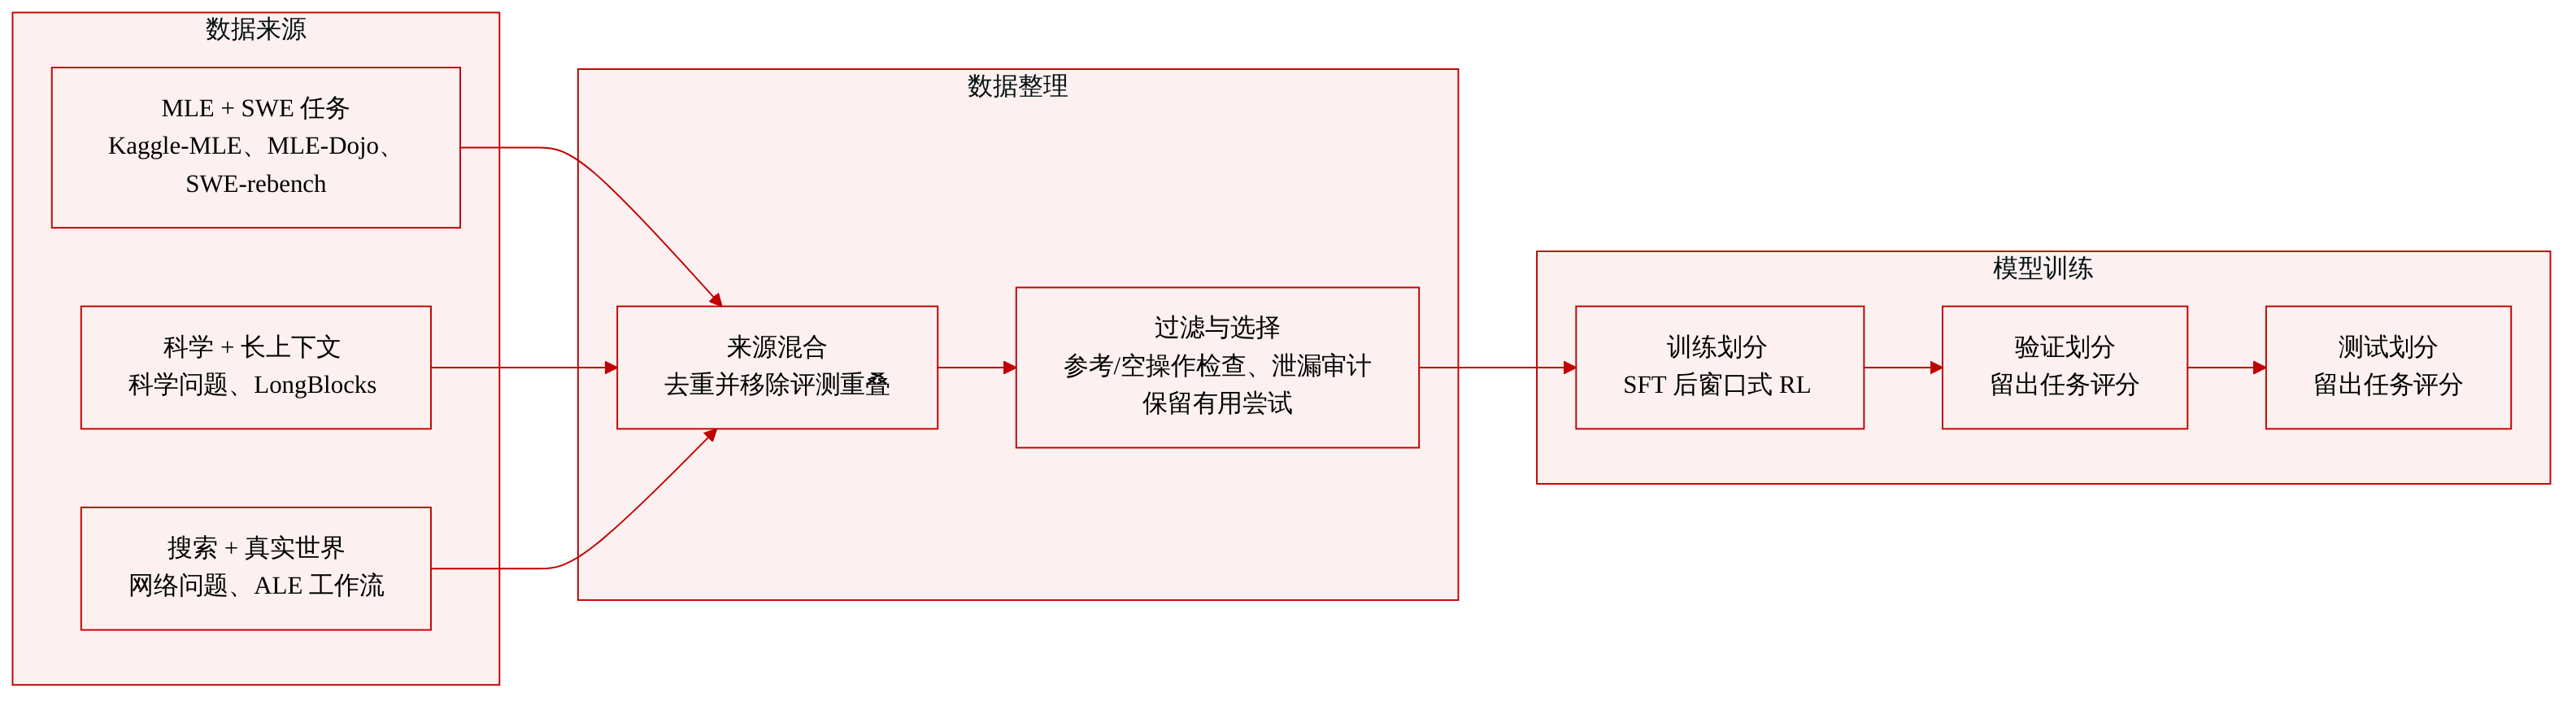
作者为后训练整理了若干经过筛选的任务和轨迹数据集,每个数据集都有不同的来源、构成规则、过滤步骤和用途。
-
MLE 任务
- 来源:自动化的 Kaggle-MLE Factory 流水线,将历史 Kaggle 竞赛转换为可执行任务;以及 MLE-Dojo。与完整 MLE-Bench 任务集重叠的竞赛被排除。
- 构成:任务包括公共工作区、隐藏测试集、根据官方描述和实际数据得出的任务说明、任务专用评估器,以及人工审查。
- 处理与筛选:收集的监督数据包括初始解前缀、长程优化轨迹和分析 sub-agent 轨迹。如果首次最佳提交后性能退化超过阈值,则在完整的工具交互边界处截断轨迹;否则保留到最终提交。
- 用途:用于两阶段监督微调的第二阶段,与科学研究轨迹结合,后续用于带执行窗口奖励的强化学习。
-
SWE 任务
- 来源:公开的 SWE-rebench-V2 数据集,以及单独的内部任务集。
- 构成:任务被转换为仿照 SWE-bench 的通用修复任务格式。每个任务包含仓库快照、基础提交、问题描述、从非测试改动中得到的解决方案补丁,以及用于评分的留出测试补丁。
- 环境与验证:恢复或构造容器配置、安装脚本和测试命令。缺失配置遵循有界构建与修复循环。候选任务通过参考补丁和 no-op 检查,这些结果被保存为任务元数据。
- 收集与筛选:使用 mini-swe-agent 和 Claude Code 收集轨迹。保留成功轨迹,同时保留经过筛选的部分未解决尝试,这些尝试具有非空补丁、实质性的任务导向交互、良好的结构,以及可接受的泄漏和覆盖检查结果。零奖励轨迹通过重放未更改补丁重新评分一次。
- 泄漏控制:在 agent 执行期间移除暴露参考修复或留出测试的 Git 对象。通过代理阻止出站流量,仅在 agent 退出后恢复评分所需对象。审计结论被保存并用于选择。
- 用途:用于仓库级软件工程问题修复训练。
-
科学研究任务
- 来源:涵盖数学、物理、化学、生物学和相关学科的多样科学问题池。
- 构成与筛选:问题经过初步质量检查,并通过基于模型的难度、任务类型和工具收益评估进行选择。优先选择具有较强推理或研究导向且可能受益于工具的中高难度问题。
- 轨迹处理:一个强模型使用 search、visit、code 和 scholar 工具生成长程轨迹。轨迹按解正确性、推理深度和工具调用成功率进行过滤。保留具有可恢复工具故障的已选轨迹,以教会自我纠正。
- 用途:用于在 Qwen3.5-35B-A3B 上进行 token 级监督微调,并采用扩展的多轮训练计划。
-
长上下文推理任务
- 来源:跨越 16K 到 128K tokens 的 LongBlocks 文档。
- 构成:任务覆盖 24 个细粒度类别,例如跨文档事实整合、时间线重建、证据归属、多源一致性检查、规则归纳、状态跟踪和版本影响分析。每个问题包含参考答案和支持证据。
- 处理:递归任务演化使用十个难度轴和参考模型反馈。通过审查且经验成功率不超过 0.75 的候选项进入高难问题池,最终得到 3,512 个高难 QA 对。Qwen3.5-35B-A3B 在该池上的平均每题成功率为 31.57%。
- 收集与选择:每个问题从 DeepSeek-V4-Pro 采样三条推理轨迹。错误答案被丢弃,剩余轨迹在两次顺序相反的评估中联合判断证据覆盖、检索质量、推理一致性和冗余度。每个问题选择一条轨迹,序列长度限制最终留下 1,949 条 LongBlocks 轨迹。
- 用途:用于长上下文推理的监督微调。
-
搜索 agent 任务
- 来源:来自开源搜索和深度研究数据集的去重问题,以及新生成的以搜索为根据的研究问题。
- 构成:新生成的问题由 proposal agent 通过搜索和页面阅读工具在网页探索中锚定。每个问题包含明确的评估标准,涉及事实、支持证据、比较或结论。
- 收集与过滤:在相同工具环境中以报告式输出收集 agentic 搜索轨迹。LLM 评估器根据问题特定标准过滤轨迹,丢弃含有无依据论断、遗漏标准或未完成任务的报告。
- 用途:保留的轨迹用于搜索-agent 任务的监督微调。
-
具有经济价值且真实的任务
- 来源与规模:从几十个高质量任务的人工冷启动开始,通过受控演化扩展到超过一千个专业工作流环境。
- 构成:任务遵循 ALE 风格的专业工作流,覆盖 55 个子领域和 13 个行业簇。每个任务包括真实输入数据、隐藏参考答案、确定性评分器、隔离沙箱、固定工具版本和单任务时间预算。构建与验证使用不同的 agent 以避免奖励污染。
- 收集与过滤:使用 Claude Code 收集轨迹。当上下文长度超出时,较早历史被压缩,任务从压缩上下文继续,所有片段均保留。每个任务选择得分最高的尝试,加上少量具有实质性产出的主动失败尝试。混合数据按任务族、领域和失败尝试占比设置上限以保持平衡。
- 用途:为通用真实世界 agent 训练贡献数亿个监督 tokens。
方法
作者沿着两个维度扩展 agent 能力开发:能力覆盖,跨任务领域;以及能力组合,涉及求解能力在执行过程中如何组织与自适应调整。为此,作者提出了自适应 Agentic 执行,包括 Agentic 编排和 Agentic 验证。
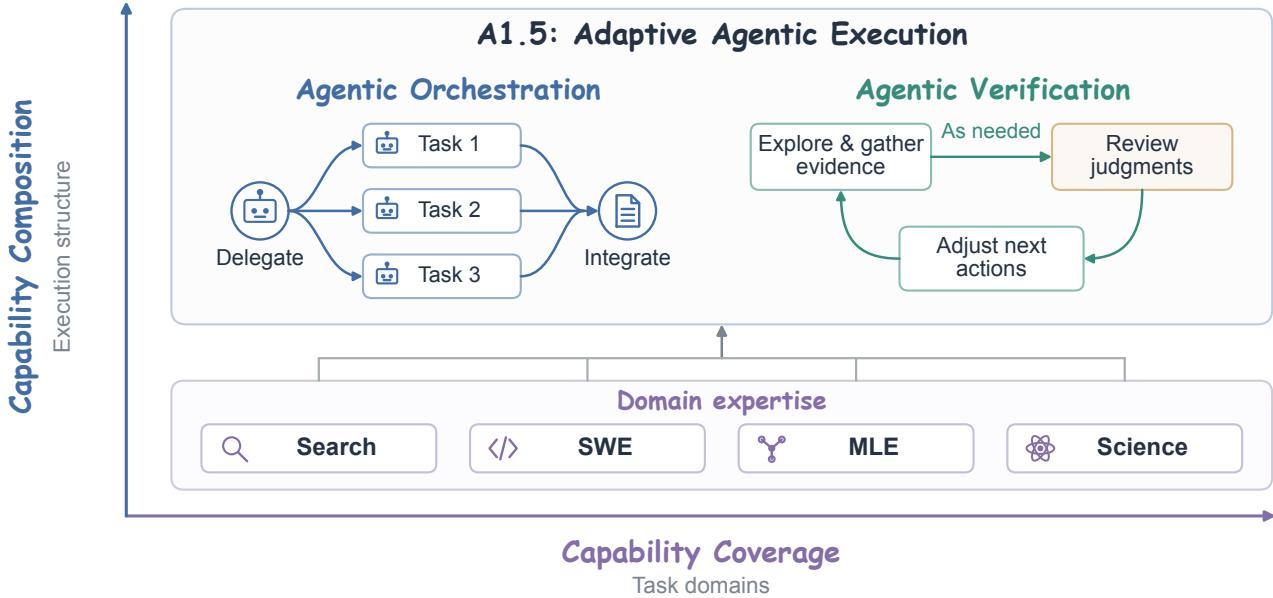
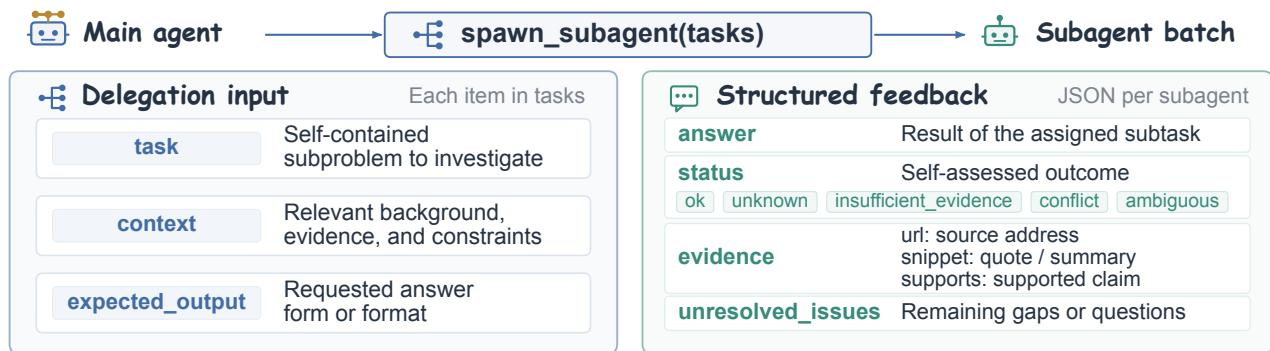
Agentic 编排在任务执行过程中对计算进行结构化、分配和协调。模型学会通过两种互补模式分解工作、委派子任务并整合结果:探索式组合,即多个 agent 针对同一问题研究不同假设;构建式组合,即任务被拆分为可并行求解的互补子问题。主 agent 通过指定范围、上下文和期望输出格式来委派子任务。subagent 随后返回结构化反馈,包括其结果、自我评估结论、支持证据和未解决问题。这些反馈使主 agent 能够识别差距、解决冲突并引导后续调查。
Agentic 验证通过使模型能够自适应地识别何时需要验证,来解决长程任务中的错误积累问题。模型不依赖外部规则,而是检查自身推理,以复核已确认事实、识别无依据的推断,并判断无效的探索路径。在训练期间,构造包含中间反思和后续动作的完整研究轨迹。监督模型在关键点引入验证,执行模型基于这些发现继续探索。在推理时,在系统提示中加入特定协议标记即可激活该能力,使模型无需外部工具即可自主执行验证和上下文管理。
为增强深度科学推理和工具使用,作者通过三阶段流程开发了科学增强型教师模型。
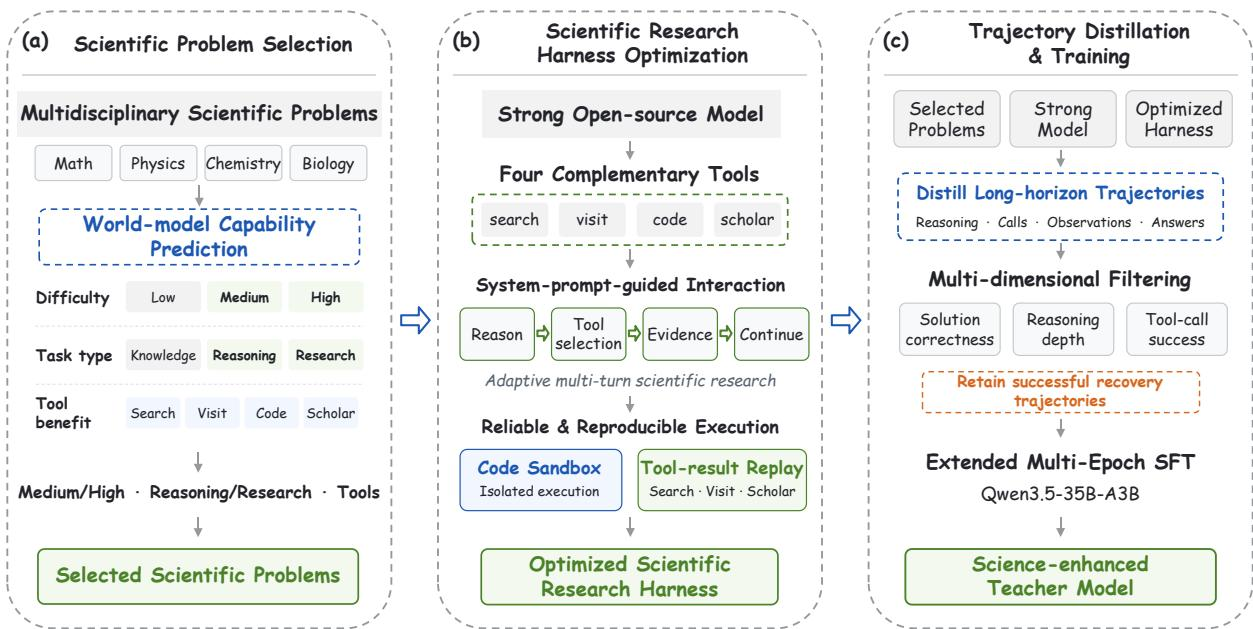
首先,科学问题选择利用世界模型预测能力,从难度、任务类型和工具收益等方面评估候选问题,优先选择能从工具交互中获益的中高难度问题。其次,优化科学研究工具框架,配备四种互补工具:search、visit、code 和 scholar。引入隔离代码执行沙箱和工具结果回放机制,以提高可靠性和可复现性。第三,轨迹蒸馏与训练使用强模型生成长程轨迹。这些轨迹经过多维度过滤,依据解正确性、推理深度和工具调用成功率,并保留可恢复的工具故障以教会自我纠正。过滤后的数据用于扩展的多轮监督微调。
对于跨领域统一训练,作者采用两阶段方法。第一阶段包括多领域监督微调(SFT),使用在兼容工具框架上收集的任务导向演示和协议聚焦冷启动示例。SFT 目标使用 token 归一化负对数似然损失:
ℓθ(τ)=−Nτ1t∑mtlogπθ(yt∣ct)其中 mt 表示模型生成的目标 tokens。总体 SFT 损失结合了任务导向子集和协议聚焦子集:
LSFT(θ)=(1−ρ)Eqtask[ℓθ]+ρEqproto[ℓθ]第二阶段采用统一的结果-过程后训练,联合优化基于结果的强化学习和多教师 on-policy 蒸馏(OPD)。样本级目标为:
Lpost(x)=λout(x)LRL(x)+λproc(x)LOPD(x)仅结果监督使用奖励函数 Rout(x)=Vd(x)−Pfmt(x)−Pproto(x),而仅过程监督针对学生分布与教师分布之间的反向 KL 散度:
LOPD(x)=Nτ1t∑mtDKL(pt∥ptT)为支持灵活部署和完全本地部署的 agentic 工作流,系统被设计为可在异构硬件上运行,包括国产 NPU、主流 GPU 和 Apple Silicon。模型提供多种量化变体,例如 FP8 和 4-bit 格式,以降低内存需求。
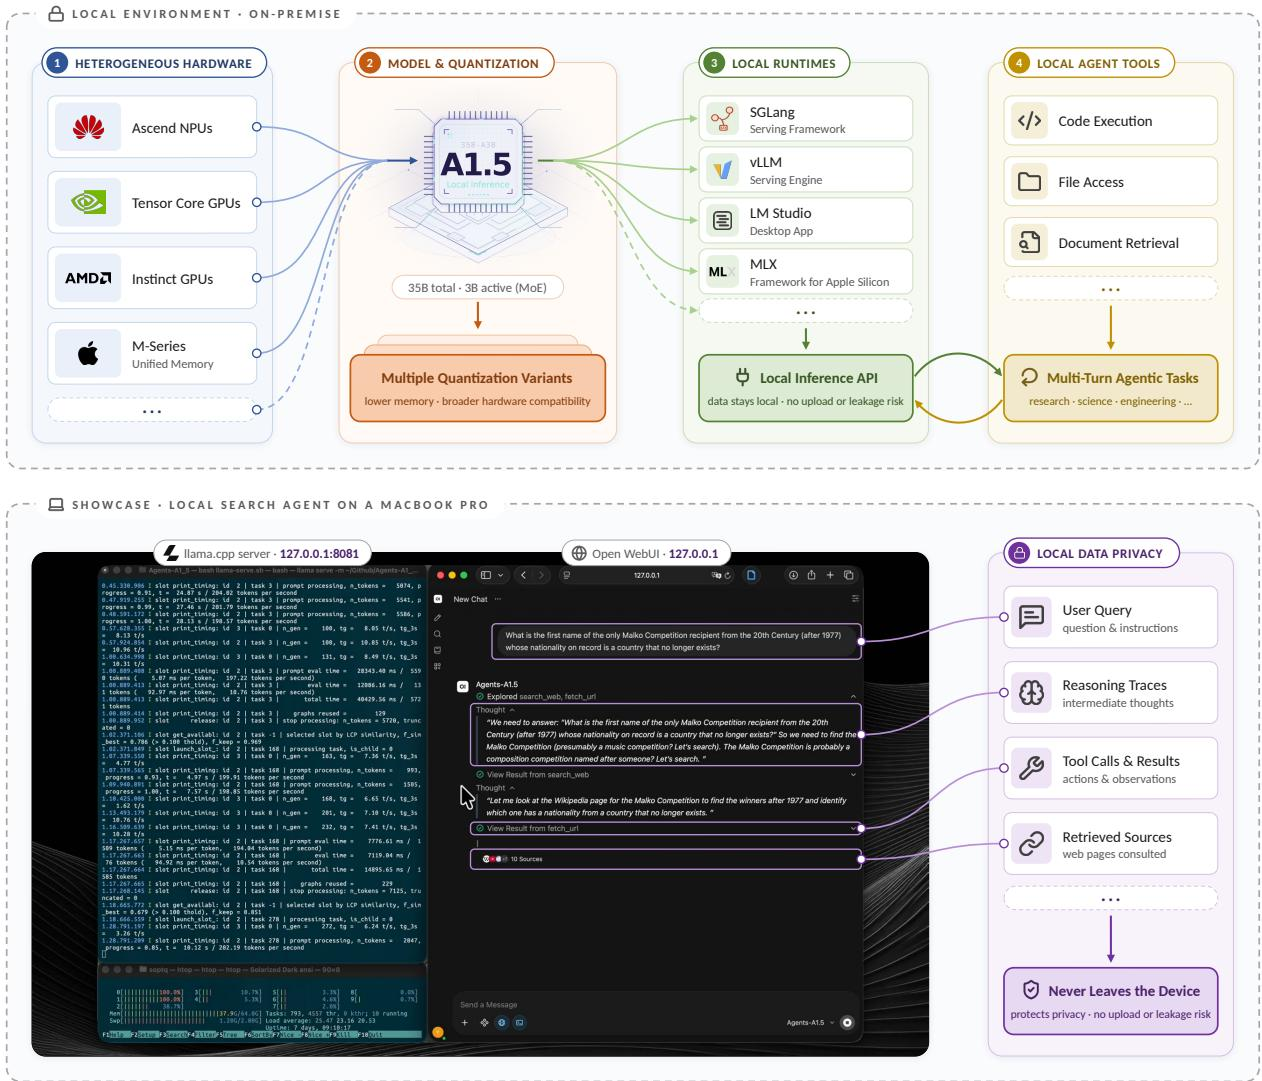
通过本地运行时和推理 API,该模型与本地 agent 工具集成,用于代码执行、文件访问和文档检索。该架构确保所有数据和多轮 agentic 任务都留在本地环境中,从而降低数据泄漏风险,并支持隐私敏感的研究和企业部署。
实验
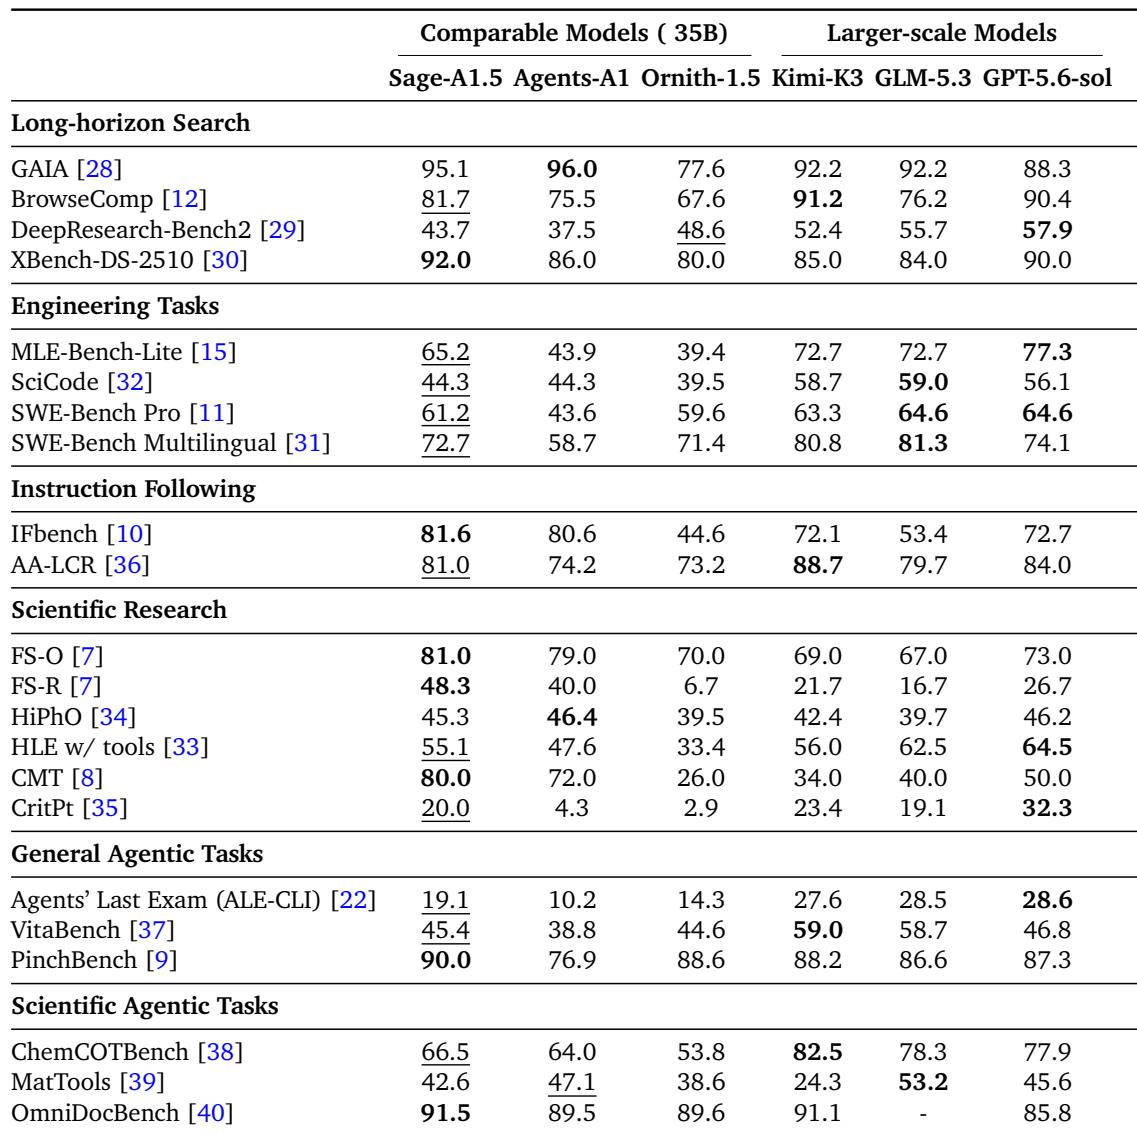
评测涵盖搜索、工程、科学研究、通用 agentic 和科学 agentic 基准,使用网页工具、代码沙箱、subagent 编排、验证和隔离执行环境。专用教师模型持续优于其 Qwen 基线,在研究级科学推理和长程信息搜寻任务上提升尤其显著;同时编排和验证进一步增强了多步浏览和报告生成,并有助于减少无效探索。Sage-A1.5 在通用 agentic 任务和指令遵循方面,就其规模而言也表现出竞争力。案例研究表明,该模型能够协调多 agent 科学工作流,自我纠正分析和数值错误,将证据整合到结构化报告中,并完成专业及端到端自动研究任务。
在与可比的 35B 模型中,Sage-A1.5 在 BrowseComp 和 XBench-DS-2510 上领先,在 GAIA 上以微弱差距排名第二,在 DeepResearch-Bench2 上落后。与更大规模模型相比,它在 XBench-DS-2510 上取得最佳综合成绩,并在 GAIA 上优于它们,但在 BrowseComp 和 DeepResearch-Bench2 上落后于领先的更大模型。DeepResearch-Bench2 仍是 Sage-A1.5 的相对薄弱点。Sage-A1.5 是 BrowseComp 和 XBench-DS-2510 上最强的 35B 模型,并在 GAIA 上几乎追平领先的 35B 模型。它在 GAIA 和 XBench-DS-2510 上的得分均高于所有列出的更大规模模型。在 DeepResearch-Bench2 上,它落后于最佳 35B 同级模型以及所有更大规模模型。
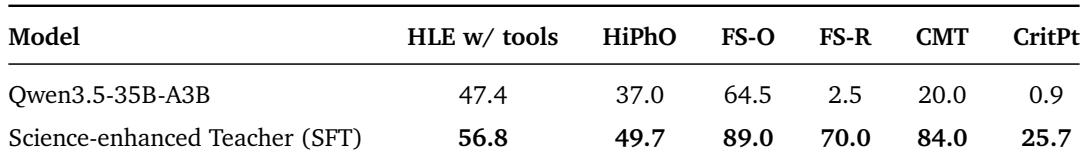
科学增强型教师模型在每个已报告的科学基准上均优于 Qwen3.5-35B-A3B。提升在复杂研究级任务上最大,这些任务的基线分数原本很低;同时奥赛级和基于专家工具的学术任务也有明显改善。研究级基准提升显著,FS-R 从 2.5 上升到 70.0,CMT 从 20.0 上升到 84.0。奥赛级科学表现也增强,FS-O 从 64.5 提高到 89.0,HiPhO 从 37.0 提高到 49.7。
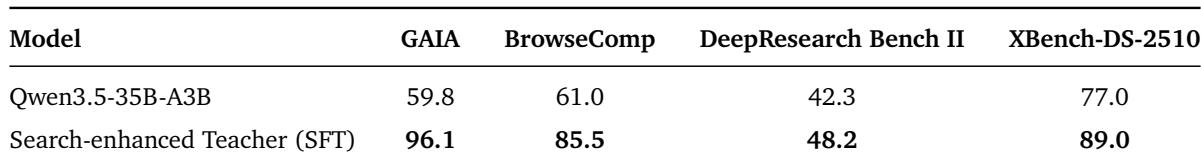
搜索增强型教师模型在所有四项搜索基准上均持续优于 Qwen3.5-35B-A3B 基线。提升在多步浏览和证据搜寻任务上最大,而报告合成和深度搜索也有较小但有意义的改善。这表明相对于基线,持续搜索、检索和合成能力更强。GAIA 和 BrowseComp 的准确率显著提高,GAIA 几乎达到天花板水平。DeepResearch Bench II 和 XBench-DS-2510 也有所改善,反映了在专业真实问题上更好的报告合成和深度搜索能力。
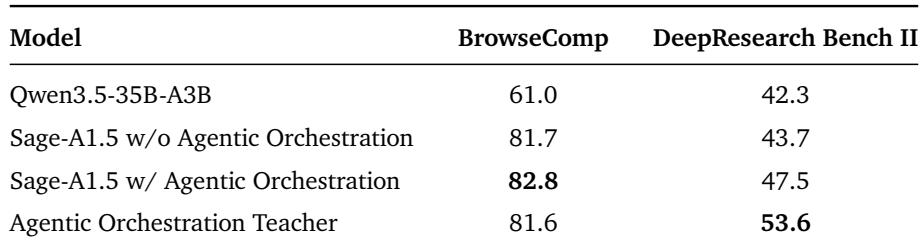
Agentic 编排改善了 BrowseComp 和 DeepResearch Bench II 上的表现。在 Sage-A1.5 上启用编排带来适度的 BrowseComp 提升和较大的 DeepResearch Bench II 提升,而编排教师模型取得最高的报告生成得分。在比较的配置中,启用编排的 Sage-A1.5 获得最高的 BrowseComp 准确率。在 Sage-A1.5 上启用编排可适度提高 BrowseComp 准确率,并更明显地提高 DeepResearch Bench II 准确率。在比较的配置中,启用编排的 Sage-A1.5 取得最高的 BrowseComp 准确率。编排教师模型取得最高的 DeepResearch Bench II 得分,并相较 Qwen 基线有大幅提升。
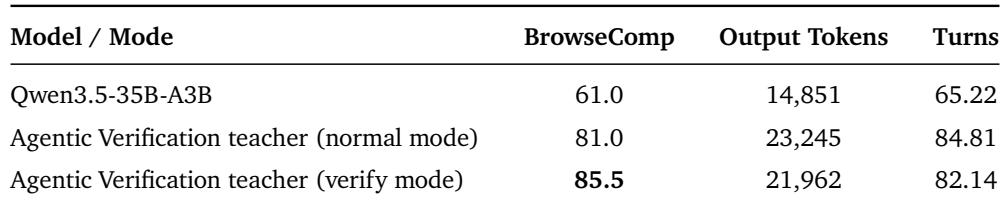
Agentic 验证相对 Qwen3.5-35B-A3B 基线显著提高 BrowseComp 准确率,verify 模式在比较配置中达到最高准确率。在成对比较中,verify 模式还相较 normal 模式降低了平均输出 token 数量和交互轮数,这表明尽管增加了验证推理,生成成本却有所下降。验证教师模型在 normal 模式下达到 81.0 的 BrowseComp 准确率,而基线为 61.0。启用 verify 模式将 BrowseComp 准确率提高到 85.5,比 normal 模式提高 4.5 个百分点,也是比较中报告的最高值。在成对尝试中,verify 模式相较 normal 模式将平均输出 tokens 减少约 5.5%,交互轮数减少约 3.2%。
实验在深度研究、浏览和科学基准上将 Sage-A1.5 与可比及更大模型进行比较,并将科学增强、搜索增强、编排和验证配置与 Qwen3.5-35B-A3B 基线进行比较。Sage-A1.5 在 BrowseComp 和 XBench-DS-2510 上领先于 35B 模型,并在 GAIA 和 XBench-DS-2510 上超过更大模型,而 DeepResearch-Bench2 仍是相对薄弱点。科学增强型教师模型显著改善研究级科学基准,搜索增强型教师模型在 GAIA 和 BrowseComp 上带来显著提升。Agentic 编排改善了 BrowseComp 和 DeepResearch Bench II,而 agentic 验证提高了 BrowseComp 准确率,并减少输出 tokens 和交互轮数。