Command Palette
Search for a command to run...
基于通用编码智能体的空间推理
基于通用编码智能体的空间推理
摘要
空间推理要求模型判断物体在三维空间中的位置、它们之间的相互关系以及运动方式。近年来,智能体式 VLM 通过让模型利用 3D 感知工具主动收集证据,而不是在单次推理中直接作答,在这类任务上取得了显著提升。即便如此,在许多问题上,工具返回了正确证据,模型却仍无法得到正确答案:模型与工具之间的差距——即将原始读数转化为可用结论的环节——仍未弥合。我们提出了 S-Agent 2.0,一种空间推理智能体,该智能体配备了一个 off-
一句话总结
来自南洋理工大学、香港大学和 Ropedia 的研究人员提出 S-Agent 2.0,一种空间推理 agent,为通用编程 agent 配备 3D 感知工具,以主动收集证据并将原始读数转化为可靠结论,从而弥合模型与工具之间在三维场景中物体关系和运动方面的差距。
核心贡献
- S-Agent 2.0 将现成的通用编程 agent 与命令行感知工具包相结合,该方法适用于 OpenHands、Codex 和 Claude Code 等编程 agent 执行环境。
- 该工具包将工具测量与模型自身感知相结合,将获得的证据持久化到场景记忆中,并以已用空间语言解释、可直接用于回答的读数返回每次测量,从而闭合证据回路。
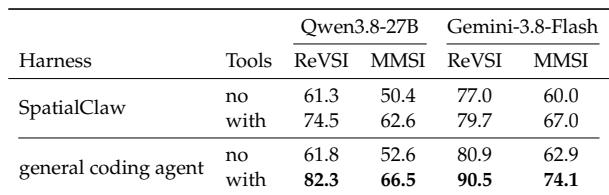
- 在 MMSI-Bench 和 ReVSI 上,感知工具包在 Qwen3.8-27B 骨干模型上比未使用工具的同一 agent 分别提升 +13.9 和 +20.5 分。S-Agent 2.0 超越最先进的 agentic 空间推理方法,并且在 Gemini-3.8-Flash 上工具包增益仍然显著,而专门基线的增益收缩幅度要大得多。
引言
空间推理要求模型确定物体在三维空间中的位置、它们之间的关系以及它们如何运动,这对在物理环境中运行的 agent 至关重要。最近的 agentic 视觉语言模型通过使用三维感知工具主动收集证据而有所改进,但一个关键差距仍然存在:即使工具返回了正确证据,模型也可能误读测量结果,或未能将其带入最终答案。现有专门系统主要投入于更丰富的感知库和手工设计的控制回路,却将证据回路中的记忆和解释阶段留给模型。作者通过提出 S-Agent 2.0 来解决这一问题,该方法将通用编程 agent 与命令行感知工具包配对,旨在通过模型与工具联合感知、持久场景记忆以及以简明空间语言返回的读数来闭合证据回路。
方法
作者利用现成的通用编程 agent 构建 S-Agent 2.0,这是一个旨在闭合视觉语言模型与三维感知工具之间证据回路的空间推理系统。该架构不依赖模型在上下文窗口内传递中间结果,而是为编程 agent 配备命令行接口感知工具包和持久场景记忆。该设计确保原始几何读数在到达最终答案之前被获取、存储,并以简明空间语言进行解释。
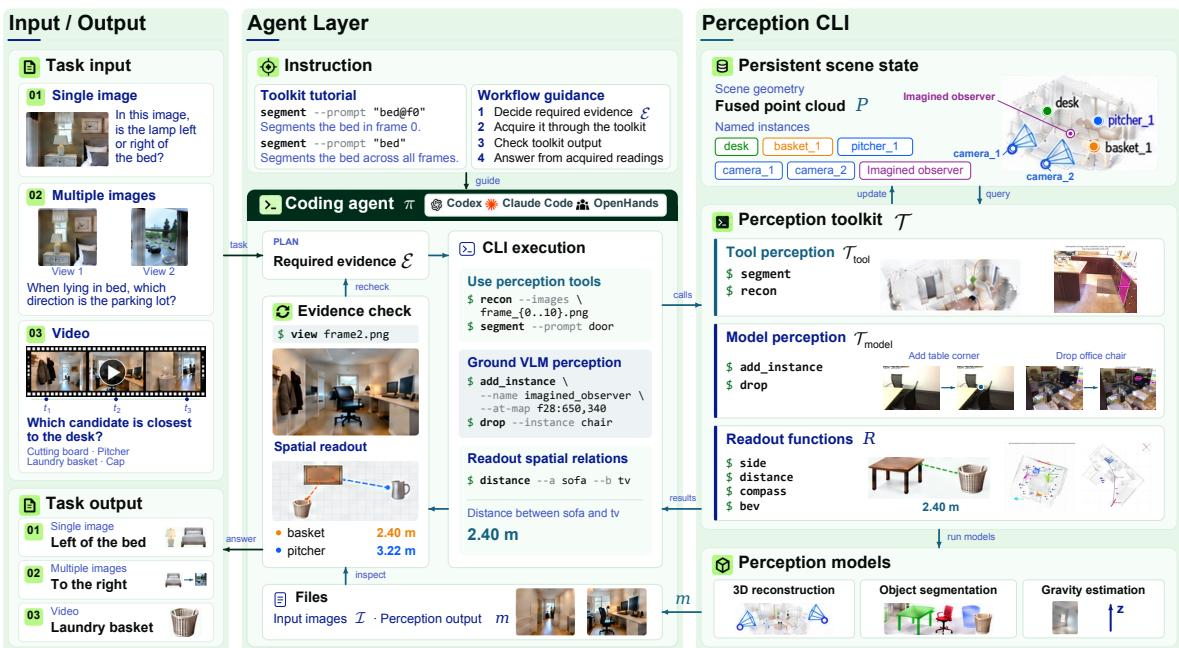
该框架包含三个核心组件:一个通用编程 agent π,充当规划器和执行器;一个命令行感知工具包 τ;以及每个场景的持久场景记忆 S。给定空间问题 q 和一帧集合 T={I1,…,In},agent 会收到一条固定指令 u,其中详细说明工具包命令和推荐工作流程。在每个推理步骤 t,agent 的上下文包括该指令、问题以及其思维链 z<t、动作 a<t 和工具响应 o<t 的历史。策略生成下一步思维和动作:
(zt,at)∼π(⋅∣u,q,z<t,a<t,o<t),at∈Agen∪Aperc动作空间分为通用编程动作 Agen(例如运行 Linux 命令、读取文件)和感知动作 Aperc(例如重建、分割)。
为了在不超出上下文窗口的情况下处理多步推理,环境维护场景记忆 S=(I,P,{(νi,gi)}i),其中 gi=(pi,Ei,Ti)。该记忆存储原始帧 I、重力对齐世界坐标系中的融合度量点云 P,以及命名实例注册表。每个实例将名称 νi 与其几何信息 gi 配对,其中包括三维位置 pi∈R3、范围 Ei 和 6 自由度位姿 Ti∈SE(3)。由于记忆记录了位置、范围和位姿,测量物体及其关系就变成每次调用时根据已存储几何信息重新导出的闭式查找。
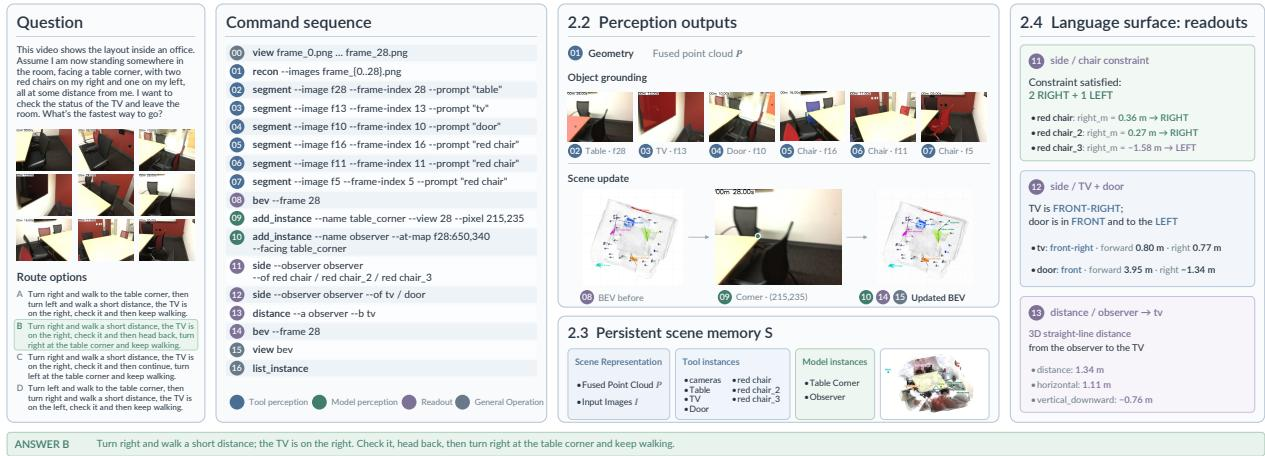
系统根据能力分工。决定测量什么被视为由 VLM 处理的语义工作,而生成精确掩码和测量则交给专用感知模型。这种分工通过对场景记忆的两条写入路径实现。工具感知 Ttool 处理测量命令,例如 recon 用于融合帧,segment 用于利用模型文本提示将物体定位。模型感知 Tmodel 允许 agent 通过 add_instance 命令注入自身的高层理解,将想象中的观察者或识别出的物体直接注册到几何注册表中。模型还可以使用 drop 命令删除错误注册的实例,例如反射,从而确保在读取之前记忆保持准确。
最后,为防止模型误读原始数值输出,工具包强制采用一种语言接口,其中每个回复都会解释自身数值。每个命令将其完整输出 m 与场景记忆 S 对照,蒸馏为一份紧凑的结构化报告:
operc=cτ(m;S)该报告包含带单位的类型化数值字段,以及一条简明语言结论,其中命名实体、声明参考坐标系,并将测量结果转换为普通空间词汇。该设计使模型无需重新推导几何即可依据读数采取行动,而完整测量结果仍保留在磁盘上,便于需要时进行更深入检查。
实验
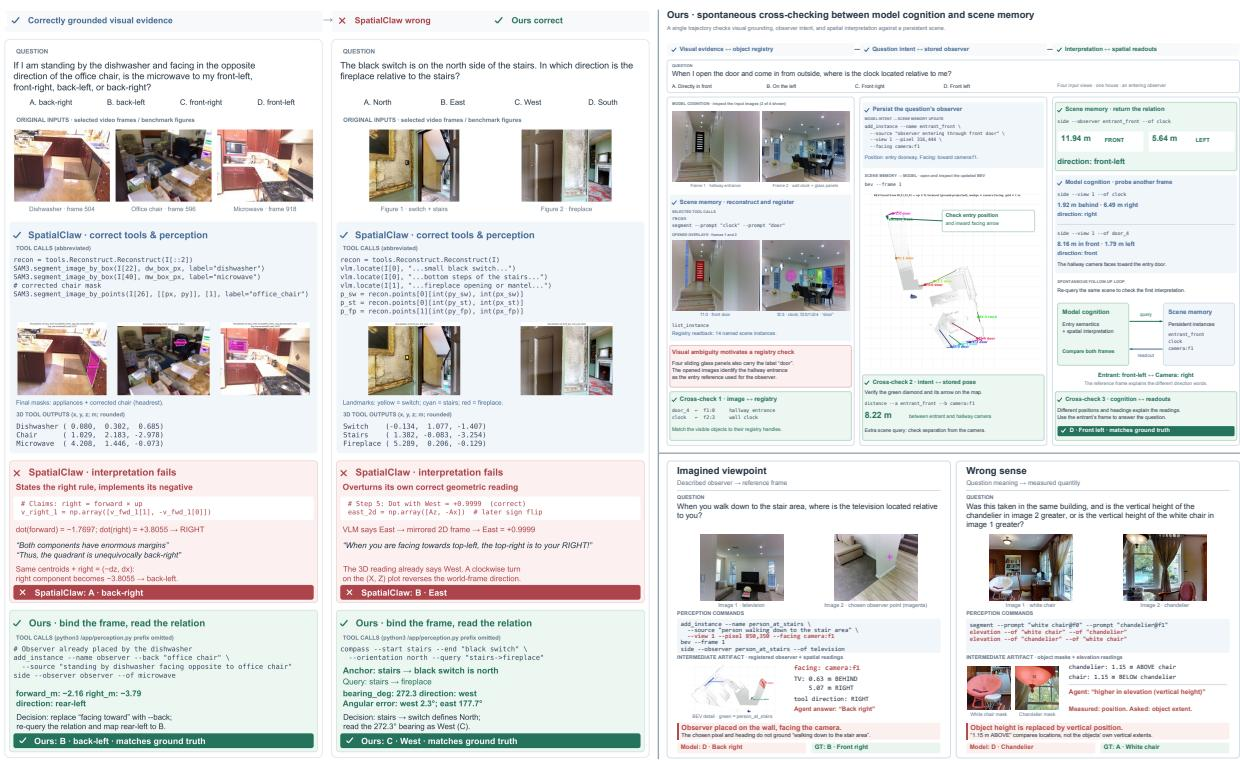
评估覆盖五个多视角和视频空间推理基准,将 S-Agent 2.0 与专有 VLM、开放权重空间模型和 agentic 基线进行比较,使用 27B 开放骨干模型或 Gemini Flash 以及冻结的感知工具。在无需训练的情况下,S-Agent 2.0 在每个基准上都优于所有 agentic 基线,并且在较强骨干模型上,在主要 MMSI-Bench 和 ReVSI 结果中取得最高平均分,尽管 GPT-6 在一些 MMSI-Bench 问题类型上仍保持领先。消融实验表明工具包和接口组件均有贡献,其中模型感知接口最重要,解释后读数贡献最小;该方法在 Codex 和 Claude Code 环境下也能工作。定性分析表明,S-Agent 2.0 通过将前提编码到场景记忆并交叉检查感知输出,闭合了 SpatialClaw 未闭合的证据到答案回路,剩余错误主要涉及物体定位,例如模拟所需视点或以错误方向测量某个量。
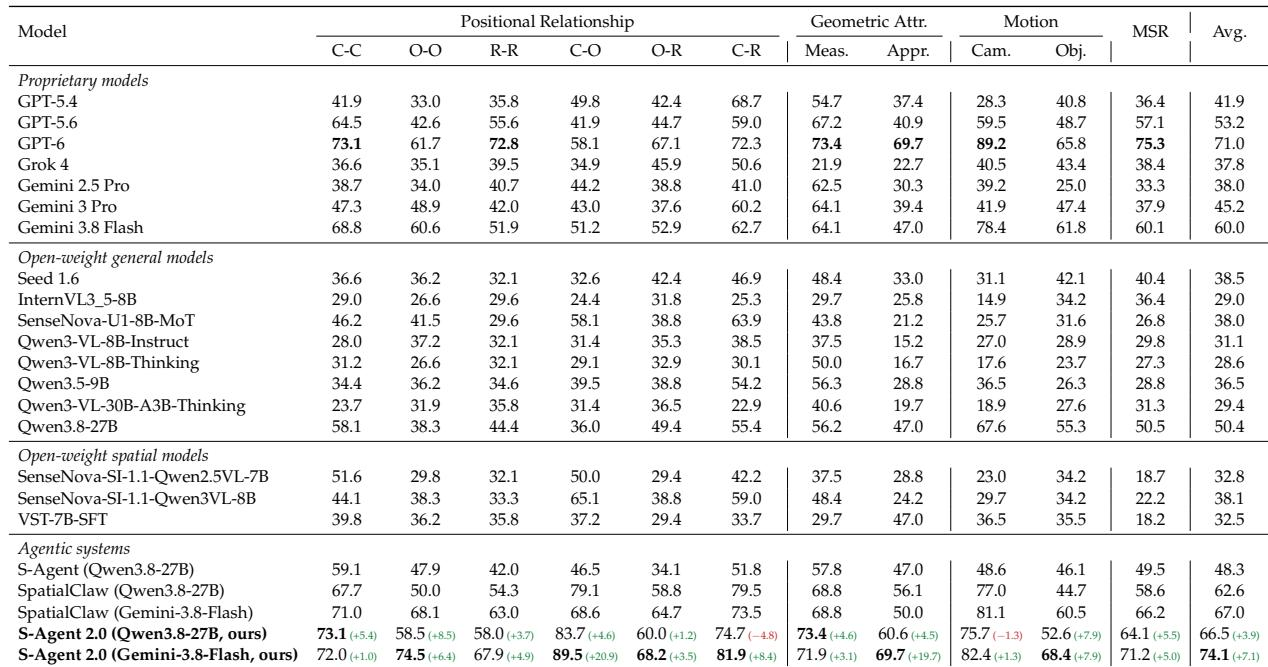
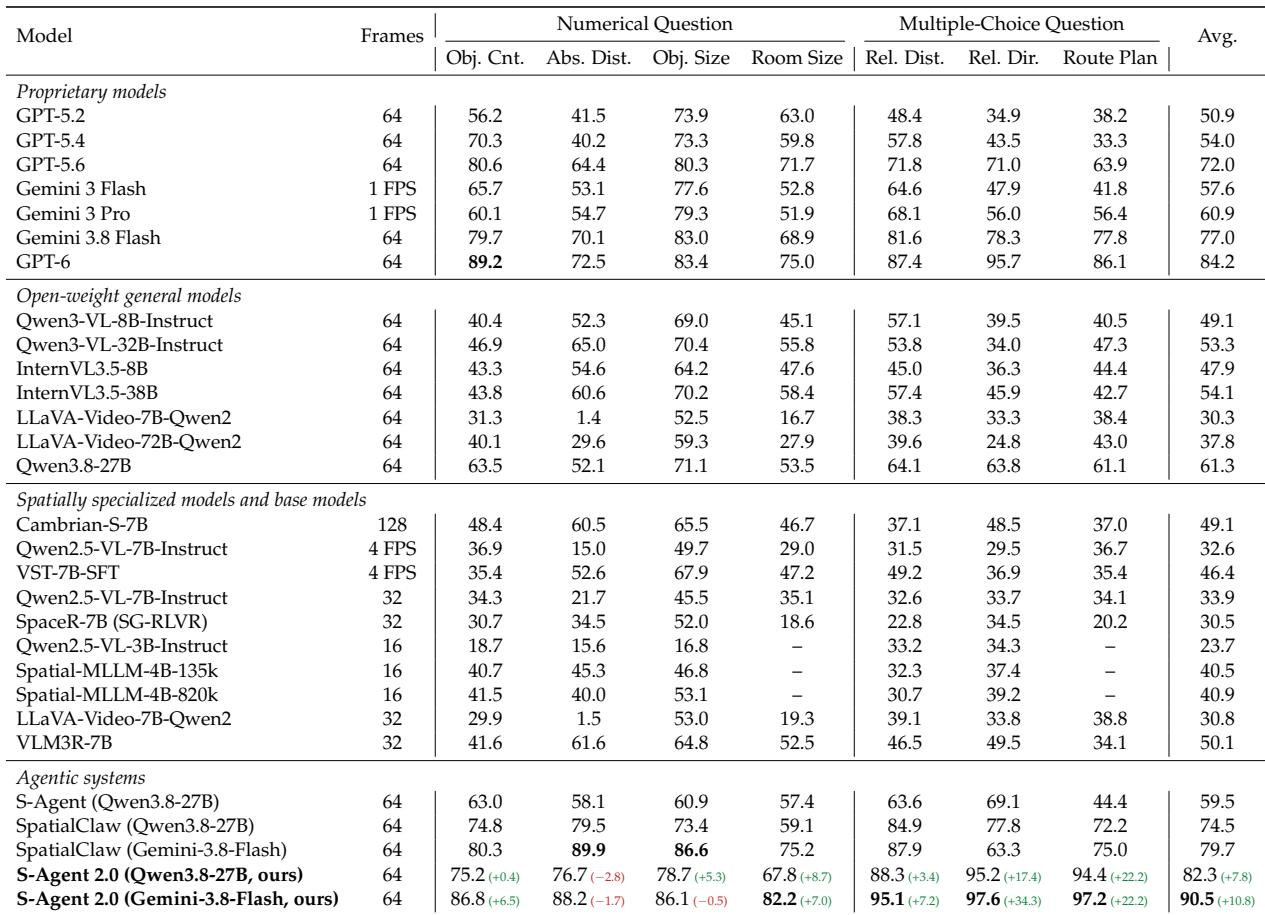
在 MMSI-Bench 上,具有 27B 骨干模型且无需训练的 S-Agent 2.0 优于除 GPT-6 外的所有 agentic 基线和所有专有模型。使用 Gemini-3.8-Flash 时,它达到最高总体平均分,而 GPT-6 在区域间关系、相机运动和多步推理上仍保持领先。在所列专有模型中,GPT-6 具有最高的总体和类别级准确率。具有 27B 骨干模型且无需训练的 S-Agent 2.0 领先于除 GPT-6 外的所有 agentic 基线和所有专有模型。使用 Gemini-3.8-Flash 时,S-Agent 2.0 达到最高平均准确率,而 GPT-6 在区域间关系、相机运动和多步推理上保持领先。在所列专有模型中,GPT-6 总体排名第一,其后是 GPT-5.6;Grok 4 和 Gemini 2.5 Pro 略低于 GPT-5.4。与其他所列模型相比,GPT-6 在相机运动和多步推理方面的提升尤其显著。
在 ReVSI 上,S-Agent 2.0 在两种骨干模型上都优于所有 agentic 基线,并且使用 Gemini-3.8-Flash 骨干模型时,它在所比较系统中取得最高总体平均分。相较于专门基线的最大优势出现在跨物体几何、相对方向和路径规划方面。唯一落后的是绝对距离,而这也是 GPT-6 相对短板最明显的方面。S-Agent 2.0 在 ReVSI 上以两种骨干模型领先所有 agentic 基线,并在 Gemini-3.8-Flash 上取得最高平均分。相比专门基线的最强提升出现在跨物体几何、相对方向和路径规划方面。绝对距离是 S-Agent 2.0 唯一的不足,也是 GPT-6 落后最多的方面。
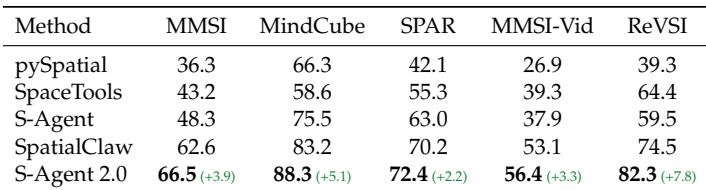
在五个评估基准上,使用 Qwen3.8-27B 骨干模型的 S-Agent 2.0 领先所有所列 agentic 空间推理基线。与 SpatialClaw 相比,它在每个基准上都有提升,其中 ReVSI 和 MindCube 上提升最大,MMSI、SPAR 和 MMSI-Vid 上提升较小。这使得 S-Agent 2.0 在给定骨干模型比较中成为最强方法。S-Agent 2.0 在比较中的每个基准上都取得最高准确率。相较 SpatialClaw 的最大改进出现在 ReVSI 和 MindCube,而 MMSI、SPAR 和 MMSI-Vid 的提升较为温和。
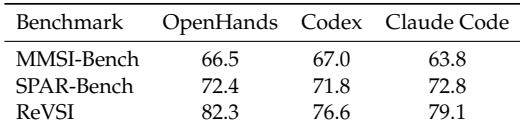
S-Agent 2.0 在 OpenHands、Codex 和 Claude Code 上均保持有效,没有单一执行环境在所有基准上占主导。接口消融显示,模型感知接口是最关键组件,场景记忆次之,解释后读数贡献较小但仍有意义。该模式支持如下观点:解释和保留的场景记忆都是闭合回路所必需的。在三种编程 agent 执行环境中,S-Agent 2.0 保持大致相当的表现,仅存在适度的基准特定差异。移除模型感知接口会导致最大的准确率下降,而移除解释后读数导致的下降最小。移除场景记忆导致中等准确率下降,这与通过上下文携带的读数在写出答案前丢失的情况一致。工具使用在两个基准上都带来显著提升,且 S-Agent 2.0 在每个骨干模型和基准上的得分均高于 SpatialClaw。
在测试的两种骨干模型上,工具使用提高了 SpatialClaw 和通用编程 agent 的 ReVSI 与 MMSI 得分。通用编程 agent 在每个骨干模型和基准设置中都优于 SpatialClaw,且启用工具后差距更大。随着骨干模型增强,SpatialClaw 从工具中获得的收益收缩更多,而通用编程 agent 启用工具的得分持续上升。工具使用在两种骨干模型上都改善了两种执行环境,但通用编程 agent 在每项比较中均比 SpatialClaw 获得更多提升。最高得分出现在较强 Gemini-3.8-Flash 骨干模型上启用工具的通用编程 agent 中。SpatialClaw 在较强骨干模型上的工具优势较小,而通用编程 agent 随着骨干模型规模继续改善。
实验在 MMSI-Bench、ReVSI、SPAR、MMSI-Vid 和 MindCube 等空间推理基准上,跨多个骨干模型和编程 agent 执行环境对 S-Agent 2.0 进行评估。无需训练时,S-Agent 2.0 在 MMSI-Bench 上超越 agentic 基线和除 GPT-6 外的所有专有模型;使用 Gemini-3.8-Flash 时,它在 MMSI-Bench 和 ReVSI 上均取得最高总体平均分,仅在相机运动、多步推理和绝对距离等领域存在剩余差距。消融实验表明模型感知接口最重要,场景记忆次之,解释后读数增加较小但有意义的收益;工具使用带来持续改进,尤其使通用编程 agent 相较 SpatialClaw 的优势更为明显。总体而言,结果验证了 S-Agent 2.0 是跨基准、骨干模型和执行环境的一个强通用空间推理 agent。