Command Palette
Search for a command to run...
Matrix-Game 4.0:利用视频模型实现实时可玩游戏世界
Matrix-Game 4.0:利用视频模型实现实时可玩游戏世界
摘要
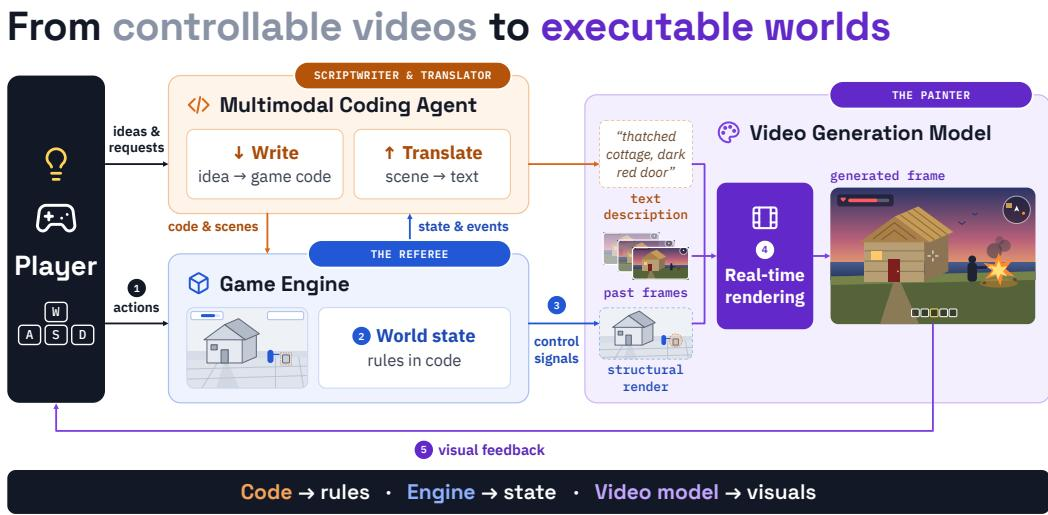
从可控视频迈向真正可玩的世界,需要持久化的世界状态、可执行的游戏规则和低延迟的交互。我们描绘了下一代 Matrix-Game 的路线图,通过可执行游戏框架将游戏执行与视觉生成分离;并推出 Matrix-Game 4.0 作为基于该设计构建的首个系统。轻量级游戏引擎维护世界状态并执行交互规则;多模态编程智能体将玩家想法转化为游戏代码和动态场景描述;基于自回归视频模型的渲染器以动态场景描述和记忆引用为条件,将引擎渲染的低多边形代理转换为精细画面。该框架为视觉生成提供持续引导,并支持以自然语言创建与修改场景和玩法。我们的渲染器在配对的低多边形与高保真视频对上进行训练,并被蒸馏为一种因果生成器,该生成器以四帧为块生成,并使用一到两个去噪步骤。结合针对性的推理优化,Matrix-Game 4.0 在单张 NVIDIA RTX 5090 上实现了 480p、60 FPS 的游戏运行,按键到显示的延迟为 112 ms。单步生成可达到 83 FPS 的稳态吞吐量,峰值 GPU 显存占用为 18.2 GiB。在固定提示词下,稳态吞吐量在 RTX 5080 上也达到 67 FPS,在 RTX 5070 Ti 上达到 58 FPS。我们展示了可定制的射击游戏和驾驶游戏,其机制由引擎强制执行;并发布了代码、模型权重和低多边形游戏资产,以支持可玩游戏世界的研究与创作。
一句话总结
来自 SkyworkAI、香港中文大学、加州大学圣迭戈分校等机构的研究人员提出了 Matrix-Game 4.0,这是首个可游玩的游戏世界系统,通过可执行 harness 将游戏执行与视觉生成分离,并将轻量级引擎、多模态编码 agent 和蒸馏的自回归视频渲染器耦合起来,在单块 NVIDIA RTX 5090 上实现 480p 60 FPS 游戏画面,按键到显示延迟为 112 ms。
核心贡献
- Matrix-Game 4.0 被提出为首个构建在可执行游戏 harness 上的系统,它将游戏执行与视觉生成分离,使用轻量级引擎维护世界状态与规则,使用多模态编码 agent 生成自然语言游戏代码和动态场景描述,使用自回归视频渲染器将低多边形引擎代理转换为详细视觉画面,并以动态描述和记忆参考为条件。
- 渲染模型在像素对齐的低多边形与高保真视频对上训练,并被蒸馏为因果生成器,以一到两个去噪步骤生成四帧块,同时针对交互延迟进行推理优化。
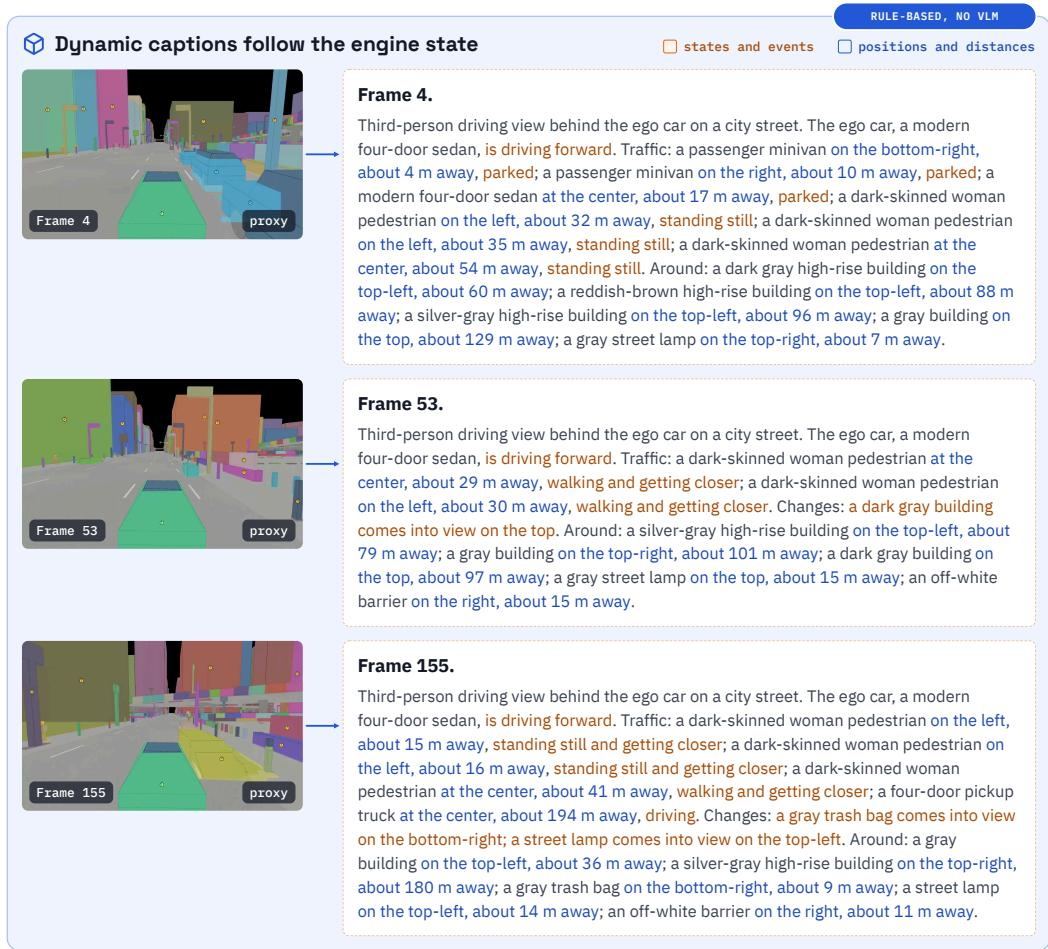
- 在单块 RTX 5090 上,系统实现 480p 60 FPS 游戏画面、112 ms 按键到显示延迟、83 FPS 单步稳态吞吐,并且峰值 GPU 显存为 18.2 GiB。固定提示吞吐在 RTX 5080 上达到 67 FPS,在 RTX 5070 Ti 上达到 58 FPS;演示包括可定制射击与驾驶游戏,代码、模型权重和低多边形游戏资产已发布。
引言
交互式世界模型(例如 Genie 系列)已将生成建模从被动视频观看扩展到主动环境交互,但主要依赖视频生成来维护世界状态的系统面临若干局限:没有持续的外部校正、自回归错误不断累积、基于帧的记忆随 rollout 长度增长,以及游戏机制有限。扩散模型也倾向于学习统计相关性而不是因果或物理结构,而可游玩世界进一步要求实时交互、丰富机制和共享的多人状态。作者提出了 Matrix-Game 4.0,这是一个将视频生成模型置于外部 harness 中的框架,从而把游戏执行与视觉渲染分离。多模态编码 agent 将玩家意图转换为游戏代码,轻量级游戏引擎维护持久世界状态和规则并渲染低多边形代理帧,视频模型将这些结构信号转换为详细视觉画面。该系统在单块消费级 GPU 上实现实时 480p 60 FPS 游戏画面,按键到显示延迟为 112 ms,并作为生成式游戏研究与开发的开源基础发布。
数据集
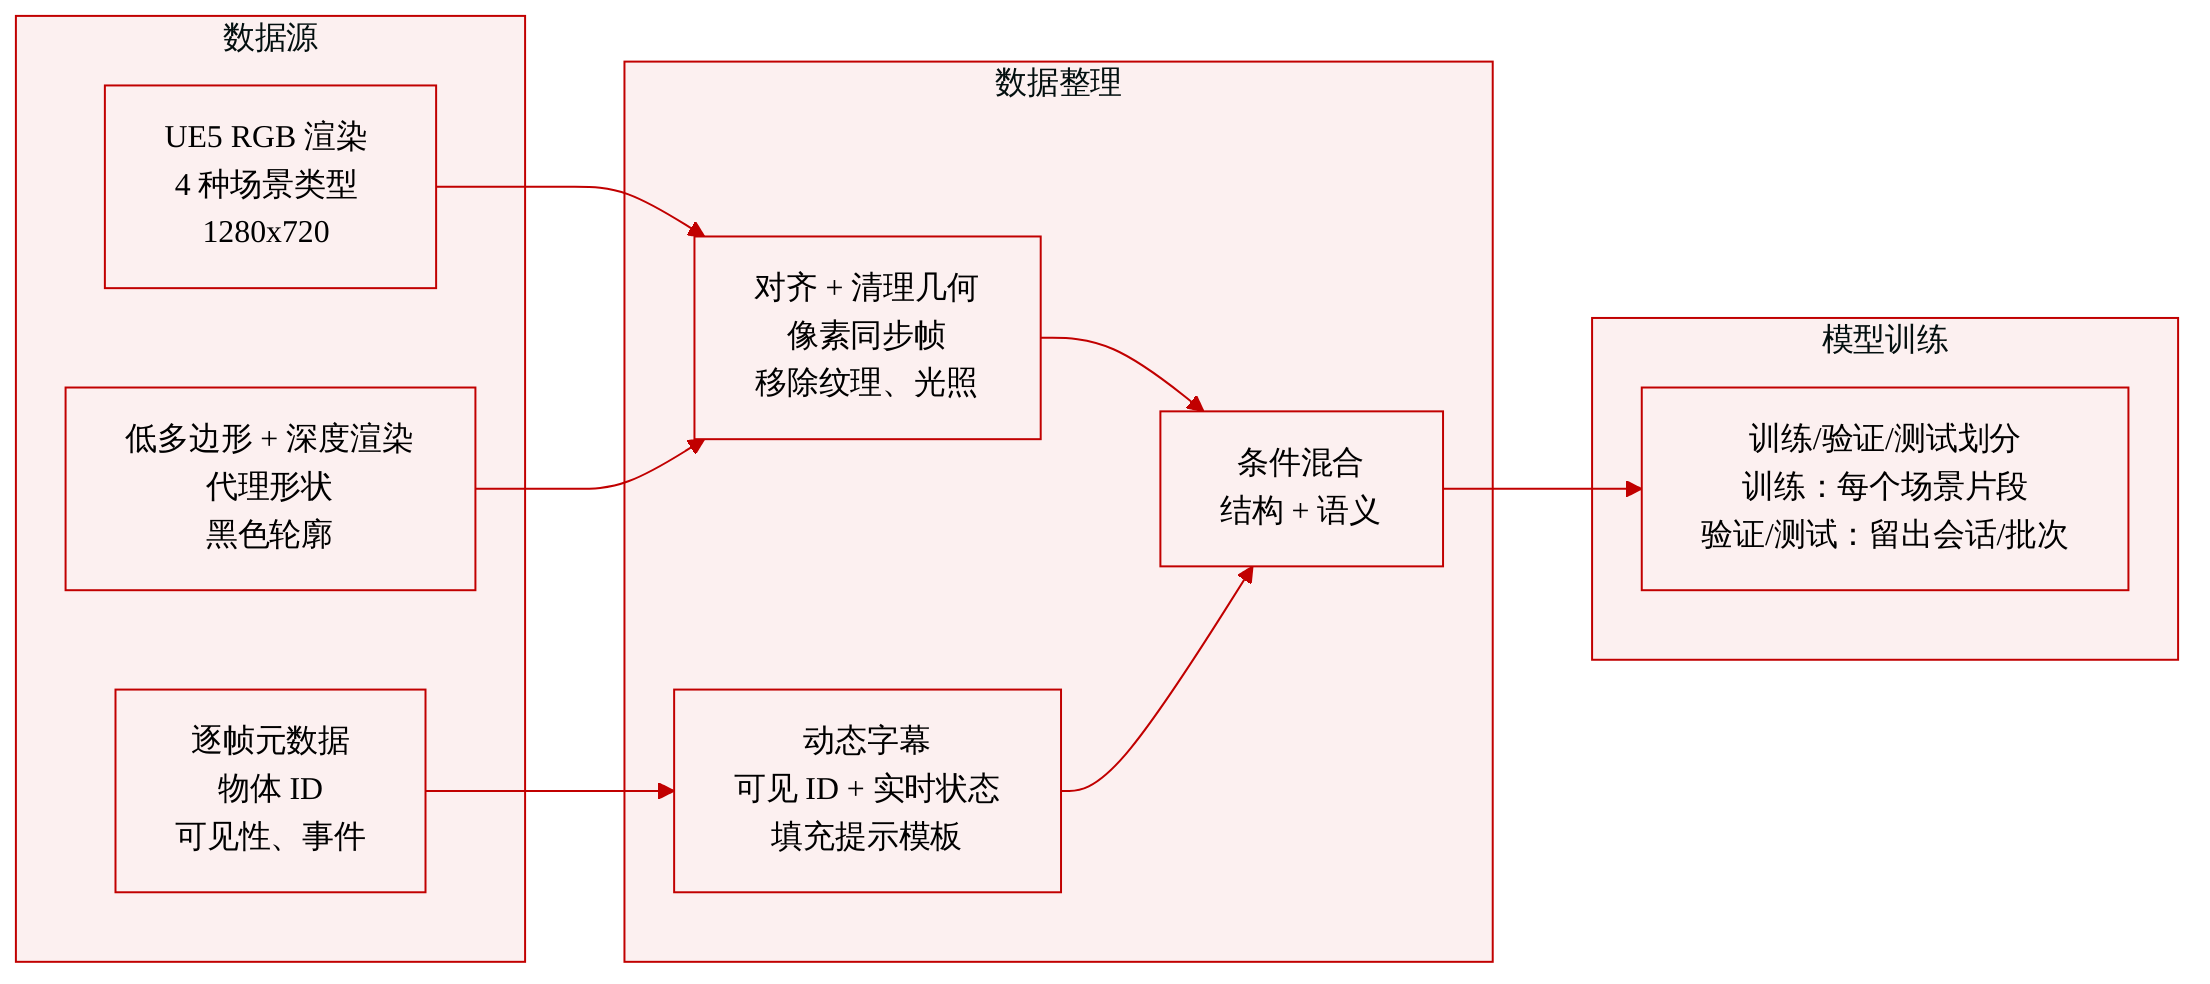
作者在 Unreal Engine 5 中构建了一个跨域数据集,其中包含对齐的低多边形与高保真视频,用于世界建模和视频生成。
数据集组成与来源:
- 四类场景:CitySample 超大城市、开阔沙漠、复杂城堡和高动态空战。
- 录制分辨率为 1280 × 720。每次采集包含三段对齐视频:UE5 RGB 渲染、低多边形结构渲染和代理几何深度渲染,以及逐帧元数据。
- 射击和空战片段约一分钟。
- 留出数据:城堡、沙漠和城市各留出三个完整采集会话;空战留出完整采集批次。任何留出会话都不贡献训练片段。
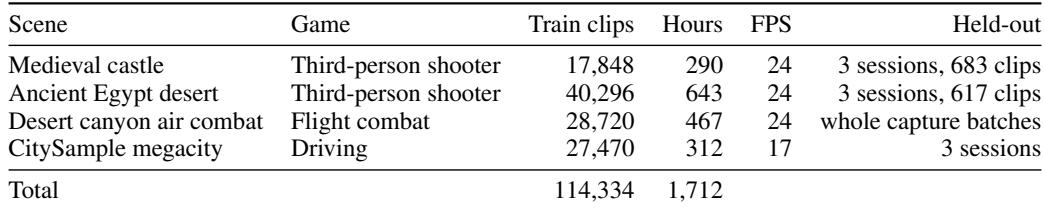
- 每个场景的训练数据量列于表 1。
处理与过滤:
- 场景被抽象为轻量级几何表示。相机轨迹和时间戳同步,因此低多边形帧与高保真帧逐像素对齐。
- 代理保留空间拓扑、刚体姿态和运动轨迹。
- 自适应几何拟合和视锥裁剪去除材质反射、高频纹理和复杂光照。
- 在代理中,天空为黑色,地面为灰色棋盘格。建筑和墙体变为纯色盒体与棱柱,树木变为一个圆柱加一个球体,角色变为方块人。每个图元都有黑色轮廓,没有纹理、反射或阴影。
- 本节未描述单独的裁剪策略。
元数据与动态描述:
- 逐帧元数据记录对象实例 ID、可见状态和因果交互事件。
- 每个对象 ID 关联一个语义描述。系统从游戏引擎读取可见对象和实时状态,并填充到提示模板中,生成与当前帧匹配的描述。
- 当视角变化、进入新区域或事件触发时,描述会更新。
在模型中的用途:
- 数据定义了从轻量级几何拓扑到高保真视觉画面的条件映射。
- 它为长 rollout 中的时空一致性和交互稳定性提供确定性监督。
- 低多边形代理提供结构:位置、布局和运动。动态描述提供语义:哪些对象在画面中以及它们当前的状态。二者共同约束生成,使帧遵循引擎产生的结构以及事件或状态变化。
- 本节未指定混合比例;训练片段按场景报告在表 1 中。
方法
Matrix-Game V4 旨在通过将视频模型置于一个维护世界状态并为游戏玩法提供可执行基础的 harness 中,构建真正可游玩的世界。该架构集成三个核心模块:游戏引擎、多模态编码 agent 和视频生成模型。游戏引擎充当外部管理器,维护世界状态、定义规则并输出结构渲染。多模态编码 agent 在玩家想法与游戏代码之间架起桥梁,将场景转换为视觉描述并实现新机制。视频模型基于结构渲染和文本描述自回归地生成逼真的未来帧。
为了训练渲染模型,作者构建了一个包含对齐低多边形与高保真视频的跨域数据集。采集管线将复杂场景抽象为轻量级几何表示,其中建筑变为纯色盒体,角色变为方块人,同时保留空间拓扑和运动轨迹,去除高频纹理。该低多边形代理为视频模型提供结构约束。
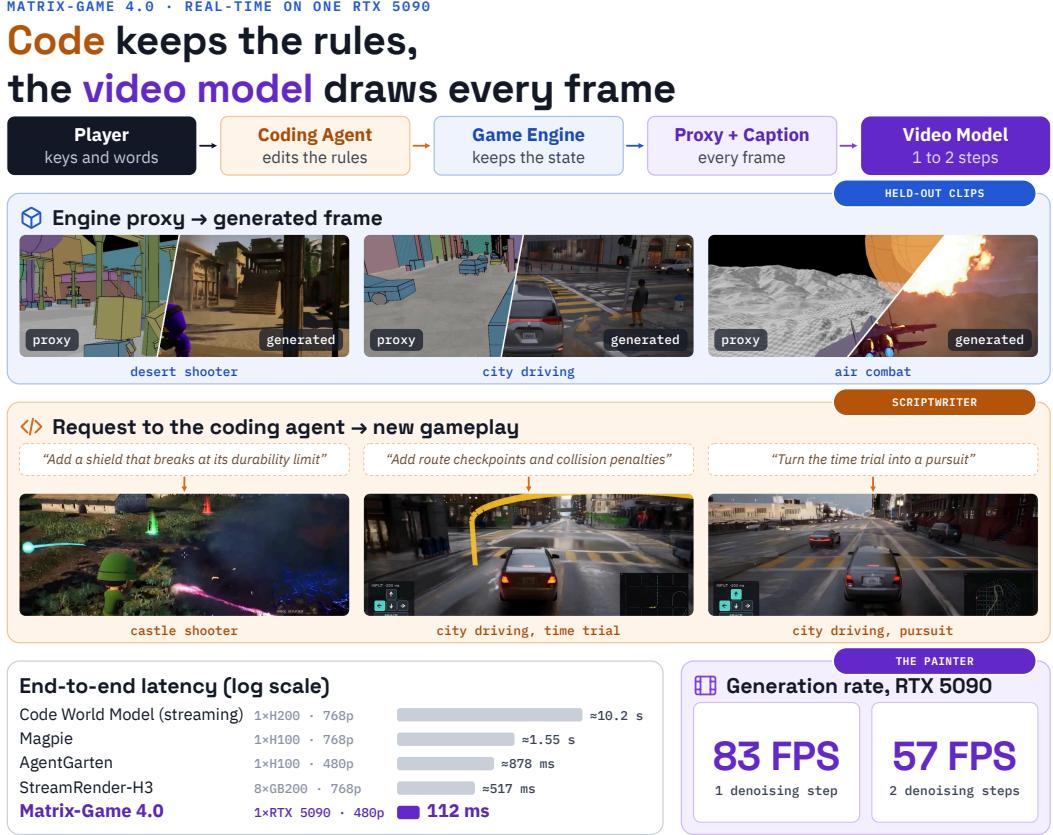
在交互环境中,视觉上下文会随着每个玩家操作而变化。为解决这一问题,系统采用动态描述。场景中的每个对象都通过实例 ID 关联到一条语义描述。系统从游戏引擎读取当前可见对象及其实时状态,并填充提示模板。这确保视频模型接收到关于对象位置、状态和事件的最新语义条件,补充来自低多边形代理的结构信息。
渲染模型基于 Wan2.2 5B Fun Control 变体构建,并被改造为视频到视频模型。它对每个 chunk(表示一个 latent 帧或四个视频帧)使用四个输入进行条件化:低多边形代理、动态描述、空间记忆参考帧和序列的第一帧。噪声 latent 与经 TAEHV 编码的低多边形代理沿通道维拼接,形成 148 个通道,并被 patchify 为每个 latent 帧 405 tokens。
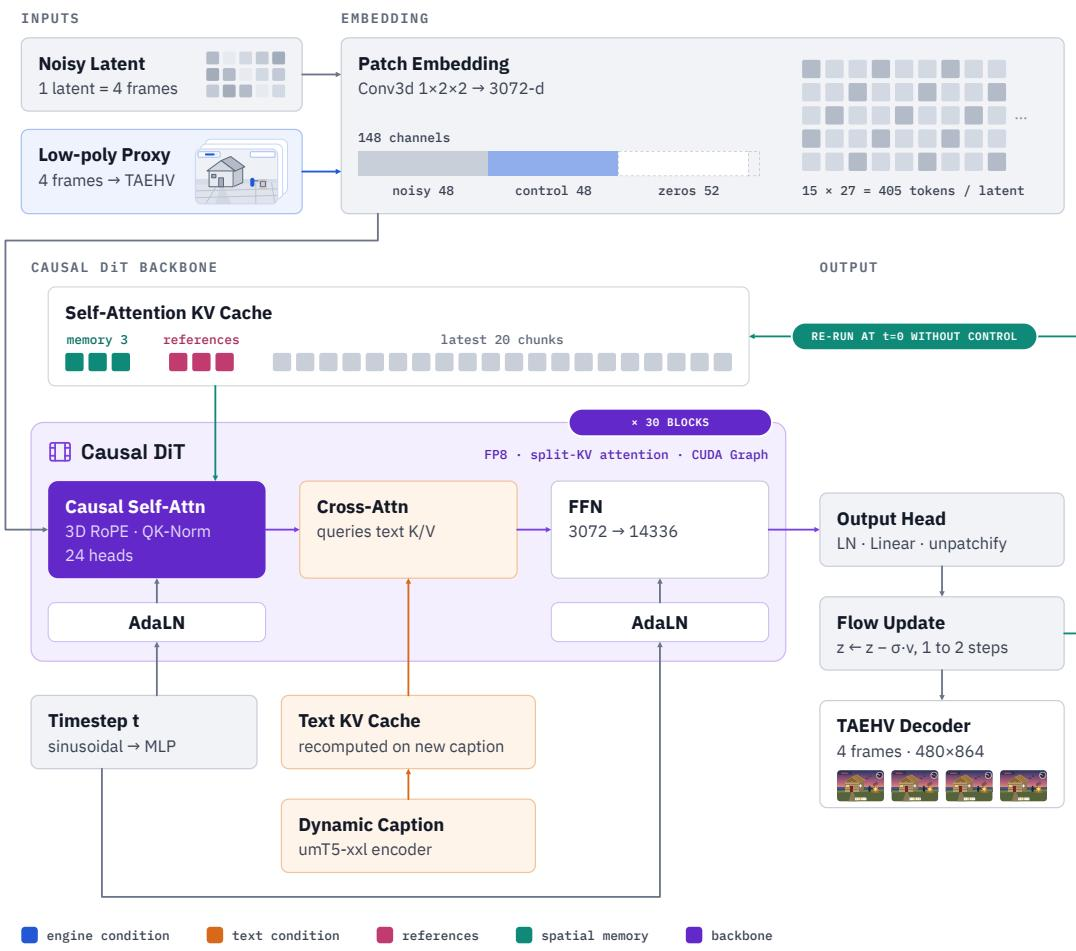
骨干网络由 30 个 causal DiT block 组成。每个 block 在包含空间记忆帧、参考帧和最近 20 个 chunk 的 KV cache 上执行 causal 自注意力。它还对来自 umT5-xxl 编码动态描述的缓存文本 key 和 value 执行交叉注意力。输出头预测速度,latent 通过 flow matching 进行一到两步更新,然后由轻量级 TAEHV 解码器解码。生成一个 chunk 后,模型在完成的 latent 上以 t=0 重新运行,且不使用控制输入,从而将干净的 key 和 value 写入缓存,供后续 chunk 使用。
训练从监督微调开始。模型从预训练权重出发,在 81 帧窗口上使用 flow-matching 目标微调为双向视频到视频模型。窗口以低多边形代理、动态描述、第一帧以及最多三个上下文帧作为空间记忆进行条件化。为了支持无分类器引导,第一帧、提示和代理控制分别以 0.3、0.2 和 0.2 的概率被丢弃。
为实现实时生成,作者分三个阶段应用 Causal Few-Step Distillation。阶段 1 使用 teacher-forced 自回归扩散将双向模型转换为 causal 自回归教师,其中每个 latent 帧只关注其之前的干净 ground-truth 帧。阶段 2 进行 causal 一致性蒸馏。在线 student 经过训练,以匹配由冻结的 causal 教师更新的 EMA student 的预测,从而支持四步生成。阶段 3 使用带非对称 DMD 的分布匹配。student 从自身的自回归 rollout 中学习,匹配来自冻结双向模型的真实 score。该阶段引入滚动缓存和混合代理编码,以与部署推理设置对齐,最终将每个 chunk 的去噪步骤减少到一到两步。
为实现实时性能,实施了多项优化。DiT 骨干计算被记录为 CUDA Graph,并在单次启动中重放,使用 8 位权重。为 RoPE、归一化和 FP8 量化编写了融合 GPU kernel。KV cache 作为环形缓冲区运行,在窗口滑动时原地覆盖最旧的槽位。最后,完整 Wan VAE 解码器被替换为轻量级 TAEHV 解码器,模型 I/O 在异步流水线中运行,显著降低延迟并提高稳态生成速率。
实验
实验将 Matrix-Game 4.0 作为交互式视频生成系统进行评估,并通过 CUDA graph、融合 kernel、key/value cache 环形缓冲区和轻量级解码器优化实时推理,显著提高帧率并降低响应延迟。三个蒸馏游戏模型上的留出 rollout 显示,生成帧在长序列中保持低多边形代理布局,同时添加稳定纹理、效果和角色外观。与近期交互式系统的比较表明,Matrix-Game 4.0 实现最低端到端延迟,并能在单块消费级 GPU 上运行。编码 agent 实验进一步验证了自然语言游戏玩法定制,规则更改在引擎中执行,并由视频模型忠实渲染。
数据集包含跨四个 UE5 场景类型的成对低多边形与高保真视频:城堡、沙漠、空战和城市。其总共包含超过 114,000 个训练片段和约 1,700 小时,其中沙漠射击贡献最大份额,城堡射击最小。大多数场景以 24 FPS 采集,而城市驾驶场景以 17 FPS 运行,留出片段按完整采集会话或批次分离。古埃及沙漠射击提供最大训练划分,而中世纪城堡射击提供最小训练划分。除城市驾驶场景以 17 FPS 采集外,所有场景均以 24 FPS 采集。城堡、沙漠和城市的留出片段按完整采集会话分组,空战按完整采集批次分组。
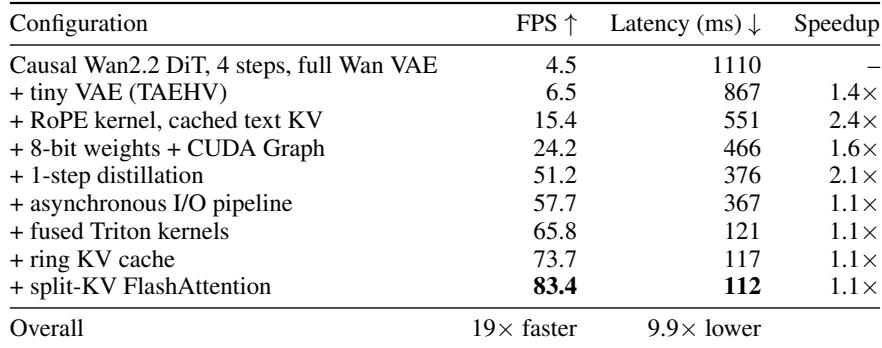
累积推理优化将稳态生成从每秒几帧提高到超过 65 FPS,并将延迟从超过一秒降低到约 120 ms。最大的吞吐量提升来自添加带缓存文本 key 和 value 的 RoPE kernel,以及一步蒸馏。最终融合 kernel 主要降低延迟,而非提高太多吞吐量。带缓存文本 KV 的 RoPE kernel 相对前一配置提供最大加速,达到 2.4 倍。Fused Triton kernel 仅将 FPS 提高 1.1 倍,但将延迟从 367 ms 降低到 121 ms。
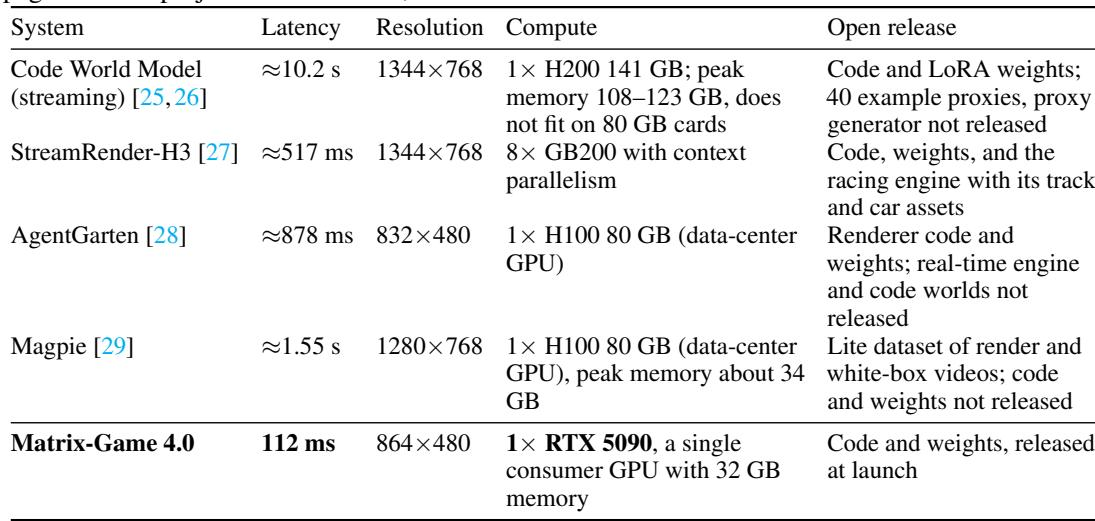
近期实时交互式生成系统在延迟、硬件要求和发布开放性方面差异很大。Matrix-Game 4.0 报告了大幅领先的最低端到端延迟,并且是所比较系统中唯一在单块消费级 GPU 上运行的系统。其代码和权重也在发布时公开。Matrix-Game 4.0 的端到端延迟约为第二快系统的五分之一。它是唯一在单块消费级 GPU 上运行的系统,其他系统依赖数据中心 GPU 或多 GPU 配置。
评估使用跨四个 UE5 场景类型的成对低多边形与高保真视频,包含超过 114,000 个训练片段,并按采集会话或批次分组留出划分。推理实验显示,累积优化将吞吐量从每秒几帧提高到实时水平,并将延迟降低到交互水平,最大收益来自缓存文本 key/value RoPE 和一步蒸馏,而融合 kernel 主要降低延迟。与近期实时系统的比较发现,Matrix-Game 4.0 实现最低端到端延迟,能在单块消费级 GPU 上运行,并在发布时提供代码和权重。