Command Palette
Search for a command to run...
PAR:用于状态跟踪中长度泛化的进度对齐循环
PAR:用于状态跟踪中长度泛化的进度对齐循环
摘要
循环语言模型在测试时可以运行更多迭代,但更多迭代未必能帮助其解决更长的问题。对于序列状态跟踪,最终答案监督并未指定每次迭代应推进多远,而反复更新可能改变循环状态的尺度。我们提出进度对齐循环(PAR),该方法训练第 ?? 次迭代的预测,使其与前 ?? 次操作后的状态匹配,并将循环状态重新缩放至其首次迭代范数。在 swap-?? 上,一个在最多 32 次移动上训练的 Qwen2.5-0.5B 模型在 512 次移动时达到 95.5% 的平均全状态准确率,即训练长度的 16 倍;相比之下,同一骨干网络上 RLT 报告为 55.7%,显式思维链为 0.8%。受控的 ?? 消融实验表明,移除范数锚定会使外推倍数从 16× 降至 2.2× 以下,而将进度对齐目标替换为最终答案监督则使其降至最多 8×。一种学习到的完成读出机制在未给定停止深度的情况下选择何时作答。当中间标签不可用时,前缀自蒸馏仅利用最终答案,从较短的问题前缀中归纳出对应关系。这些收益适用于多个序列状态跟踪任务,确立了深度外推所需的任务结构。这些发现支持同时训练中间预测和状态尺度,以使额外的循环深度对更长的问题更有用。
一句话总结
来自蚂蚁国际和新加坡国立大学的研究者提出了 Progress-Aligned Recurrence (PAR),该方法训练循环模型将迭代预测与部分状态对齐并重新归一化循环状态,使在 32 步上训练的 Qwen2.5-0.5B 模型在 512 步时达到 95.5% 的全状态准确率,较此前方法实现 16× 外推。
核心贡献
- 本文提出 Progress-Aligned Recurrence (PAR),将每个循环迭代与执行相应数量问题操作后的状态对齐,并应用 RMS 范数锚定来稳定跨迭代的循环状态尺度。
- PAR 进一步扩展了可学习的完成读出机制,在未提供停止深度的情况下选择何时作答;并通过前缀自蒸馏仅利用最终答案从较短问题前缀中学习中间目标。
- 实验表明,在最多 32 步上训练的 Qwen2.5-0.5B 模型在 swap-??_5 上达到 512 步时 95.5% 的平均全状态准确率,而 RLT 为 55.7%,显式思维链为 0.8%;消融实验分离出范数锚定和进度对齐目标两者的必要性。
引言
长度泛化关注在短问题上训练的模型能否解决同一任务中更长的实例,而规则表链和对象跟踪等顺序状态跟踪任务提供了受控环境,因为规则保持不变,但操作数量会增加。循环语言模型可以通过对隐藏状态重复应用共享 Transformer 块来随序列长度增加计算深度,但先前工作表明,仅增加参数或运行更多迭代本身都不足够,而且在每个循环上给予最终答案监督可能会鼓励提前预测并削弱外推能力。中间状态目标有助于定义进度,但在循环状态尺度未受控制时,它们在超出短距离外推后仍会失去准确性。作者提出 Progress-Aligned Recurrence (PAR),将每个迭代与执行前 k 个操作后的状态匹配,并使用 RMS 范数锚定来控制循环之间传递的状态尺度。作者进一步增加可学习的停止规则和前缀自蒸馏,以仅从最终答案标签中获得中间目标,并在状态跟踪任务上实现了 16 倍外推。
方法
作者引入 PAR 框架,在语言模型中建立深度与长度的对应关系,使其能够随问题复杂度动态扩展计算。架构和训练流程的直观概览见框架图。
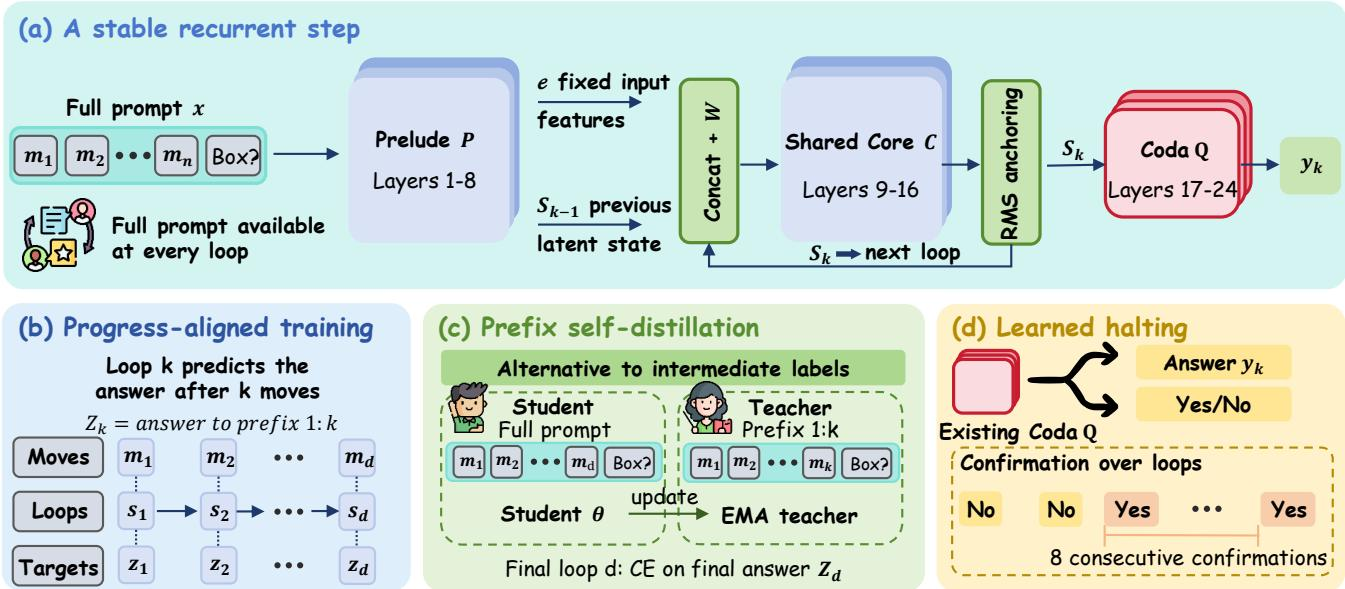
为实现该架构,作者对标准 Transformer 进行改造,将其层拆分为三个不同组件:前奏(prelude)、权重共享核心(weight-tied core)和尾声(coda)。前奏处理初始提示,生成静态输入特征。这些特征与上一轮的潜在状态拼接后,通过适配器投影到共享核心。核心根据以下方程对状态进行迭代:
sk=C(W[e;sk−1]),k=1,…,R尾声可以从任意给定的迭代中读出答案。为确保改造后的初始模型在运行单次迭代时计算与父网络完全相同的函数,适配器初始化时仅投影静态输入特征。
定义迭代需要将模型的循环步骤与计算的实际进展对齐。对于需要特定数量的顺序步骤才能解决的问题,作者强制建立严格对应关系,即每次循环迭代必须将计算推进恰好固定数量的步骤。训练损失通过将模型在每次迭代的输出与对应该特定进展点的中间答案进行比较来计算:
LPAR=k∈K∑CE(Q(sk),zmin(ck,d))这防止模型走捷径,并确保迭代次数随问题深度线性扩展。
由于模型在外推过程中会数百次应用该步骤映射,状态表示的任何漂移都可能改变所计算的函数。为保持步骤映射的平稳性,作者实现了状态范数锚定。每次迭代后,每个 token 的状态都被重新缩放,以匹配其第一次迭代状态的 RMS 范数,从而在不影响单次迭代行为的情况下防止范数漂移。此外,为处理查询位置远离早期移动的长提示,在短期微调阶段采用位置拉伸技术对位置索引进行倍增,从而确保稳健外推。
为了实现自主推理,该框架引入了可学习的停止机制。尾声被训练用于输出完成概率,预测计算是否已在当前迭代完成。推理时,模型选择完成概率超过阈值且后续迭代确认窗口也一致同意的第一个迭代。这使模型能够动态终止计算,而无需外部深度信号。
最后,为将这种对应关系扩展到缺少中间步骤标签的场景,作者采用前缀自蒸馏。在该方法中,指数移动平均教师模型评估截断提示,为学生模型的早期迭代生成软目标。学生模型通过 KL 散度匹配这些分布,从而仅在最终答案监督下有效诱导中间状态表示。
模型使用 AdamW 训练,并为适配器和网络其余部分设置特定学习率,采用预热调度,并在多种训练深度上训练一个 epoch。训练和测试期间均不生成中间 tokens,从而保证计算高效。
实验
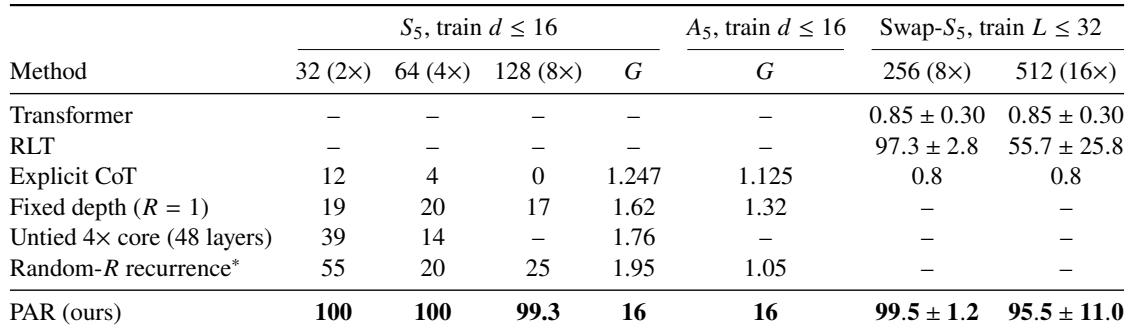
实验在置换群字问题和现有顺序基准上评估 PAR,并将其与固定深度、循环、非权重共享和显式思维链基线进行比较。主要结果表明,PAR 学习到的循环步骤映射能够泛化到更长的序列,在不同模型规模上保持接近上限的准确率,最高达到训练深度的 16 倍,而固定深度和思维链模型无法外推。消融实验确认,正确的迭代监督和平稳的状态动态都是必要的,并且当步骤标签或长距离位置编码成为问题时,可学习的停止信号或位置拉伸微调会有所帮助。在结构化任务上,该方法支持顺序多步推理,但并未在并行图可达性任务上带来相同收益。
PAR 在深度外推上显著优于基线,在 swap 协议上保持近乎完美的全状态准确率直到最长的测试倍数,并在置换任务上达到可测量的最大外推倍数。固定深度、循环、非权重共享和显式思维链模型则性能下降,其中显式思维链在最长外推之前已降至随机水平。消融实验表明,受监督的迭代目标和范数锚定对于可靠的外推都是必要的。在 swap 协议上,PAR 在 16 倍外推时保持全状态准确率高于 95%,而 RLT 降至 55.7%。在置换任务上,PAR 在多个种子中达到可测量的最大外推倍数,而固定深度、循环和非权重共享基线均低于 2 倍。显式思维链在训练范围内表现良好,但在 swap 任务上到 8 倍时崩溃至随机水平。与 PAR 相比,移除范数锚定或改变最终答案监督都会显著降低长深度准确率。
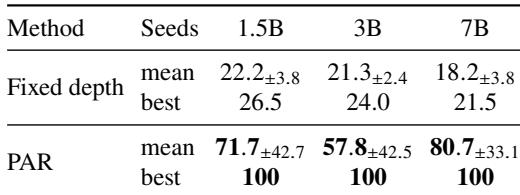
PAR 在所有评估的 Qwen2.5 骨干模型上,在 S5 16 倍外推设置中显著优于固定深度基线。最佳 PAR 种子在每个骨干模型的 horizon 256 处保持 100% 准确率,而固定深度模型仍接近随机水平。PAR 的跨种子平均提升较大但存在波动,且收益并不随骨干规模单调变化。表现最好的 PAR 运行在所有测试的 Qwen2.5 骨干模型上于 16 倍 horizon 达到 100% 准确率。固定深度基线仍接近随机水平,所有骨干模型的最佳准确率均低于 27%。PAR 在每个模型规模上都比固定深度带来大幅平均准确率提升,但种子间方差较大。PAR 的平均准确率在 7B 模型上最高,在 3B 模型上最低,未呈现简单的单调扩展趋势。
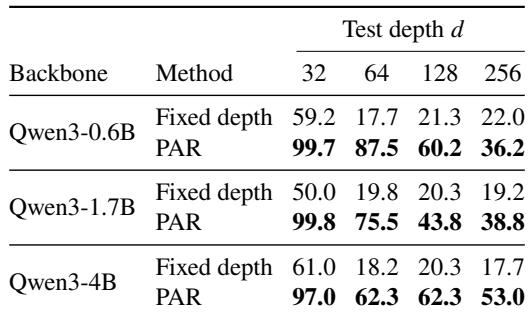
在测试的 Qwen3 骨干模型中,PAR 在每个评估测试深度上均持续优于固定深度模型。PAR 的准确率在最短外推深度接近上限,而固定深度性能迅速下降,并在更长 horizon 上保持接近随机水平。该优势一直持续到训练深度的十六倍,其中最大骨干模型表现出最强的长 horizon 结果。在最短测试深度,PAR 在所有三个 Qwen3 骨干模型上达到接近上限的准确率,而固定深度模型仅得分约一半正确。固定深度准确率在第二个测试深度降至接近随机水平,并在每个骨干模型上直到最长 horizon 都保持低位。PAR 在训练深度的八倍范围内始终保持对固定深度的大幅领先,在十六倍时,4B PAR 模型取得最高的长 horizon 平均准确率。
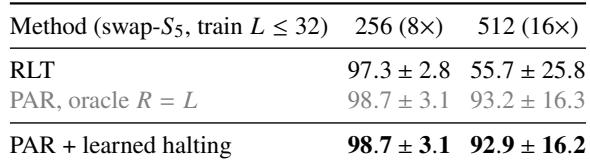
联合训练的可学习停止机制能够跟踪 oracle 停止策略,并在没有问题长度信息的情况下保持较高的全状态准确率。在最长的评估外推中,它避免了循环基线所出现的大部分性能下降,并保持在接近 oracle 性能的水平。这表明显式停止对于可靠的长度外推很重要。在评估的两个外推长度上,可学习停止均与 oracle 停止基线非常接近。在最长外推中,可学习停止保持高准确率,而 RLT 基线显著退化,并且跨种子变得更加不稳定。
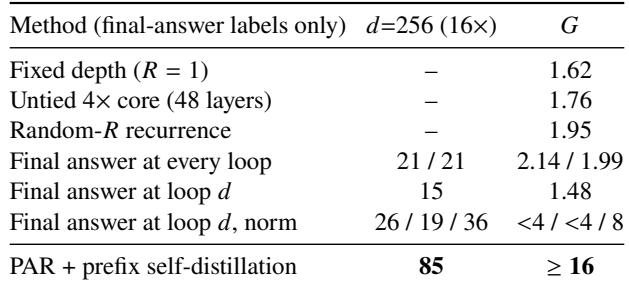
在 S5 任务上以 16 倍训练深度评估的仅最终答案训练方案中,前缀自蒸馏是唯一保持高准确率的方法,达到 85%。其他方法显著退化,大多数外推能力有限,有些在最长深度之前已降至随机水平。这表明仅最终答案标签与前缀自蒸馏结合时,也能够支持较强的长度外推。前缀自蒸馏是所评估的仅最终答案方法中唯一在 16 倍训练深度下保持高准确率的方法,达到 85%。其他最终答案监督方案外推较弱,在 16 倍训练深度下的报告准确率大多在百分之十几到二十几,且外推差距小得多。
在 swap 和置换深度外推任务中,PAR 在远超训练深度直至训练 horizon 的 16 倍处仍保持近乎完美的全状态准确率,而固定深度、循环、非权重共享和显式思维链基线则退化或降至随机水平。在多个 Qwen2.5 和 Qwen3 骨干模型上的评估显示,PAR 在每个测试深度上均持续优于固定深度模型,尽管提升因种子而异,且不随模型规模单调变化。消融实验确认,受监督的迭代目标和范数锚定对于可靠外推是必要的,可学习停止与 oracle 停止紧密匹配,前缀自蒸馏是唯一在长 horizon 下保持高准确率的仅最终答案训练变体。