Command Palette
Search for a command to run...
MemT-1.0:迈向记忆原生进化
MemT-1.0:迈向记忆原生进化
摘要
记忆原生进化要求将记忆作为基础模型的一种内在能力,使它们能够持续积累和利用信息。为此,我们提出了 MemT-1.0,这是一种将记忆内化为模型计算的一部分的记忆基础模型新架构。MemT-1.0 以 Metis 为基础,采用 Gated DeltaNet-2,并在每一轮中具有稳定的 token 级记忆更新机制。我们进一步引入 Mixture-of-Storage 来扩展原生记忆容量。在经过审慎的骨干准备之后,我们开发了一个由持续预训练和后训练组成的两阶段训练流程,并得到 34B 个 token 的训练数据以及高效训练与推理基础设施的支持。我们发布了由 MemT-1.0-Nano 和 MemT-1.0-Flash 组成的模型家族,并对记忆能力与通用能力进行了全面评估。结果表明,它们平均而言优于参数化记忆基线,并与检索增强方法保持竞争力,同时在很大程度上保持了通用能力。在 128K 个 token 的历史长度下,MemT-1.0-Nano 相较于全上下文 KV 缓存实现了约 1.86 倍的端到端推理加速和 66 倍的持久存储缩减。通过内化检索到的过程性经验,MemT-1.0 提高了智能体任务的成功率,从而为迈向记忆原生进化提供了切实一步。
一句话总结
MemTensor团队推出MemT-1.0,一个记忆原生基础模型,集成Gated DeltaNet-2与稳定token级记忆更新及存储混合扩展机制,基于34B tokens训练;发布的MemT-1.0-Nano和MemT-1.0-Flash在平均表现上优于参数化记忆基线,与检索增强方法保持竞争力,在128K tokens历史长度下实现约1.86倍端到端推理加速和相对全上下文KV缓存的66倍持久存储降低,并通过内化检索到的程序性经验改进agent任务成功率。
核心贡献
- 推出MemT-1.0,一个记忆原生基础模型架构,通过Gated DeltaNet-2将持久记忆集成到模型计算中,具有稳定token级记忆更新机制和存储混合机制以扩展原生记忆容量。
- 制定细致的骨干准备方案,采用持续预训练与后训练的两阶段训练流程,基于34B tokens,发布MemT-1.0-Nano和MemT-1.0-Flash模型家族。
- 报告MemT-1.0模型在平均表现上优于参数化记忆基线,并与检索增强方法保持竞争力;MemT-1.0-Nano在128K tokens下实现约1.86倍端到端推理加速和66倍存储降低,并在SWE-bench Verified和Multilingual上的成功率相比无经验骨干分别提高7.6和8.3个百分点。
引言
基础模型正日益内化推理和多模态等能力,记忆是自然的下一个目标,因为记忆允许模型积累经验而无需携带原始上下文。之前包括Metis在内的记忆原生工作显示记忆可以成为原生模型能力,但其token选择方法在稳定性和容量扩展方面仍留有挑战。作者推出MemT-1.0,保留动态局部记忆和可训练超参数记忆,但用基于Gated DeltaNet-2的稳定token级更新取代token选择,并添加存储混合以扩展原生记忆容量。作者通过包含34B tokens的两阶段流程训练Nano和Flash模型变体,在11个记忆基准上评估,展示在保持通用能力的同时改善历史信息利用。
数据集
数据集描述
-
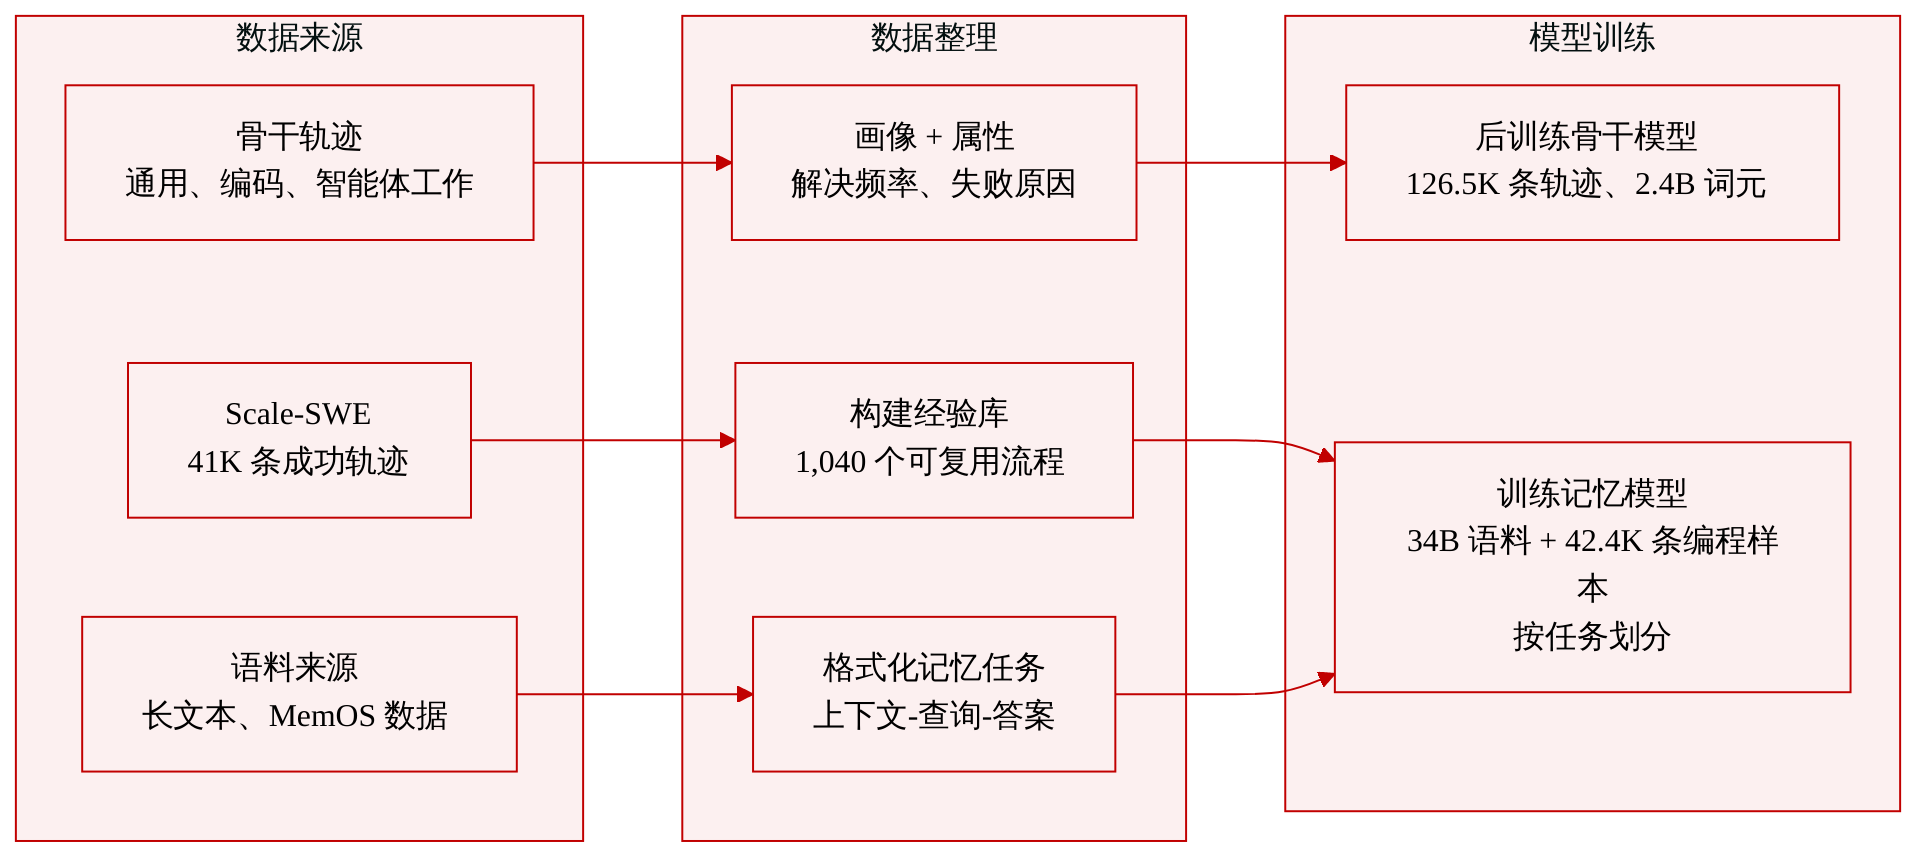
骨干准备混合数据。 作者对DeepSeek-V4-Flash进行后训练,数据来自三个方向:通用能力、agent编码和agent工作。数据构建遵循三个步骤:能力剖析、干预归因和能力条件合成。可靠解决的任务提供回放数据。偶尔解决的任务提供骨干自身通过程序化验证器的尝试。因缺少约定或程序而导致失败的情况,通过引导采样或风格匹配的更强模型示范来学习。在干预下仍失败的被排除,知识缺口主要交由检索或原生记忆处理。最终混合包含126.5K条轨迹、总计2.4B tokens,其中1.1B为损失承担tokens。按数量计,56.4%为通用数据,18.0%为agent编码,25.3%为agent工作;agent轨迹贡献约90%的损失承担tokens。
-
MemT-1.0训练语料。 作者构建34B tokens的语料用于训练MemT-1.0。其中20B tokens为持续预训练数据,来自大规模通用语言建模语料,强调长文本和序列文本。其余14B tokens为后训练数据,分为三类:记忆原生语言建模数据、原生记忆存储与利用数据和记忆任务数据。存储与利用任务包括摘要、续写和压缩。记忆任务数据强化选择性保留和长距离依赖解析。部分语料基于匿名化的内部MemOS交互数据。所有后训练类别采用统一的上下文-查询-答案格式:上下文先通过原生记忆存储,然后模型接收查询并基于记忆状态生成目标答案。
-
经验引导的agent编码数据。 作者从Scale-SWE发布的41,057条成功编码轨迹构建经验库。采用轨迹标注、程序化策略归纳、策略聚类、经验生成和质量审计。过滤后,经验库包含1,040条可复用的编码经验。每条经验记录触发条件、推荐执行步骤、适用性约束和验证程序。对于训练样本,作者在Scale-SWE环境中使用AweAgent框架,用Qwen3.6-35B-A3B生成18,820条原始编码轨迹。在不成功轨迹中识别断点,注入检索到的经验子集,评估199,500个断点-经验变体。保留45,481条成功续写,进一步质量过滤后得到42,403个训练样本。样本按任务划分以防止训练和验证之间的泄漏。每个样本表示为至断点的原始轨迹前缀、注入的经验子集和成功续写。
-
数据使用方式。 骨干准备混合数据用于在附加原生记忆前对DeepSeek-V4-Flash进行后训练;随后冻结骨干。34B tokens语料支持MemT-1.0训练。经验条件编码样本用于MemT-1.0-Nano的特定应用后训练:经验写入原生记忆,原始前缀在禁用记忆读取的情况下回放,断点后模型预测成功续写。经验文本和轨迹前缀不计入损失。最终设置使用全后缀监督的知识蒸馏。
-
处理说明。 未描述明确的裁剪策略。主要格式选择包括MemT-1.0后训练的统一上下文-查询-答案结构,以及经验条件agent训练的前缀/经验/续写结构。
方法
MemT-1.0在包含离散步骤的多步场景中建模。每一步中,自回归生成过程基于输入和先前生成的tokens,同时有状态模型参数更新以纳入新信息。作者在通用因果语言模型上构建MemT-1.0,为选定的标准Transformer块增加原生记忆块,以维护来自先前信息的记忆。如下图所示:
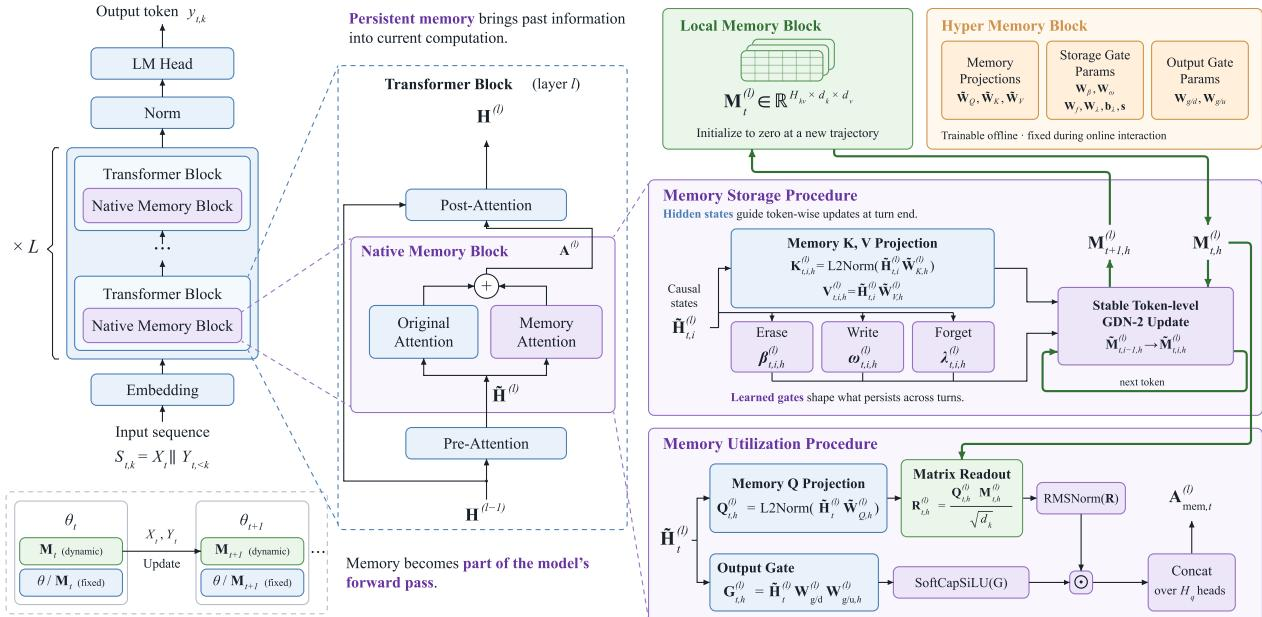
架构集成局部记忆块和超参数记忆块。局部记忆块将在线信息存储为动态记忆状态,在新轨迹开始时初始化为零。超参数记忆块包含可训练参数,包括记忆投影、门控投影(如擦除门、写入门和遗忘门)以及记忆输出门控。这些参数在训练期间优化,在线交互时保持固定。
原生记忆通过两个并行过程运作:存储和利用。记忆存储过程使用基于GDN-2的稳定token级更新机制更新动态记忆状态。该过程计算记忆键和值,以及擦除门、写入门和遗忘门,执行token级更新以防止发散。记忆利用过程从累积的记忆状态中检索信息。该过程计算记忆查询并通过矩阵读出读取信息,然后由使用SoftCapSiLU激活的输出门进行门控,最后与原始注意力输出拼接相加。
为联合扩展在线记忆容量和可训练记忆参数,作者引入存储混合(MoS)。如下图所示:
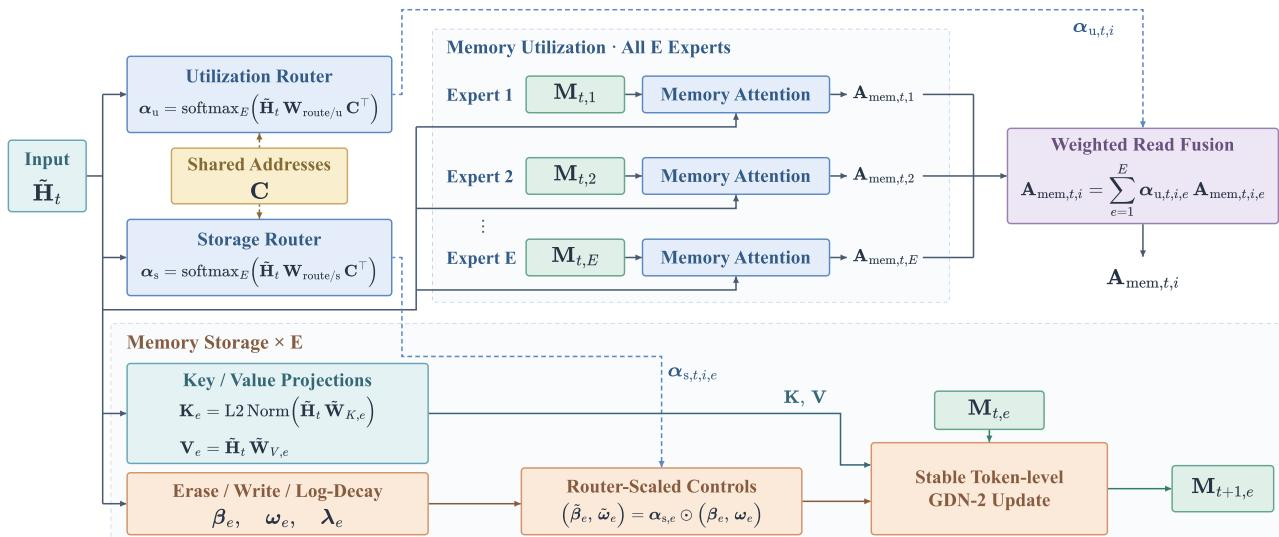
MoS将每个原生记忆块扩展为多个并行记忆专家。与传统的稀疏混合专家不同,MoS在所有记忆专家上采用稠密路由。引入两个稠密路由器用于记忆利用和存储,共享一个可训练的专家地址矩阵。利用路由器计算路由概率以加权各专家的记忆注意力输出,而存储路由器调制每个专家状态更新的擦除门、写入门和对数衰减。
MemT-1.0的训练包括骨干准备、数据构建和多阶段训练流程。作者首先后训练DeepSeek-V4-Flash骨干,以提高在偶尔解决的任务上的可靠性,使用能力剖析、干预归因和能力条件合成三步流程。如下图所示:
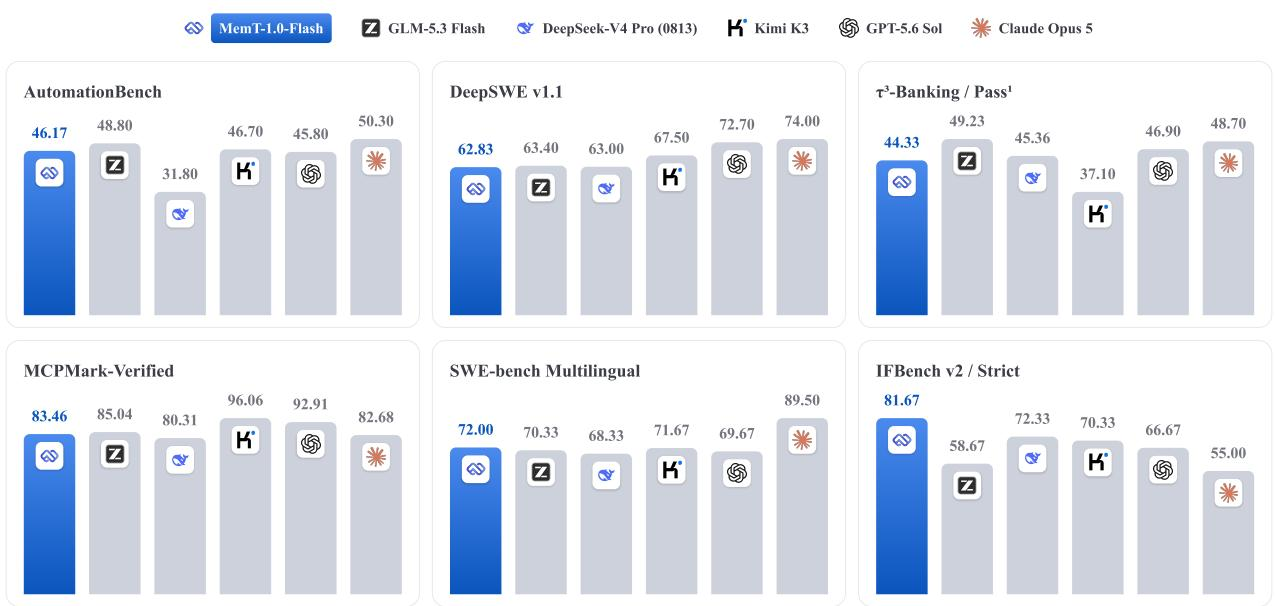
此骨干准备在附加原生记忆前显著提升多个基准上的性能。准备好的骨干随后被冻结,作为宿主模型和全上下文蒸馏教师。
对于数据构建,作者汇编34B tokens的大规模训练语料,包括持续预训练数据和后训练数据。后训练数据组织为记忆原生语言建模数据、原生记忆存储与利用数据和记忆任务数据,均采用统一的上下文-查询-答案格式。
核心训练目标通过离策略蒸馏框架,在给定全上下文的条件下对齐模型能力与骨干。冻结骨干作为教师,提供全历史上下文上的下一个token分布。MemT-1.0学生接收当前输入和代表先前历史的传入局部记忆状态。训练损失结合截断教师分布的前向KL散度和下一个token的交叉熵损失。
训练分两个阶段进行。首先,持续预训练建立带原生记忆的基本语言建模能力。输入序列划分为连续段,学生在当前段内执行因果语言建模,同时依赖原生记忆访问先前段的信息,使用交叉熵损失。其次,后训练将模型适配到基于原生记忆的响应生成。历史上下文通过原生存储过程处理以产生记忆状态,模型使用基于KL的蒸馏训练以逼近全上下文教师输出,优化集中在响应tokens上。
为支持经验引导的agent执行,作者开发一个框架,使MemT-1.0在长周期任务执行期间存储并复用程序性经验。如下图所示:
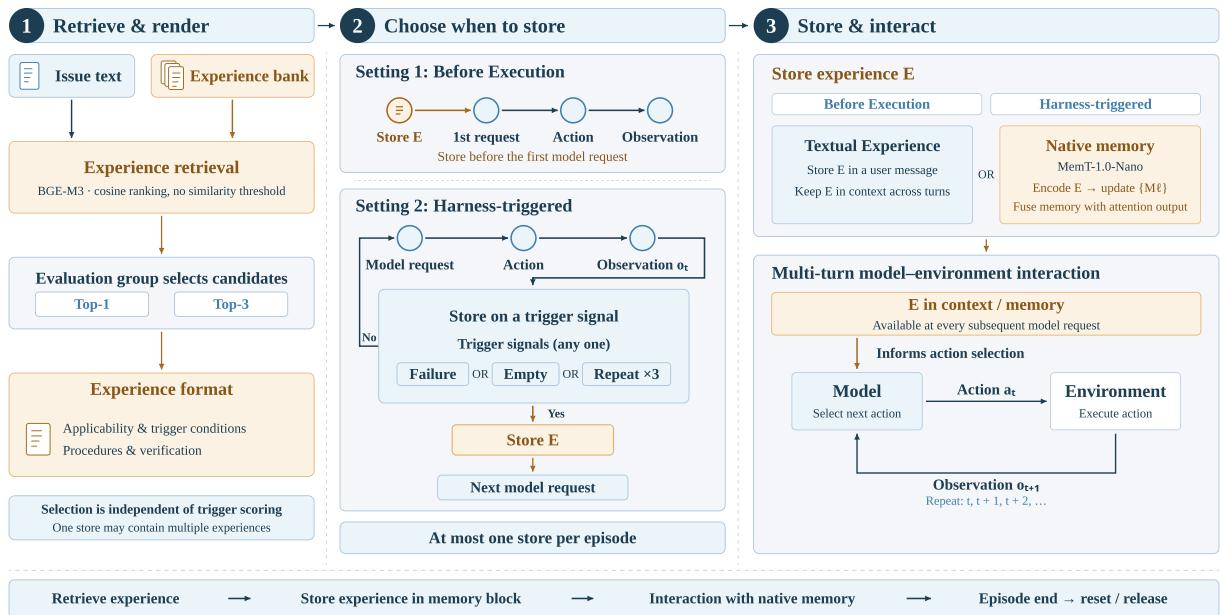
该框架从经验库中检索相关经验,并将其存储在agent文本上下文中或MemT-1.0-Nano原生记忆中。在原生记忆设置下,经验文本通过前向传播处理,启用记忆写入,更新记忆状态而不修改原始任务上下文。后续agent动作通过记忆注意力访问存储的经验,使经验影响动作生成,而无需在消息历史中显式出现。
实验
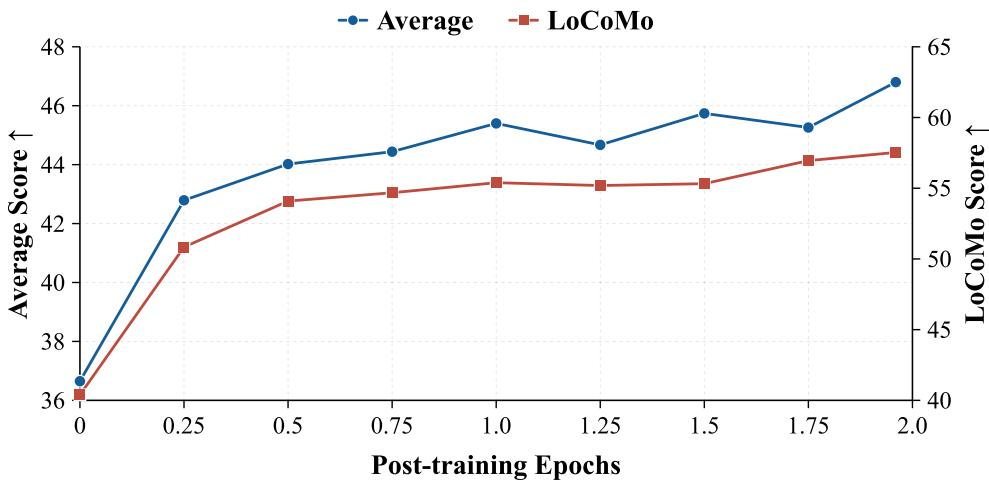
实验从扩展、基准、效率、存储、消融和agent应用角度考察MemT-1.0。对MemT-1.0-Nano的扩展研究显示,在固定容量下持续的与记忆相关的后训练改善记忆能力,而增加记忆专家提供进一步增益,尤其在训练后期。跨11个记忆任务和6个通用能力基准的评估表明,MemT模型领先参数化记忆基线但仍落后于强文本记忆系统,而通用能力在噪声下基本保持。消融将主要增益归因于token级更新和后训练,agent编码及长历史效率结果展示原生记忆可以内化程序性经验,提高任务一致性,并在更好长历史推理效率的同时保持存储恒定。
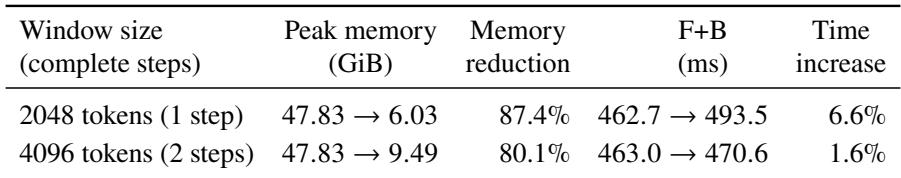
单个MoS记忆块的窗口化执行在32K tokens包长度下大幅降低峰值内存,相对于整包执行。一步窗口实现最大内存降低但增加少量时间开销,两步窗口保留大部分内存节省且时间增加更小。从整包执行切换到窗口化执行,在测试窗口大小下将峰值内存降低约80-87%。2048 tokens的一步窗口给出最大内存降低,但相对时间增加大于4096 tokens的两步窗口。两步窗口仍大幅降低峰值内存,同时保持增加的前向加反向时间低于2%。
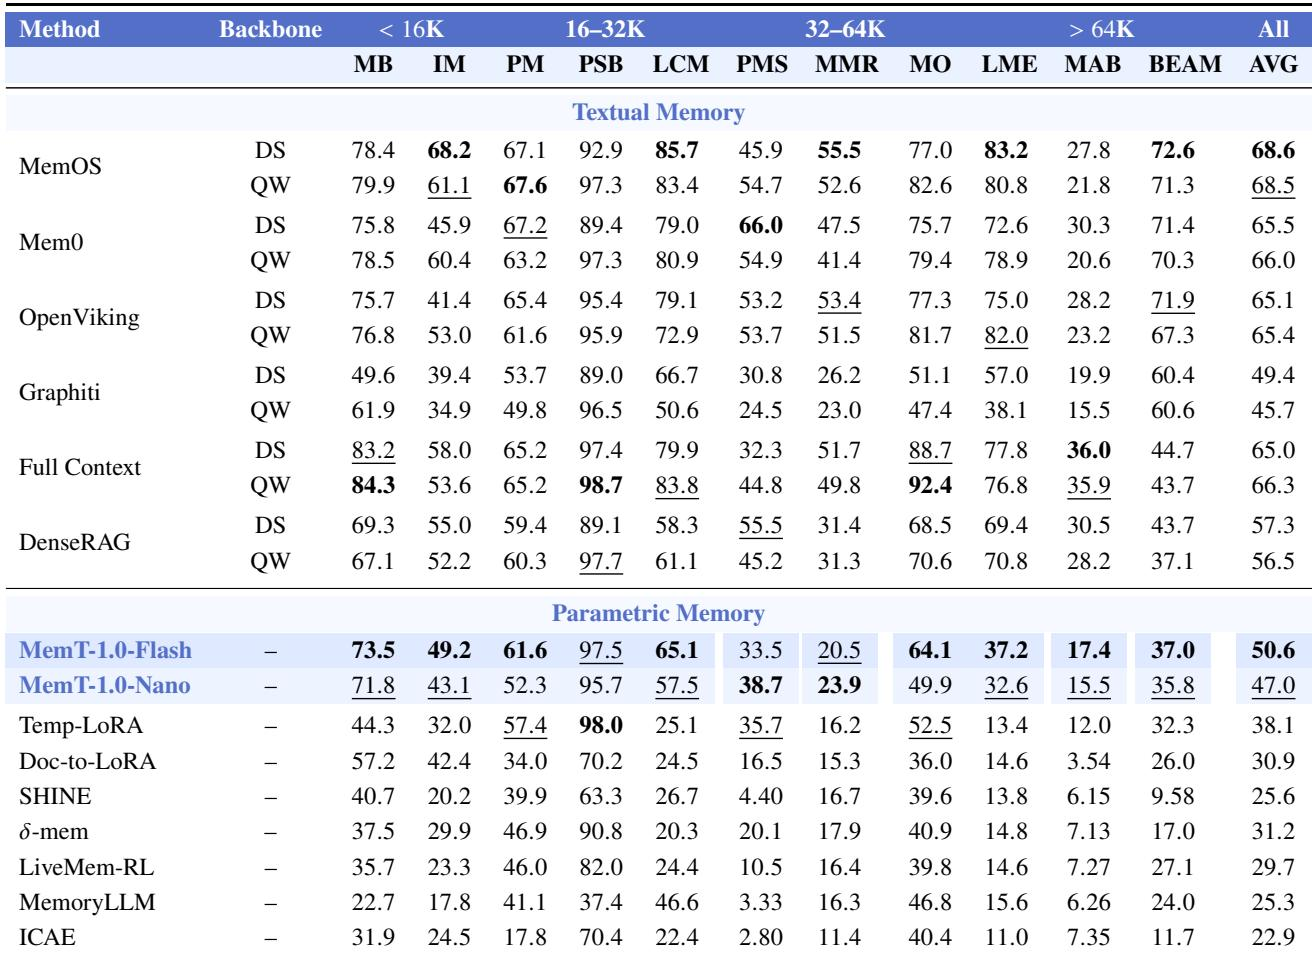
MemT-1.0-Flash和MemT-1.0-Nano是评估中排名前二的参数化记忆方法,主要受记忆操作影响存在适度的总体差距。Flash在记忆操作、个性化理解、对话召回和隐式学习方面更强,而Nano在PerMemSafe和Memora上更强。在查询时接收显式历史证据的文本记忆系统仍取得最高性能,尤其在LongMemEval-S和BEAM-1M上。MemT-1.0-Flash和MemT-1.0-Nano在参数化记忆方法中排名第一和第二,以明显优势领先最强参数化基线。两个MemT变体呈现互补优势:Flash在记忆操作、个性化理解、对话召回和隐式学习上领先,而Nano在PerMemSafe和Memora上领先。文本记忆系统整体仍更强,特别是在LongMemEval-S和BEAM-1M上,反映了查询时显式历史证据的收益。
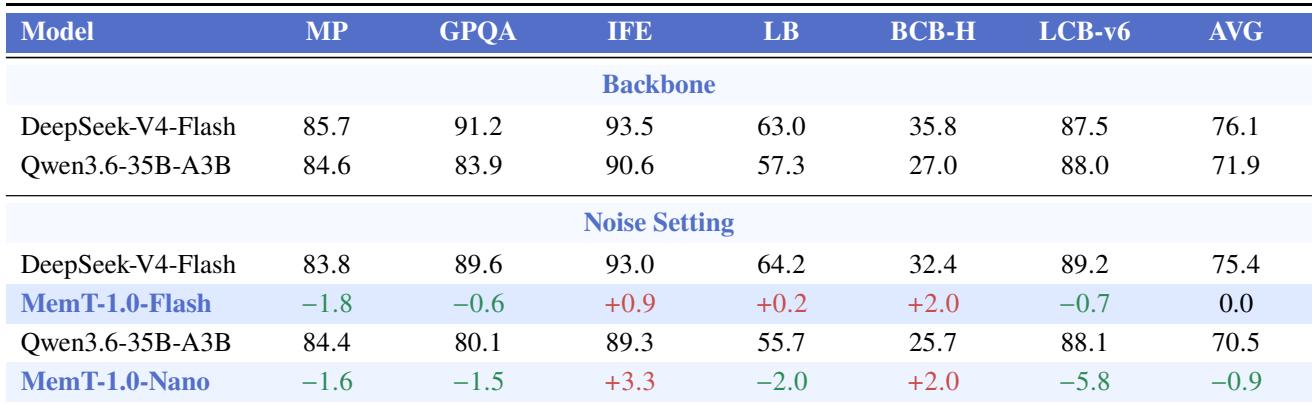
在噪声设置下,MemT-1.0-Flash平均与其DeepSeek-V4-Flash骨干持平,BigCodeBench-Hard上有显著提升,IFEval和LongBench v2上有适度增益,MMLU-Pro、GPQA Diamond和LiveCodeBench v6上有小幅下降。MemT-1.0-Nano显示约一个点的轻微平均下降,大多数基准接近其骨干,IFEval和BigCodeBench-Hard上有增益。一个编码基准改善而另一个下降的模式表明噪声效应在同一能力域内并不一致。MemT-1.0-Flash在噪声设置下相对其DeepSeek-V4-Flash骨干保持平均通用能力。MemT-1.0-Flash最大改善出现在BigCodeBench-Hard上,而MMLU-Pro显示最大下降。MemT-1.0-Nano仅有小幅平均下降,IFEval和BigCodeBench-Hard上有增益,最大下降在LiveCodeBench v6上。效应在编码基准内并非一致,BigCodeBench-Hard改善而LiveCodeBench v6下降。
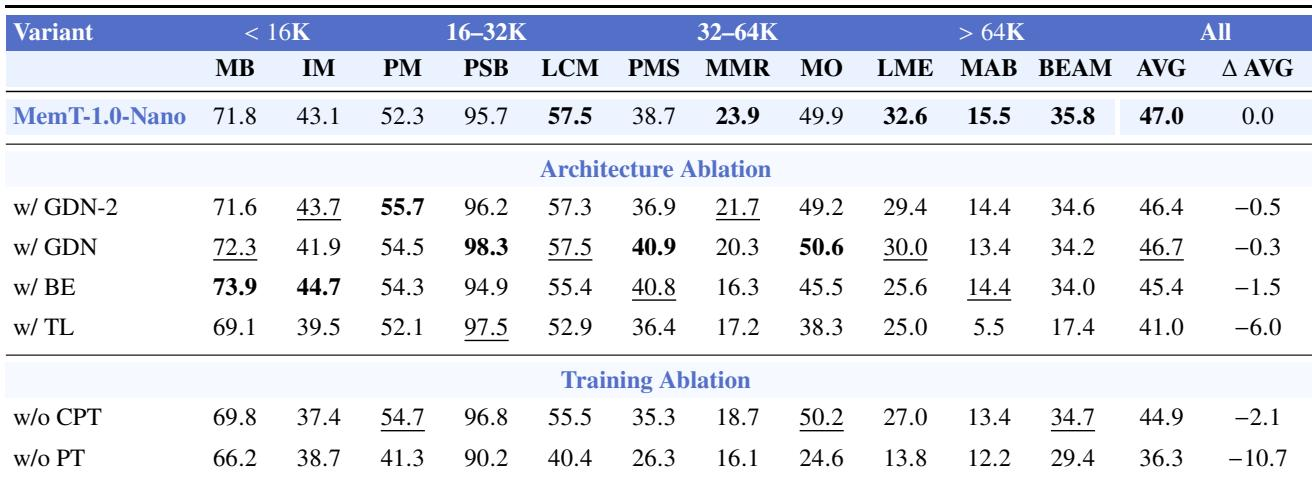
消融表明token级更新对MemT-1.0-Nano很重要,切换到turn级更新导致架构变体中的最大平均下降。用GDN或GDN-2替换稳定更新仅轻微降低整体性能,说明稳定机制带来适度优势。训练消融表明后训练是记忆特定改进的主要驱动因素,而持续预训练增加了初始化收益。完整模型在列出的架构变体中实现最高总平均分,基于GDN的替换紧随其后。Token级更新是关键因素;turn级变体显示平均分数的最大回退。用GDN或GDN-2替换稳定更新相对完整模型仅适度降低总平均分。后训练在持续预训练检查点上将记忆特定性能提升约十个点,而持续预训练也支持最终流程。
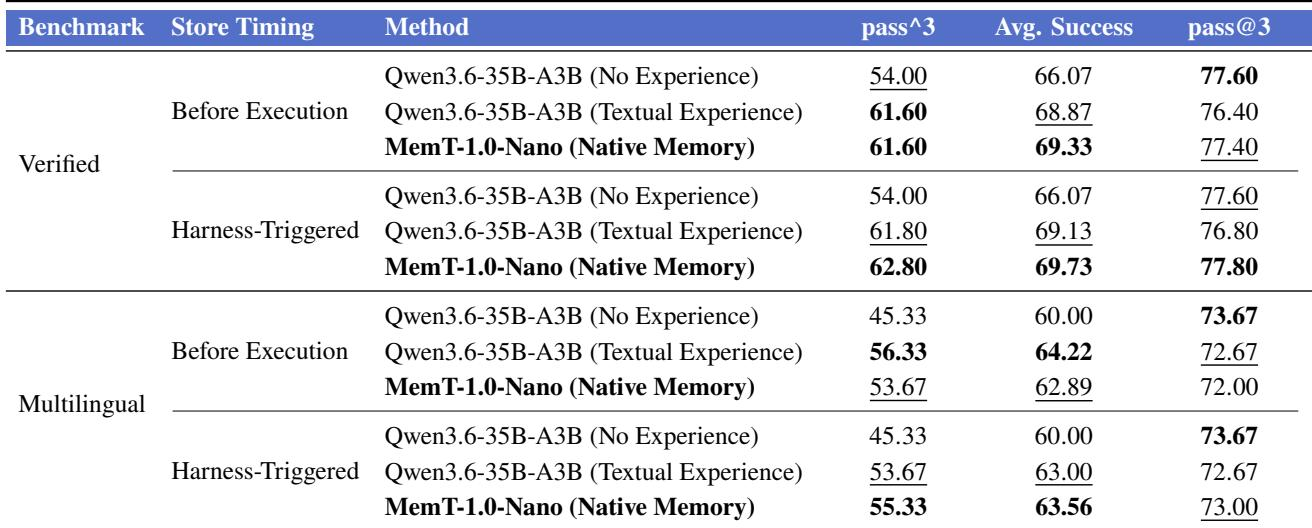
原生记忆在SWE-bench Verified和Multilingual上持续改进平均编码成功率和重复运行可靠性,相比无经验基线。其性能与文本经验相当,在某些设置中有小幅优势。pass^3的增益强于pass@3,表明在重复运行中解决更一致。原生记忆在SWE-bench Verified和Multilingual上提升平均成功率和pass^3,相比无经验基线。在Verified Before Execution设置中,原生记忆达到69.33%的平均成功率,略高于文本经验和无经验基线。重复运行可靠性大幅改善:Verified pass^3从54.00%升至61.60%,Multilingual pass^3从45.33%升至53.67%。Pass@3相对持平或略低,说明收益在于一致性而非增加至少一次解决任务的机会。在Harness-Triggered设置中,原生记忆在列出的已验证基准方法中实现最高pass^3和平均成功率。
这些实验评估记忆效率、参数化记忆质量、噪声鲁棒性、消融选择和重复软件工程运行。MoS记忆块的窗口化执行相比整包执行大幅降低峰值内存,两步窗口在内存节省和时间开销之间提供有利的权衡。MemT-1.0-Flash和MemT-1.0-Nano以互补优势领先参数化记忆方法,但文本记忆系统仍最强,特别是在历史证据可用时。在噪声下,MemT变体基本保持骨干能力;消融显示token级更新和后训练是关键贡献因素,原生记忆相比无经验基线改善编码成功率和重复运行一致性。