Command Palette
Search for a command to run...
SpecMRL:在参数谱中重新设计套娃表示学习
SpecMRL:在参数谱中重新设计套娃表示学习
Zhongxin Chen Songhao Wu Heng Cui Cong Li Xiao Zhou Rui Yan
摘要
套娃表示学习(MRL)旨在通过联合优化嵌套前缀来支持灵活的表示大小。尽管该方法有效,但这一设计缺乏显式约束,无法确保前导部分能够提供合适的紧凑编码。为解决这一问题,我们提出了 SpecMRL,它通过重新组织特征空间来实现更有效的前缀读出。具体而言,我们在 MRL 的基础上引入了一个由参数导出、按特征重要性组织的谱基。除此之外,SpecMRL 仍遵循标准 MRL 流程,在学习到的谱空间中执行前缀读出。在 MTEB 上的实验表明,SpecMRL 在所有评估的降维维度上均优于 MRL,并且在更激进的压缩下增益更大。这些结果表明,学习到的谱基能够更好地优先处理有信息量的方向,从而实现更有效的表示压缩。值得注意的是,SpecMRL 扩展了 MRL 的性能前沿,仅用一半的嵌入维度就超越了全维度 MRL。
一句话总结
来自中国人民大学、联想集团和武汉大学的研究者提出了 SpecMRL,该方法扩展了 Matryoshka 表征学习,通过参数导出的谱基按特征重要性重组特征空间,从而实现更有效的前缀读出;在 MTEB 上的实验表明,SpecMRL 在所有降维维度上均优于 MRL,并且仅使用一半嵌入维度即可超过全维度 MRL。
核心贡献
- 本文提出了 SpecMRL,一种对 Matryoshka 表征学习的参数化谱重设计,该方法使用由参数导出的谱基,并按特征重要性排序来重组特征空间。
- 该方法将固定的嵌套前缀读出替换为在所学谱空间中的前缀读出,从而在其余部分遵循标准 MRL 的同时得到更紧凑的前导表示。
- 在 MTEB 上的实验表明,SpecMRL 在所有评估的降维维度上均优于 MRL,且在激进压缩下收益更大,并仅使用一半嵌入维度即超过全维度 MRL。
引言
表征学习支撑着许多下游应用,但固定的高维嵌入会带来存储和延迟成本。Matryoshka 表征学习(MRL)通过在一次训练中训练完整嵌入的嵌套前缀来应对这一问题,但并未显式保证较早的维度携带最有用的信息。此前的工作通过跨维度监督改进低维读出,但未改变原始坐标系统,而原始坐标系统可能不适合前缀截断。作者提出了 SpecMRL,一种仅改变表示基的参数导出谱重设计。它利用可学习投影的 Gram 矩阵获得有序正交基,并采用基于幂迭代的近似方法,避免昂贵的特征求解器和不稳定的特征向量梯度。MTEB 上的实验表明,SpecMRL 在降维维度上优于 MRL,在 16 倍压缩下最高提升 3.80 个点,并以一半维度超过全容量 MRL。
方法
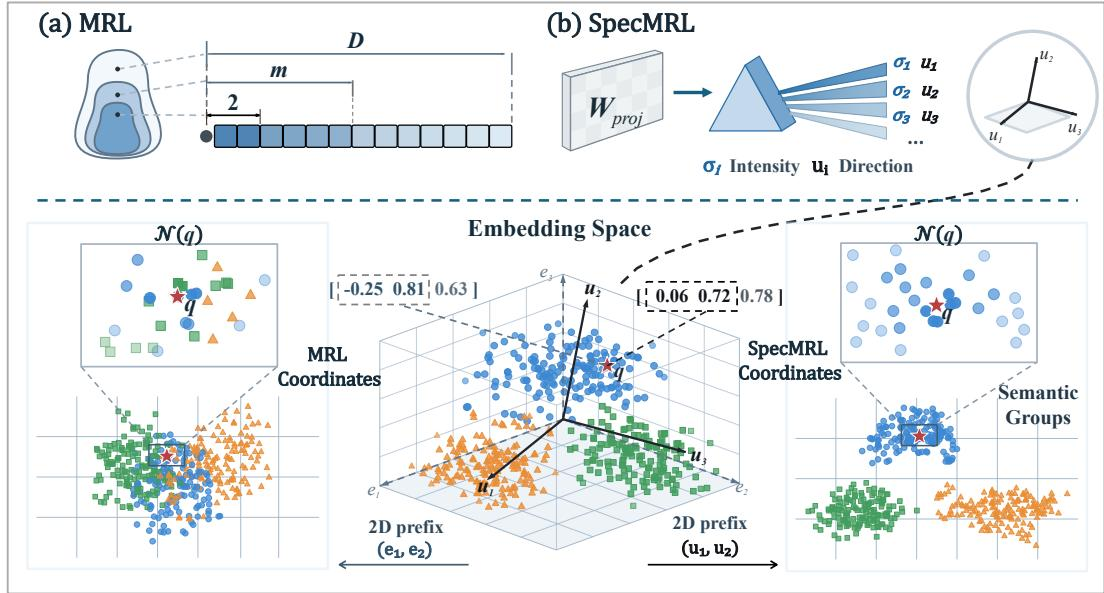
作者将 SpecMRL 作为 Matryoshka 表征学习的一种可直接替换的修改方案,用学习到的谱排序取代固定的启发式嵌套维度排序。SpecMRL 并不把嵌入的前几个维度视为天然更重要,而是将表示空间的潜在结构编码到投影矩阵 WProj∈RD×R 中,并从该矩阵导出一个嵌套基。
具体来说,SpecMRL 从 WProj 的 Gram 矩阵计算有序基:
U=Eigen(WProjWProj⊤),其中特征向量按特征值排序:
λ1≥λ2≥⋯≥λD≥0.基于这一排序,U 的前 m 列构成嵌套读出基。对于输入表示 X∈RD,谱前缀定义为:
XSpec(m)=XU:,1:m∈Rm.该谱前缀随后在每个损失项中替代标准嵌套表示:
LSpec=m∈M∑wmL(XSpec(m)).由于该修改只影响嵌套表示的构造方式,因此其余 Matryoshka 训练流程保持不变,无需增加额外损失函数或架构改动。
直接实现谱分解可能开销较大,并且对病态特征值分布敏感。为让 SpecMRL 实用,作者使用流式幂迭代方案近似有序基。该基由初始 Gram 矩阵的有序特征向量初始化,后续步骤通过一次矩阵乘法和随后的 QR 正交化更新:
U(t)=QR(WProj(t)WProj(t)⊤U(t−1)),其中先前基 U(t−1) 被视为固定,梯度通过 Gram 矩阵和 QR 分解传播。该设计避免了训练期间反复运行完整特征分解的成本和不稳定性。
在推理时,谱基固定,无需从 WProj 重新计算。因此 SpecMRL 仅需承担 D×D 线性投影的成本,在实际部署中保持高效,同时保留 Matryoshka 风格训练所需的嵌套表示结构。
实验
实验在 MTEB 上的多个主干模型和降维维度上评估了 SpecMRL 与标准 MRL 的对比,并通过消融实验分离参数化谱基、特征分解和过参数化的贡献。结果表明,SpecMRL 持续改善低维性能,并仅在一半全维度时取得最佳结果,而特征派生、基于 Gram 以及仅正交的变体均不及完整方法。进一步研究确认,SpecMRL 可扩展到更大模型和更长训练,对嵌套损失权重变化和稀疏监督保持稳健,优于现有 MRL 改进方法,并且编码开销可忽略且检索更快。
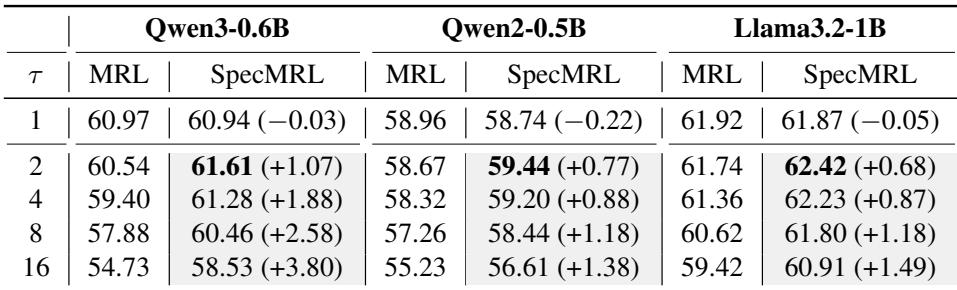
在全维度上,SpecMRL 与 MRL 表现相当,但在 Qwen3-0.6B、Qwen2-0.5B 和 Llama3.2-1B 的所有降维维度上均持续优于 MRL。随着压缩增强,优势扩大,在最小评估读出尺寸下收益最大。在三个主干模型上,SpecMRL 均在一半全维度时取得最佳平均 MTEB 得分。在三个评估主干模型的所有降维维度上,SpecMRL 均优于 MRL,而全维度差异可忽略。性能差距随压缩增强而扩大,在较低读出维度下收益更大。SpecMRL 使用一半全维度即可达到最佳得分,并支持以相同紧凑表示进行更快检索。
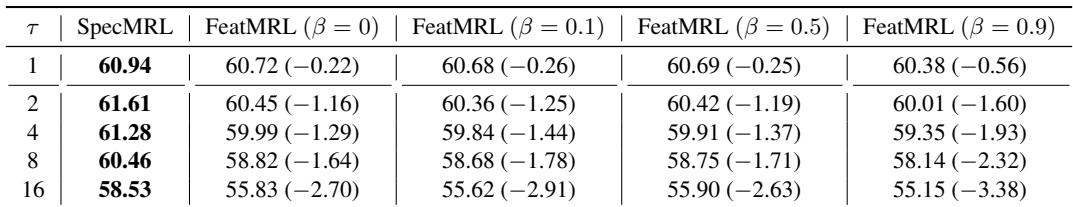
在 MTEB 上,SpecMRL 在所有评估前缀维度和 beta 设置下均持续优于特征派生变体。最大前缀维度下性能差距较小,但随着表示维度减小,差距显著扩大。这表明参数导出的谱比直接从输入特征构造谱基更有效。在与 FeatMRL 的每次比较中,SpecMRL 均取得最佳性能。特征派生变体在最大前缀维度下仅有小幅下降,但随着维度减小差距明显扩大。没有任何 FeatMRL beta 设置能与 SpecMRL 匹敌,最大下降出现在最小前缀维度。
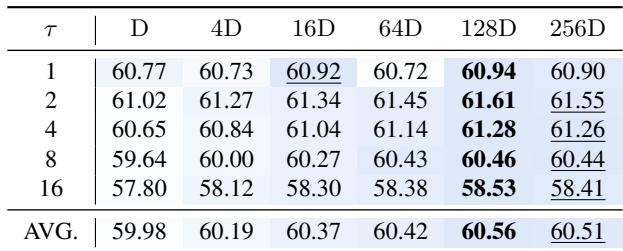
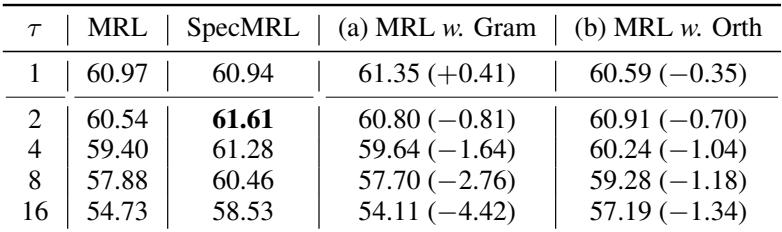
超参数搜索显示,投影的适度过参数化可在一定程度上提升性能。最佳结果出现在 τ=2、投影规模为 128D 时,紧随其后的是 256D,而平均性能从 D 提高到 128D,随后略有下降。较大的 τ 值,尤其是 8 和 16,会导致性能持续较低。τ=2 时,最优结果为 128D 下的 61.61,第二优结果为 256D 下的 61.55。不同 τ 下的平均性能从 D 的 59.98 上升到 128D 的 60.56,然后略降至 256D 的 60.51,而 τ=16 下降到 57.8 至 58.5 区间。
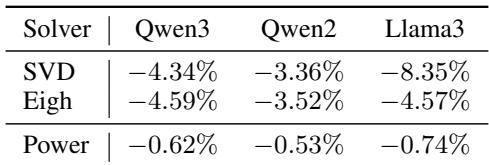
在三个模型系列中,幂迭代相对 MRL 仅造成较小的训练吞吐量下降,而 SVD 和 Eigh 带来显著更大的开销。这种差异在 Llama3 上尤为明显,SVD 在所有求解器中表现出最严重的下降。因此,幂迭代保持了接近 MRL 的训练效率。在 Qwen3、Qwen2 和 Llama3 上,幂迭代的吞吐量下降最低,相对 MRL 保持在 1% 以下。SVD 和 Eigh 产生更大的训练开销,其中 SVD 在 Llama3 上的下降在所有求解器中最大。
消融实验表明,添加可学习的基于 Gram 的相似度相比普通 MRL 仅带来有限提升,并且在更强压缩下迅速退化。SpecMRL 在嵌套维度缩小时仍保持更强性能。可学习正交基相比普通 MRL 有所改进,但仍不及完整 SpecMRL,说明谱排序在正交性之外仍有贡献。在降维维度上,SpecMRL 始终保持高于两个消融变体的性能。基于 Gram 的变体表现接近普通 MRL,并在更强压缩下出现更大下降。正交变体相比普通 MRL 有所改进,但仍低于 SpecMRL,凸显了学习到的谱排序的价值。
实验在 MTEB 上使用 Qwen3-0.6B、Qwen2-0.5B 和 Llama3.2-1B 评估 SpecMRL,并在降读出维度下与 MRL、特征派生谱基、求解器选择和消融变体进行对比。SpecMRL 在全维度上与 MRL 持平,但在压缩下持续优于 MRL 和所有特征派生基线,且最佳平均得分出现在一半全维度。适度的投影过参数化可在一定程度上改善结果,幂迭代保持接近 MRL 的训练吞吐量,并且 SpecMRL 学习到的谱排序优于基于 Gram 和仅正交的变体。