Command Palette
Search for a command to run...
面向脑编码的参数高效微调规模化
面向脑编码的参数高效微调规模化
Josh Ying Guanglong Sun Nolan Ho Kieran Liu Rui Yang Andrew Chen Nikolaus Kriegeskorte Pony Ma Hossein Adeli
摘要
脑编码模型旨在预测刺激所引发的神经响应。最广泛使用的方法是在冻结的预训练骨干网络上拟合读出层。使用神经数据从头训练大模型,或在任务预训练后对其进行全量微调,已被证明很困难,因为神经数据成本高昂且数量有限。我们表明,参数高效微调(PEFT)使我们能够以少量可训练参数,针对脑编码有效适配非常大的预训练骨干网络。为了使该方法在计算上可行,我们利用骨干网络的因果结构,在单次前向传播中预测多个时间点,而不是使用滑动窗口,从而显著降低特征提取成本。这使得能够高效微调参数多达 104B 的多模态骨干网络;据我们所知,这是用于脑编码的规模最大的适配模型。我们的方法使用低秩适配器(LoRA)和轻量读出层进行训练,在九个不同的多模态骨干网络上一致提升了脑编码性能。在与先前最先进方法(SoTA)相同的 Qwen3-Omni 骨干网络上,我们的方法 BrainLoRA 在 Algonauts 2025 Challenge 上取得了已发表的最佳性能,而可训练参数量仅约为其 5%。我们还表明,适配后的多模态骨干网络仍具有可解释性:模态归因恢复出经典的感觉拓扑结构,而先前工作通常是通过分别构建单模态编码器来获得该结构;此外,神经适配提高了骨干网络内部音频输入和跨模态混合的贡献。为了横向扩展适配模型的数量,我们开发了一种多 LoRA 内核,可在共享骨干网络上加速多个 LoRA 的联合训练。这使得能够构建一个包含 200+ 个适配模型的集成,截至撰写时在公开的 Algonauts 赛后排行榜上排名第一。综上,我们的结果表明,PEFT 是脑编码中一种高效且强大的范式。
一句话总结
来自哥伦比亚大学等机构的研究者提出 BrainLoRA,一种参数高效微调方法,通过低秩适配器、轻量 readout 和单次因果多时间点预测,将高达 104B 参数的多模态 backbone 适配到脑编码任务,在 Algonauts 2025 上取得最优表现,训练参数约为 5%,并以 200 多个模型的集成排名第一。
核心贡献
- 本文提出 BrainLoRA,一种参数高效微调方法,利用低秩适配器和轻量 readout 将大型预训练多模态 backbone 适配到脑编码。它在九个多模态 backbone 上改善了脑编码,并在与先前工作相同的 Qwen3-Omni backbone 上取得了已发表的最佳 Algonauts 2025 Challenge 表现,同时仅使用约 5% 的可训练参数。
- 该工作通过利用 backbone 的因果结构进行单次多时间点特征提取,将特征提取成本相较先前最佳方法降低 350 倍,并引入用于批量适配器训练的 multi-LoRA kernel,使大规模适配在计算上变得可行。这支持适配高达 104B 参数的 backbone,并训练超过 200 个模型的集成,该集成在公开的 Algonauts 赛后排行榜上排名第一。
- 研究表明,适配后的多模态 backbone 仍具有可解释性:模态归因恢复了通常需要组合多个单模态编码器才能获得的经典感觉拓扑,并且与冻结 backbone 相比,适配提高了音频输入贡献和跨模态混合。
引言
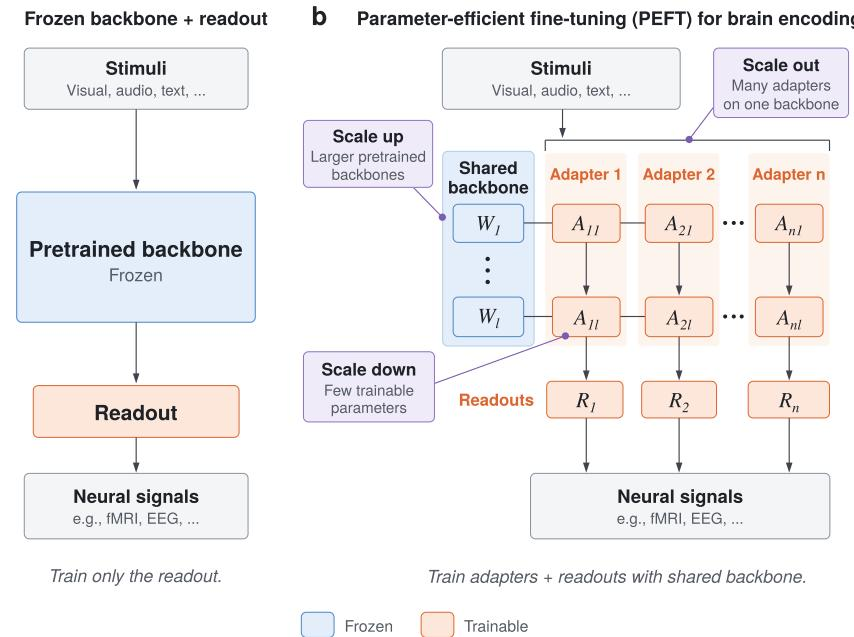
脑编码模型预测刺激引起的神经响应,通常通过冻结大型预训练模型作为特征提取器,并仅在神经数据上训练 readout 来构建。这种方法受益于强预训练先验,但无法让 backbone 专门适配脑数据;而适配 backbone 很困难,因为神经记录成本高且数据稀缺。先前的适配结果参差不齐:从头训练较小模型无法达到最优全脑表现,完全微调可能不如冻结,低秩适配仅在较小的视觉模型上测试过。作者通过将参数高效微调视为可扩展的脑编码框架来弥补这一空白。他们提出 BrainLoRA,将 LoRA 与大型多模态 backbone 上的轻量 readout 结合,并通过单次特征提取将成本降低约 350 倍,使适配变得实际可行。BrainLoRA 在多达 104B 参数的九个多模态模型上均优于冻结 backbone,并在 Algonauts 2025 全脑 fMRI 基准上创下新的最优结果,而使用的可训练参数约为先前最佳方法的 5%。
方法
作者将脑编码形式化为从多模态刺激 X 到所诱发神经响应 Y 的映射。模型由预训练 backbone fθ 和其后的 readout gϕ 组成,通过最小化下式训练:
Y^=gϕ(fθ(X)),θ∈Θ,ϕminL(Y,Y^),其中 L 是适合任务的损失,例如平方误差或负相关,gϕ 还处理刺激表示与神经采样率之间的时间对齐。
该方法不使用完全微调,而是将 backbone 适配限制在低维参数化中。给定预训练权重 θ0,优化集满足
Θfrozen={θ0}⊂ΘPEFT={θ0+Δ(ψ):ψ∈Rk}⊂Θfull=Rd,其中 k≪d 且 Δ(0)=0。该形式化与架构无关,LoRA、adapter 层和 prompt tuning 都是 Δ 的实例。对于基于 Qwen3-Omni 的主架构,作者将 rank-16 LoRA 插入到第 32 层之前的 attention 模块中,并在该层截断 decoder,引入 891 万个可训练参数。adapter 和 readout 在一个 epoch 内联合优化。
特征提取流程取代了先前方法使用的重叠滑窗协议。由于 backbone 是因果掩码的,一个 149 秒窗口(对应 100 个 fMRI TR)只需一次前向传播即可编码,并且同时提取所有时间步的表示。每个窗口前会添加 60 秒上下文引导,以恢复窗口边界处丢失的时间上下文。这种单次设计将特征提取成本降低约 350 倍,使通过 backbone 进行微调在计算上可负担。作者还验证,在 decoder 之前对短音频和视觉块进行操作的局部双向模态编码器只引入很小的数值差异,而不是有意义的未来刺激泄漏。
对于 readout,backbone 特征首先在每个 2 Hz 时间步被池化为每个模态一个向量,并聚合到与 fMRI 采样率对齐的八个对数间隔时间滞块中。线性 readout 将每个输入窗口中约 19.3k 个 tokens 池化为 894 个向量,然后应用最终线性投影到 1,000 个脑分区,可训练参数为 5230 万。作为一种替代方案,在约 3.2k 个 tokens 的扩展集合上进行逐 TR 交叉注意力,取代固定的时间滞聚合,仅增加 20 万参数。
在使用 SGD 联合优化后,线性 readout W 以闭式解重新估计。前向传播累积受试者特定的 Gram 矩阵,随后使用逐脑分区岭回归求解 W。这种闭式重新拟合在 SGD 训练的 readout 之外带来了额外提升。
实验
实验使用一个视听 fMRI 基准上四名受试者的平均 Pearson 相关系数,评估九个多模态 backbone 上的参数高效适配,比较小型 adapter 与大型 readout,消融模型组件和输入设计,解释模态贡献,并研究大型 adapter 集成。结果表明,PEFT 相比冻结 backbone 一致改善脑编码,轻量 LoRA 或交叉注意力 adapter 优于大得多的冻结 readout,并创下新的最优结果,同时高效的单次输入在适配后恢复了性能损失。特征归因恢复了经典皮层组织,但适配使模态权重向音频偏移,并增加了跨模态混合。独立适配模型的大型集成进一步提高准确率,有用多样性主要来自架构变化,而不是随机种子或训练变化。
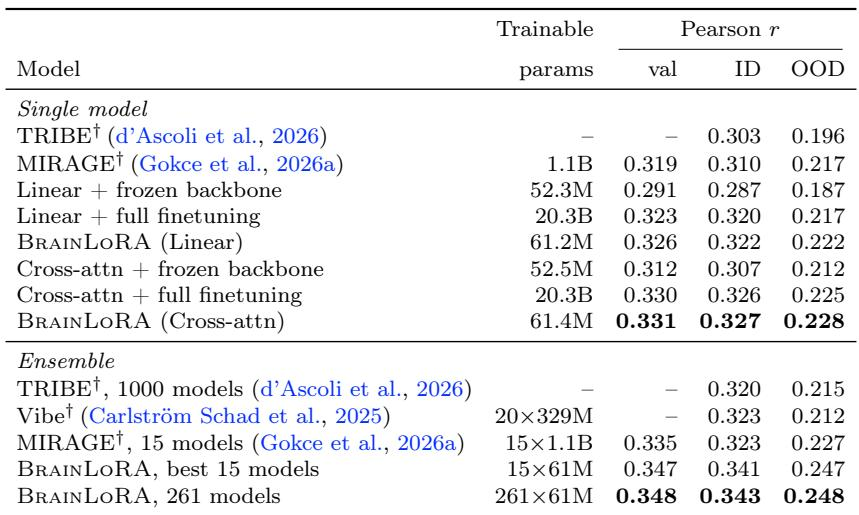
BrainLoRA 通过使用轻量 LoRA 模块适配冻结 backbone,而不是训练大型 readout,在 Algonauts 2025 基准上创下新的最优结果。一个 LoRA 加线性 adapter 仅使用 MIRAGE 可训练参数的一小部分,就已在留出的 ID 和 OOD 测试集上优于先前的单模型最优结果,而交叉注意力变体进一步提升。特征提取栈的完全微调并未超过 LoRA,而将许多独立适配模型集成可以得到最高的公开排行榜分数。LoRA 加线性 adapter 训练参数约为先前 MIRAGE 模型参数的 5%,并且已在 ID 和 OOD 留出分数上超越它。交叉注意力 readout 进一步改善单模型表现,在 ID 上超过已发布的 15 模型 MIRAGE 集成,在 OOD 上与其持平。训练参数多出数百倍的完全微调与 LoRA 持平或略差,而大型 adapter 集成取得了公开排行榜最佳结果。
消融实验表明,使用 LoRA 适配冻结 backbone 带来最大的性能提升,闭式重新拟合带来较小但一致的改善。替代 readout 和秩选择产生适度差异,其中交叉注意力在 readout 变体中得分最高。移除音频会导致显著下降,表明其对编码模型的重要性。LoRA 适配相比冻结 backbone 基线提供了最大的单项改进。移除闭式重新拟合会降低适配模型得分,确认其持续贡献。Rank-32 LoRA 和 gated-MLP readout 的表现接近主配置,而交叉注意力 readout 得分略高。无音频相对于主配置导致显著性能下降。
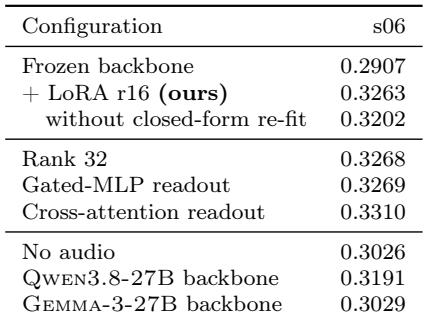
这些实验在 Algonauts 2025 基准上评估 BrainLoRA,使用轻量 LoRA 模块和不同 readout 适配冻结 backbone。LoRA 适配相比冻结基线带来最大提升,闭式重新拟合带来较小但一致的改善,移除音频造成显著性能下降。LoRA 加线性 adapter 已以远少得多的参数超过先前 MIRAGE 模型,交叉注意力 readout 进一步改善单模型表现。完全微调没有超过 LoRA,而集成适配模型得到最佳排行榜结果。