Command Palette
Search for a command to run...
EgoXperience:从人类经验中学习世界锚定的自我中心表征
EgoXperience:从人类经验中学习世界锚定的自我中心表征
摘要
从自我中心视频中重建人类活动不仅需要恢复单个 3D 组件:观察者的运动、周围几何结构以及手与物体的交互必须在一个一致的世界中彼此契合。实现这种一致性既需要联合重建,也需要对齐监督,然而现有方法和数据集对两者的支持都有限。我们提出了 EGOXPERIENCE,一个全栈式
一句话总结
Ropedia、南洋理工大学、清华大学和北京大学提出 EGOXPERIENCE,一种从人类经验中学习以世界为基准的自我中心表征的全栈方法,该方法在一致监督下联合重建观察者运动、周围几何结构以及手与物体交互,解决现有自我中心视频方法和数据集中缺乏连贯联合重建和一致监督的问题。
核心贡献
- 提出 EgoXperience,一种通过任务驱动采集、几何对齐标注和联合重建来学习以世界为基准的自我中心表征的统一方法。
- 提供 EgoX-Engine,为 50 小时的 EgoX-Data-6M 提供对齐的多模态标注,并构建留出的一小时 EgoX-Bench,涵盖相机、深度、手部和刚体物体标注。
- 提出 EgoX,从 RGB 观测和可选的首帧物体掩码中,在公共度量世界坐标系中联合重建相机位姿、稠密深度、手部几何和刚体物体 6-DoF 位姿。EgoX 在四个基准上取得最先进结果,在深度、手部和物体指标上排名第一,并在 HOI4D 上获得最佳相机精度。
引言
自我中心视频是人类活动和具身 AI 的一种实用采集模态,因为它从可穿戴传感器记录相机运动、场景上下文、手部和物体交互。然而,以往重建方法通常只恢复这些组成部分的一个子集,拼接单独输出会造成尺度和坐标系不一致。现有数据集也难以大规模提供联合标注,因为经过标定的多相机或动作捕捉装置成本高昂,难以在不同环境中部署。作者提出 EgoXperience,一种全栈范式,将自动标注引擎 EgoX-Engine、50 小时对齐数据集、基准以及 EgoX 结合,EgoX 是一个前馈模型,从单目自我中心视频中在共享度量世界坐标系中联合重建相机位姿、场景深度、手部和刚体物体位姿。
数据集
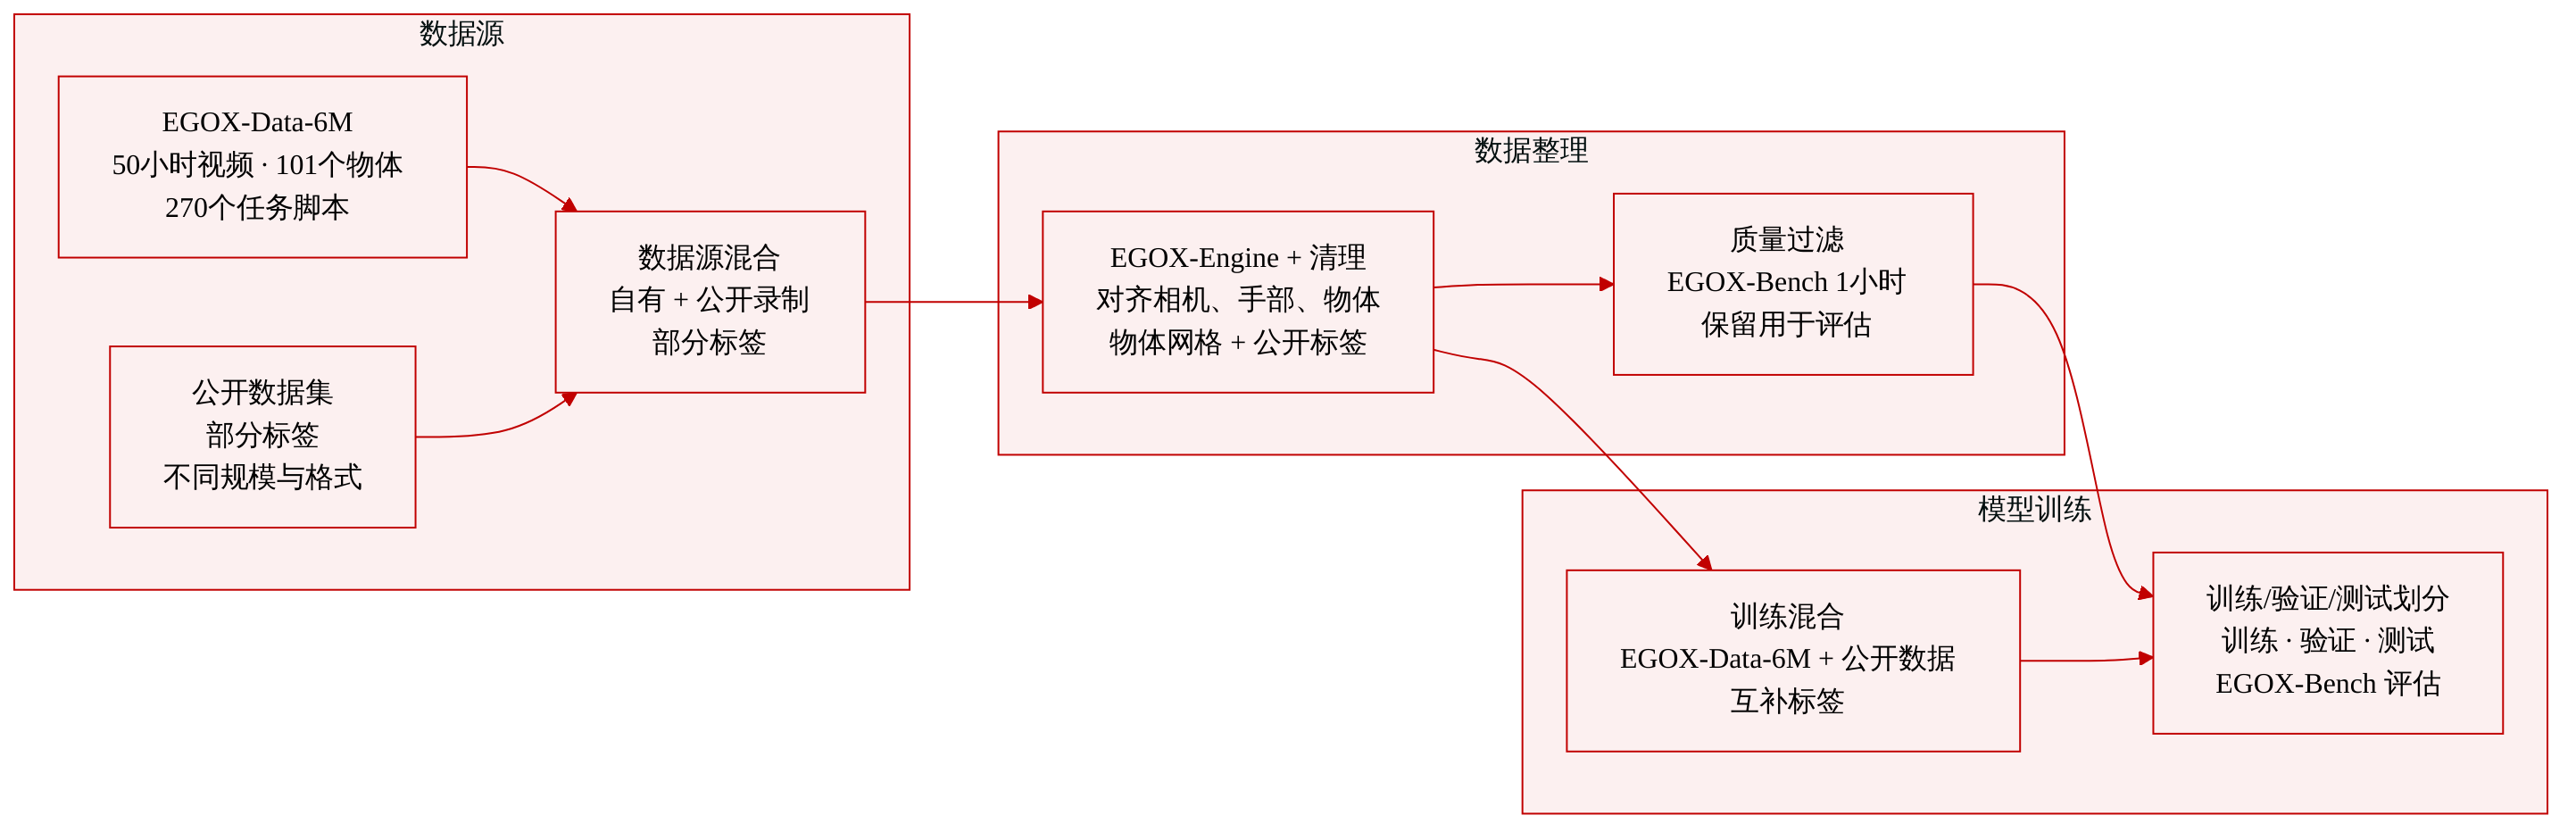
作者从任务驱动的自我中心记录中构建 EGOX-Data-6M,并将其与公开数据集一起用于联合重建训练。
-
构成与来源:
- EGOX-Data-6M 包含 50 小时视频、101 个刚体物体和 270 个任务脚本。
- 采集来自 HOMIE Gen2 头戴装置,配备同步标定的立体相机和四个鱼眼相机。
- 活动涵盖工作台操作、跨房间交互和室外移动操作。
-
处理与标注:
- EGOX-Engine 利用 SLAM 相机轨迹提供会话固定的度量坐标系。
- 立体深度提供度量场景几何;手部关键点经三角化后用于约束 MANO 拟合。
- 物体网格由 31 个同步穹顶相机使用 SAM 3 掩码和 MV-SAM3D 构建,并使用 AprilTag 板确定尺度。
- 物体运动从首帧掩码初始化,在交互区间内使用 FoundationPose 跟踪,并根据观测深度进行验证。
- 所有相机、场景、手部和物体标注都对齐在同一度量坐标系中。包含二级任务描述。
-
子集与过滤:
- EgoX-Bench 是一个经过质量控制的一小时子集,涵盖全部三种活动设置,专门用于评估。
- 额外公开数据集被转换为公共坐标和尺度约定,清理错误标注,并与手部和物体几何进行深度对齐。它们可以提供部分标签。
-
模型中的使用:
- EGOX-Data-6M 和公开数据集作为互补训练数据使用。
- EgoX-Bench 专门用于相机、场景、手部和物体重建的联合评估。
- 最终训练混合比例详见附录 F。
- 所提供文本未指定裁剪策略。
方法
作者提出 EGOXPERIENCE 范式,统一了数据采集、标注和模型学习,用于从自我中心视频中联合度量重建相机、场景深度、手部和物体。这一综合框架整合了用于数据处理和标注的 EGOX-Engine、大规模 EGOX-Data-6M 数据集,以及用于单目视频联合重建的 EGOX 模型。
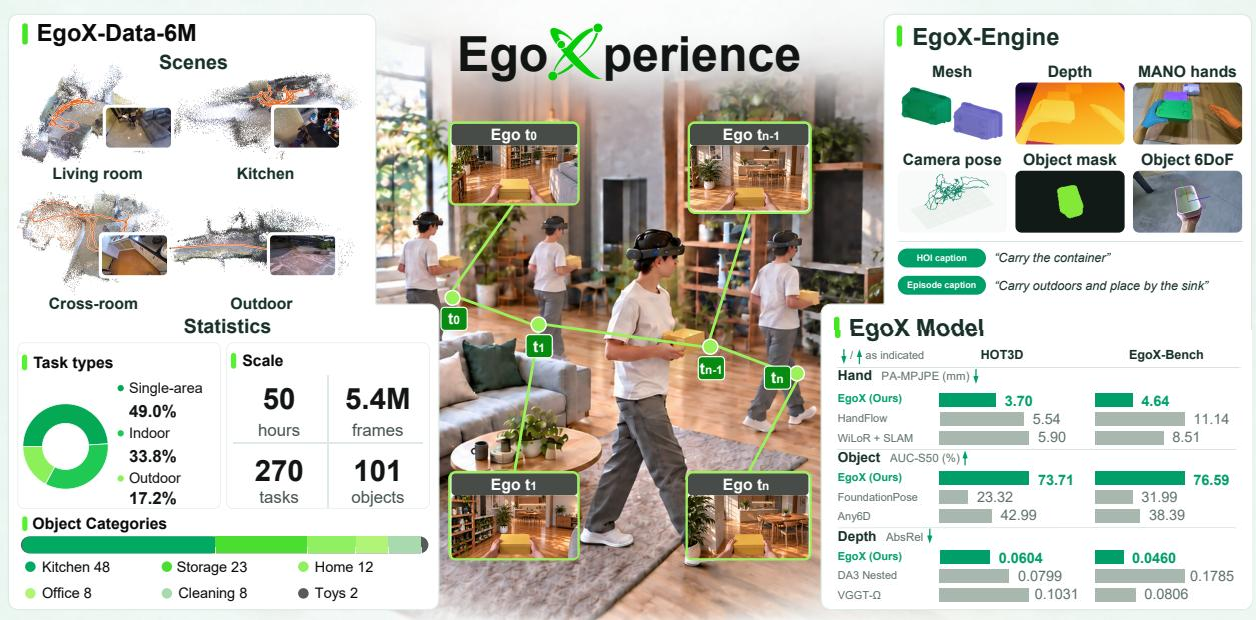
为了生成必要的对齐标注,作者开发了 EGOX-Engine。学习联合重建自我中心活动具有挑战性,因为观察者和交互实体同时运动,难以区分相机运动与实体运动。EGOX-Engine 通过利用立体深度恢复度量尺度下的几何,并利用 SLAM 估计的相机位姿在每次记录中对不同标注进行对齐,从而解决这一歧义。流程首先通过多视角笼式扫描准备物体模型,以获得具有固定几何和度量尺度的完整物体网格。在自我中心采集阶段,系统记录 RGB、深度、相机位姿和 MANO 手部标注。对于物体跟踪,该引擎采用身份安全的掩码跟踪机制,锚定第一个掩码,使用 SAM3 传播,并通过排除竞争物体来恢复身份。最后,使用 FoundationPose 提议和基于深度、轮廓、覆盖和运动的证据验证生成经过验证的 6DoF 轨迹,得到结构化输出,包括物体 6DoF 轨迹、自我视角掩码序列和描述。
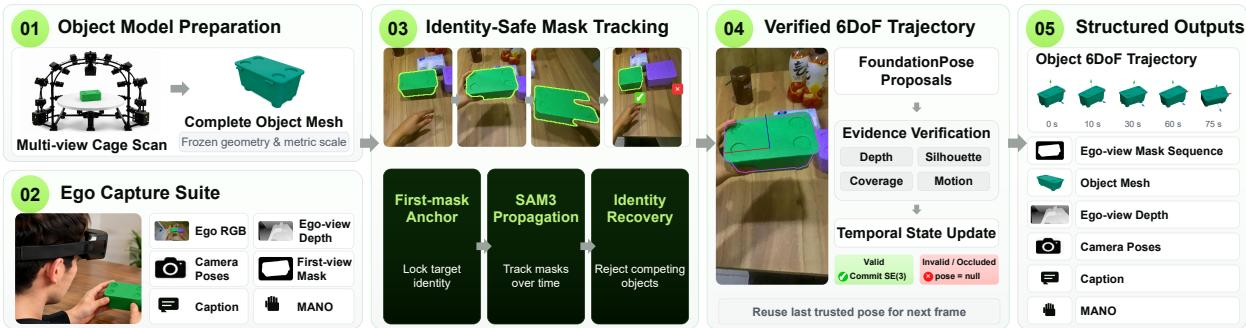
为了将对齐监督转化为联合重建,作者提出 EGOX 模型。给定单目观测和可选的首帧物体掩码,EGOX 在单次前向传播中联合预测相机内参和位姿、稠密深度、双手 MANO 状态、物体原点和朝向,以及正的度量尺度。所有重建输出都在首帧相机坐标系中表示。
该架构依赖由共享 Transformer 编码的联合场景与实体表示。模型从 DINOv3 提取的图像块特征出发,在每个视图中引入相机、手部和物体 tokens。不同的左右嵌入用于标识双手,而首帧掩码描述子在视图之间关联目标物体。这些 tokens 通过视图内注意力收集图像证据,并通过跨视图注意力在不同观测之间交换信息,形成用于重建的联合表示。
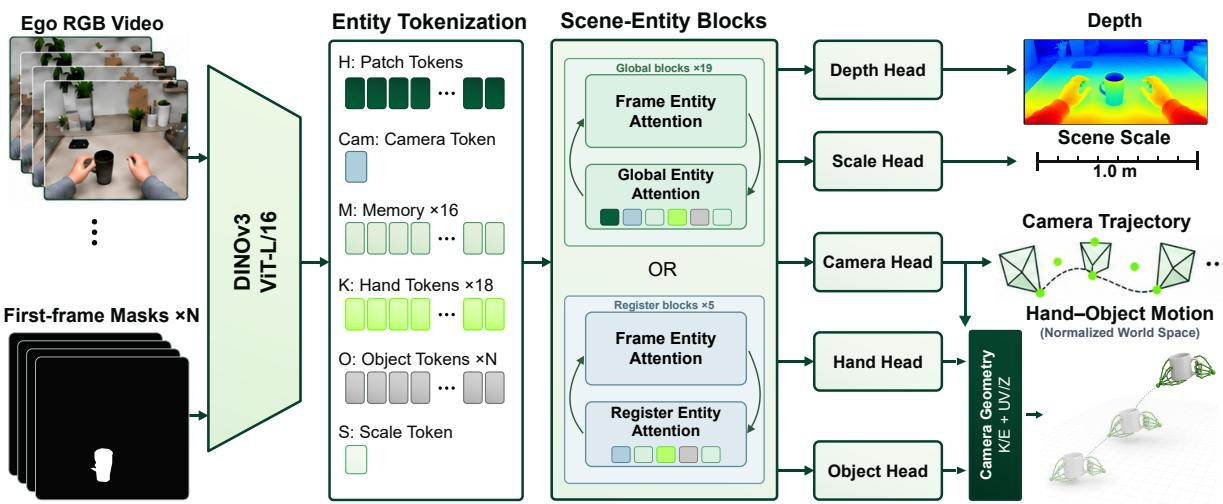
基于这一联合表示,模型在公共参考坐标系中重建场景几何和手部-物体运动。为了合并不同视图的预测,模型估计相机内参和外参。这些参数允许从图像坐标和预测深度恢复场景点、手腕位置和物体原点。对于齐次图像位置 u~ 和归一化深度 z,其在世界坐标系 W 中的位置计算如下:
Ut(u~,z)=R^t⊤(zK^t−1u~−τ^t).这一共享映射将场景和实体位置绑定到相同的相机估计。对于手部和物体朝向,使用相机旋转的逆变换将相机坐标系中的朝向转换到世界坐标系。为了恢复度量尺度,共享的 ScaleHead 为序列预测一个正因子,一致地缩放场景点以及相机、手腕和物体位置。
作者采用几何耦合监督训练模型。监督不仅作用于单个预测,还作用于世界坐标系中产生的手部-物体几何。通过将手部和物体预测经由估计相机进行变换,并将重建几何与真值比较,所得损失通过相机变换反向传播,同时更新实体和相机预测。训练目标结合了这些监督项:
L=Llocal+Ldense+Lcoupled+Lscale,其中 Llocal 监督相机和视图局部实体预测,Ldense 监督深度和场景点,Lcoupled 监督合成的手部-物体几何,Lscale 监督度量尺度。为适应不同数据集之间标注覆盖范围的差异,每个损失仅在其所需标签可用的地方应用。
实验
实验在 HOT3D、EgoX-Bench、H2O 和 HOI4D 上评估相机、深度、手部和物体重建,使用相同的 150 个观测片段,从训练中排除评估序列,并且仅在各自提供的输出上进行比较。EgoX 是唯一从 RGB 和首帧掩码出发、在共享世界坐标系中联合重建相机、深度、手部和物体 6-DoF 位姿的端到端方法,在所有基准上取得最佳手部和物体结果以及最佳深度结果,并且相对于强几何基线具有竞争力的相机运动。消融实验表明,移除度量尺度预测或稠密深度预测会降低联合手部和物体重建质量,说明这些组件的作用不仅是简单重缩放。
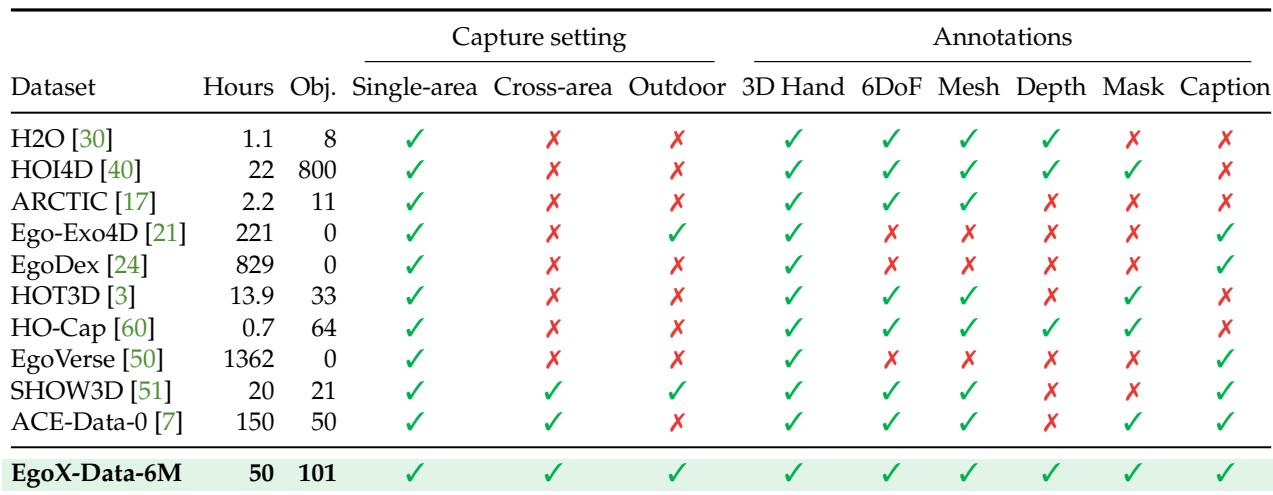
EGOX-Data-6M 在记录时长和建模刚体物体数量方面属于中等规模的自我中心数据集,并且独特地结合了单区域、跨区域和室外采集。现有资源大多是单区域的,标注覆盖不均,没有一个被比较的数据集同时提供所有标注类型。其在共享度量坐标系中对齐的相机、场景、手部和物体标注使其在工作台、跨房间和室外活动的联合重建中具有独特优势。大规模现有数据集没有报告建模物体,而物体丰富的数据集是单区域的,这表明 EGOX-Data-6M 以中等规模和 3D 物体覆盖填补了空白。只有一个被比较的数据集包含室外采集,没有一个包含跨区域采集,而 EGOX-Data-6M 覆盖全部三种活动设置。
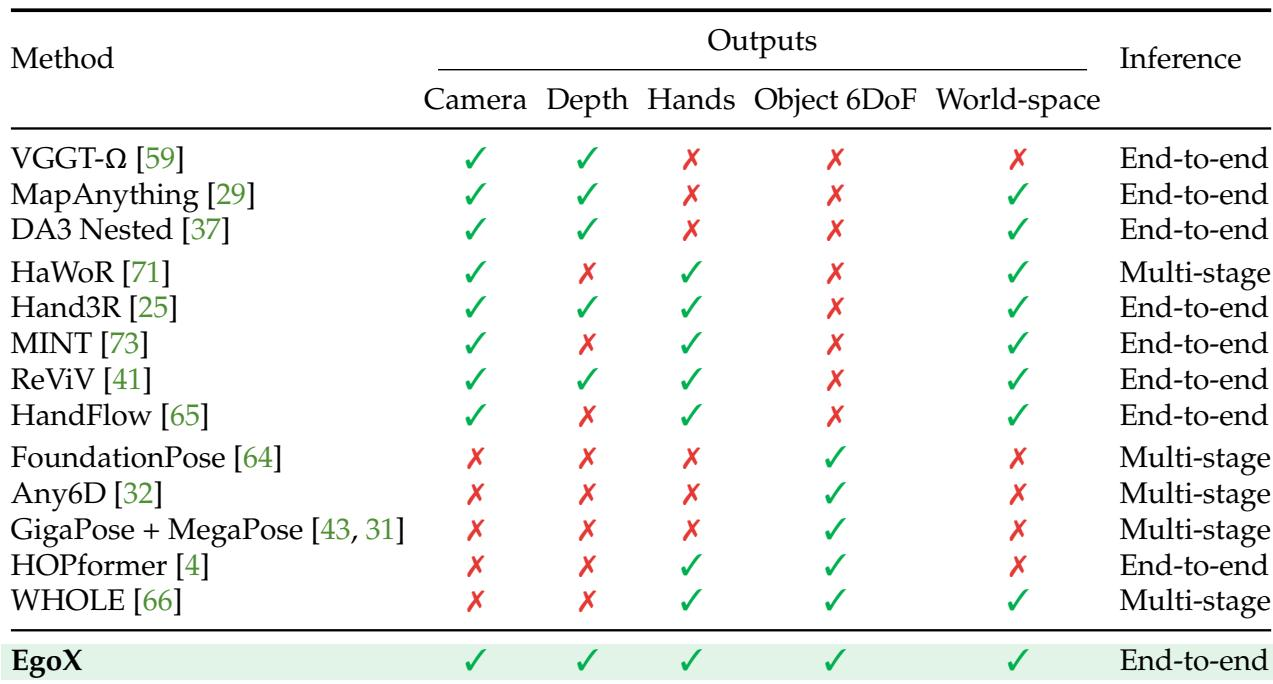
被比较的重建方法支持不同的输出子集,并使用端到端或多阶段推理。若干端到端方法恢复相机和深度,但不包含手部和物体位姿;一些以手部为重点的方法加入了手部,但仍缺少物体 6-DoF。EgoX 是该比较中唯一在共享世界坐标系中联合重建相机、深度、手部和物体 6-DoF 位姿的端到端方法。相机和深度重建在若干端到端方法中较为常见,但手部和物体 6-DoF 通常不受支持。Hand3R 和 MINT 在端到端模型中加入了手部重建和世界空间输出,但不包含物体 6-DoF。HaWoR 是所列基于手部的方法中唯一采用多阶段推理而非端到端推理的方法。EgoX 独特地在端到端框架中同时支持相机、深度、手部和物体 6-DoF。
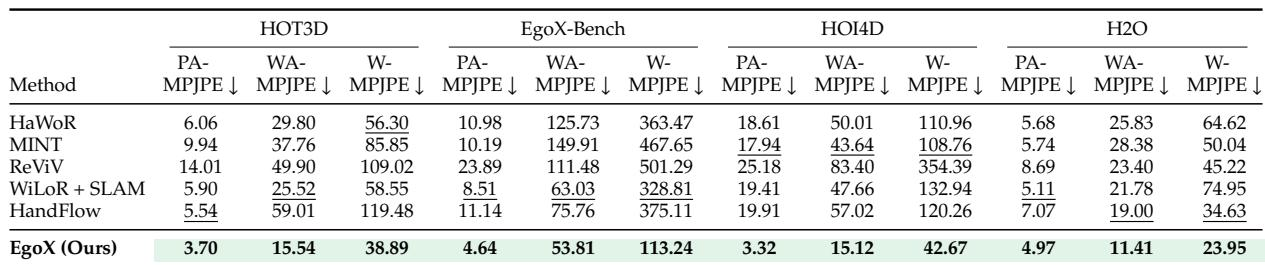
EgoX 在全部四个基准上产生最准确的手部重建,在被比较方法中取得最低的 PA-、WA- 和 W-MPJPE。这一优势在世界空间对齐中尤为明显,强基线仍会相对真值位置出现显著漂移。EgoX 在 HOT3D、EgoX-Bench、HOI4D 和 H2O 上的全部三项指标中取得最佳手部重建误差。在 HOT3D 上,EgoX 相对该指标最强基线 HaWoR 大幅降低 W-MPJPE,尽管 HaWoR 使用了自适应 SLAM 和度量深度尺度。在 EgoX-Bench 上,EgoX 将 W-MPJPE 从 WiLoR + SLAM 的 328.81 mm 降至 113.24 mm。结果表明,世界空间中的手部放置更好,而不仅是局部姿态估计更好。
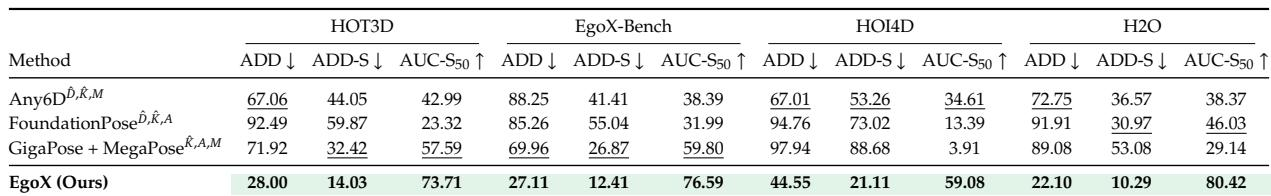
EgoX 在全部四个基准上取得最佳相机坐标系物体位姿重建结果,具有最低的 ADD 和 ADD-S 误差以及最高的 AUC-S50。这些优势即使对使用额外输入(如估计深度、内参、度量 CAD 资产或逐帧掩码)的基线也成立。结果表明,使用更少的辅助输入即可获得更准确的物体位姿。EgoX 在 HOT3D、EgoX-Bench、HOI4D 和 H2O 上报告了最低的 ADD 和 ADD-S 以及最高的 AUC-S50。在 EgoX-Bench 上,EgoX 超过来自 GigaPose + MegaPose 的最强竞争结果,尽管该流程使用了度量 CAD 资产和逐帧掩码。在 HOI4D 上,EgoX 超过 Any6D,后者接收估计深度、内参和逐帧掩码。
在相机和深度重建方面,EgoX 在全部四个基准上取得最低深度误差和最高深度内点率,同时相机运动也优于 ReViV。相机度量结果更依赖数据集,VGGT-Ω 在 HOT3D 和 EgoX-Bench 上领先,EgoX 在 HOI4D 上领先,DA3 Nested 在 H2O 上领先。EgoX 使用自己预测的度量尺度获得深度精度,而非从 DA3 Nested 深度拟合尺度。EgoX 在每个基准上都报告最强的深度重建,在 EgoX-Bench 上相对 ReViV 和 VGGT-Ω 的增益尤其大。EgoX 在全部四个基准上取得低于 ReViV 的相机平移和旋转误差。在相机指标上,最佳结果随数据集不同而变化:VGGT-Ω 在 HOT3D 和 EgoX-Bench 上领先,EgoX 在 HOI4D 上领先,DA3 Nested 在 H2O 上领先。
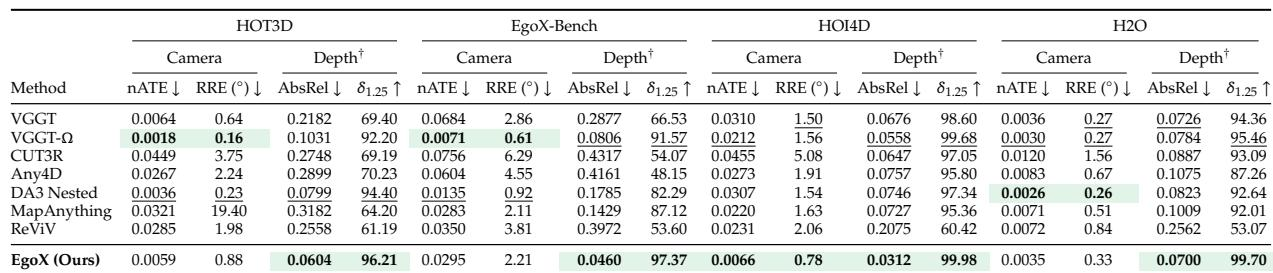
实验将 EGOX-Data-6M 引入为中等规模自我中心数据集,独特地覆盖单区域、跨区域和室外采集,并在共享度量坐标系中提供对齐的相机、场景、手部和物体标注,弥补了现有基准的不足。实验在 HOT3D、EgoX-Bench、HOI4D 和 H2O 上将 EgoX 与端到端和多阶段重建方法进行比较,表明 EgoX 是唯一联合重建相机、深度、手部和物体 6-DoF 位姿的端到端方法。结果验证 EgoX 在全部基准上取得最准确的手部重建和相机坐标系物体位姿估计,与世界空间对齐更好,且相比竞争流程所需辅助输入更少;同时提供最强的深度重建,并改进了相对 ReViV 的相机运动;最佳相机指标仍随数据集不同而变化。