Command Palette
Search for a command to run...
Holi-World:从人类自我中心体验构建整体世界智能
Holi-World:从人类自我中心体验构建整体世界智能
Hao Li Xiyuan Zheng Yuanyuan Gao Yalun Dai Xinhao Ji Xuan-Li Chen Jing Zhao Fangzhou Hong Zhaoxi Chen Ziwei Liu
摘要
人类自我中心体验为学习世界如何组织以及如何通过交互发生变化提供了丰富基础。要在规模化层面实现这一潜力,需要将不断增长的记录转化为学习资源,这些资源跨视角和时间连接场景结构、对象语义和交互历史,同时减少对昂贵人工标注的依赖。我们提出了 HOLI-WORLD,一个连接体验采集、世界表示、自动化数据构建、模型学习和独立评估的集成生态系统。为支持规模化学习,HOLIWORLD-Foundry 结合互补的静态与动态感知,自动构建世界记录,将持久场景结构和动态变化的对象状态与交互历史及支撑观测关联起来。HOLIWORLD-Data 将来自约 100 个自行采集场景的这些记录组织为有依据的学习资源,包括约 80K 用于训练 HOLIWORLD-VL-4B 的问答对。对留出记录的独立人工标注构成 HOLIWORLD-Bench,用于评估标注质量以及模型学习到的空间与时间理解能力。在 ScanNet、ScanNet++、Aria Digital Twin 和 HOLIWORLD-Bench 上的实验展示了静态感知和动态跟踪方面的强劲性能,而在 HOLIWORLD-Data 上训练显著提升了 HOLIWORLD-VL-4B 在 HOLI-WORLD-Bench 和 EgoDynamic4D 上的空间与时间推理能力。HOLIWORLD 为从持续的人类体验流中扩展学习资源并推进机器对动态世界的理解提供了实用基础。
一句话总结
Ropedia 等人提出 HOLI-WORLD,一个集成了体验采集、世界表示、自动数据构建、模型学习和独立评估的综合生态系统。其中 HOLIWORLD-Foundry 结合静态与动态感知,将从约 100 个自采场景自动构建的世界记录整合为 HOLIWORLD-Data,包含约 80K 个 QA 对;在这些资源上训练可提升 HOLIWORLD-VL-4B 在 HOLIWORLD-Bench 和 EgoDynamic4D 上的空间与时间推理能力。
核心贡献
- 论文提出 HOLIWORLD,一个连接体验采集、世界表示、自动数据构建、模型学习和独立评估的综合生态系统。
- HOLIWORLD-Foundry 结合互补的静态与动态感知,自动构建世界记录,将持久场景结构、变化的物体状态和交互历史与支撑观测关联起来。
- HOLIWORLD-Data 将来自约 100 个自采场景的记录组织成约 80K 个 QA 对,用于训练 HOLIWORLD-VL-4B;HOLIWORLD-Bench 通过独立人工标注提供评测。在 ScanNet、ScanNet++、Aria Digital Twin、HOLIWORLD-Bench 和 EgoDynamic4D 上的实验表明,静态感知、动态跟踪以及空间与时间推理均有提升。
引言
即使借助视觉语言模型和预测视频建模,跨视角和时间构建对物理世界的一致理解仍然是一个开放的 AI 挑战。第一人称记录提供了人们体验环境、物体和交互的直接途径,但将这些记录转化为细粒度监督通常需要大量人工标注和整理。静态场景重建和第一人称物体跟踪此前分别发展,但将场景几何、物体语义和交互历史连接成可追溯的学习资源仍然困难。作者提出了 HOLIWORLD,一个综合生态系统,其 HOLIWORLD-Foundry 流程从真实场景第一人称视频中自动重建静态场景并跟踪动态物体状态,生成 HOLIWORLD-Data 和证据驱动的 QA 监督,用于训练 HOLIWORLD-VL。作者还通过独立人工标注建立 HOLIWORLD-Bench,以评估恢复的世界记录和下游空间推理。
数据集
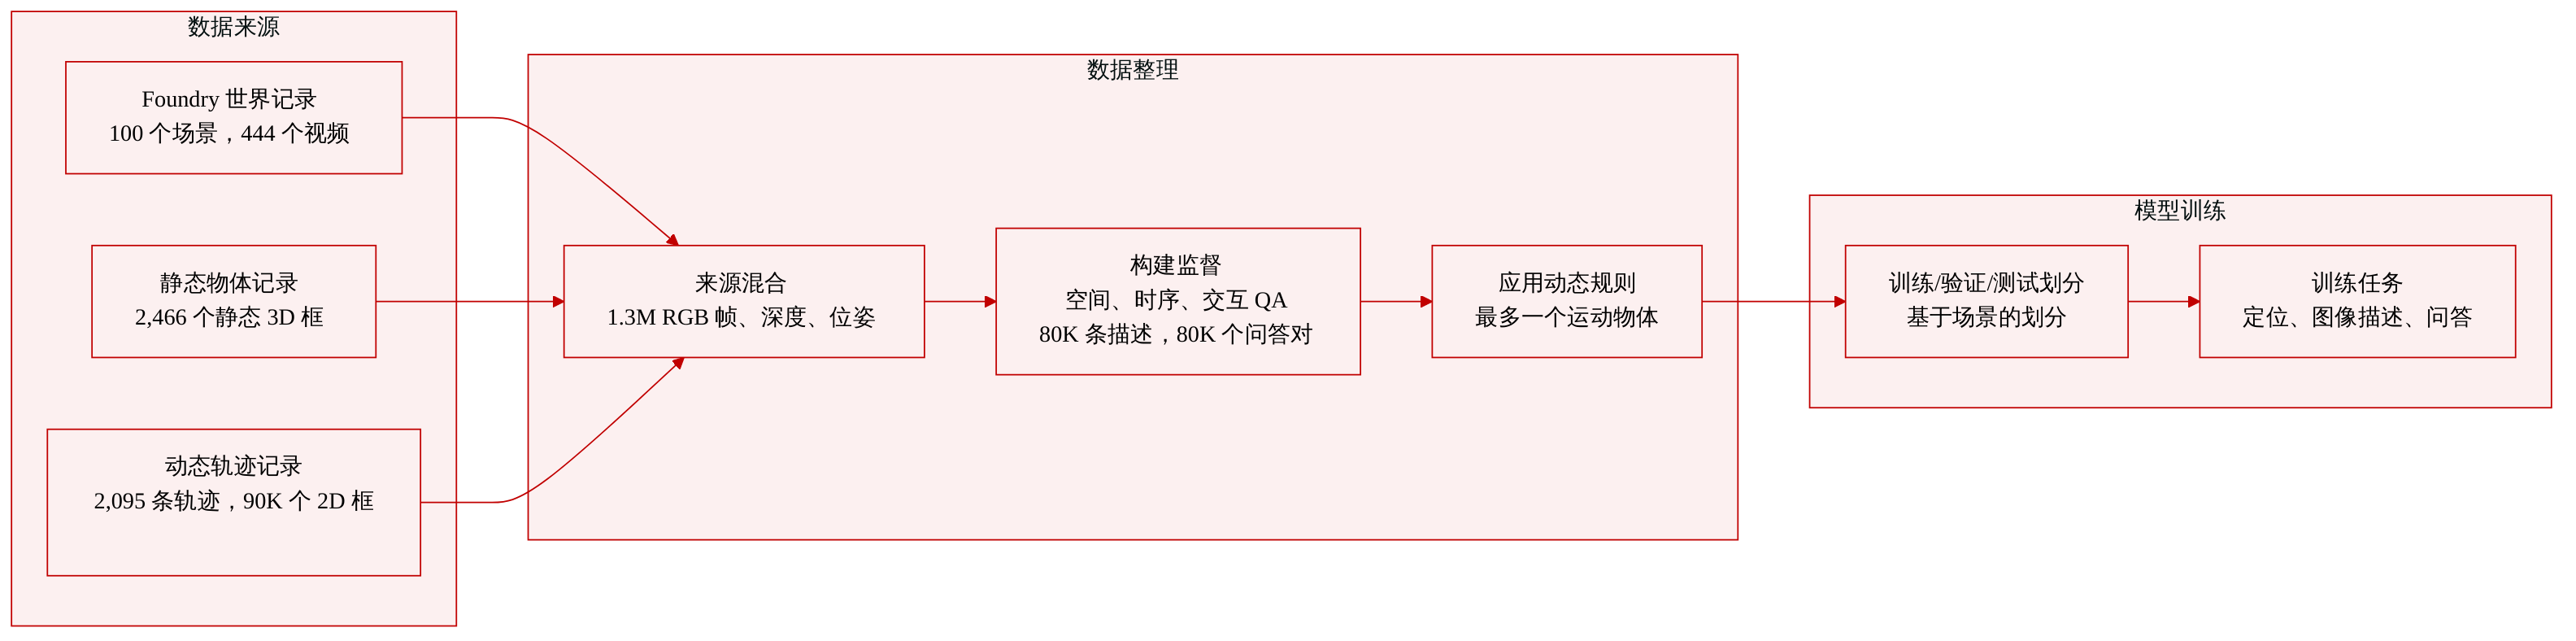
作者从 Foundry 的世界记录构建 HoliWorld-Data。数据集将监督组织为 grounding、图像描述以及空间、时间和交互 QA。每个样本都保留其来源观测和标注的链接,使输出可追溯到特定物体、时间和证据。
-
来源与范围:基于 Foundry 的世界记录构建。静态物体及其几何支持空间理解。具有一致身份的动态轨迹支持运动和时间理解。与交互语义配对的轨迹支持对物体操作和状态变化的描述。
-
标注构建:QA 对由空间、时间和交互标注生成,遵循 EgoDynamic4D 的 QA 模式。Grounding 将指代表达式关联到 2D 观测、静态 3D 框或动态轨迹。空间 QA 使用物体几何和相机位姿推导方向、距离、包含、支撑以及与视角相关的关系。时间 QA 比较物体状态随时间的变化,以描述运动、事件顺序和持续时间。交互 QA 使用交互语义描述被操作物体和状态变化。场景描述和盘点问题聚合跨帧的物体记录。动态监督假设每个时刻至多有一个运动物体。
-
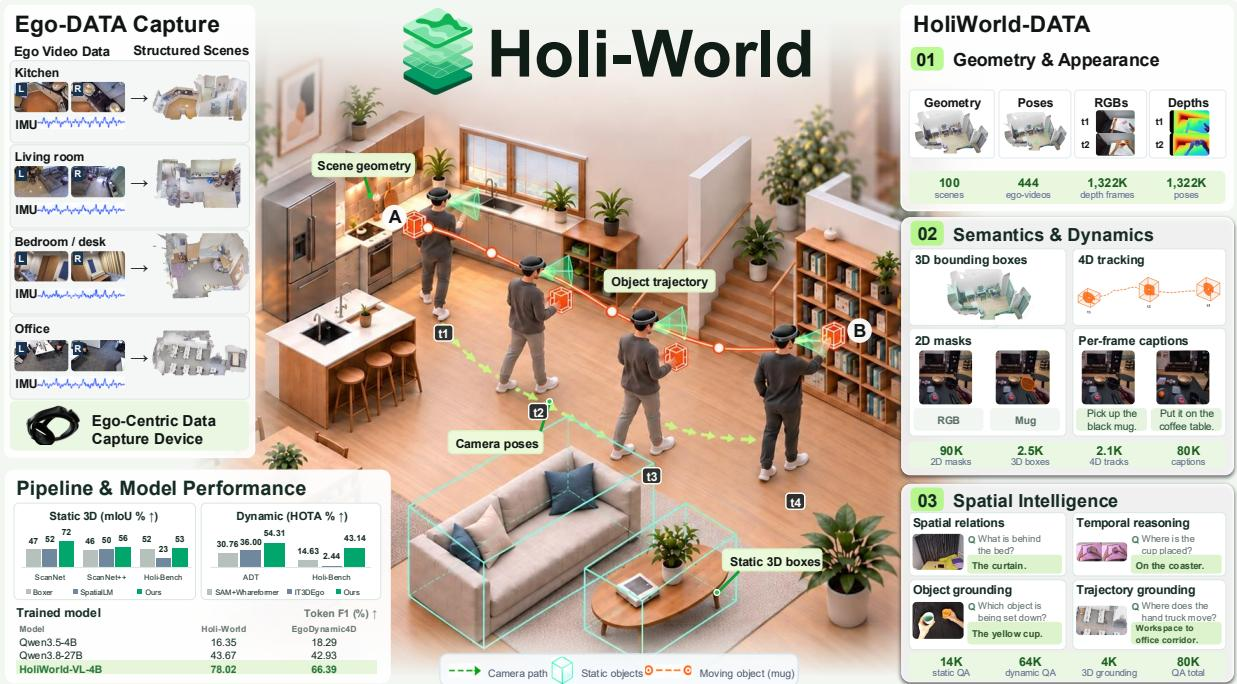
组成:HoliWorld-Data 包含大约 100 个场景、444 段第一人称视频、约 100 个 3D Gaussian splatting 重建、1,322K 帧 RGB 图像(含深度图和相机位姿)、90K 个 2D 框、2,466 个静态 3D 框和 2,095 条动态轨迹。它支持约 4K 个 3D grounding 标注、80K 条图像描述、13,647 个静态 QA 对和 64,409 个动态 QA 对,总计约 80K 个 QA 对。
-
用途:作者使用数据集提供 grounding、图像描述、空间 QA、时间 QA 和交互 QA 监督。来源观测和标注保持关联,因此目标输出可追溯到特定物体和时间。
方法
作者提出了 HoliWorld,一个将第一人称记录转换为空间和时间对齐监督以训练视觉语言模型的综合生态系统。该框架整合了硬件采集、场景重建、标注和数据集生成,以产生高质量的空间理解数据。
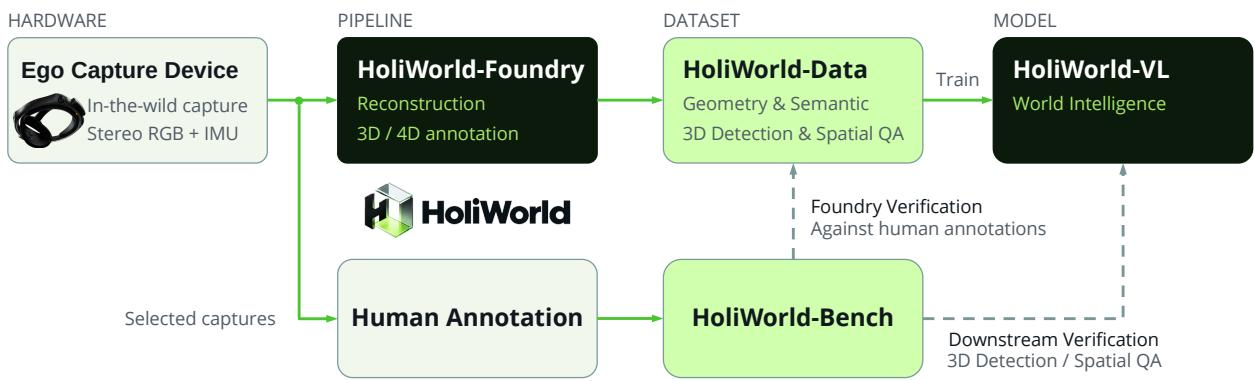
流程从 Eagle Capture Device 开始,该设备记录同步的立体 RGB 和 IMU 测量。随后 HoliWorld-Foundry 重建场景并标注静态物体和动态轨迹。HoliWorld-Data 将这些输出组织为用于 HoliWorld-VL 的 grounding、图像描述和空间 QA 监督。对留出记录进行独立人工标注,形成 HoliWorld-Bench,以评估标注质量和模型的空间理解。
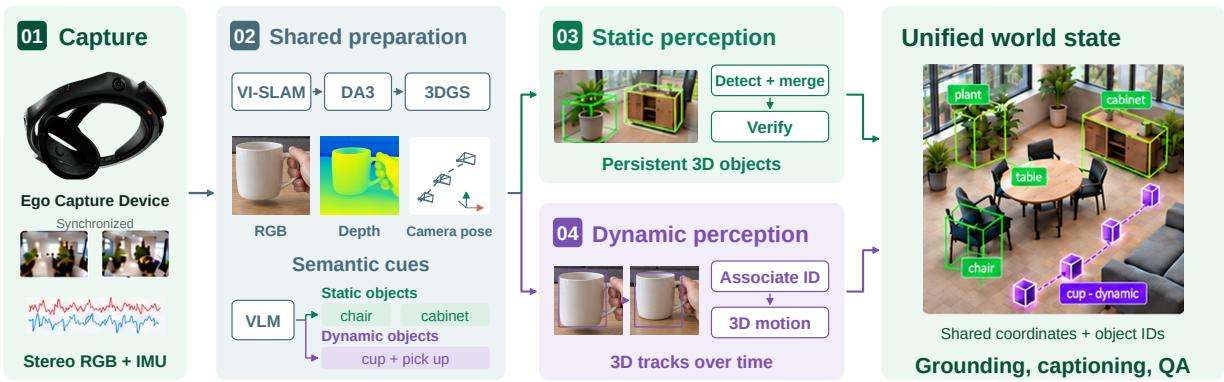
在 HoliWorld-Foundry 内部,流程从几何准备和共享语义线索开始。作者首先使用视觉惯性 SLAM 从立体 RGB 和 IMU 中恢复相机位姿和稀疏点。然后他们使用 Depth Anything 3 (DA3) 从 RGB 关键帧和这些位姿估计深度和稠密点。利用 RGB 观测和这些几何信息,他们优化 3D Gaussian 场景表示 G,在观测位姿处渲染精细深度,并通过逐帧 DA3 深度估计补全动态区域。所得观测被组织为:
O={(It,Dt,Kt,Tt)}t=1T,其中 It 是 RGB 帧,Dt 是深度图,Kt 是相机内参矩阵,Tt 将相机坐标映射到世界坐标。为了将静态和动态物体分配到各自的感知流程,一个视觉语言模型(VLM)从 O 中的 RGB 关键帧中提取类别、属性、运动线索和交互描述。类别引导基于图像的静态候选目标,而运动和交互线索用于识别动态跟踪目标。
对于静态物体感知,作者采用双路径 3D 检测策略,以同时捕获物体细节和场景级几何。在基于图像的路径中,他们分别在左右 RGB 流上运行 Boxer,以捕获互补的物体细节。开放词汇 2D 检测结果利用对应深度和相机位姿提升为度量尺度的 3D 框,然后跨帧关联。与此同时,TR3D 在重建场景点云 P 中检测物体,捕获超出单视图的大物体范围。为了处理多个指向同一物体的候选目标,并丢弃几何支持较弱的候选目标,在 VLM 验证之前,低成本的几何检查会合并空间上兼容的框,并过滤掉在 P 中缺乏足够点支持的框。随后 VLM 根据源观测和从 G 渲染的补充视图检查每个被选中的框。根据这些证据,VLM 可以保留该框、优化其几何、重新标记其类别或拒绝该框。如果被拒绝,则评估一个预选的备用框。被接受的框形成 Bsta,并带有指向其支持观测的链接。
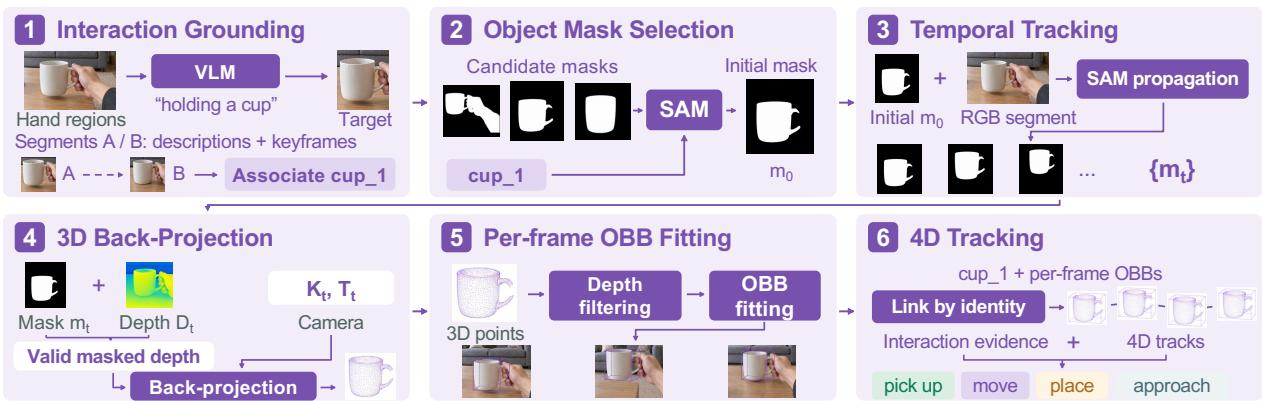
动态物体感知处理可能消失又重新出现的被操作物体。为了在间断后识别同一物体,作者使用手部区域和 VLM 交互描述来识别每个片段中的目标,比较描述和关键帧证据以建立一致的物体身份。在这些身份的引导下,Segment Anything Model (SAM) 选择并初始化目标掩码,然后在每个交互片段内传播该掩码,得到 {mt},其中 mt 表示时间 t 时运动物体的前景像素。为了恢复物体在世界坐标中的状态,使用 DA3 补全的动态深度 Dt 和相机位姿对每个有效跟踪掩码的像素进行反投影:
Xt={Tt(Dt(u)Kt−1uˉ)u∈mt,Dt(u) is valid},其中 uˉ 是齐次图像坐标,Xt 包含物体支撑的世界点。在过滤掉无支撑的深度样本后,对每个点集拟合有向包围盒(OBB),并将具有相同身份的框跨时间连接,形成动态 4D 轨迹。
Foundry 的输出被统一为一个世界表示 S(t)=(Ot,U(t),G,P,Bsta,Bdyn(t),Z(t)),其中 U(t) 包含检测到的 2D 框和被跟踪的掩码,Z(t) 记录关联的标签、身份、置信度分数、交互语义和证据链接。这种表示使监督能够指向特定物体、时间和支撑观测。
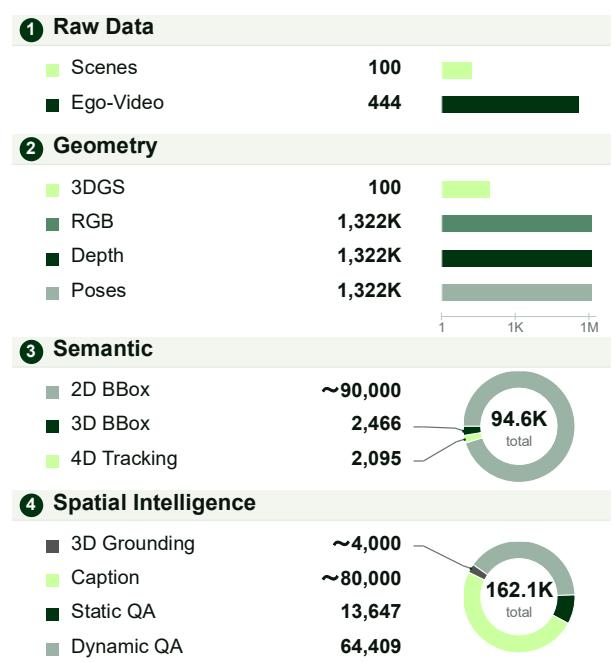
最后,HoliWorld-Data 将这些世界记录组织为 grounding、图像描述以及空间、时间和交互 QA 监督。静态物体及其几何支持空间理解,而具有一致身份的动态轨迹支持运动和时间理解。QA 对按照既定模式构建,其中 grounding 任务将指代表达式与 2D 观测、静态 3D 框或动态轨迹关联。空间 QA 使用物体几何和相机位姿推导方向、距离和包含关系。时间 QA 比较物体状态随时间的变化,交互 QA 使用交互语义描述被操作物体和状态变化。最终数据集包含约 100 个场景、444 段第一人称视频、1,322K 帧带深度图和相机位姿的 RGB 图像、2,466 个静态 3D 框和 2,095 条动态轨迹,支持约 80K 个 QA 对和 80K 条图像描述。
实验
实验评估了该流程在静态场景中生成以物体为中心的 3D 标注以及跟踪运动物体的能力,并分别评估静态感知、动态跟踪、下游理解和消融。该方法在静态物体检测和动态跟踪上持续优于基线,表现出更完整的物体覆盖、更对齐的空间范围和更一致的轨迹。在生成数据上进行下游微调可显著改善空间和时间推理,消融实验证实图像提升、点云检测、立体融合和图像描述引导等静态组件提供了互补收益,而动态组件改善了身份连续性和轨迹稳定性。
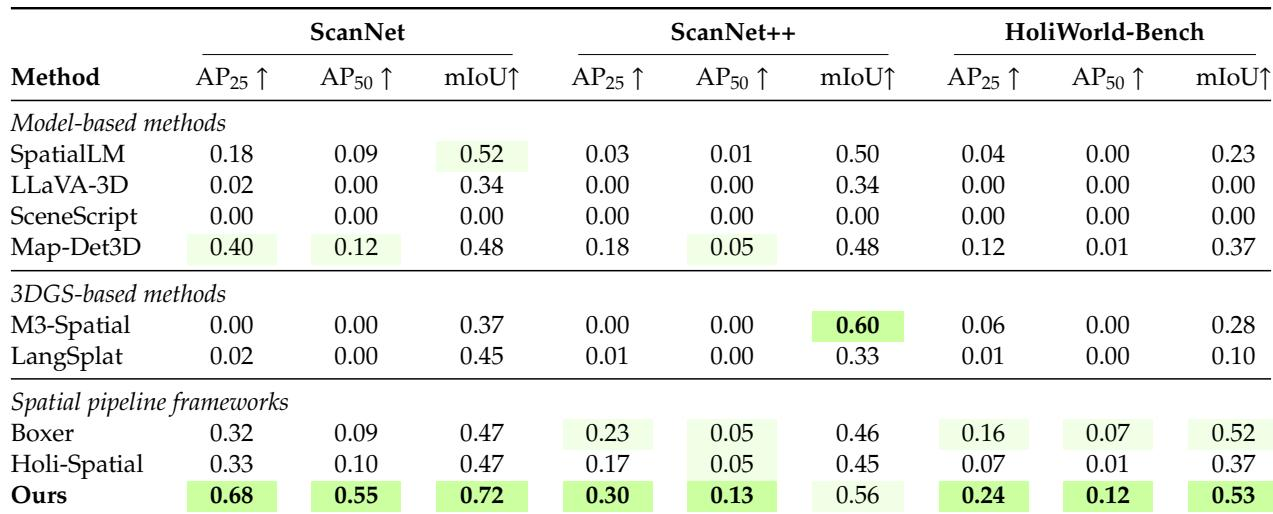
HOLIWORLD-FOUNDRY 在 ScanNet、ScanNet++ 和 HoliWorld-Bench 上取得最强的静态 3D 物体感知结果,在三个数据集的 AP25 和 AP50 上均领先。其 AP50 相对于最佳基线的差距在 ScanNet 和 ScanNet++ 上尤其大,表明在更严格的几何匹配下检测更精确。在所比较的基于模型的基线中,Map-Det3D 通常产生最佳检测 AP,而其他几种方法几乎为零。HOLIWORLD-FOUNDRY 在三个静态感知基准上取得最高的 AP25 和 AP50。其 AP50 相对于最强基线的领先幅度在 ScanNet 和 ScanNet++ 上显著更大,表明在更严格匹配下性能更好。Map-Det3D 是检测 AP 最强的基于模型的基线,但仍远落后于 HOLIWORLD-FOUNDRY。包括 SceneScript 和 LLaVA-3D 在内的几种基于模型的基线在评估数据集上的 AP 分数几乎为零。
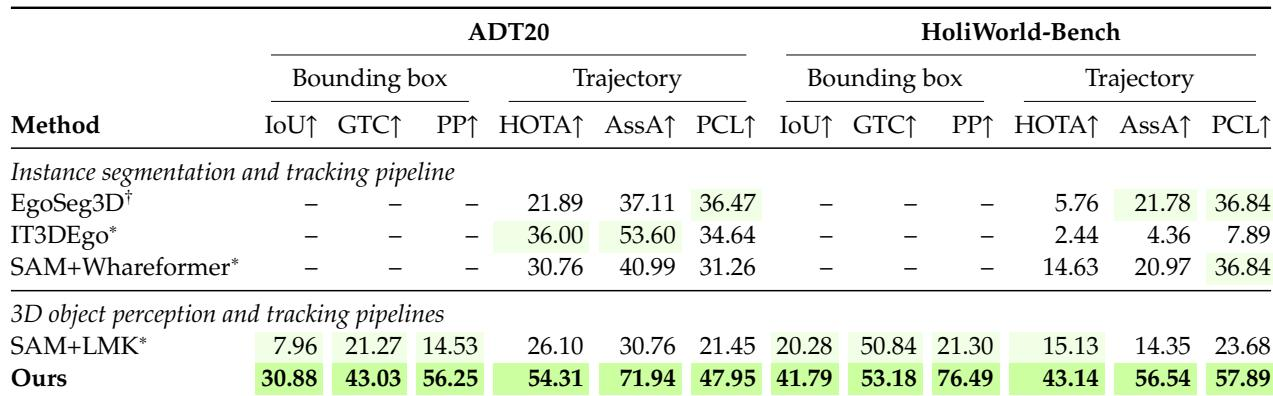
HOLIWORLD-FOUNDRY 在 ADT20 和 HoliWorld-Bench 上的动态 3D 物体跟踪均领先,HOTA 显著高于最强的对比流程。这些提升伴随着更高的关联分数和轨迹覆盖分数,表明物体身份更一致、跟踪覆盖更广。补充的框指标也反映匹配物体上的空间范围对齐得到改善。HOLIWORLD-FOUNDRY 在两个数据集上取得最佳 HOTA,在 HoliWorld-Bench 上领先幅度尤其大。更高的 AssA 和 PCL 表明身份比基线更一致,轨迹覆盖更广。框指标为匹配物体上更好的空间对齐提供了补充证据。
在 HoliWorld-Data 上微调 Qwen3.5-4B 可在 HoliWorld-Bench 和 EgoDynamic4D 上带来大幅空间推理提升。得到的 HoliWorld-VL-4B 在两个基准的所有四个报告指标上均超过零样本 Qwen3.8-27B。提升涵盖 yes/no、多选和数值准确率,表明在不同问题格式上均带来广泛收益。微调后,Token F1 在 HoliWorld-Bench 上从 16.35% 提升到 78.02%,在 EgoDynamic4D 上从 18.29% 提升到 66.39%。HoliWorld-VL-4B 在每项指标上均取得最高准确率,包括 EgoDynamic4D 上 99.67% 的 yes/no 准确率,以及两个基准上超过 90% 的多选准确率。
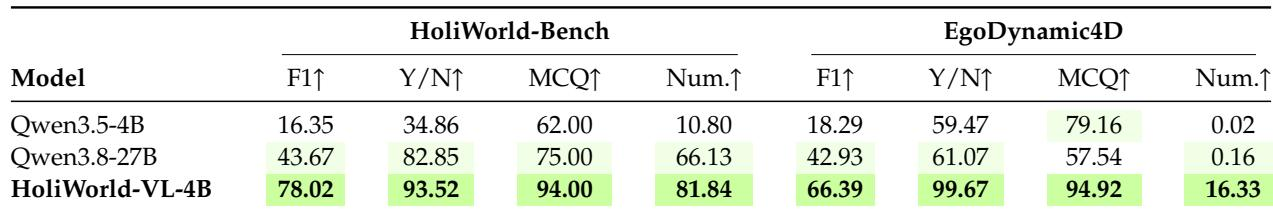
实验评估了 HOLIWORLD-FOUNDRY 在静态 3D 物体感知、动态 3D 物体跟踪和微调后空间推理上的表现。在静态感知中,它在 ScanNet、ScanNet++ 和 HoliWorld-Bench 上优于所有基线,在更严格的几何匹配下提升尤为明显,而几种基于模型的基线仍几乎为零。在动态跟踪方面,它在 ADT20 和 HoliWorld-Bench 上实现了最强的物体身份一致性和轨迹覆盖。在 HoliWorld-Data 上微调 Qwen3.5-4B 还在 HoliWorld-Bench 和 EgoDynamic4D 上带来了广泛的空间推理改进,在不同问题格式上超过了一个大得多的零样本模型。