Command Palette
Search for a command to run...
聚焦式全模态 GUI 智能体
聚焦式全模态 GUI 智能体
Fuyao Zhang Wenwen He Jiaming Zhang Yurong Hao Xuan Wang Guowei Guan Che Wang Longtao Huang Wei Yang Bryan Lim
摘要
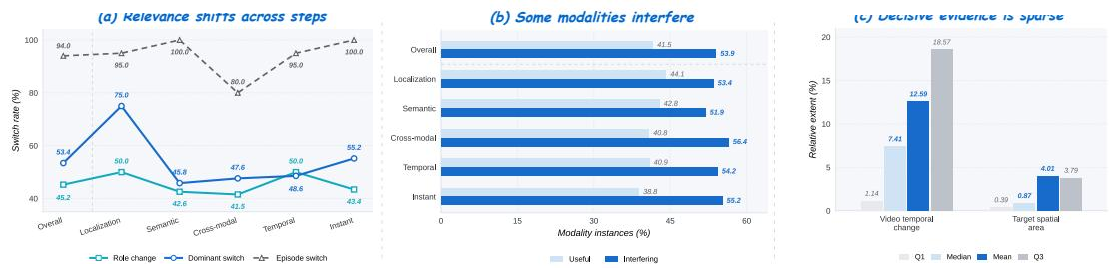
图形用户界面(GUI)智能体越来越多地基于流式全模态观测进行行动,这些观测涵盖屏幕截图、音频、视频、交互历史和设备状态。然而,在每一步都均匀地暴露这一完整上下文,忽视了相关性是瞬时且稀疏的:决定某一动作的信号在下一步可能变成干扰。由于执行的动作会反馈回上下文中,这些误差会累积为“顺序干扰”(Sequential Distraction),使智能体陷入不可逆的轨迹漂移。我们将这一底层需求形式化为“聚焦感知”(Focused Perception):一种逐步自适应、动作充分且非侵入式的表示。我们在 FocusGUI 中实现了这一需求,FocusGUI 是一个轻量级适配器,它根据步骤特定的决策参考动态地对多模态通道进行优先级排序。FocusGUI 并非统一处理所有输入,而是将最相关的证据压缩为紧凑的潜在表示,并微妙地注入冻结解码器的嵌入中,在不改变其原生参数空间的情况下引导模型的注意力。FocusGUI 仅通过动作监督进行训练,既不需要模态相关性标签,也不需要微调主干网络。在四个全模态主干网络上,与冻结主干网络相比,FocusGUI 平均将总体 Type Match 提高 +33.2,将 Exact Match 提升至 3.0 倍;与最强的现有增强方法相比,Type Match 提高 +30.1。
一句话总结
来自南洋理工大学和阿里巴巴集团的研究者提出 FocusGUI,一种轻量 adapter,它针对步骤特定决策参考动态优先化全模态 GUI 通道,将最相关证据压缩为紧凑 latent,并微妙地将其注入冻结解码器嵌入以引导注意力,而不改变 backbone 原生参数空间;仅通过动作监督训练,FocusGUI 在四个全模态 backbone 上平均将 Type Match 提高 +33.2,Exact Match 提高 3.0×。
核心贡献
- 论文将 Focused Perception 形式化为面向全模态 GUI agents 的步骤自适应、动作充分且非侵入式表示需求,以解决 Sequential Distraction 的累积误差。
- FocusGUI 作为一种轻量 adapter 被提出,它针对步骤特定决策参考动态优先化多模态通道,将最相关证据压缩为紧凑 latent,并通过动作边界处零初始化残差注入冻结解码器。
- 仅从动作监督训练,无需模态相关性标签或 backbone 微调,FocusGUI 在四个全模态 backbone 上相比冻结 backbone 平均将 Type Match 提高 +33.2,Exact Match 提高 3.0x,并相比最强现有增强方法将 Type Match 提高 +30.1。
引言
GUI agents 现在基于流式全模态观测运行,其中下一步动作的证据可能来自音频、视频、设备状态或视觉变化,而不仅仅是当前截图。这种步骤级相关性很重要,因为闭环 agents 会将已执行的动作反馈到下一次观测中,因此误读一个步骤可能累积为轨迹漂移。先前工作通常通过空间裁剪屏幕来应对,但这种方法忽略非视觉信号,并可能移除定位坐标和文本所需的背景上下文;更深层的局限是解码器缺少关于当前步骤发生了什么变化的显式引导。作者提出 FocusGUI,它保持冻结的全模态 backbone 及其完整输入不变,根据从当前观测导出的参考对可分离感知通道进行评分,将优先通道压缩为 focus latent,并通过零初始化残差在动作解码边界处注入该 latent,仅使用下一动作监督。
数据集
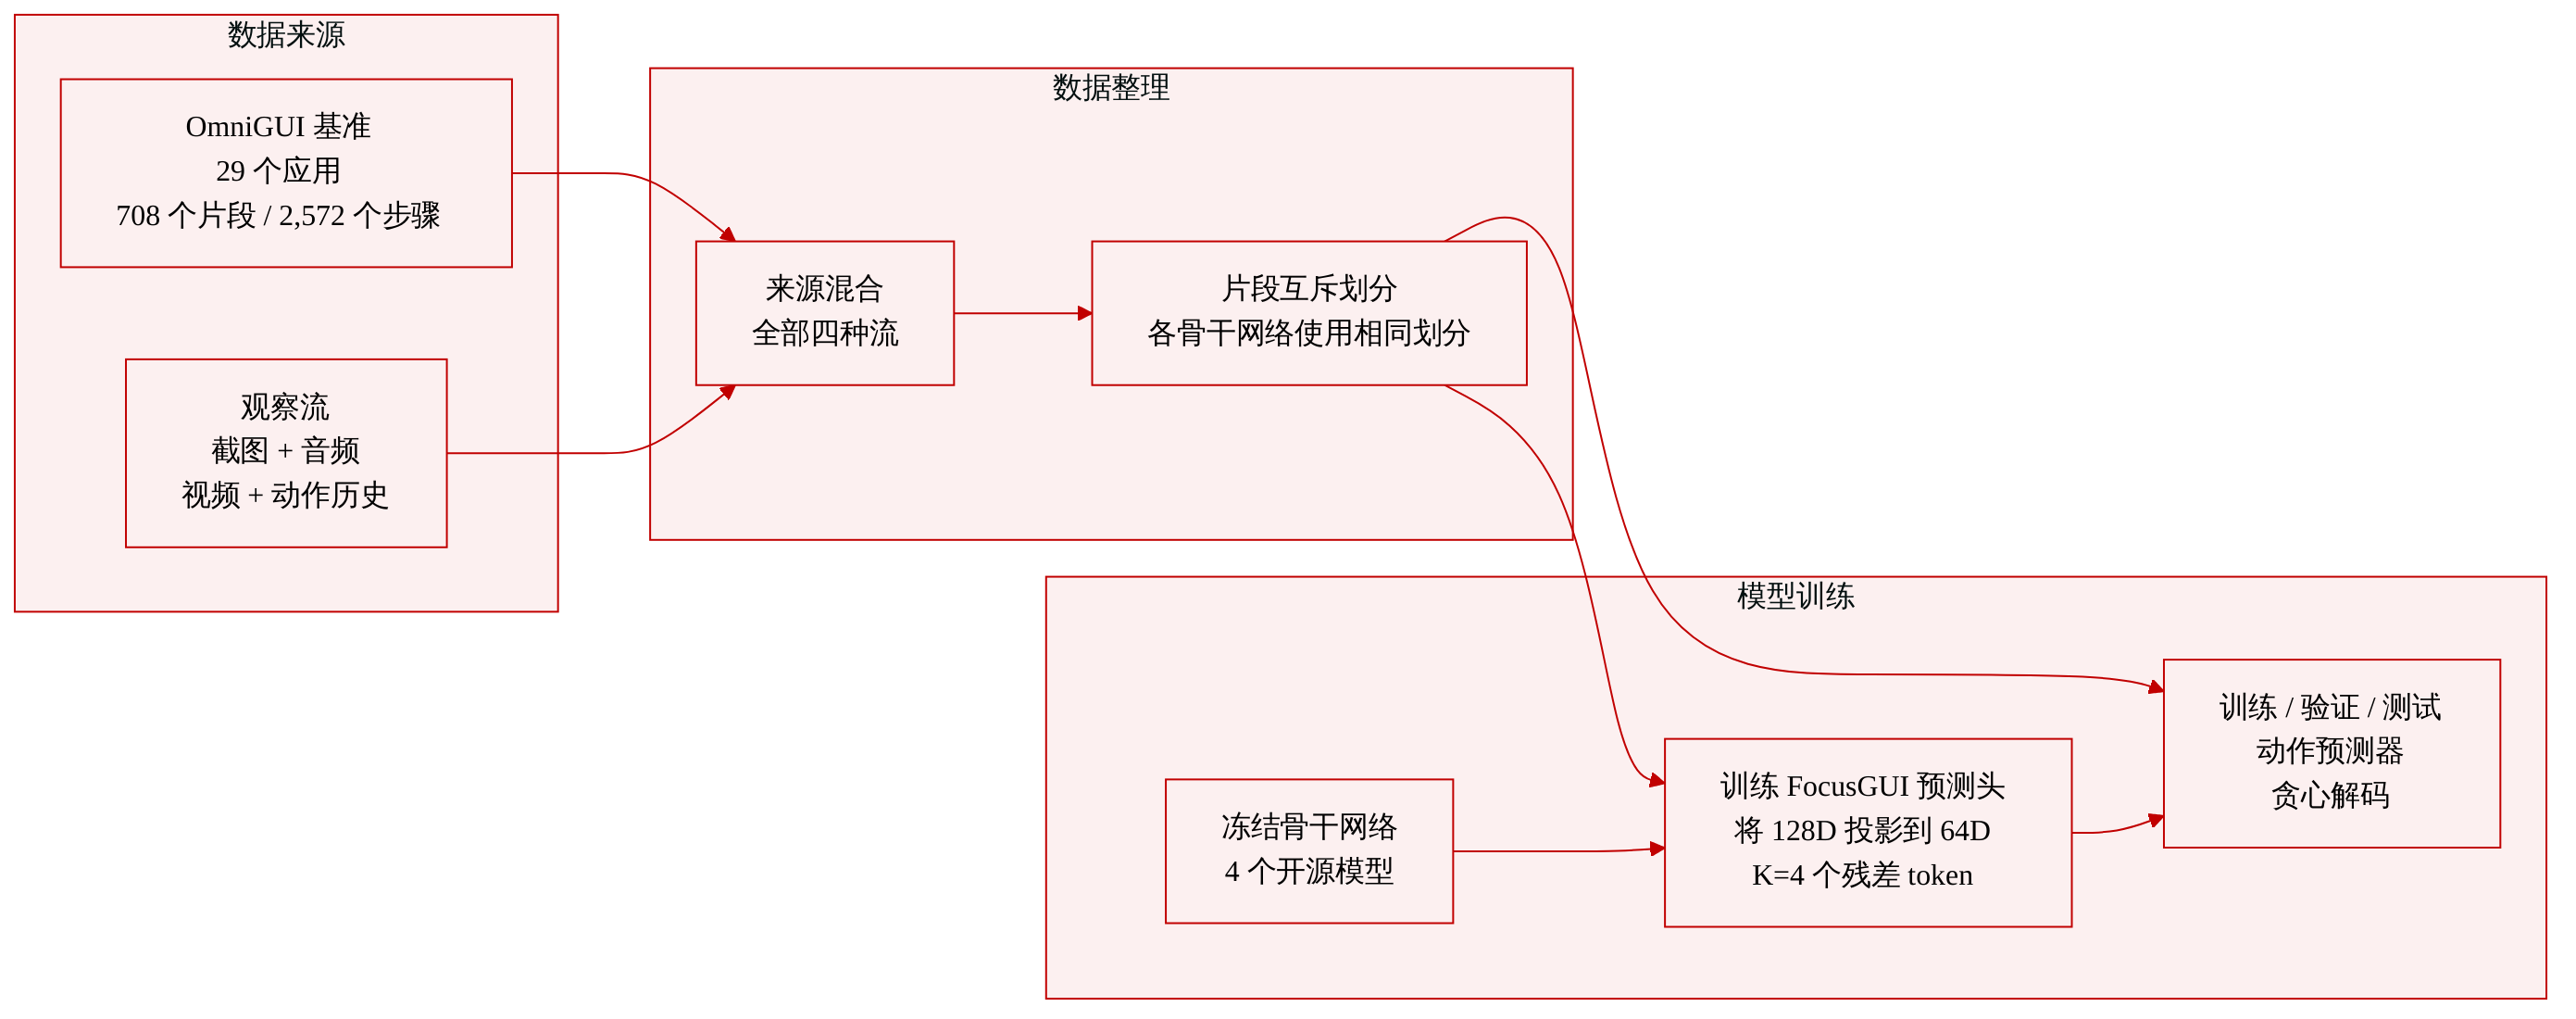
作者在 OmniGUI 上评估,这是一个面向全模态智能手机 GUI 交互的 benchmark。
- 来源与组成:OmniGUI 覆盖 29 个应用 中的 GUI 交互。
- 规模:该 benchmark 包含 708 个 episode,共 2,572 个动作步骤。
- 观测结构:每个动作步骤将截图与同步音频、视频和动作历史配对。决定性信号可以来自这四个流中的任意一个。
- 真值与指标:
- Type Match (TM):检查预测的动作原语是否与真值匹配。
- Exact Match (EM):还要求预测坐标落在目标元素的边界框内,且生成的文本与参考匹配。
- Goal Progress (GP):每个 episode 中正确执行步骤的比例,并在各 episode 上取平均。
- 划分与使用:作者采用 episode 不相交划分,在四个 backbone 和所有 baseline 上一致应用。冻结的 backbone 不更新;训练仅更新轻量 FocusGUI head 和动作预测器。
- FocusGUI 中的处理细节:证据通道被投影到共享的 128 维 空间,由全模态查询加权,压缩为 64 维 的动作充分嵌入,并扩展为 K = 4 个残差 token,添加到动作边界前的最后 prompt 嵌入中。
- 过滤与裁剪:提供的节选未说明数据集过滤规则或裁剪策略。
方法
作者将 GUI 交互形式化为全模态观测下的下一动作预测问题。在每个交互步骤 t,agent 接收到观测
Ot={g,It,Vt,At,Ht,St},其中 g 是用户目标,It 是当前界面,Vt 是时序视觉观测,At 是声学观测,Ht 是交互历史,St 是设备状态。模型预测可执行动作序列
yt=(yt,1,…,yt,Lt),该序列同时指定动作原语及其参数。
FocusGUI 围绕参数为 Θ0 的冻结预训练全模态 backbone 构建。该方法不剪枝或替换观测的任何部分,而是保持原始多模态路径不变,并添加轻量的辅助 focus 路径。FocusGUI 从同一观测构造紧凑的 focus 表示
zt=fϕ(Ot),将其映射为残差
Rt=Aϕ(zt),并将该残差注入一小组现有嵌入位置。因此解码器作用在
Et=Et+SJt(γRt),其中 Et 是呈现给解码器的原始嵌入序列,Jt 表示所选位置,SJt 仅在这些位置放置残差。该设计将观测保留与决策引导分离:原始路径保留所有多模态证据,而辅助路径学习应如何强调下一动作。
为显式化来源优先级,FocusGUI 首先将观测暴露为可分离感知通道
Xt={xt(m)}m∈M,其中 M 索引各个模态以及 backbone 隐藏状态和一个空间屏幕通道。每个通道通过特定于来源的投影器被投影到共享的 d 维空间,
et(m)=Pm(xt(m))∈Rd.决策参考 qt 由集成表示 et(all) 通过
qt=Pq(et(all)),导出,其总结了联合观测上下文。对每个通道,FocusGUI 计算其与该联合上下文的兼容性分数,并将分数归一化为步骤特定优先级:
st(m)=v⊤tanh(We(et(m)+rm)+Wqqt), αt(m)=∑j∈Mexp(st(j)/τ)exp(st(m)/τ), ct=m∈M∑αt(m)et(m).这里 rm 是学习到的通道身份嵌入,τ 是 softmax 温度。由于感知通道和联合上下文在每一步都会重新计算,信息源之间的相对强调可以在任务过程中变化,而无需在步骤之间携带状态。
优先化表示 ct 随后被压缩为更低维的 focus 向量
zt=Ps(ct)∈Rdz,dz<d.该投影约束的是条件信号的容量,而不是 backbone 可访问的信息。为使 focus 可被冻结解码器使用,FocusGUI 在动作边界处将其与解码器嵌入空间对齐。令 bt 表示动作生成开始的位置,并令
Jt={bt−K,…,bt−1}为前 K 个嵌入位置。紧凑 focus 向量被扩展为该窗口上的残差:
Rt=Reshape(Wpzt+bp)∈RK×dmodel, Et,Jt=Et,Jt+γRt.残差在动作生成前立即注入,因此 focus 信号可供所有后续动作 token 使用,无需单独的预测头,也不改变输出词汇表。加性形式保留原始嵌入,并将 focus 仅视为额外条件信号。参数 Wp 和 bp 初始化为零,因此训练从原始冻结模型的输入开始,并逐渐学习以观测为条件的偏差。该方法不追加文本提示,也不移除任何多模态输入。
所有 FocusGUI 组件仅从动作监督中联合学习,没有指示应强调哪个模态或通道的标注。令 ϕ 表示可训练参数。训练目标为
Lact(ϕ)=−∣Dtr∣1t∈Dtr∑Lt1k=1∑LtlogpΘ0,ϕ(yt,k∣yt,<k,Ot).损失仅对动作 token 计算。梯度通过冻结解码器传播到辅助参数 ϕ,而全模态 backbone、解码器和语言模型 head 保持不变。推理时,FocusGUI 从当前观测构造感知通道,在当前联合语义上下文中评估它们,形成紧凑 focus 表示,并生成相应残差。冻结解码器随后通过其原始生成路径自回归地产生下一可执行动作。
实验
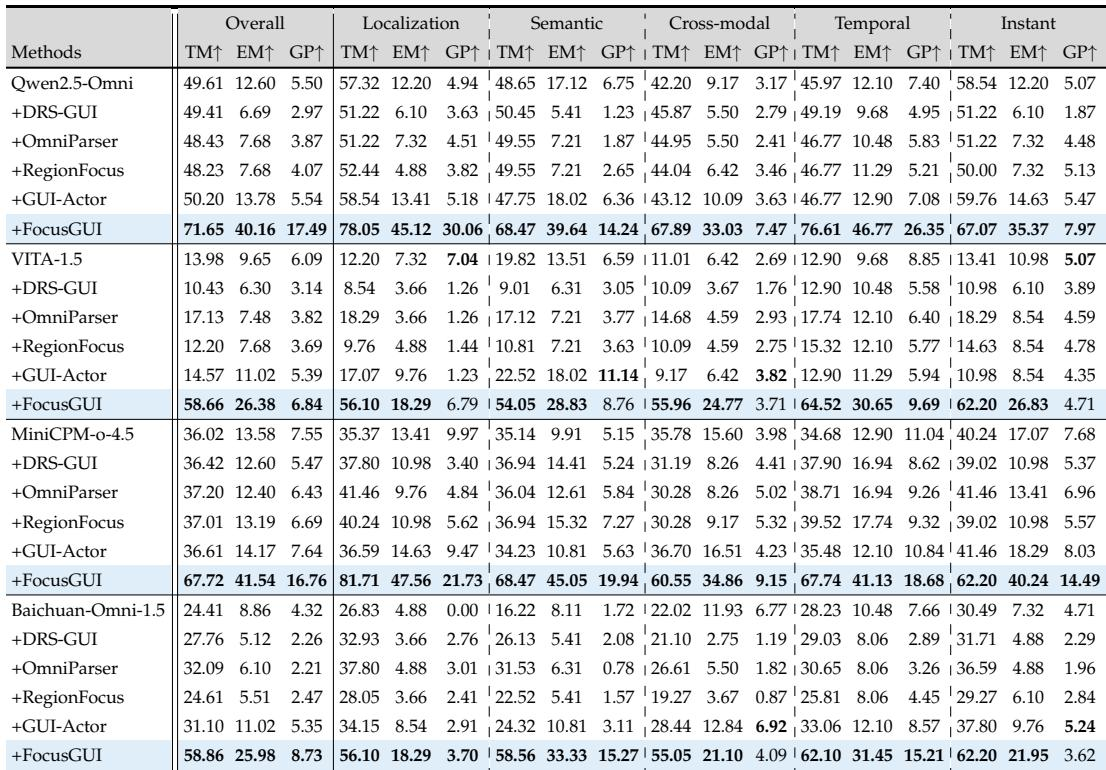
实验在 OmniGUI 上评估 FocusGUI,OmniGUI 是跨 29 个应用的全模态智能手机 GUI benchmark,使用四个冻结开源 backbone 模型,并与屏幕精修 baseline 和训练的动作 head 进行比较。主要结果表明,FocusGUI 在所有 backbone 上一致地改善动作预测,而屏幕精修失败,因为它丢弃周围上下文且无法访问非视觉通道。消融和交互深度分析表明,所有组件对 episode 级 goal progress 的贡献最强;随着轨迹变长,FocusGUI 保持准确率而冻结 backbone 退化;学习到的通道优先级在 episode 中从交互状态转向音频和视频。容量研究进一步显示,该方法在较宽参数范围内保持稳定,无需按 backbone 调参。
在四个冻结全模态 backbone 上,FocusGUI 相比直接推理和先前屏幕精修 baseline,一致提升任务匹配、exact match 和 goal progress。提升覆盖定位、语义、跨模态、时序和即时任务类别,其中时序设置下改进最大,且随着交互深度增加,优势扩大。屏幕精修 baseline 在任务匹配上接近中性,但降低 exact match 和 goal progress,表明裁剪截图会丢弃准确定位所需的上下文。FocusGUI 在每个测试的 backbone 和任务类别上均取得最佳任务匹配和 exact match。屏幕精修 baseline 在任务匹配上接近中性,但一致地降低 exact match 和 goal progress,说明精修屏幕区域无法恢复缺失的跨模态或时序上下文。
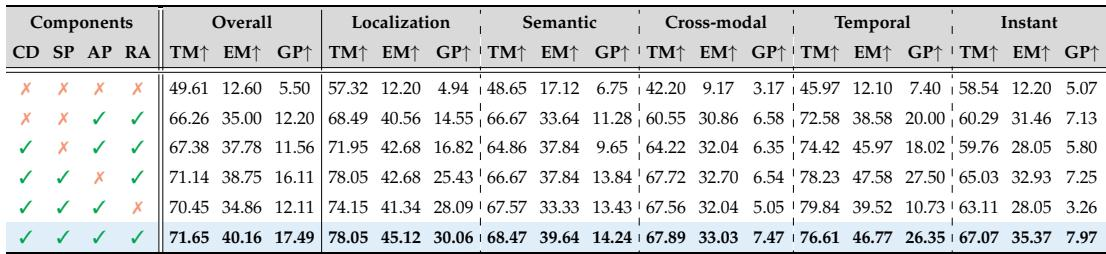
消融四个组件中的任意一个都会降低整体性能,且 episode 级 Goal Progress 的损失最大。这些组件对 Goal Progress 的影响比对单步 Type Match 的影响不成比例地更强,表明它们主要防止轨迹发散,而不仅仅是改善单个动作选择。通道分解与优先级联合提高稳定性,而残差对齐主要支持将所选动作落实为正确参数。每个被移除组件对 Goal Progress 的相对影响都大于对 Type Match 的影响,Goal Progress 损失最高约三分之一,而 Type Match 损失不到十分之一。没有步骤自适应优先级的通道分解相比单一集成通道会提升 Type Match 和 Exact Match,但需要优先级来将更丰富的通道访问转化为 episode 级稳定性。残差对齐对 Goal Progress 和 Exact Match 的影响远大于对 Type Match 的影响,表明其有助于将选定的动作原语落实到正确参数。
在宽范围扫描中,性能对边界窗口大小基本不敏感,exact match、goal progress 和时序 goal progress 仅出现小幅波动,无一致趋势。紧凑 focus 维数的影响更明显:将其降至 32 会大幅降低 exact match 和 goal progress,而默认设置保持稳定,并在扫描中取得最高 exact match。结果证明可以在各 backbone 间固定这两个容量参数,无需按 benchmark 调参。在十六倍范围内改变边界窗口仅使整体指标产生小幅变化,且没有单调趋势。使用 32 的紧凑 focus 维数而非默认值会急剧降低 exact match 和 goal progress,表明潜在表示受到容量限制。默认参数设置在报告的扫描中得到最高 exact match,并保持稳定的整体性能。
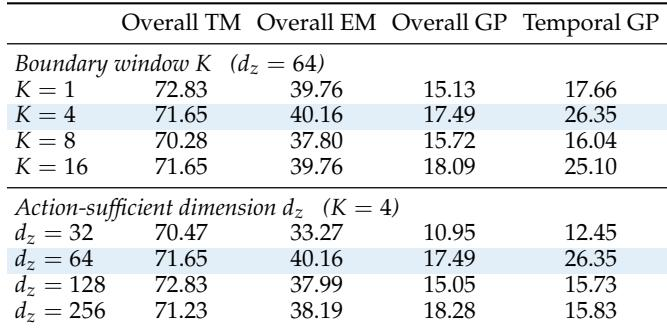
在四个冻结全模态 backbone 上,FocusGUI 在任务匹配、exact match 和 goal progress 上一致优于直接推理和屏幕精修 baseline,其中时序任务和更深交互中的提升最大,而屏幕精修丢弃上下文并损害精确定位。消融显示,四个组件主要贡献于 episode 级稳定性而非单步动作选择,其中通道分解加优先级改善轨迹连贯性,残差对齐支持参数落实。性能对边界窗口大小基本不敏感,而过小的 focus 维数会急剧限制容量并降低 exact match 和 goal progress,支持默认设置且无需按 benchmark 调参。