Command Palette
Search for a command to run...
从机群经验中学习:一种机器人集体学习范式
从机群经验中学习:一种机器人集体学习范式
摘要
部署过程中产生的经验使机器人有机会通过从自身执行中学习来提高策略可靠性。然而,通过人类纠正进行学习需要远程操作员监控执行过程并在策略失败时进行干预,这一需求随着机器人群体规模增长而难以满足。我们提出了集体经验学习(CEL),一种学习范式,其中已部署的机器人共享各自的执行经验,以改进共同策略。我们通过失败引导的经验检索微调(FERT)来实现 CEL,该方法利用机器人执行中的失败上下文,从群体共享的成功经验中检索相关轨迹片段,并将其动作作为策略更新的监督信号,而无需收集额外的专家演示或纠正动作。一个容错异步训练系统(FATS)在机器人群体内部出现局部中断的情况下,协调经验收集、策略优化和策略分发。在五个真实世界操作任务中,所得策略取得 93.3%–99.2% 的成功率,且每个任务均在未参与训练数据收集的机器人上评估了 120 次试验。在每台机器人的收集时间保持固定的条件下,更大规模的群体能提供更多经验,并且 FERT 在所评估的群体规模上通常取得更高的成功率。在多阶段手机包装任务中,使用 96 台机器人进行学习将成功率从 79.2% 提高到 98.3%。这些结果支持集体经验作为可扩展机器人学习的实用基础,并提供了一条在部署期间无需收集额外专家纠正动作即可提高策略可靠性的路径。
一句话总结
来自清华大学、AgiBot 和 Infinigence AI 的研究人员提出了集体经验学习(CEL),这一范式通过失败引导的经验检索微调(FERT)和容错异步训练系统(FATS)实现,使部署的机器人集群能够共享成功执行轨迹,而无需额外的专家纠正,在五个真实世界操作任务中达到 93.3%-99.2% 的成功率,并将 96 台机器人参与的多阶段手机包装任务成功率从 79.2% 提高到 98.3%。
核心贡献
- 提出集体经验学习(CEL),该范式让已部署机器人在专家监督初始化后共享执行经验以改进共同策略,而无需收集额外的专家演示或纠正动作。
- 提出失败引导的经验检索微调(FERT),利用失败上下文从共享集群经验中检索相关成功轨迹片段,并将其动作作为监督信号;同时提出容错异步训练系统(FATS),在机器人中断的情况下协调经验收集、策略优化和策略分发。
- 在五个真实世界操作任务上评估,所得策略在未参与训练数据收集的机器人上每个任务 120 次试验中达到 93.3%-99.2% 成功率;更大的机器人集群通常会提升性能,在 96 台机器人参与的多阶段手机包装任务中,成功率从 79.2% 提升到 98.3%。
引言
机器人基础模型可以将视觉和语言理解转化为物理动作,但当物体属性、接触条件或多阶段错误在不同部署环境中变化时,初始能力并不自动带来可靠执行。先前的集群学习方法通常需要在部署期间提供专家演示或纠正干预,随着机器人集群规模扩大,人类动作监督难以扩展。作者引入了集体经验学习(CEL),该范式让机器人汇集自身部署经验以改进共享策略,而无需持续的人类专家动作监督。他们通过失败引导的经验检索微调(FERT)和容错异步训练系统(FATS)实现 CEL,前者利用失败执行来检索相关成功轨迹以进行策略更新,后者协调整个集群中的分布式收集、推理和优化。
方法
作者引入了集体经验学习(CEL),该范式让机器人共享部署过程中产生的经验,以改进共同策略。该方法将经验收集与共享策略改进连接为一个闭环。如下图所示,从人类演示学习到专家纠正学习,再到从机器人集群内部产生的集体经验学习,对专家动作监督的需求逐步降低。
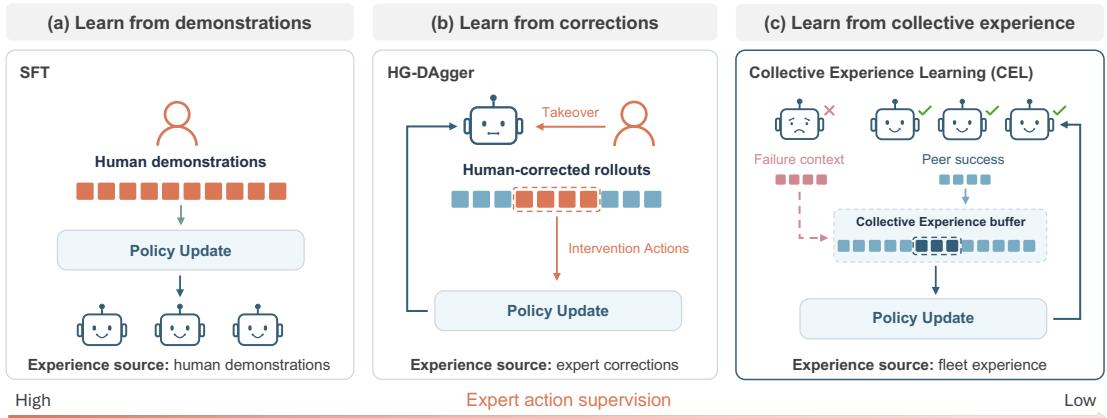
为实现 CEL,作者提出了失败引导的经验检索微调(FERT)。该算法利用部署期间产生的经验更新策略,而无需收集额外的专家演示或纠正动作。FERT 使用成功机器人轨迹作为动作目标,并使用失败上下文来优先选择相关的成功经验进行监督式策略更新。
下图展示了 FERT 过程的四个逻辑步骤。
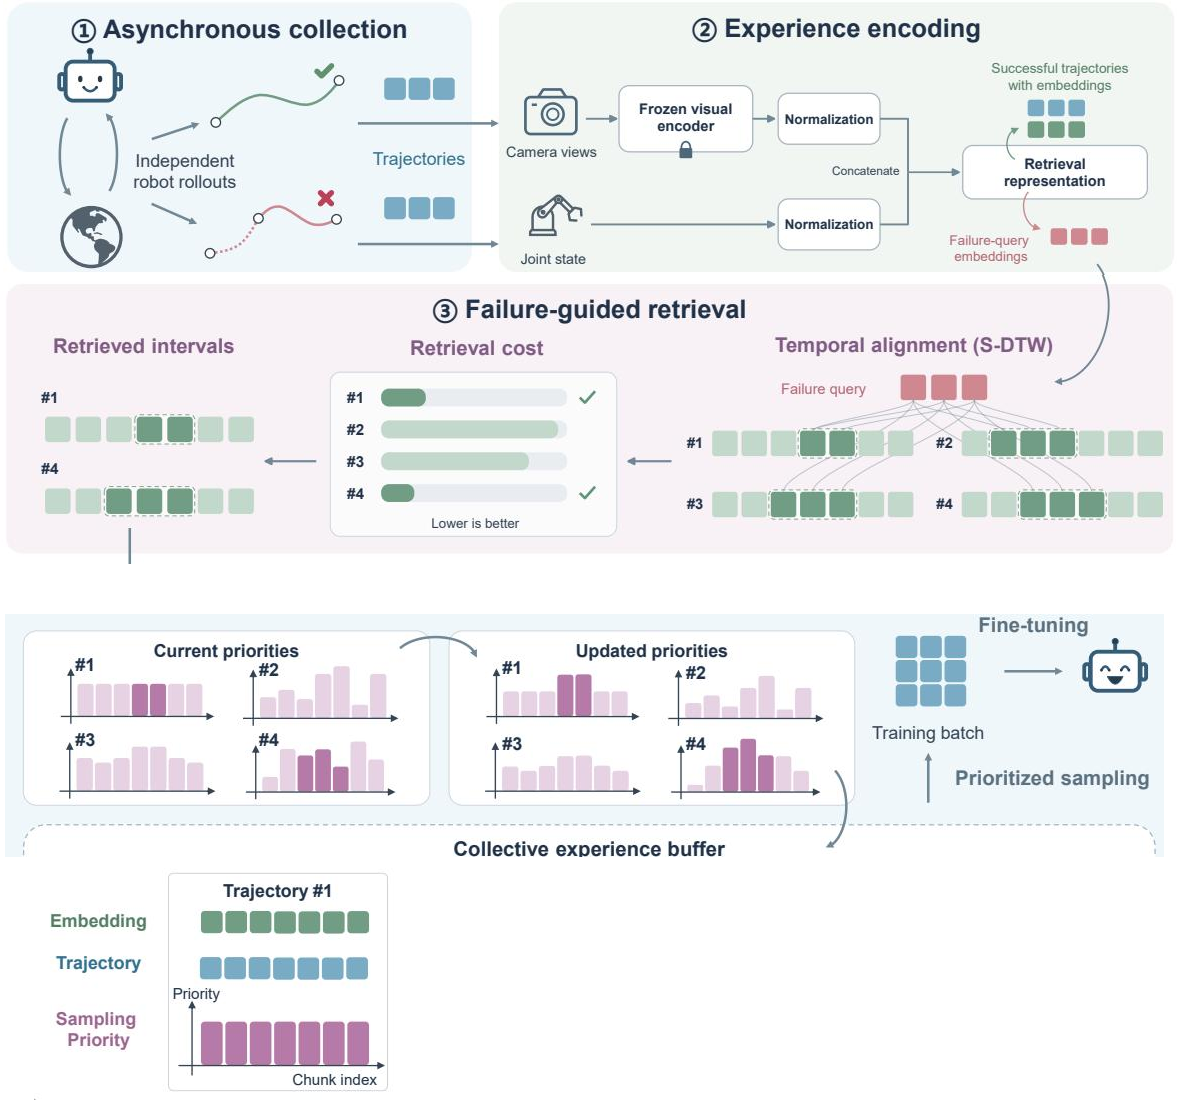
首先,系统进行异步经验收集。机器人自主执行,每个完成的轨迹都会得到二值任务结果。成功轨迹被保留在集体经验缓冲区中,以提供动作目标;失败轨迹则作为临时检索查询。这种分离使系统能够利用失败来引导学习,而不会模仿不成功的动作。
其次,经验编码会构建同时捕捉场景和机器人构型的表示。作者将视觉特征与本体感受状态相结合。冻结的视觉编码器处理相机视图以生成视觉 token,这些 token 经过池化并拼接。检索表示 zt 结合了归一化视觉特征 ht 和归一化关节状态 st:
zt=[max(∥ht∥2,ϵ)ht;max(∥st∥2,ϵ)st]第三,失败引导的检索会识别相关的成功片段。由于二值失败标签无法精确定位失败发生的起点,系统使用终点前的一段短观察序列作为检索查询。系统使用斜率约束的子序列动态时间规整从经验缓冲区中检索时间对齐的片段。距离矩阵评估失败查询嵌入与成功轨迹嵌入之间的逐帧距离。算法找到最小代价对齐,并选择代价最低的若干候选片段,将其扩展形成最终检索集合。
第四,优先化微调将检索到的区间转换为采样优先级。成功动作块 Ai 的优先级 wi 根据其与检索区间的重叠程度进行更新:
wi(n)=ρwi(n−1)+R∈Rn∑H∣idx(Ai)∩R∣动作块按与其优先级成比例的方式从缓冲区中采样:
P(i)=∑j∈D+wjwi策略使用负对数似然目标进行微调:
LFERT(θ;B)=−∣B∣1i∈B∑logπθ(Ai∣oi,gi)这会将学习引导到与策略当前困难相关的行为上。
为了在分布式资源上支持这一学习循环,作者设计了容错异步训练系统(FATS)。FATS 协调机器人执行、云端推理和策略优化。它将学习循环划分为操作机器人的环境工作进程、计算动作的推理工作进程和更新策略的训练工作进程。
系统架构由数据平面 SwarmLink 和控制平面 HotSwarm 组成。SwarmLink 通过分布式通道连接机器人执行与云端推理及训练。它汇聚推理请求,并流式传输轨迹字段以供云端组装,使交互流量优先于批量数据传输。HotSwarm 管理集群成员关系,检测故障并将故障机器人恢复到其位置。它实现分层恢复:环境工作进程在原位重启,推理工作进程重新加载当前策略,训练工作进程从检查点恢复。这种设计确保单个故障或暂停的机器人只会降低经验到达速率,而不会中断整个训练过程,从而实现集群中各部分解耦推进。
实验
实验在五个真实世界桌面操作任务上使用 AgiBot G2 机器人评估了 FERT 和 FATS,将其作为持续经验学习的具体实现,并使用留出的机器人实例衡量任务成功率。结果表明,带有二值任务结果的集群生成经验能够在无需额外专家演示或纠正动作的情况下提升策略可靠性,并优于单机器人在线强化学习、离线集群强化学习和人类遥操作基线。扩展性结果表明,随着更多机器人贡献经验,成功率通常会增加;消融实验确认了失败引导检索、适度策略同步、检索片段扩展和优先级保留的重要性。在 96 台机器人运行中的系统实验表明,FATS 在局部故障和通信延迟下仍能维持经验收集,局部恢复和解耦推进避免了同步轮次或完全重启带来的更大收集损失。
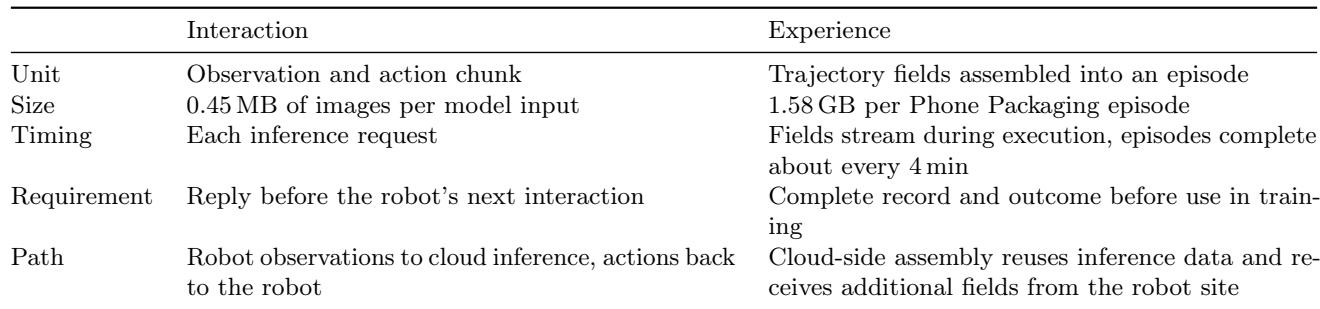
机器人交互与训练经验在大小、节奏和时序要求上差异显著。交互消息较小,且必须在机器人下一步之前返回;而经验片段要大得多,大约每隔几分钟完成,且不需要立即交付。这些差异促使推理服务与经验传输相互独立,并复用推理观测数据进行云端轨迹组装。交互消息频繁、较小且对延迟敏感,而经验片段大得多,可以异步流式传输用于训练。云端组装复用已为推理发送的观测数据,从而减少片段结束后仍需传输的数据量。
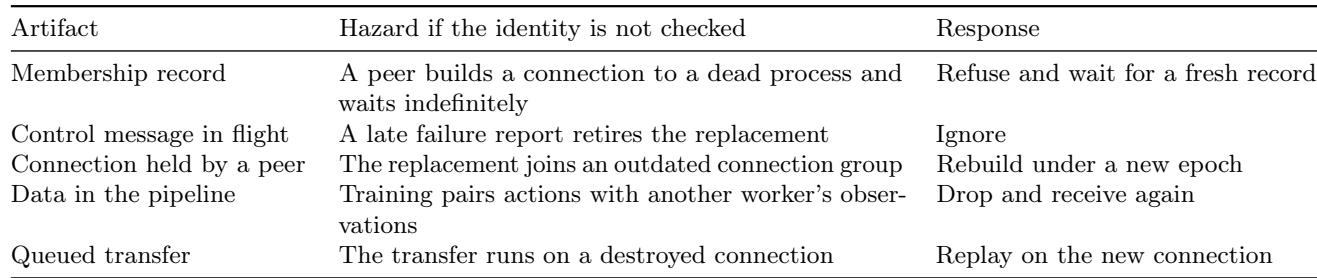
HotSwarm 通过检查工作进程身份并应用针对特定产物的响应,防止故障工作进程遗留的产物污染其替代进程。过期的成员记录会被拒绝,迟到的控制消息会被忽略,连接在新 epoch 下重建,流水线数据会被丢弃并重新接收,排队的传输会在新连接上重放。这些措施使替代进程与已死亡进程保持隔离,并保护训练数据和连接状态。过期成员记录和迟到控制消息通过拒绝和忽略处理,避免对等方等待已死亡进程,也避免迟到的故障报告使替代进程退役。流水线数据被丢弃并重新接收,排队的传输在新连接上重放,因此训练不会将动作与其他工作进程的观测混合,也不会在已销毁的连接上执行传输。
在五个操作任务中,FERT 将平均失败率从 19.0% 降至 2.67%,相当于 86.0% 的相对降低。最大的相对失败率降低出现在 Phone Charging 和 Phone Packaging 任务上,而 Flower Arrangement 的降低幅度最小。这些结果表明,相较于多机器人 HG-DAgger 起始检查点,可靠性得到提升。平均失败率从 19.0% 降至 2.67%,跨任务的相对降低为 86.0%。Phone Charging 和 Phone Packaging 的相对失败率降低最大,Flower Arrangement 的降低最小。
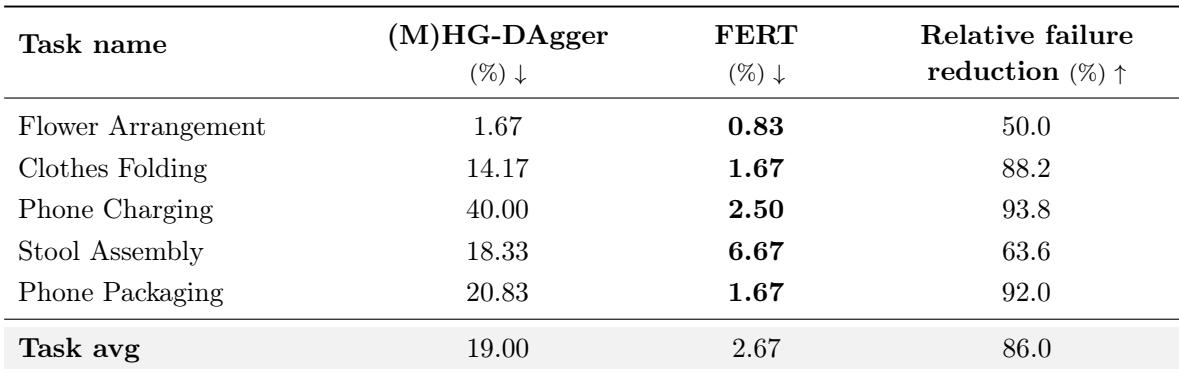
实验验证了拆分服务设计,其中较小且对延迟敏感的交互消息与较大的异步经验片段分开处理,云端轨迹组装复用推理观测数据以减少剩余传输开销。实验还测试了故障恢复,结果表明 HotSwarm 会拒绝过期成员关系和迟到控制消息,丢弃并重新接收流水线数据,并在新连接上重放排队的传输,使替代进程不会继承遗留产物。在五个操作任务中,FERT 将平均失败率从 19.0% 降至 2.67%,相对降低 86.0%,其中 Phone Charging 和 Phone Packaging 改进最大,Flower Arrangement 改进最小。