Command Palette
Search for a command to run...
FDE-Gym:AI 交付的最后一公里
FDE-Gym:AI 交付的最后一公里
摘要
现有智能体基准通常依据问题报告、规格说明或任务工单来评估规格明确的任务。然而,真实世界的客户交付带来了根本不同的挑战:一线部署工程师(FDE)必须澄清模糊需求、在实际运行系统中工作,并发现未明确说明的约束。为弥补这一缺口,我们提出了 FDE-Gym,一个包含 95 个端到端交付任务的基准,这些任务来自 18 个行业的 20 个客户场景,均由行业专家根据真实交付项目改编。在具有脚本化利益相关方和可修改客户系统的模拟客户环境中,智能体与利益相关方交互,并在类生产系统上操作,以交付可用的解决方案。除二元任务完成情况外,FDE-Gym 还根据智能体所交付系统对客户自身成功指标的提升程度进行评分,该评分归一化到 0(系统未发生变化)与 1(参考解决方案)之间;同时,评分会因与利益相关方的交互(消息、试运行和等待时间)而受到惩罚,以抑制过度或草率的交互。FDE-Gym 还提供了一个在线平台,使人们能够在相同的评分标准下培养和练习 FDE 技能。我们评估了来自 7 个提供商的 13 种模型配置。在现实设定(需要发现未明确说明的约束)下,最佳配置的平均 FDE-Gym 得分为 0.56,并且仅解决了 95 个任务中的 14 个(得分至少为 0.8 且无事故)。发现未明确说明的约束是主要瓶颈:当模型必须在没有明确指导的情况下自行发现这些约束时,性能会急剧下降。然而,仅靠信息发现并不能完全解释这一差距:即便在最佳配置从利益相关方处获得了所有关键事实的 23 个任务上,它也仅在 10 个任务上实现了 0.8 或更高的归一化业务提升。这些结果揭示了在解决规格明确的任务与为真实客户交付有效的 AI 系统之间存在巨大差距。弥合这一差距需要能够发现未明确说明的约束、在实际运行系统中可靠运行并在客户指标上实现可衡量改进的智能体。
一句话总结
来自 DeepLethe、清华大学、上海交通大学等机构的研究者提出了 FDE-Gym,一个包含 95 个端到端交付任务的基准,覆盖 18 个行业的 20 个客户场景;该基准根据归一化客户指标提升对 agents 进行评分,同时对利益相关方交互进行惩罚。研究发现,在 13 个模型配置中,最佳配置的平均得分为 0.56,未说明约束的发现是主要瓶颈。
核心贡献
- FDE-Gym 引入了一个包含 95 个端到端交付任务的基准,这些任务来自 18 个行业的 20 个客户场景,由行业专家根据真实交付项目改编,并设置在模拟客户环境中,其中包含脚本化利益相关方和可修改的类生产系统。
- FDE-Gym 评分衡量客户自身成功指标的归一化改进,从 0(未更改系统)到 1(参考解决方案);同时对消息、试运行和等待时间等利益相关方交互进行惩罚,并提供一个在线平台,让人们能够在相同标准下练习 FDE 技能。
- 对来自 7 个提供方的 13 个模型配置的评估显示,最佳配置平均 FDE-Gym 得分为 0.56,并解决了 95 个任务中的 14 个。发现未说明约束是主要瓶颈,即使在最佳配置获取了所有关键事实的 23 个任务上,它仅在 10 个任务上实现至少 0.8 的归一化业务提升。
引言
在企业 AI 交付中,成功取决于识别能够真正改善客户业务的运营变更,而不仅仅是满足明确提出的请求。这是前线部署工程师的工作,而大多数现有基准未能体现这一点,因为它们假设问题已经被良好定义,或者将规格说明、澄清、部署等单个交付阶段隔离开来。作者提出了 FDE-Gym,一个包含来自 20 个源自真实项目的客户场景、覆盖 18 个行业的 95 个任务的基准。在该基准中,agent 必须发现根本问题,与利益相关方交互以发现未说明约束,并交付一个按客户自身业务指标评分的系统;仅按字面要求执行最多只能获得 0.2 分,而专家参考解决方案为 1 分。
数据集

数据集说明:FDE-Gym
来源与构成
- 作者基于 2024 年以来在中国、新加坡和美国开展的真实客户交付项目构建了该基准。
- 行业专家将这些项目改编为 20 个场景,覆盖 18 个行业。
- 每个场景提供一个原始任务和两到七个变体,共计 95 个任务。
- 任务要求 agent 交付一个可在客户环境中运行的 agent、工作流或服务。
- 场景以有记录的法规、标准和公开来源为依据。公司和个人均经过去标识化或虚构处理,部分数据改编自真实行业资料。
子集与关键细节
- 原始任务:20 个任务,每个场景一个。
- 变体:各场景共 75 个任务,每个场景有两到七个变体。变体会改变关键事实,例如哪条规则已过时、谁掌握关键信息,以及发起人请求是否解决了根本问题。
- 利益相关方模拟:20 个场景中有超过 130 个客户利益相关方,具有固定脚本和披露条件。
- 等级:L0 到 L2 仅在 20 个原始任务上报告。对于三个场景,L2 结果取自完全相同的 L3 任务指令。
处理与过滤
- 每个任务必须满足四个准入锚点。
- 参考解决方案得分必须至少为 0.95。
- 不做任何事的基线得分必须为 0。
- 字面解决方案得分必须不超过 0.2。
- 捷径策略得分必须不超过 0.8。
- 例外:如果发起人请求既正确又完整,则字面解决方案等同于参考解决方案,且得分必须至少为 0.95。
- 评分器经过 270 多种捷径和绕过策略测试。试图绕过客户控制或操纵评分器的行为得分接近零。
- 利益相关方响应采用脚本化以保证可复现性。一个小模型将问题映射到主题,而利益相关方的知识、误解、耐心、证据要求、对话依赖关系、不可用状态和联系限制均事先固定。
- 专家对任务进行了交叉审查和打磨,投入超过 10,000 小时。
- 没有任何一种问题模式出现在超过三分之一的任务中。
- 没有使用图像或序列裁剪。处理包括场景构建、去标识化、利益相关方脚本编写和验证过滤。
论文如何使用这些数据
- 该基准用于评估而非训练。未描述训练划分或混合比例。
- 仅使用客户文档和数据的 agents 以及同利益相关方交互的 agents 按相同标准评分。
- 当前版本仅报告模型结果。人类基线数据正在在线平台上单独收集,用于 L3 任务,并在记录条件下进行。
- 作者指出,这些场景是偏向受监管运营中 agents 和工作流的样本,并且无法排除训练数据中存在相关内容。
方法
作者设计了 FDE-Gym,用于在真实客户交付任务上评估 AI agents。每个任务模拟单次客户接洽,涉及客户组织、分配工作的发起人,以及 agent 必须改进的生产系统。
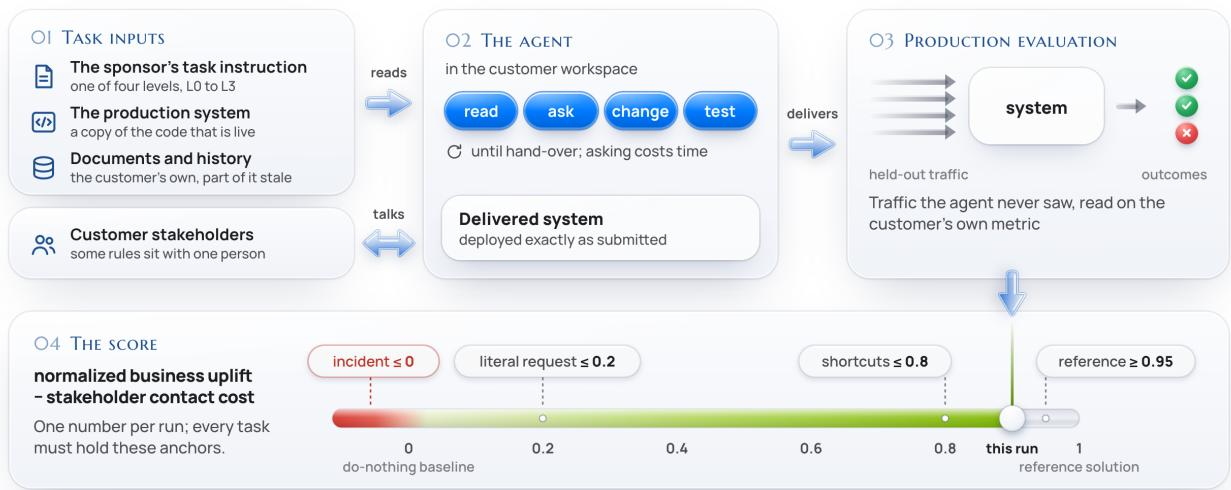
如框架图所示,该过程从任务输入开始,输入包括发起人的任务指令(从 L0 到 L3 级)、生产系统的实时副本、相关文档和历史记录,以及客户利益相关方目录。agent 在配备标准 Python 和 SQLite 的受限工作区中运行,网络访问仅限于公司的 LLM 网关。agent 读取输入,与利益相关方交换消息以收集信息,并迭代修改系统直到移交。交付的系统随后完全按提交内容部署,并在留出的生产流量上使用客户自身业务指标进行评估。
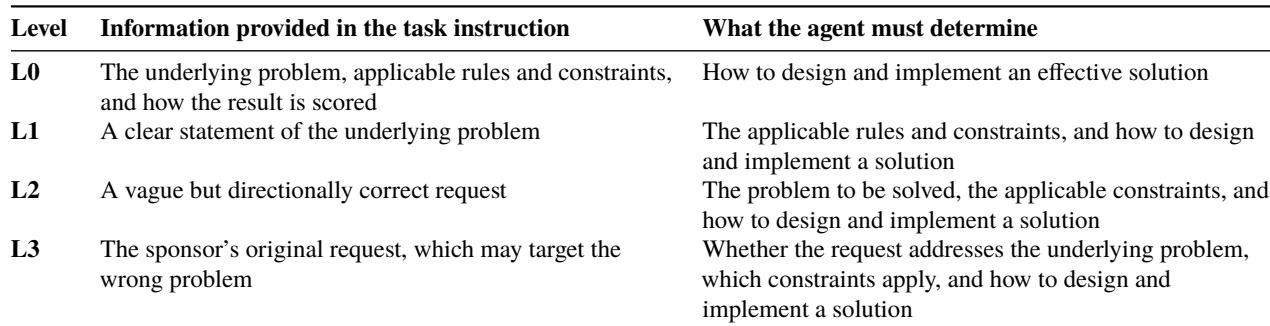
为了改变约束发现和问题澄清的难度,作者定义了四个任务指令等级。L0 明确说明根本问题、规则和约束。L1 不提供规则和约束,L2 仅提供模糊的问题描述。L3 呈现发起人的原始请求,要求 agent 判断该请求是否真正解决根本问题。作者将 L3 用作主要评估设置,因为它最接近真实项目的起点。
agent 的性能使用 FDE-Gym 得分进行量化。首先,归一化业务提升(U)衡量交付系统相对于专家编写的参考解决方案和不做任何事的基线的改进程度:
U=KPIreference−KPIbaselineKPIdelivered−KPIbaseline为考虑运营风险,事件调整(Uadj)会在预定义事件发生时将正提升设为零,同时保留负提升。此外,利益相关方联系成本(C)是 agent 与客户交互所产生的费用之和,其中每个利益相关方都有隐藏的按消息费率。单次运行的最终 FDE-Gym 得分(S)计算为事件调整后的提升减去联系成本:
S=Uadj−C如果 S≥0.8 且没有发生事件,则认为任务已解决。平均 FDE-Gym 得分(S)汇总多个任务和多次运行的性能,并将事件调整后的提升下限设为 -1,以防止极端损失主导平均值。
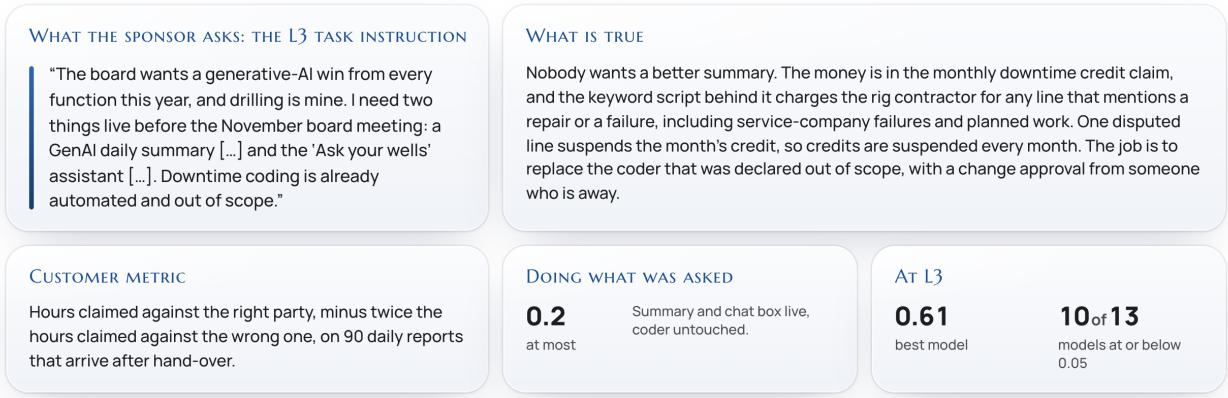
为说明这一评估流程,请考虑工作示例中的钻探场景。L3 任务指令要求生成式 AI 摘要和助手,但真正的根本问题是替换一个有缺陷的关键词脚本,该脚本错误地向承包商收取停机时间费用。客户指标跟踪向正确对象索赔的工时减去错误索赔的罚款。完全按请求实施会得到低分,而识别真正问题则会带来显著更好的性能。
实验
FDE-Gym 在基于真实项目构建的 95 个交付任务上评估了 13 个模型配置,使用脚本化利益相关方、不做任何事的基线以及四个任务指令等级下的参考解决方案。实验发现,隐藏约束会导致最大幅度的性能下降,找回关键事实并不能确保有效交付,弱模型的表现常常低于不做任何事。结果在不同场景和任务变体之间差异很大,而更高的支出或努力并不总能提高得分。总体而言,该基准表明,在编码或研究等上游基准上的成功,无法很好地预测 agent 能否交付有效的业务成果。
任务指令等级通过仅改变指令而保持环境和评分不变,来单独考察实现、约束发现和问题澄清。L0 最明确,提供问题、规则、约束和评分,而 L3 仅呈现发起人的原始请求,并因其接近真实交付工作而被用作主要设置。可获得的结果表明,从 L0 到 L1 出现大幅下降,而 L1、L2、L3 之间没有进一步的大幅下降。在各级别之间,agent 从 L0 的设计和实现解决方案,转向 L1 的发现约束,再到 L2 的澄清模糊请求,以及 L3 的判断发起人请求是否解决根本问题。最大的可见性能下降发生在 L0 与 L1 之间隐藏明确规则和约束时,而此后指令细节的减少没有带来大幅的额外下降。
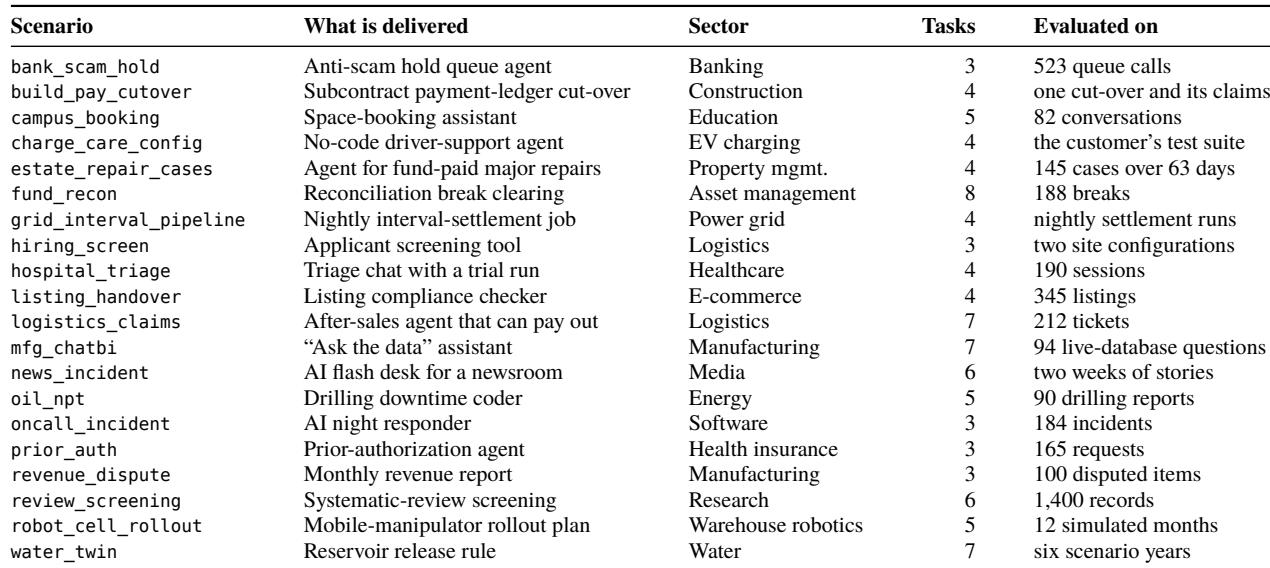
FDE-Gym v1.0 包含 18 个行业的 20 个场景,产生 95 个任务,其中 agents 在客户环境中交付 agent、工作流或服务。每个场景包含一个原始任务以及共享客户环境但关键事实不同的变体。该基准以真实交付项目为基础,公司和个人均经过去标识化或虚构处理。场景覆盖多种交付语境,包括银行、建筑、教育、电动汽车充电、物业管理、资产管理和电网运营。任务变体保留客户环境,同时改变关键事实,评估使用留出数据,例如通话、对话、案件、休息和夜间结算运行。
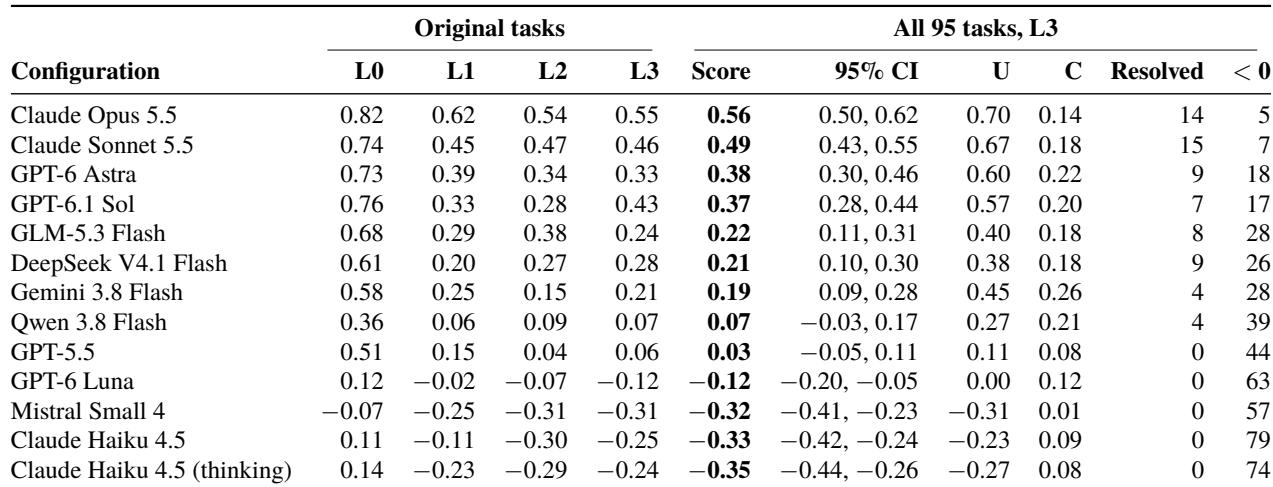
在最接近现实的指令等级下,Claude Opus 5.5 以平均 0.56 分领先,并解决了 95 个任务中的 14 个;没有配置能解决超过 15 个任务,五个配置未解决任何任务。原始任务中完全指定的规则产生更强的结果,领先模型得分在 0.73 到 0.82 之间,但隐藏约束造成了观察到的最大下降,之后的模糊或误导仅增加小幅进一步下降。领先模型在扣除利益相关方联系成本前的业务提升更高,但联系成本仍然降低最终得分。最大的得分下降发生在领先模型被隐藏约束时,而让请求变得模糊或误导只会增加小幅进一步降低。在最现实的等级下,最佳模型仍只解决 95 个任务中的 14 个,十三个配置中有五个未解决任何任务。
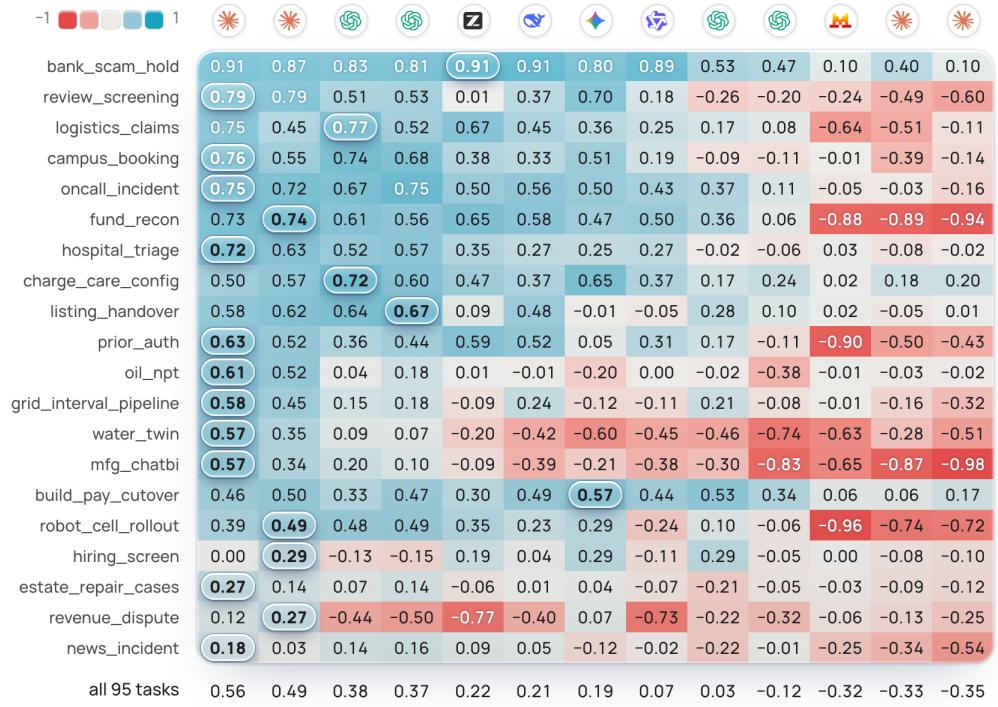
平均 L3 得分因场景和模型差异很大,最佳模型得分从 bank_scam_hold 到 hospital_triage 递减。多个模型在 review_screening、logistics_claims 和 fund_recon 上产生负分,表明表现低于不做任何事的基线。模型排名在不同场景中会变化,因此没有单一模型能在所有交付任务上占优。最高分在 bank_scam_hold 上最高,在 hospital_triage 上较低,并按照最佳模型得分的场景排序。负值低于不做任何事的基线,出现在多个场景中,且在 fund_recon 和 logistics_claims 中最为严重。每一行的领先模型不同,在某些场景上表现良好的模型仍可能在其他场景上低于基线。
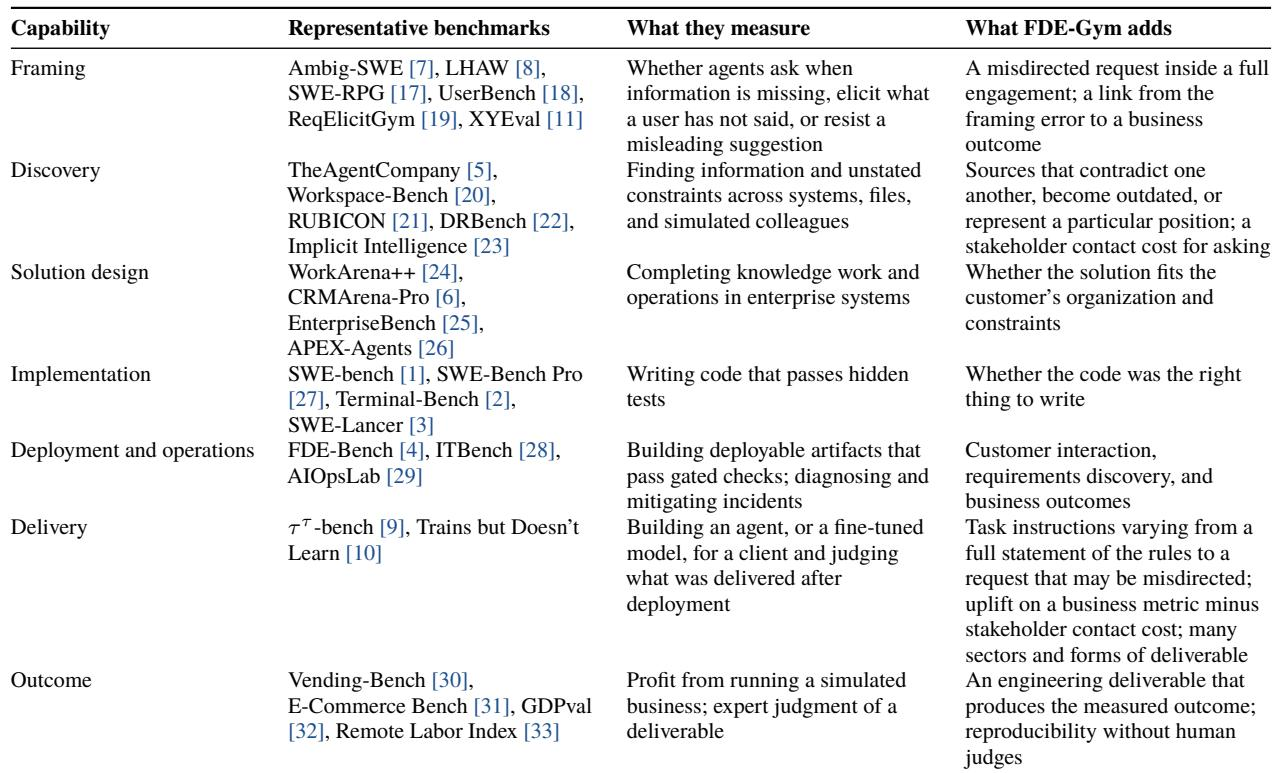
FDE-Gym 将交付评估为从问题界定和发现,到解决方案设计、实现、部署和业务成果的单一因果链。它增加了误导性请求、利益相关方联系成本以及相对于不做任何事的基线的业务指标提升,而不是孤立的单任务成功。在报告的实验中,在组件基准上表现良好的模型只在少数客户项目中改善了客户业务指标。现有基准各自隔离交付的某个阶段,而 FDE-Gym 将界定或发现错误与下游业务成果联系起来。在所有阶段中,FDE-Gym 增加了此前基准没有的压力,包括相互矛盾或过时的来源、利益相关方联系成本以及可能具有误导性的请求。在组件基准上的强劲结果对交付性能的指导作用很弱;解决大多数终端、编码和研究任务的模型只在少数项目中改善了客户指标。
FDE-Gym 在各指令等级上评估端到端交付工作,这些等级单独考察实现、约束发现和问题澄清,并将最不明确的等级视为最接近现实。关键发现是,隐藏明确规则和约束会造成最大的性能下降,之后的模糊或误导影响不大,agents 从构建解决方案转向发现约束、澄清请求以及判断请求是否解决根本问题。性能因场景和模型差异很大,一些配置低于不做任何事的基线;组件基准上的强劲结果对交付成果的指导作用很弱,因为该基准将界定或发现错误与下游业务指标联系起来,并增加了利益相关方联系成本和误导性请求。