Command Palette
Search for a command to run...
MJev-Spatial:基于原生注意力匹配的系统一空间智能
MJev-Spatial:基于原生注意力匹配的系统一空间智能
摘要
空间智能使智能体能够在物理世界中进行感知与行动,其中许多判断必须以交互速率完成:例如哪个空间关系成立、物体距离多远或应将其放置在何处。视觉语言模型(VLM)通过自由形式文本生成来给出这些答案,即便输出空间十分紧凑(若干选项之一、一个标量或一个二维点),仍需付出自回归解码和答案解析的代价。有鉴于此,我们提出了 MJev-Spatial,一个系统 1 多模态决策模型,在统一分类框架下处理全部三类空间理解任务。具体而言,MJev-Spatial 将每个候选项视为一个类别,并利用骨干网络预训练的 query 和 key 投影对其进行评分,而不增加任何参数。对于选择题任务,候选项为给定选项;对于数值预测和点预测,候选项分别为通过由粗到细分类逐步细化的数值区间和图像区域。推理时,每个分类决策只需一次前向传播,不生成任何答案 token。为高效训练异构空间数据,我们在一次前向传播中通过教师强制(teacher forcing)联合监督所有由粗到细的阶段,并将其与长度感知的全局批处理和跨 GPU 负载均衡相结合,训练吞吐量相比原始批处理策略提高了 30.8%。MJev-Spatial 基于 Qwen3.5-4B 构建,并在由现有空间数据集转换得到的 12.3M 个问答对上训练,在八个受测模型中取得最高总分(65.64%),在十二个基准中的七个上排名第一,并在全部十二个基准上优于未修改的自回归基础模型,同时比最快的自回归基线快 2.5 倍,比基础模型快 5.6 倍。
一句话总结
作者提出 MJev-Spatial,一种 System 1 多模态决策模型,通过使用预训练 query 和 key 投影对候选项进行评分,在单次前向传播中统一空间选择、数值和点任务,且不增加参数;该模型基于 Qwen3.5-4B 和 12.3M 问答对构建,总体得分为 65.64%,在十二个基准中的七个上排名第一,运行速度比最快的自回归基线快 2.5 倍。
核心贡献
- MJev-Spatial 被提出为一种 System 1 多模态决策模型,将选项选择、数值预测和空间点预测统一为候选分类,利用骨干网络预训练 query 和 key 投影,不增加参数,每次决策只需一次前向传播,且不生成 answer tokens。
- 该模型对数值和图像区域采用由粗到细的分类,通过层级细化提升精度,并通过树展开支持多点预测;联合阶段监督配合 teacher forcing 在单次前向传播中训练所有阶段,同时长度感知的全局分批和跨 GPU 负载均衡将训练吞吐量提升 30.8%。
- MJev-Spatial 基于 Qwen3.5-4B 构建,并在由现有空间数据集转换而来的 12.3M 问答对上训练,在八个受测模型中取得最高总体得分 65.64%,在十二个基准中的七个上排名第一,在全部十二个基准上优于未修改的自回归基座模型,运行速度比最快的自回归基线快 2.5 倍,比基座模型快 5.6 倍。
引言
空间智能要求 agent 在通常具有实时约束的情况下回答视觉问题,包括选择空间关系、估计数值量或识别图像中的点。现有大多数视觉语言模型通过自回归文本生成处理这些任务,这将空间预测绑定到 token 格式化和样板文本上,增加不必要的监督,并带来顺序解码和解析开销。作者提出 MJev-Spatial,一种 System 1 风格多模态决策模型,将这三类输出统一为对有限候选集进行分类。它利用骨干网络预训练 attention query 和 key 投影对候选项进行评分,在无需额外预测头的情况下对数值和点精度进行层级细化,并在 12.3 百万个空间 QA 示例上训练。在十二个空间基准上,MJev-Spatial 在八个受测模型中取得最高平均分,并相较其自回归基座模型获得显著推理加速。
方法
作者采用统一的分类框架处理多种空间任务,包括选择题、数值估计和点定位。给定有序图像 I 和空间问题 q,模型通过从确定性任务控制器在每个阶段 t 构建的候选集 Ct 中选择答案。共享评分器为每个候选项分配 logit zt,i,预测选择得分最高的类别:
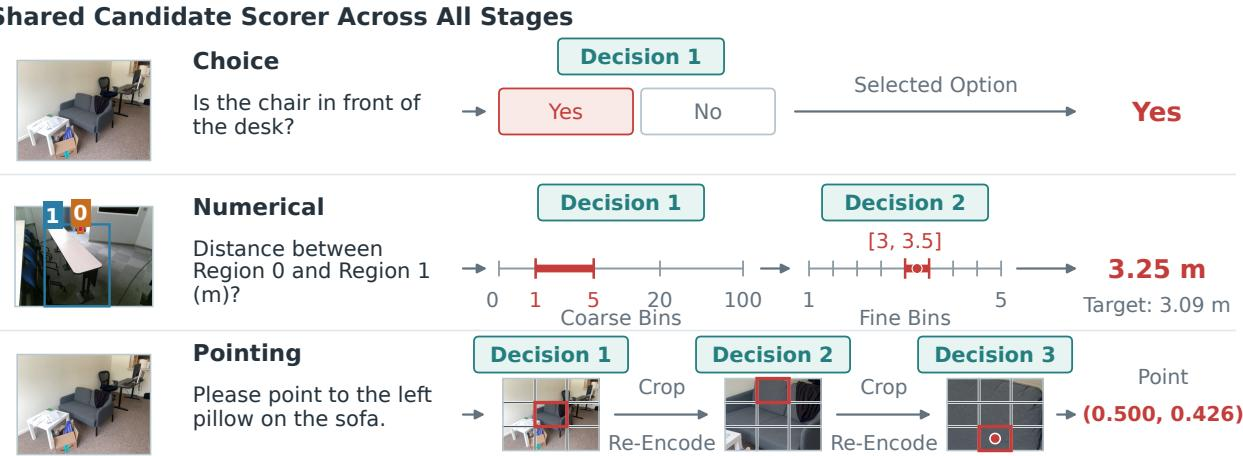
pθ(i∣I,q,h<t,Ct)=∑j=1Ktexpzt,jexpzt,i,a^t=argimaxpθ(i∣I,q,h<t,Ct)只有合法候选项进入 softmax,填充槽位被赋予负无穷。选择任务在单次决策后结束。数值和点任务使用由粗到细的细化过程。对于数值预测,第一阶段选择粗区间,第二阶段在其中选择细单元,并解码为单元中点。点预测需要精细分辨率和局部视觉细节,因此使用三次 3×3 区域选择,在阶段之间对原始图像裁剪重新编码,以避免累积重采样误差。
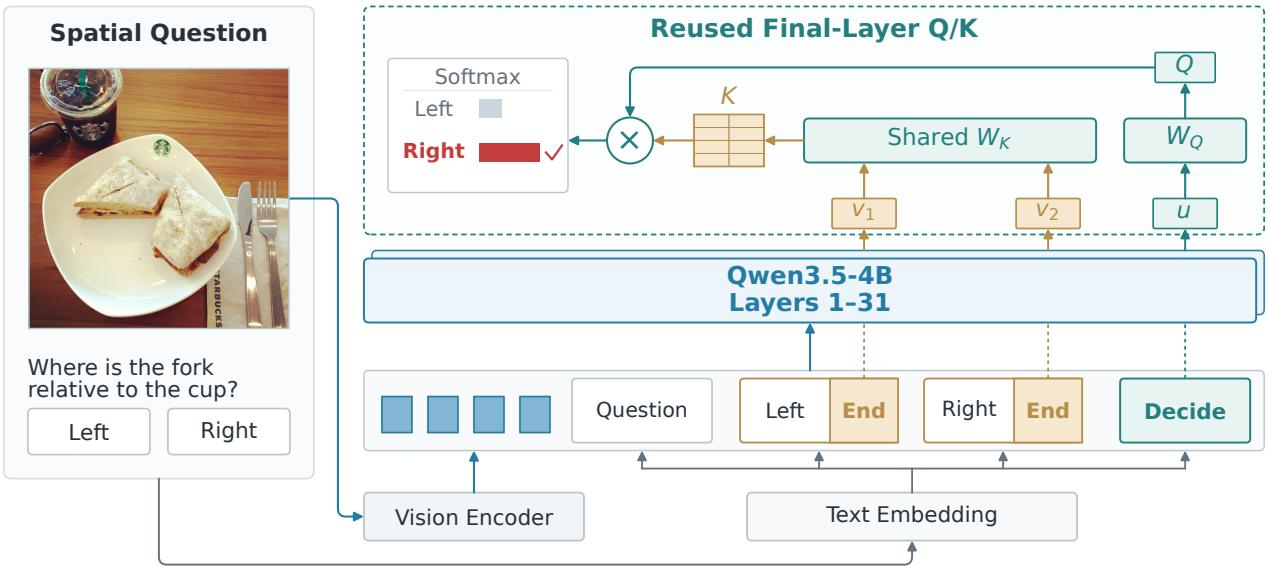
为落实该框架,作者采用预训练视觉语言模型,具体为 Qwen3.5-4B。每个候选项以文本表示,并与视觉 tokens、问题和先前的细化历史一起被编码到因果序列中。候选描述以选项结束标记结尾,完整列表以决策标记结尾。这些标记处的隐藏状态表示候选项和整体决策上下文。为防止最终 MLP 以牺牲语义匹配为代价将表示偏向词汇预测,作者使用最终全注意力层的预训练 query 和 key 投影计算候选得分。决策表示提供 query Q,每个候选表示提供 key K。候选项 i 的得分是跨 query 头的平均缩放内积:
zt,i=H1h=0∑H−1dQt,h⊤Kt,i,g(h)该设计复用预训练特征和匹配投影,为分类器提供强初始化,无需额外的预测头或新嵌入。
在训练过程中,作者将现有空间标注转换为 12.3 百万个训练问答对,涵盖多项选择、点定位、长度估计、角度估计和计数任务。他们采用联合阶段监督,每个受监督决策在其当前候选集上使用分类交叉熵。对于具有 Sq 个阶段的问题 q,损失计算为:
L=Nactual1q∑Sq1t=1∑Sq−logpθ(aq,t∗∣Iq,q,hq,<t∗,Cq,t)这一公式允许所有阶段损失在单次语言骨干网络前向传播中完成评估,较早决策无法关注较晚的选择或裁剪。为高效处理不同序列长度和计算成本,作者按长度对扩展序列排序,以形成相似长度的微批。随后采用最长工作优先分配将这些微批分配到各 GPU,同时考虑填充序列长度和视觉 token 工作量以平衡负载。作者对语言骨干网络使用 AdamW 进行全参数微调,同时保持视觉编码器和融合模块冻结。
实验
评估将 MJev-Spatial 与七个自回归 VLM 在空间预测质量和推理延迟上进行比较,并通过受控消融验证候选评分、数值离散化、视觉细化、多点解码和训练调度。主要结果表明,MJev-Spatial 实现最佳准确率-延迟权衡,在十二个基准中的七个上排名第一,同时显著降低查询延迟。消融表明,复用预训练原生 Q/K 评分已足够,裁剪重编码对精确定位至关重要,较粗数值码本配合 argmax 解码有效,层级解码支持带剪枝的多点预测,全局长度分组与跨 GPU 均衡通过减少填充提升训练吞吐量。
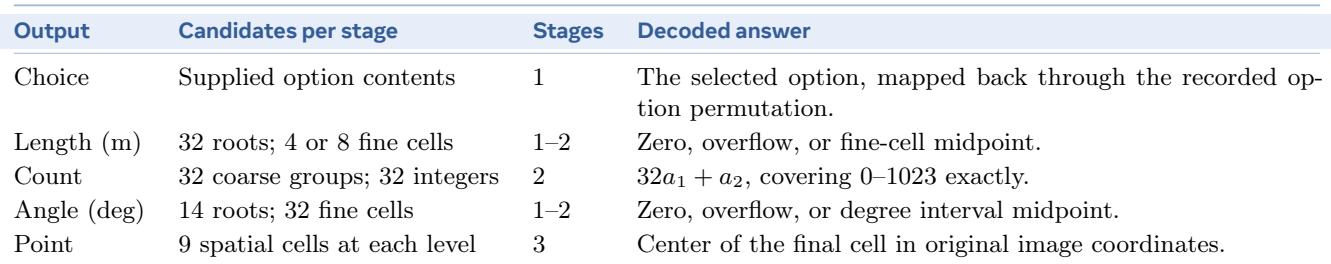
该框架将选择、数值和点问题视为共享评分器的候选分类问题。数值输出共享标量接口,但使用独立码本,长度和角度遵循由粗到细阶段,计数使用两阶段整数编码。点预测使用三层空间层级,概率树将相同点分类扩展到多点计数。选择题在提供选项上单阶段作答,并通过记录的选项排列进行解码。长度和角度使用一个或两个阶段,具有粗根和细单元,允许在细化解码前出现零或溢出结果。计数预测使用两个阶段将粗分组和整数组合为支持范围内的精确计数。点预测经过三级空间单元并解码到最终单元的中心。概率树调整点层级,以在计数评估中恢复多个目标。
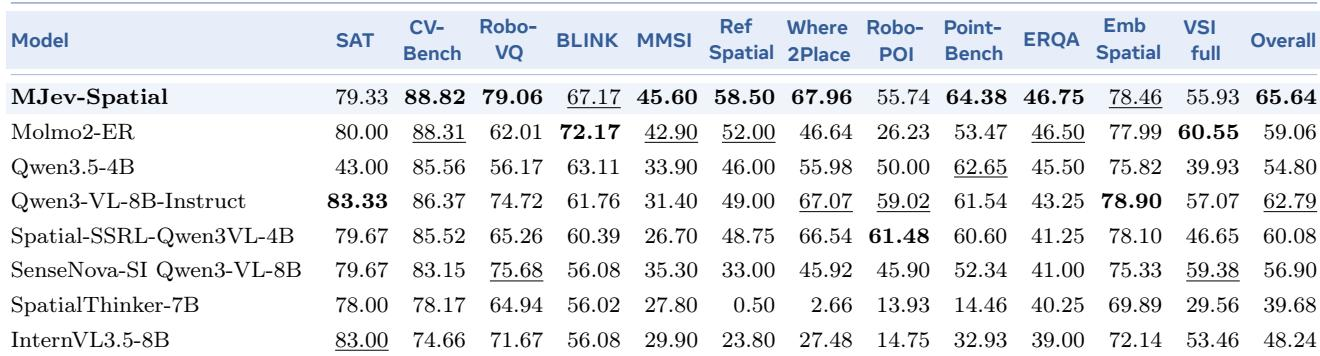
MJev-Spatial 在十二个空间理解基准上取得最高总体准确率,领先次优自回归 VLM,并在十二个任务中的七个上排名第一。其最强结果涵盖视觉问答和点定位,而 BLINK 和 VSI full 等部分基准由其他模型领先。该模型还在每个基准上优于其自回归基座模型。MJev-Spatial 在所有比较模型中取得最高总分,在七个基准上排名第一,包括 CV-Bench、Robo-VQ、MMSI、RefSpatial、Where2Place、Point-Bench 和 ERQA。Qwen3-VL-8B-Instruct 是整体上最接近的竞争者,而 Molmo2-ER 在 BLINK 和 VSI full 等选定任务上领先。相较其自回归基座模型,MJev-Spatial 在全部十二个基准上均有提升,其中在机器人空间 VQA 和指称空间理解上报告增益最大。MJev-Spatial 还在比较模型中实现最低平均查询延迟,相较自回归基线有显著加速。
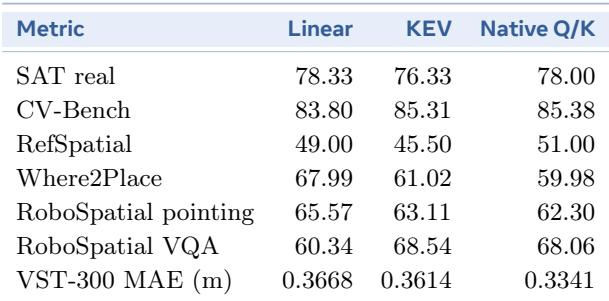
候选评分变体的比较显示,没有单一方法在所有空间任务上占优。原生 Q/K 评分在 RefSpatial 上取得最高准确率,在 VST-300 MAE 上取得最低误差,而线性分类器在 Where2Place 和 RoboSpatial pointing 上表现更好。原生 Q/K 受到青睐,因为它复用预训练投影且不增加新的可训练参数。原生 Q/K 评分在比较变体中获得最佳 RefSpatial 准确率和最低 VST-300 MAE。线性分类器评分在 Where2Place 和 RoboSpatial pointing 上优于原生 Q/K,表明存在任务相关的优势。原生 Q/K 复用现有预训练投影,避免新增预测头和额外可训练参数。
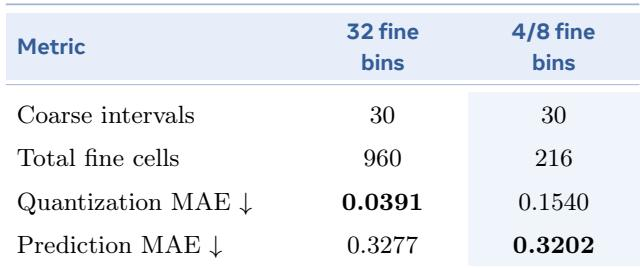
该消融比较数值预测中更细和更粗的细阶段分箱。更粗设置使用远更少的细单元,显著恶化量化误差,但下游预测误差略有改善。这表明最终预测器能很好地容忍较粗量化。更粗的细阶段配置保持相同粗区间,但大幅减少总细单元。较粗分箱下量化 MAE 显著更高,而预测 MAE 略低。
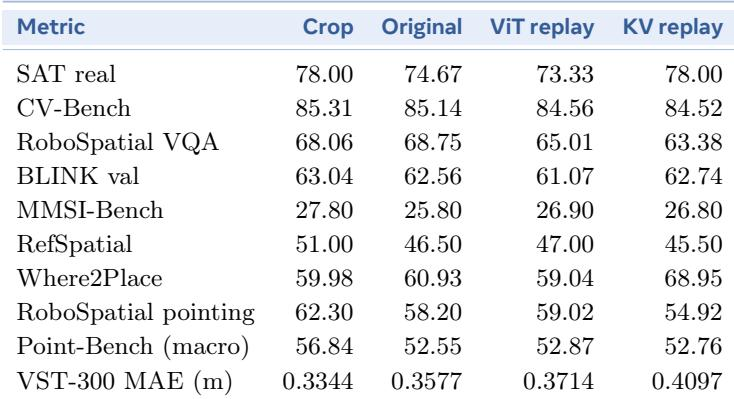
使用替代视觉输入进行匹配训练表明,裁剪重编码是整体最强策略,在 RefSpatial、CV-Bench、BLINK val 和 MMSI-Bench 上取得最佳得分,并在 SAT real 准确率上并列最佳。原始图像上下文和 replay 变体具有任务特定优势,但在空间精度上未能一致达到裁剪重编码的水平。结果支持在点预测中保留裁剪重编码以获取局部视觉证据。裁剪重编码在报告的七项指标中的五项上领先或并列,包括最高 RefSpatial 准确率。原始图像上下文在 RoboSpatial VQA 上表现最佳,而 KV replay 在 Where2Place 上表现最佳。ViT replay 和 KV replay 未能恢复裁剪级 RefSpatial 性能,且 KV replay 在视觉输入中的 RoboSpatial VQA 准确率最低。
该框架将选择、数值和点问题统一为共享评分器下的候选分类,使用层级码本处理长度、角度、计数和点定位,并使用概率树进行多点计数。在十二个空间基准上,MJev-Spatial 在整体和七个任务上排名第一,优于其自回归基座,并实现最低平均查询延迟。消融显示,原生 Q/K 评分因其复用预训练投影而受到青睐,更粗的细阶段分箱会提高量化误差,但最终预测器可以容忍。对于局部空间精度,裁剪重编码是最强的视觉输入策略,优于原始图像上下文和 replay 变体。