Command Palette
Search for a command to run...
OpenGCUA:迈向通用计算机使用的完全开放技术栈
OpenGCUA:迈向通用计算机使用的完全开放技术栈
摘要
计算机使用已达到一个转折点:关注点正从仅 GUI 的交互扩展到通过视觉与程序化接口在用户计算机上完成任务的系统。我们将通用计算机使用智能体(GCUA)定义为一种系统:模型自行选择如何跨视觉与程序化接口观察、行动并组织其工作。然而,诸如 GPT-6 Astra 的计算机使用系统等前沿实现大多仍不开放,限制了对它们设计的系统性研究。我们介绍 Open Generalist CUA(OpenGCUA),这是一个持续推进的项目,旨在与社区共同开发并开放 GCUA 的完整技术栈。本报告介绍 Open Generalist CUA 的首个版本。代码执行是我们智能体设计的关键特性:它使中间结果能够决定后续操作,并让模型将自身已有的编程能力直接应用于计算机交互。我们还提出了执行框架(harness)到模型的决策迁移,将选定的观察信息与任务状态决策从固定的执行框架规则转移到模型。在 OSWorld-v2 上,我们的完整配置提升了全部八个受评估模型的任务得分,包括 GPT-6 Astra 和 Claude Opus 5,将平均部分得分提高了 +19.6 分,并将所报告的每任务步骤数相对于批量仅 GUI 执行平均减少了 53.0%。我们发布了我们的实现和提示词、来自全部八个模型的评估轨迹,以及真实设备执行框架和跨设备 SDK 的初步版本。该执行框架解决了基准测试尚未充分覆盖的真实设备挑战,而该 SDK 提供了跨计算机、移动设备和浏览器的统一编程接口。在我们的真实设备执行框架下的四个真实 macOS 任务中,选定的 Qwen3.8-Max 运行所使用的上报推理 token 数量是 GPT-6 Astra 的 19.4 倍,凸显了不同模型在真实设备执行效率上的显著差异。
一句话总结
Alibaba Token Hub、阿里巴巴集团推出 OpenGCUA,这是一个开放全栈的通用计算机使用 agent,将代码执行与 harness-to-model 决策转移相结合;在 OSWorld-v2 上,它使平均部分得分提高 +19.6 分,并在全部八个被评估模型(包括 GPT-6 Astra 和 Claude Opus 5)上使报告的每任务步骤数平均减少 53.0%,该项目还发布了真实设备 harness 和跨设备 SDK。
核心贡献
- 首个版本引入 Open Generalist CUA(OpenGCUA),一个面向通用计算机使用 agent 的开放全栈项目,其 agent 设计以代码执行为中心,并提出 harness-to-model 决策转移,将选定的观察和任务状态决策从固定 harness 规则转移到模型。
- 在离线 OSWorld-v2 子集上,完整的 OpenGCUA 配置在全部八个被评估模型上都提高了任务得分,相对于批量 GUI-only 执行,使平均部分得分提高 19.6 分,并使报告的每任务步骤数平均减少 53.0%;消融实验显示,代码执行带来的收益超出了仅提供界面访问。
- 该发布包含实现、提示、评估轨迹,以及真实设备 harness 和跨设备 SDK 的初步版本;在所选的四个真实 macOS 任务中,Qwen3.8-Max 运行所报告的推理 token 数量是 GPT-6 Astra 的 19.4 倍。
引言
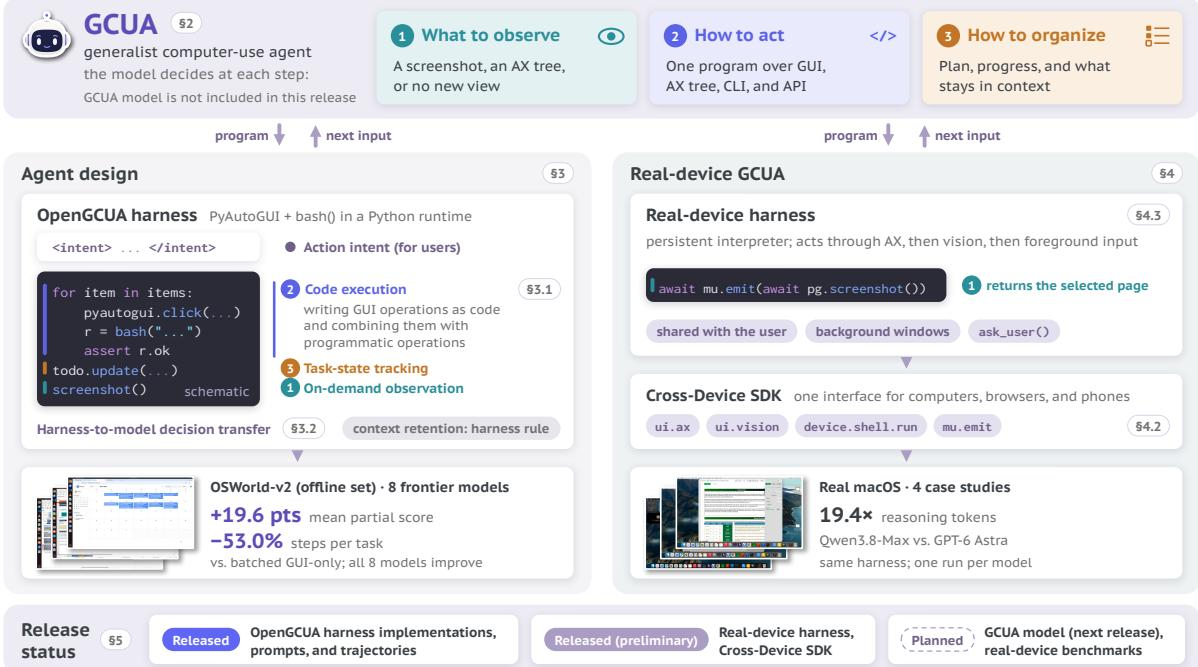
计算机使用已经从仅 GUI 的控制转向通用系统,这些系统结合视觉交互、shell 命令、可访问性 API 和代码执行,在真实计算机上完成工作。这一点很重要,因为在用户自己的机器上操作会带来共享控制、后台窗口、需求变化和效率约束等挑战,而这些是传统基准设置无法完全捕捉的。以往工作受到限制,因为大多数开放 agent 仍然以 GUI 为中心,或者预先固定观察和动作选择,而像 GPT-6 Astra 这样的前沿系统在很大程度上是封闭的,导致其提示、harness 和轨迹难以复现或比较。作者引入 OpenGCUA,以开放通用计算机使用的全栈,将通用计算机使用 agent 定义为在每个步骤由模型决定观察什么、如何行动以及如何组织工作的 agent,并提供初步的真实设备 harness、跨设备 SDK 和已发布的轨迹。
方法
作者设计了一个以两种核心行为为中心的 agent 框架:代码执行和 harness-to-model 决策转移。该框架不依赖固定的 harness 规则,而是赋予模型编写可执行程序的能力,将图形用户界面交互和编程操作统一起来。通过在一个 Python 程序中结合用于桌面交互的 PyAutoGUI 和用于 shell 命令的 bash 等工具,模型不仅可以指定要执行哪些操作,还可以指定执行如何进行。循环和条件逻辑使程序能够重复操作,并根据中间结果选择后续动作,而无需在每一步都进行新的模型调用。
为了进一步增强自主性,该框架将选定的工作流决策从固定 harness 规则转移到模型。这种 harness-to-model 决策转移决定了模型观察什么以及如何组织其任务状态。系统提供按需观察机制,使模型仅在需要视觉反馈时才请求新截图,从而减少上下文长度。任务状态跟踪通过持久化的 todo 界面维护,模型在其中更新和检索进度记录,以区分待处理工作、已尝试的更改和已验证的结果。此外,动作意图机制要求模型在每次代码执行步骤运行之前说明该步骤的目的,从而使程序目标显式化。
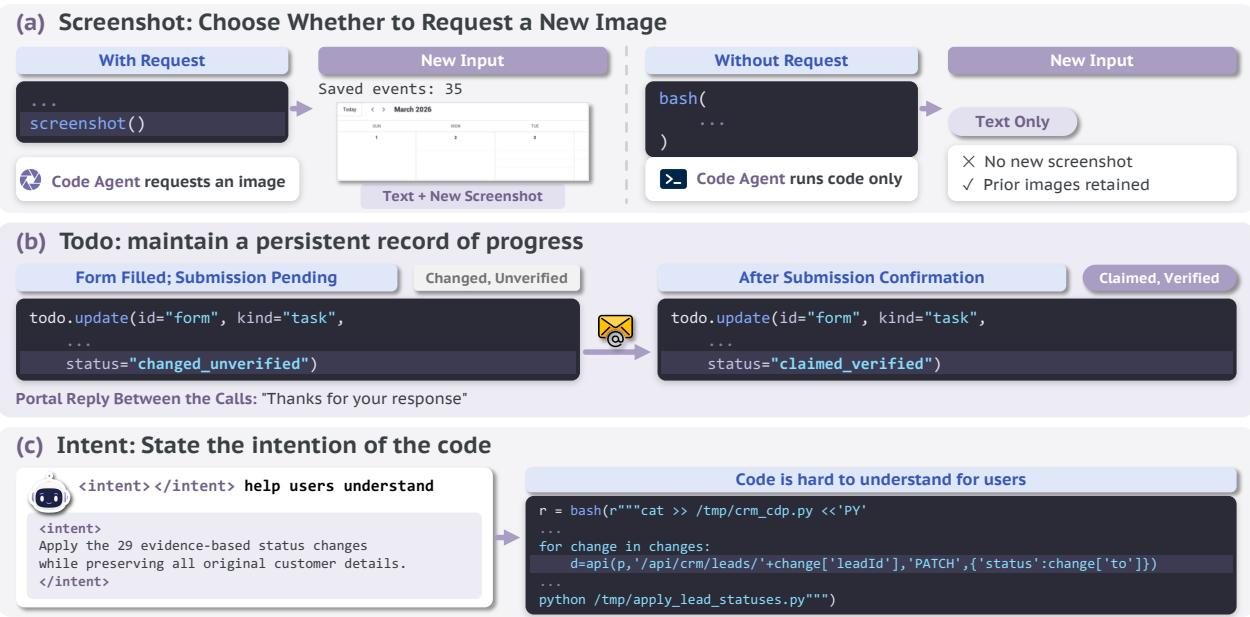
上述模型输出展示了这些界面,说明 agent 如何有选择地请求视觉反馈、在程序之间维护持久任务记录,并在执行复杂代码之前显式说明其意图。
为了部署在真实用户计算机上,作者引入了 Cross-Device SDK 和真实设备 harness,以处理不受控环境的复杂性。Cross-Device SDK 提供统一的编程接口,使单个 agent 能够协调移动应用、桌面工具和基于浏览器的服务之间的操作。它支持具有明确目标的共享操作、单个任务内的跨设备协调以及共享观察处理。
真实设备 harness 通过一个结构化的五层架构,将该 SDK 与 agent 循环和平台特定机制集成。
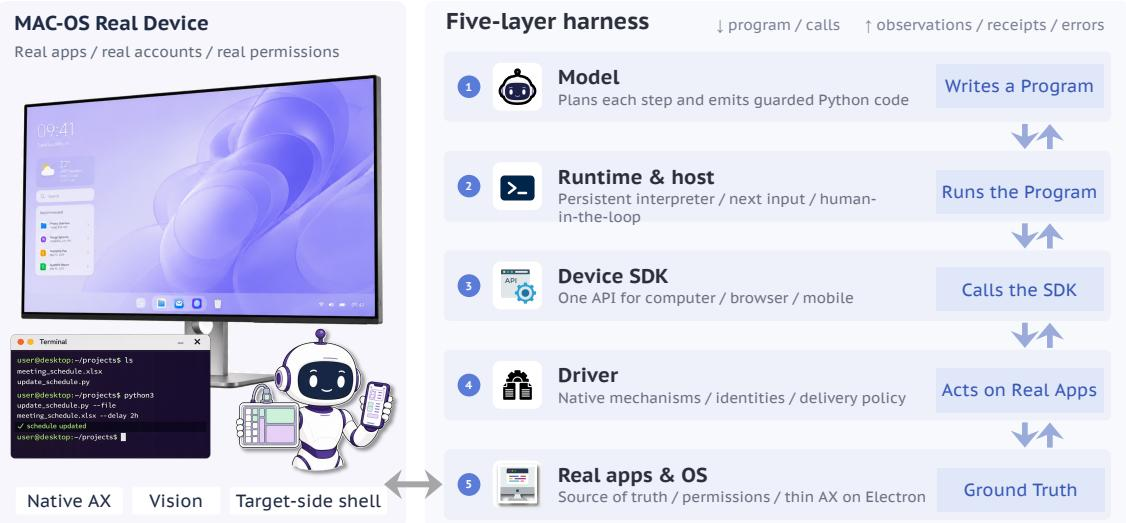
如上图所示,系统分为五个不同的层。Model 层根据任务和交互历史生成 Python 程序。Runtime 层管理 agent 循环并在持久化解释器中执行这些程序,处理上下文保留并构建下一个模型输入。Device SDK 层将观察和动作绑定到设备、窗口等显式资源。Driver 层将 SDK 请求转换为原生操作,管理元素身份和动作交付策略。最后,Applications and Operating System 层表示真实情况,根据权限和应用状态确定可用的观察和控制能力。这种责任的显式分离使得兼容组件可以独立替换,并确保执行失败被正确报告并与任务级结果区分开。
实验
这些实验在离线 OSWorld-v2 子集上跨多个前沿模型评估 OpenGCUA agent 设计,将 GUI-only 和 GUI+CLI 基线,与添加了代码执行和 harness-to-model 决策转移的完整配置进行比较。完整设计在全部模型上一致地改善了任务完成率和交互效率,表明收益来自对 GUI 和 shell 操作的可执行控制,以及由模型控制的观察和工作流管理,而不仅仅是界面访问。消融实验表明,代码执行支持自适应协调,按需观察改善缓存复用,任务状态跟踪有助于保持进度,而资源感知分析在成本或时间限制下会改变模型排名。真实设备的初步结果进一步表明,实际性能取决于观察目标选择、推理量,以及模型是否编写能验证完整任务覆盖的代码。
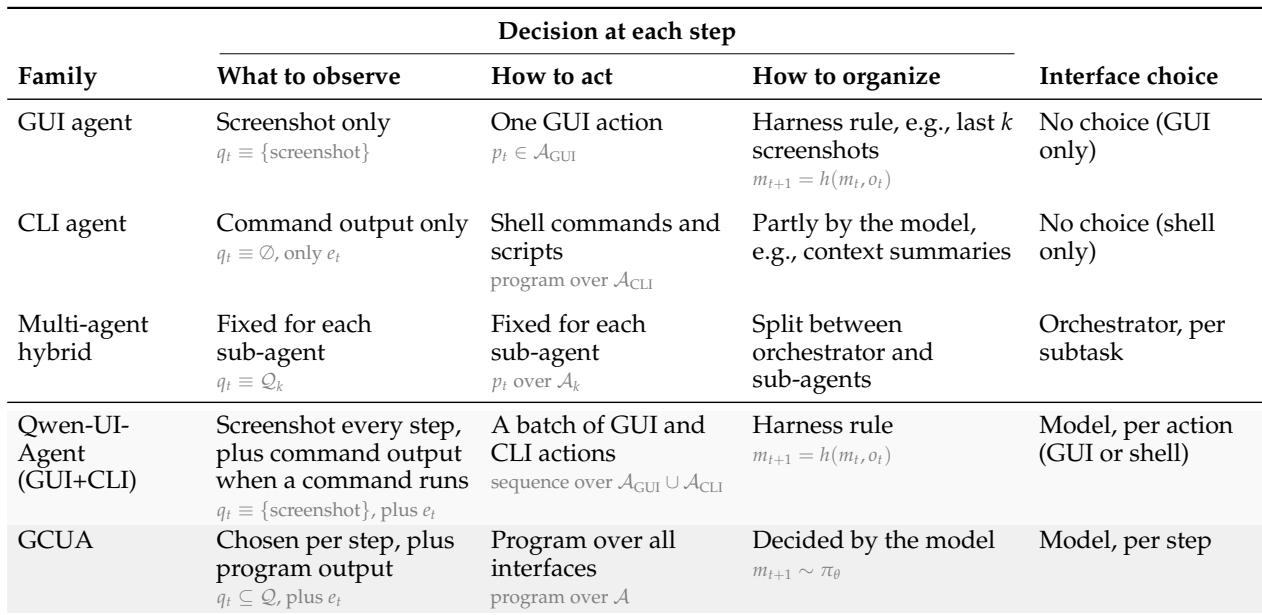
GCUA 是相对于现有 agent 家族来定义的,依据是三类决策中有哪些被预先固定:观察什么、如何行动以及如何组织工作。GUI 和 CLI agent 锁定了其观察和界面选择,而多 agent 混合方案只在每个子任务中选择界面。从早期的 GUI+CLI agent 到 GCUA 的演进,朝着由单个模型在每一步做出全部三类决策的方向发展。现有家族至少固定其中一类决策,而 GCUA 将观察范围、动作界面和工作状态更新留给模型在每一步动态决定。早期的 GUI+CLI agent 已经在每个动作中选择 GUI 或 shell 动作,但 GCUA 还会动态做出观察和记忆组织决策。
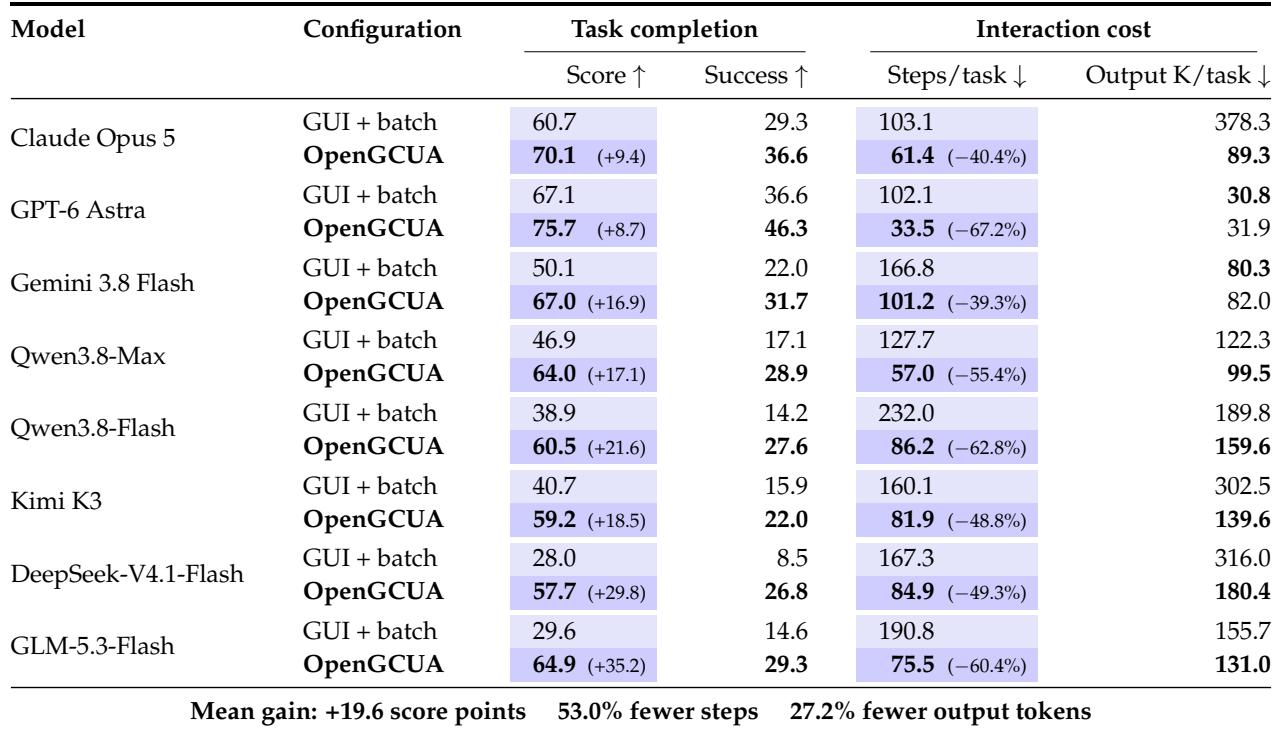
相对于批量 GUI-only 基线,完整的 OpenGCUA 配置在全部被评估模型上提高了任务完成得分和完整任务成功率,同时大幅减少了每任务步骤数。大多数模型的输出 token 使用量下降,但并非全部如此,因此步骤更少并不总是意味着 token 更少。这些收益在基线性能和效率差异很大的模型中都成立。在八个被评估模型中,跨模型平均得分从 45.3 上升到 64.9,而每任务步骤数平均下降 53.0%。在所示模型子集中,输出 token 使用情况不一:一个模型大幅减少了 token,而其他模型尽管步骤大幅减少,token 预算却相近。
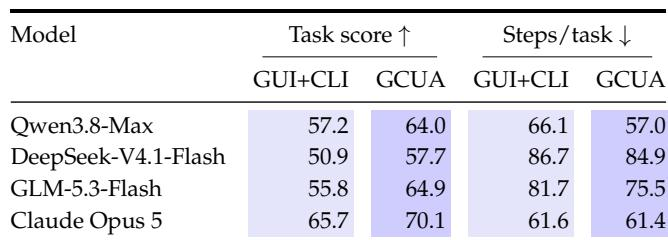
通过添加代码执行和由模型发起的工作流控制,完整 GCUA 相较于批量 GUI+CLI 基线有所改进。在所选的运行中,四个模型都取得了更高的任务得分,并且大多数模型的每任务步骤数也更少。结果表明,对执行和工作流的控制,比单纯提供 GUI 和 CLI 访问更重要。在完整 GCUA 下,每个被评估模型的任务得分都高于批量 GUI+CLI 基线。大多数模型在完整 GCUA 下每任务步骤数下降,而 Claude Opus 5 在得分提高的同时步骤数几乎没有变化。在所选运行中,得分提升约为 4 到 9 分,其中 Qwen3.8-Max 的报告步骤减少幅度最大。
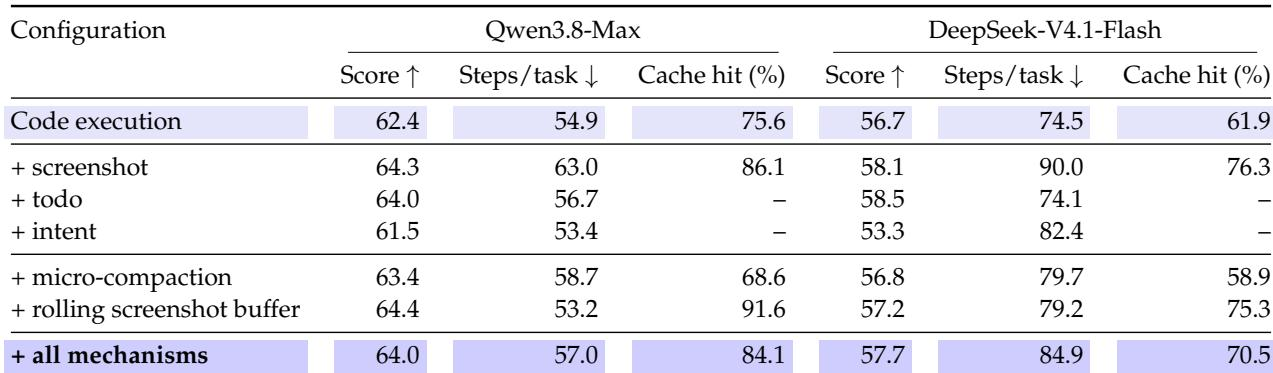
从代码执行基线出发的消融实验显示,新增机制主要影响缓存复用和步骤效率,而任务得分变化不大。截图观察和滚动截图缓冲区在提高缓存命中率的同时没有降低任务得分,todo 带来小幅得分提升。Intent 使得分略微下降,而 micro-compaction 降低了缓存复用,但似乎没有降低所选任务得分。对于两个被评估模型,截图观察相较于代码执行提高了缓存命中率和任务得分。滚动截图缓冲区在新增机制中带来了最大的缓存命中率提升,同时任务得分保持在基线水平或以上。Todo 略微提高了任务得分,这与其跟踪进度和未解决工作的作用一致。Intent 标注略微降低任务得分,反映其重点在于用户可解释性,而不是基准性能。Micro-compaction 与代码执行相比降低了缓存命中率,但在这些所选比较中任务得分没有下降。
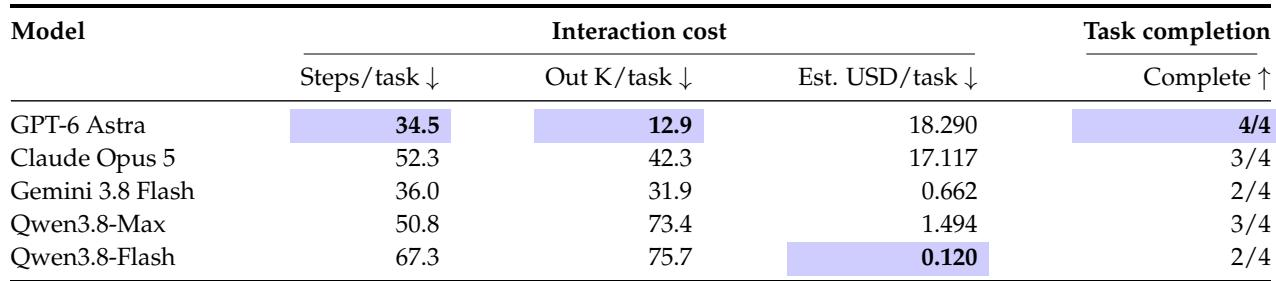
真实设备评估揭示了在完成数、生成量、交互长度和估计成本之间存在大量权衡。GPT-6 Astra 以最少的步骤和输出 token 获得最高的完成任务数,但在定价假设下最昂贵,而 Qwen3.8-Max 使用的推理 token 多得多,成本却低得多。任务级案例显示,即使模型执行类似操作,推理开销和代码覆盖率也可能出现差异。在不同配置中,完成任务数从两个到四个不等,较低的 token 使用量并不总是意味着较低的成本。GPT-6 Astra 完成了全部四个任务,同时使用的步骤和输出 token 最少,但其每任务估计成本最高。Qwen3.8-Max 每任务产生的输出 token 约为 GPT-6 Astra 的 5.7 倍,主要来自推理,但其估计成本低得多。在一个工作簿任务中,GPT-6 Astra 填入了全部 125 个所需答案单元格,而 Qwen3.8-Max 在仅处理部分行后留下 40 个空白。一个简单的截图操作突显了推理成本差距:Qwen3.8-Max 输出超过两千个输出 token,而 GPT-6 Astra 输出约一百二十个。
实验将 GCUA 与固定决策基线(如 GUI-only 和批量 GUI+CLI agent)进行比较,显示在各模型上具有一致的任务得分提升和大幅步骤减少,尽管 token 使用和成本有所不同。完整 GCUA 受益于代码执行和由模型发起的工作流控制,其得分提升超过了仅提供 GUI 和 CLI 访问所能带来的效果。消融实验表明,新增机制主要影响缓存复用和步骤效率,得分变化有限,而真实设备评估揭示了在更少 token 和步骤并不总是意味着更低成本时的权衡。